Scraping con Selenium: capacidades y registros
Diseña una ejecución acotada de scraping con Selenium: binario Chromium explícito, recibo de capacidades, condición de disponibilidad y registros validados.
BotBrowser Team
Quieres la documentación estructurada de Primeros pasos?
Este artículo forma parte de la biblioteca editorial. Para pasos de configuración, material de referencia y actualizaciones continuas, entra en la sección de docs.
Selenium puede controlar un navegador para una tarea de recopilación autorizada, pero crear una sesión WebDriver correcta es solo uno de sus límites. Una ejecución útil también identifica el binario y la sesión negociada, espera la señal real de disponibilidad de la página propia, valida cada registro extraído y se detiene cuando la política de acceso o la respuesta del sitio así lo indican. BotBrowser documenta perfiles mediante archivo y parámetros CLI de inicio; BotBrowser configura la entrada del navegador, pero no garantiza que el perfil se cargue, la compatibilidad Selenium/Grid ni la respuesta de un tercero. Selenium sigue gestionando su sesión WebDriver y el contrato de recopilación de la aplicación.
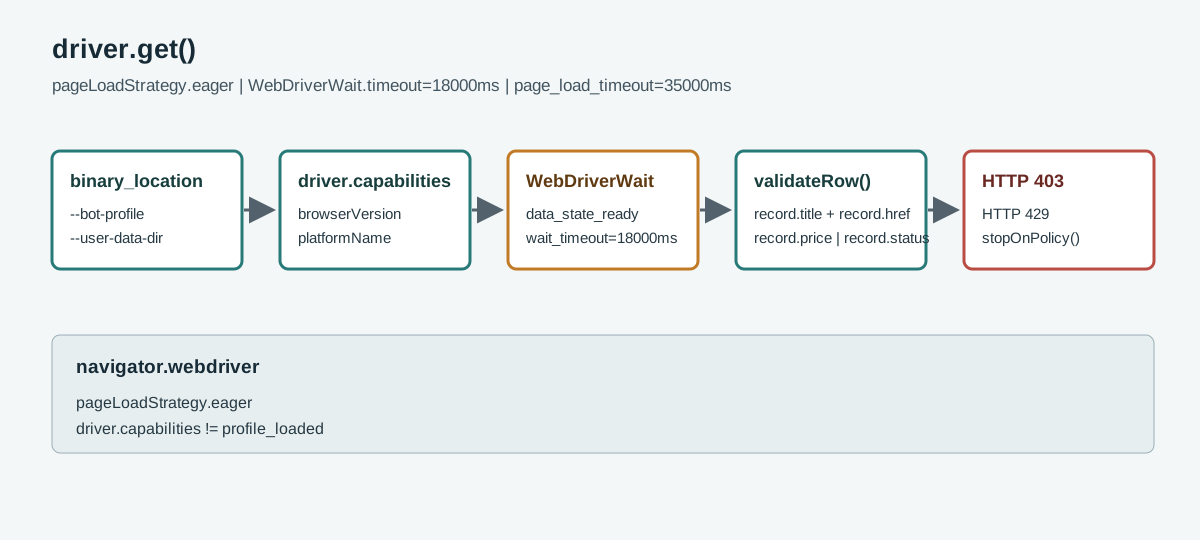
Resumen
- Selecciona deliberadamente el ejecutable del navegador mediante la API de opciones y registra las capacidades devueltas por la sesión nueva, en vez de suponer que se aceptó la configuración solicitada.
- Mantén separados el archivo de perfil de BotBrowser, el directorio de datos de usuario de Chromium, el servicio Selenium y la salida de la ejecución; asigna un responsable a cada uno.
driver.get()marca un límite de navegación del documento; los resultados de un catálogo renderizado por el cliente requieren otra condición de disponibilidad con tiempo acotado.- Valida una fila como dato: exige título, URL de detalle del mismo origen y precio o estado de disponibilidad explícito antes de aceptarla.
navigator.webdrivery las capacidades describen una sesión automatizada; no prueban identidad, autorización, carga del perfil ni la decisión de un sitio.
Contenido
- Definir la ejecución y sus pruebas
- Seleccionar el navegador y configurar la sesión
- Registrar capacidades sin sobreinterpretarlas
- Esperar a que el catálogo esté disponible
- Validar registros y clasificar resultados
- Mantener explícito el límite de identidad
- Conclusión práctica
Definir la ejecución y sus pruebas
Empieza con un catálogo propio o cuya recopilación esté autorizada. Especifica su URL permitida, los campos necesarios para el trabajo posterior, el máximo de registros, la cadencia aprobada por su responsable y las condiciones para detenerse. Así se distingue una página que muestra un catálogo vacío de un script que aceptó datos mal formados. Una ejecución acotada podría leer una página y producir una línea JSON por cada una de hasta 40 tarjetas visibles. El límite de 40 pertenece a esa tarea; no es una recomendación de ritmo para otros sitios.
Deja el contrato de datos junto al código. Por ejemplo, title debe ser texto no vacío después de quitar espacios; href, una URL absoluta del origen autorizado; y price, un importe decimal con moneda o un estado explícito como out-of-stock. No conviertas un campo ausente en un valor inventado como cero. Un precio cero, un precio ausente y un precio oculto tras una solicitud de consentimiento son estados distintos. Conserva esa distinción para que quien consuma los datos decida si la fila sirve.
El registro de ejecución debe describir entradas que puedan cambiar el resultado sin guardar contenido innecesario: revisión del fixture, URL inicial, identificador del binario, versiones del driver y del navegador, estrategia de carga, idioma cuando sea pertinente, hora de inicio y cantidades aceptadas y rechazadas. Excluye secretos, cookies, cabeceras de autorización, directorios de perfil completos y texto de página ajeno a la tarea. Si un error exige una captura o fragmento DOM, usa solo el fixture propio o la región mínima autorizada, oculta datos personales y aplica la política de conservación.
Antes de conectar un trabajo parecido a producción, prueba con un fixture conocido. Puede mostrar un marcador predecible, unas pocas filas, un precio ausente y un estado de acceso denegado. Así se verifica que el script acepta filas válidas, rechaza incompletas y se detiene ante un límite de política. El fixture comprueba tu contrato de extracción; no demuestra qué responderá otro sitio ni qué inferirá un detector.
Decide antes de programar si las URL de las tarjetas llevarán a páginas de detalle. El ejemplo de solo registra las tarjetas del catálogo y no las visita: navegar a detalles añade otro contrato de página, solicitudes adicionales y un nuevo límite de autorización. Otra tarea puede especificarlo si el responsable de los datos lo autoriza. Así se mantiene auditable la instantánea de la lista y se evita que un bucle amplíe silenciosamente la recopilación.
Seleccionar el navegador y configurar la sesión
La documentación de Chrome de Selenium muestra cómo las opciones permiten elegir un binario y añadir argumentos. Ese mecanismo selecciona un ejecutable compatible instalado en el entorno; no certifica todos los binarios derivados ni todas las versiones del driver. Fija navegador y driver según el proceso de versiones del entorno y registra ambas versiones. Si la sesión no arranca, revisa primero la localización del binario y la compatibilidad del driver, no los selectores ni el esquema de datos.
Las recetas CLI de BotBrowser muestran un perfil mediante --bot-profile y un --user-data-dir independiente; la referencia de perfiles indica que las opciones CLI prevalecen sobre configuración y valores por defecto, que los .enc públicos heredados son de solo lectura, que el perfil se recibe como archivo y que la versión mayor del perfil debe coincidir con la del binario. Son entradas de inicio, no capacidades de Selenium ni valores creados mediante Options.set_capability(). En un entorno que admita expresamente el binario y el driver elegidos, una ejecución autorizada puede pasar los argumentos documentados mediante las opciones de Chrome. Debe usar una ruta absoluta permitida y un directorio de datos separado, conforme a las políticas aplicables.
from selenium import webdriver
from selenium.webdriver.chrome.options import Options
from selenium.webdriver.support.ui import WebDriverWait

options = Options()
options.binary_location = "/opt/approved-browser/chrome"
options.add_argument("--bot-profile=/srv/browser-inputs/profile.enc")
options.add_argument("--user-data-dir=/srv/browser-state/run-2026-11-08-01")
options.page_load_strategy = "eager"

driver = webdriver.Chrome(options=options)
try:
    driver.set_page_load_timeout(35)
    driver.get("https://catalogue.example.test/items")
    WebDriverWait(driver, 18).until(
        lambda browser: browser.find_element(
            "css selector", "[data-testid='catalogue-ready']"
        ).get_attribute("data-state") == "ready"
    )
finally:
    driver.quit()
Las rutas son marcadores de posición para rutas administradas por un ejecutor autorizado. No incluyas credenciales en argumentos, código o registros. No reutilices a la vez el mismo perfil o directorio de datos. El directorio administrado puede conservar estado entre invocaciones: asígnale un responsable, decide si es efímero y cierra el navegador antes de reutilizarlo. La guía de sesiones de driver de Selenium explica que construir el driver crea una sesión y que quit() la termina. El bloque finally importa porque la navegación, la espera o la extracción pueden fallar antes del cierre normal.
Con WebDriver remoto o Grid, el binario y las rutas de archivos pertenecen al nodo que inicia el navegador, no necesariamente al proceso que envía comandos Python. Una ruta local absoluta no se vuelve válida en el nodo remoto por existir en la estación cliente. Documenta la imagen del nodo, versiones, entrega del perfil, almacenamiento temporal y propiedad del directorio. Si no se puede verificar dónde está montado el perfil y quién controla el directorio de datos, no inicies la sesión con estado ambiguo.
Elige la estrategia de carga para el límite del documento, no como sustituto de la disponibilidad dinámica. Selenium define normal como esperar a que el documento esté completo, eager como regresar cuando el documento es interactivo y none como no esperar un estado de carga. Se aplica a toda la sesión WebDriver. No determina cuándo está disponible el catálogo de una aplicación de una sola página; esa condición requiere un predicado propio. Para empezar, usa el valor normal por defecto, salvo que la aplicación necesite regresar antes y exista un predicado explícito.
Registrar capacidades sin sobreinterpretarlas
Después de iniciar el driver, guarda una proyección pequeña y revisada de driver.capabilities. La referencia de opciones del navegador de Selenium documenta capacidades compartidas como browserName, browserVersion, platformName y pageLoadStrategy; la clase de opciones establece el nombre del navegador. Estos valores son un recibo de la sesión WebDriver negociada y permiten comparar lo solicitado con lo informado. No prueban que se aceptara un perfil cifrado, que cargaran todas sus superficies ni que un sitio acepte el navegador.
capabilities = driver.capabilities
capability_receipt = {
    "browserName": capabilities.get("browserName"),
    "browserVersion": capabilities.get("browserVersion"),
    "platformName": capabilities.get("platformName"),
    "pageLoadStrategy": capabilities.get("pageLoadStrategy"),
}
Valida el recibo antes de navegar. Si browserName no identifica la familia esperada o browserVersion queda fuera del intervalo permitido, detente y clasifica el problema como configuración de sesión. No sustituyas la versión devuelta por la deducida de la ruta solicitada. Si el driver expone campos adicionales específicos del proveedor, consérvalos solo cuando su significado esté documentado y sean necesarios. Volcar todo el objeto puede guardar metadatos de implementación sin hacer más clara la comparación.
Guarda por separado la configuración solicitada y el recibo devuelto. Si se pidió page_load_strategy="eager" pero el driver informa otro valor, la diferencia debe ser visible. Del mismo modo, una ruta de perfil en la configuración del ejecutor es una entrada, no una prueba de que el navegador lo haya cargado. Confírmalo solo con evidencia de inicio admitida por el producto y el procedimiento autorizado. No se afirma aquí que haya ocurrido una ejecución de BotBrowser.
Escribe el recibo antes de navegar y añade un resultado terminal después. Algunas categorías útiles son session-start-failed, navigation-timeout, readiness-timeout, access-boundary, schema-rejected, complete y cleanup-failed. Conserva la primera causa que detuvo la recopilación; registra por separado un posible fallo posterior de limpieza. Así una respuesta de acceso no se disfraza de error de selector porque el script siguió buscando elementos.
Esperar a que el catálogo esté disponible
Que driver.get() termine no significa que ya se hayan insertado o hidratado todas las filas. Marca el límite de navegación del documento seleccionado. El código del cliente puede solicitar datos después, mostrar un indicador y sustituirlo luego por tarjetas. A la inversa, la página puede seguir descargando recomendaciones cuando la lista solicitada ya está lista. Esperar al fin de toda actividad de red no siempre representa una condición de negocio. El trabajo debe nombrar el marcador concreto que indica que el catálogo autorizado está listo.
Usa un WebDriverWait explícito con una condición estable que publique la página autorizada. Puede ser un elemento documentado con data-state="ready", un mensaje accesible de estado o un recuento conocido. Evita esperar una clase de animación o una pausa fija de 10 segundos. La pausa desperdicia tiempo cuando la lista aparece pronto y puede fallar cuando tarda más. Una espera acotada devuelve un resultado claro. El límite de 18 segundos del ejemplo es ilustrativo, no un valor universal: elígelo según el objetivo de servicio de la aplicación propia.
El predicado de disponibilidad debe ser de solo lectura. WebDriver puede evaluarlo varias veces, por lo que no debe pulsar controles, enviar formularios, desplazarse para cargar registros adicionales ni modificar la página. Si la paginación está autorizada, modela cada transición por separado: verifica la condición actual, captura las filas aceptadas, realiza una sola acción de página siguiente y espera un estado o identificador distinto. Detente en el máximo acordado y anota que se alcanzó. No sigas pulsando cuando el número de página no cambia.
Una limitación de velocidad puede producir resultados diferentes. Una respuesta acotada de reintento, un estado de la aplicación que pide esperar, una página de desafío, una redirección al inicio de sesión y un selector ausente no son equivalentes. Respeta la política de acceso publicada y el presupuesto permitido por el responsable. Si aparece un límite de acceso o política, detén la ejecución y conserva solo la categoría mínima. No automatices la resolución de desafíos, eludir controles ni aumentar la intensidad para forzar resultados. El script puede informar que no llegó el estado esperado; no puede decidir que se permite continuar.
Validar registros y clasificar resultados
Convierte cada fila en un registro tipado antes de serializarla. Quita espacios del texto visible, resuelve los enlaces respecto a la URL del catálogo, exige el origen permitido y rechaza valores mal formados. Si el precio usa separadores locales, interprétalo según el idioma declarado en vez de borrar puntuación a ciegas. Si la página muestra precio y disponibilidad, conserva ambos. No guardes descripciones cuando la tarea solo necesita título, URL y precio o estado.
from urllib.parse import urljoin, urlparse

def normalized_origin(url):
    try:
        parsed = urlparse(url)
        hostname = parsed.hostname
        port = parsed.port
    except ValueError:
        return None
    scheme = parsed.scheme.lower()
    if scheme not in {"http", "https"} or not hostname or parsed.username is not None or parsed.password is not None:
        return None
    effective_port = port if port is not None else (443 if scheme == "https" else 80)
    return scheme, hostname.lower(), effective_port

def parse_card(card, page_url, allowed_origin):
    title = card.find_element("css selector", "[data-testid='title']").text.strip()
    href = card.find_element("css selector", "a[data-testid='detail-link']").get_attribute("href")
    absolute_url = urljoin(page_url, href or "")
    price_nodes = card.find_elements("css selector", "[data-testid='price']")
    status_nodes = card.find_elements("css selector", "[data-testid='availability']")
    price = price_nodes[0].text.strip() if price_nodes else None
    status = status_nodes[0].text.strip() if status_nodes else None

    if not title or normalized_origin(absolute_url) != allowed_origin:
        return None, "schema-rejected"
    if not price and not status:
        return None, "missing-price-or-status"
    return {"title": title, "href": absolute_url, "price": price, "status": status}, None
Calcula allowed_origin una vez a partir de una URL inicial permitida con la misma función normalized_origin, nunca desde un enlace extraído. Este ejemplo solo acepta HTTP y HTTPS y compara esquema, host y puerto efectivo normalizados, incluidos los puertos predeterminados 80 y 443; los puertos mal formados se rechazan. Centraliza la normalización de URL y prueba puertos predeterminados, hosts internacionalizados, redirecciones y enlaces relativos. No visites un href solo porque aparece en una tarjeta. Extraer y navegar son permisos distintos.
No trates una lista vacía como una recopilación correcta sin más. Puede ser un catálogo válido, pero también puede significar que el marcador apareció antes de insertar los datos, que un filtro no devolvió resultados o que cambió el contrato de la página. Exige un recuento o un estado vacío explícito. Si la página declara cero resultados, emite empty-catalogue con la revisión de página y detente. Si falta el marcador esperado, clasifica una espera agotada, no un archivo vacío correcto.
Cuenta cada resultado y registra el motivo de rechazo. Por ejemplo, 36 filas aceptadas, dos precios ausentes y dos URL de otro origen difieren de 40 aceptadas. Un resumen puede indicar accepted=36, rejected=4 y cantidades por motivo sin conservar los cuerpos de página. Rechaza URL normalizadas duplicadas si el consumidor exige un registro por producto, pero informa el número de duplicados en vez de sobrescribirlos silenciosamente.
| Resultado | Evidencia mínima | Responsable siguiente |
|---|---|---|
| El navegador o driver no crea la sesión | error saneado, identificador del binario y versiones | imagen del ejecutor |
| Las capacidades no cumplen la lista permitida | recibo de cuatro campos y estrategia solicitada | configuración WebDriver |
| La navegación supera el límite | host inicial, categoría de tiempo y último estado | aplicación o red |
| No aparece la condición de catálogo listo | nombre de condición, tiempo transcurrido y recuento | contrato de página |
| Una fila falla el esquema | campo rechazado y total de filas no válidas | contrato de extracción |
| El sitio informa un límite de acceso | categoría de respuesta o estado visible, sin contenido del desafío | responsable de política |
quit() falla después de otro error | error original y categoría de limpieza | ciclo de vida del ejecutor |
La tabla no autoriza a recoger más diagnóstico del necesario. Un HAR, copia del perfil, base de datos del navegador o captura autenticada pueden contener credenciales y actividad ajena. Empieza por la evidencia mínima; amplíala solo con autorización y conforme a la política de privacidad. Limita las rutas de salida a la ejecución y aplica la retención definida por el proyecto.
Mantener explícito el límite de identidad
El archivo de perfil, el binario, las opciones WebDriver y los valores visibles desde JavaScript son capas relacionadas pero distintas. La configuración de perfil puede aportar ajustes documentados; los argumentos CLI tienen prioridad sobre la configuración y los valores por defecto. El binario seleccionado debe coincidir en versión mayor con el perfil según la documentación. Las capacidades describen la sesión negociada. Nada de ello, por sí solo, prueba todos los valores de página, la continuidad de una identidad entre ejecuciones o cómo un servidor clasifica una solicitud.
MDN describe navigator.webdriver como un booleano de solo lectura que indica si el agente de usuario está controlado por automatización. Es una señal de automatización visible para la página, no una identidad, permiso, huella completa ni veredicto del sistema de detección. Si un fixture propio autorizado necesita registrarlo para una prueba de compatibilidad, guarda el booleano junto al contexto de página y navegador; no lo conviertas en una puntuación de acceso.
El mismo límite debe aparecer en los informes. Es válido decir: “la sesión WebDriver inició con la versión X y el fixture devolvió 36 registros válidos”. No lo es afirmar que “el navegador parecía humano”, que “el perfil demuestra la identidad de la cuenta” o que “el sitio aceptará esta sesión”. La primera frase deriva de capacidades y validaciones propias. Las demás atribuyen decisiones externas que esas observaciones no prueban.
Las referencias públicas de BotBrowser sobre configuración de perfil y recetas CLI describen entradas del navegador; no certifican compatibilidad Selenium ni cambian el protocolo WebDriver. Cada equipo debe validar su binario, driver, paquete de perfil, sistema operativo y configuración dentro del entorno admitido. Un ejemplo genérico de Selenium no es certificación del producto ni promesa de que una aplicación externa permita recopilar datos.
Para separar asuntos cercanos, Integración de perfiles de navegador y propiedad de sesión con Selenium trata el almacenamiento y el ciclo de vida del perfil; Esperas de Selenium WebDriver y pruebas estables desarrolla la semántica de las esperas. El registro de scraping se limita a capacidades, una condición de disponibilidad, un esquema de filas y un límite de parada. Los detalles del navegador no sustituyen el permiso del responsable de datos ni el contrato de la aplicación.
Preguntas frecuentes
¿driver.get() significa que el catálogo ya está listo?
No. La estrategia de carga marca un estado del documento; una aplicación puede rellenar sus resultados después. Espera una señal propia y acotada.
¿Las capacidades prueban que el perfil se cargó?
No. Describen la sesión negociada. La carga del perfil requiere evidencia de inicio admitida por el producto y por el procedimiento autorizado.
¿Debe visitarse cada enlace extraído?
No. Navegar a detalles amplía la tarea y sus solicitudes. Hazlo solo cuando el alcance y la autorización definan expresamente ese segundo contrato.
Fuentes
- Funcionalidad específica de Chrome en Selenium
- Sesiones de driver de Selenium
- Opciones y capacidades del navegador en Selenium
- Recetas CLI de BotBrowser
- Configuración de perfiles de BotBrowser
- MDN: propiedad Navigator.webdriver
Conclusión práctica
Trata una tarea de scraping con Selenium como una cadena de límites comprobables: permiso y esquema, navegador y driver seleccionados, recibo de capacidades, condición acotada de disponibilidad, filas validadas y cierre normal de sesión. Mantén separado el perfil y el directorio de datos, atribuye el primer fallo a su responsable y detente ante un límite de acceso. El registro resultante explica qué observó el ejecutor en un catálogo propio; no prueba la carga del perfil sin evidencia del producto ni predice la decisión de un tercero.
Este artículo forma parte de la guía: Primeros pasos con automatización de navegador: mapa inicial
Artículos Relacionados
Integración de perfiles de navegador con Selenium
Primeros pasosScraping con Puppeteer: opciones y valores observables
Primeros pasosEsperas de Selenium WebDriver para pruebas estables
Primeros pasosScraping con Playwright: navegador y perfil
Primeros pasosFijación y actualización de versiones del navegador
Primeros pasosEventos WebDriver BiDi para una automatización estable
Ejecuta la misma comprobación en BotBrowser
Carga un perfil, mantén dentro del navegador las señales que acabas de leer y confirma el resultado en tu propia máquina antes del despliegue.