Scraping de bolsas de empleo: límites del navegador
Planifica la recopilación de listados públicos en torno al marcado JobPosting, la paginación, el estado de sesión y un límite claro ante datos autenticados.
BotBrowser Team
Quieres la documentación estructurada de Despliegue?
Este artículo forma parte de la biblioteca editorial. Para pasos de configuración, material de referencia y actualizaciones continuas, entra en la sección de docs.
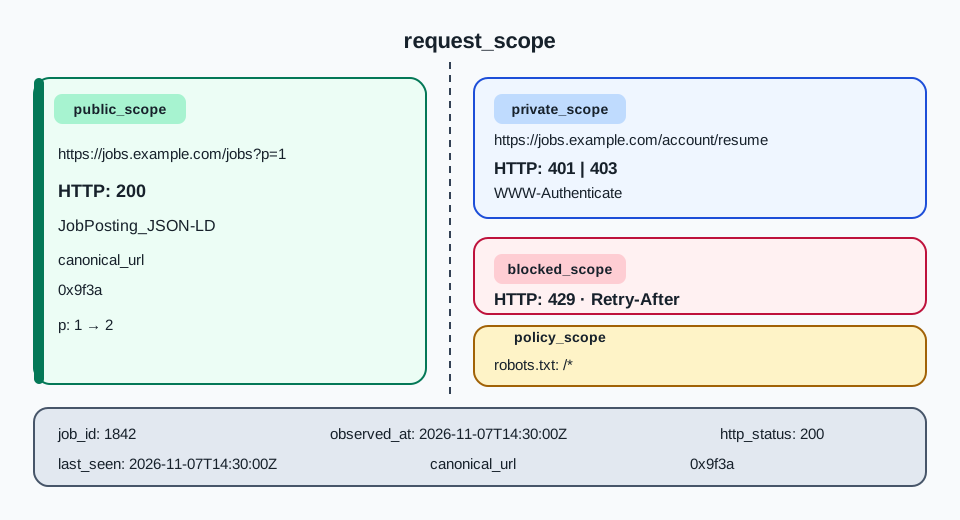
El scraping de bolsas de empleo es sobre todo un problema de paginación e integridad de registros, y la capa del navegador solo cubre una parte. El límite que importa es la clase de acceso: una página de listado pública puede solicitarse bajo la autorización de un operador, mientras que un perfil de candidato, un historial de solicitudes, una bandeja de reclutador o una página de cuenta con búsquedas guardadas son datos privados fuera de esta carga de trabajo. BotBrowser proporciona un entorno de navegador configurable que se inicia desde una configuración del operador y devuelve el resultado visible de la página, pero no puede conceder permiso, decidir si los términos de un sitio permiten la recopilación ni eliminar una barrera de autenticación, consentimiento o límite de velocidad. El alcance se limita a los listados públicos.
TL;DR
- Trata cada bolsa de empleo como tres fuentes de registros: tarjetas de listado, páginas de detalle y JSON-LD de
JobPosting. Fusiónalas en un solo registro con un orden de precedencia explícito. - Define la preparación de la página como un contenedor de resultados visible más un recuento de tarjetas estable, no como una espera fija ni un evento global de inactividad de red.
- Lleva
job_id,canonical_url,datePosted,validThrough,hiringOrganizationyjobLocationdesde la primera observación en lugar de reconstruirlos después. - Clasifica cada URL como listado público o datos autenticados antes de la primera solicitud; detén la ejecución cuando una respuesta cruce hacia la segunda clase.
- Atribuye un 429, una regla de
robots.txt, un intersticial de consentimiento y un 401 a capas distintas. Ninguno de ellos es evidencia de que el navegador necesite otro perfil.
Contenido
- Asignar la carga de listados a las tareas del navegador
- Trazar el límite entre público y autenticado
- Medir la completitud y atribuir los fallos
Asignar la carga de listados a las tareas del navegador
Una ejecución de bolsa de empleo parte de una URL de consulta como https://jobs.example.com/jobs?q=analyst&p=1, recorre los enlaces de paginación que ofrece el sitio y abre una página de detalle por publicación. Con 40 tarjetas por página y 12 páginas de listado, el techo esperado es 480 páginas de detalle, pero el navegador nunca decide ese número. El operador fija la consulta, el rango de páginas permitido y la regla de detención; el navegador crea un contexto, navega, espera la señal acordada y lee la página que recibió.
Separar responsabilidades evita una conclusión falsa común. Un planificador posee los reintentos, el orden de la cola y la concurrencia. El almacenamiento posee la normalización y la desduplicación. El navegador posee la navegación, la renderización, la preparación y la extracción de lo que expone la página. Cuando una página de detalle devuelve una tarjeta sin título, el campo faltante es un problema de extracción o de marcado hasta que un código de estado o un intersticial demuestre lo contrario.
Las páginas de bolsas de empleo son extraordinariamente repetitivas: una plantilla sirve miles de publicaciones, los filtros viven en la cadena de consulta y el diseño de detalle rara vez cambia entre roles. El costo por página está dominado, por tanto, por la navegación, la espera de preparación y el trabajo de análisis, más que por aprender un diseño nuevo cada vez. Esa forma premia un contrato de selectores fijo y un contrato de campos fijo, y penaliza los selectores improvisados escritos por publicación.
La misma aritmética de páginas de listado a páginas de detalle aparece en la planificación de carga para scraping SERP, que separa las etapas del navegador de la espera de respuesta antes de elegir un objetivo de recopilación.
Leer la publicación estructurada antes de la tarjeta visible
Muchas bolsas publican marcado de Schema.org JobPosting como JSON-LD. El nodo suele estar en un bloque <script type="application/ld+json">, a veces dentro de un arreglo @graph y a veces repartido entre varios bloques de una misma página. Lee todos los bloques, conserva los fallos de análisis como un campo contabilizado y selecciona los nodos cuyo @type sea JobPosting o un arreglo que lo contenga.
| Campo | Forma típica | Almacenar como | Fallo que registrar |
|---|---|---|---|
@type | "JobPosting" o un arreglo | node_type | La página tiene tarjetas pero ningún nodo de publicación |
datePosted | Fecha ISO 8601 como 2026-11-03 | date_posted | Solo texto relativo como «hace 3 días» |
validThrough | Fecha o fecha y hora ISO 8601 | valid_through | Campo ausente en vacantes permanentes |
hiringOrganization.name | cadena Organization.name | employer_name | Empleador mostrado como «Confidential» |
jobLocation.address.addressLocality | PostalAddress anidado | location_city | Rol remoto sin dirección |
identifier | Cadena o PropertyValue | source_job_id | El identificador cambia entre renderizaciones |
El mismo campo puede aparecer en tres lugares con valores distintos: la tarjeta de listado, el DOM de detalle y el nodo JSON-LD. Registra qué fuente aportó cada campo en lugar de permitir que una pasada posterior sobrescriba en silencio una anterior. Una precedencia viable es primero los datos estructurados, segundo el estado incrustado de la página y por último el DOM visible, con la fuente elegida almacenada como field_source.
const raw = await page.locator('script[type="application/ld+json"]').allTextContents();
const errors = [];
const nodes = raw.flatMap(text => {
  try {
    const doc = JSON.parse(text);
    return Array.isArray(doc['@graph']) ? doc['@graph'] : [doc];
  } catch (error) {
    errors.push(String(error));
    return [];
  }
});
const postings = nodes.filter(node => [].concat(node['@type'] ?? []).includes('JobPosting'));
El fragmento devuelve los nodos de publicación y mantiene visibles los errores de análisis. No supone que la bolsa publique datos estructurados; una bolsa que solo renderiza tarjetas sigue necesitando el contrato DOM, y una que inyecta marcado después del primer pintado sigue necesitando la regla de preparación que aparece más abajo.
Definir la paginación desde la página, no desde una URL adivinada
Las bolsas expresan la paginación de al menos cinco maneras, y la diferencia cambia cómo una ejecución detecta el final. Registra la URL que produjo cada página, el índice y el siguiente enlace que la propia página anuncia.
| Patrón | Ejemplo | Detección | Riesgo principal |
|---|---|---|---|
| Número de página | ?page=2 | Parámetro de consulta | El sitio limita o ignora las páginas profundas |
| Número de página corto | ?p=2 | Parámetro de consulta | El mismo nombre de parámetro significa otra cosa en otra bolsa |
| Desplazamiento | ?start=25 | Parámetro de consulta con tamaño de página | Desplazamiento derivado de un tamaño de página incorrecto |
| Cursor | ?after=eyJpZCI6MTg0Mn0 | Token opaco de la página anterior | Reutilizar un cursor obsoleto |
| Relación de enlace | <link rel="next" href="..."> | Atributo del DOM | Ausente en algunas plantillas |
Detente cuando la página no anuncie ningún enlace siguiente, cuando el contenedor de resultados esté presente pero vacío, cuando las claves de la primera y la última tarjeta repitan una página anterior o cuando el conjunto de URL visitadas ya contenga el siguiente destino. Trata un recuento de páginas tomado de un widget «1 de 12» como una pista, no como una garantía: los cambios de filtro, la personalización y las publicaciones caducadas pueden desplazar el total entre solicitudes.
Dos protecciones pertenecen al bucle desde la primera ejecución. Mantén un conjunto de URL de página normalizadas y rechaza una repetición. Mantén una firma construida con las claves de la primera y la última tarjeta de cada página; las firmas idénticas en páginas consecutivas suelen significar que el sitio fijó el número de página en lugar de devolver resultados nuevos.
Establecer una condición de preparación que coincida con la extracción
Un evento de navegación demuestra que llegó un documento, no que el listado sea utilizable. DOMContentLoaded puede dispararse antes de que se rendericen las tarjetas, y una espera global de inactividad de red puede bloquearse con anuncios, analítica o una solicitud de sondeo largo. Usa una condición ligada a los elementos que lee el extractor.
| Señal de preparación | Qué demuestra | Qué omite |
|---|---|---|
Evento domcontentloaded | HTML analizado | Tarjetas renderizadas en cliente |
| Contenedor de listado visible | Plantilla montada | Tarjetas que aún llegan en flujo |
| Recuento de tarjetas estable entre dos comprobaciones | Lista asentada | Inyección tardía de JSON-LD |
Nodo JobPosting presente | Datos estructurados de detalle analizados | Bolsas sin marcado |
| Control siguiente habilitado | Paginación interactiva | Límite de página del lado del servidor |
La regla práctica es una conjunción: el contenedor de resultados es visible, el recuento de tarjetas iguala el recuento que informa la página y cada tarjeta tiene un enlace de detalle no vacío. Para una página de detalle, añade un nodo JobPosting analizado o un marcador explícito de «sin datos estructurados» antes de que empiece la extracción. Registra la marca temporal del evento de preparación por separado del inicio de la solicitud para que una revisión posterior pueda calcular la espera.
El estado de sesión pertenece al mismo contrato. Algunas bolsas mantienen los filtros en la URL y devuelven la misma lista a un contexto nuevo. Otras guardan el orden, el radio de ubicación o un cursor de página en cookies o almacenamiento local, de modo que un contexto nuevo reinicia en la página uno mientras la URL todavía dice página ocho. Decide qué comportamiento aplica y luego reutiliza un contexto para una ejecución o reconstruye el estado de filtros desde la URL. Un contexto dedicado por ejecución también evita que el almacenamiento se filtre entre trabajos de recopilación no relacionados; el aislamiento de navegador multicuenta explica cómo se separan el almacenamiento por contexto y la configuración de identidad cuando varias cargas de trabajo autorizadas comparten un host.
Si una ejecución pierde su ruta a mitad de la paginación, no reinicies todo el rastreo. La guía sobre recuperación de sesión tras una interrupción de red cubre cómo distinguir una conexión caída de una página caducada y cómo reanudar sin duplicar páginas completadas.
Trazar el límite entre público y autenticado
La clase de acceso de una URL es una propiedad del sitio y de la autorización del operador, no de la compilación del navegador. Un resultado de búsqueda público, una página de detalle pública y la página de empleo de una empresa servida sin sesión pertenecen a una clase. Un perfil de candidato, una página de estado de solicitud, un hilo de mensajes de reclutador, una búsqueda guardada vinculada a una cuenta y un formulario de solicitud que acepta un currículum pertenecen a otra. Esta carga de trabajo solicita solo la primera clase.
Ese límite de datos públicos es el mismo que mantiene en alcance la protección de huellas para la recopilación de datos web: las señales del navegador pueden hacerse repetibles para un flujo autorizado, pero no pueden convertir una página autenticada en datos públicos.
| Clase de URL o respuesta | Ruta de ejemplo | Respuesta esperada | En alcance | Acción |
|---|---|---|---|---|
| Búsqueda pública | /jobs?q=analyst&p=2 | 200 con tarjetas de resultado | Sí | Solicitar dentro del rango de páginas acordado |
| Detalle público | /jobs/1842 | 200 con marcado de publicación | Sí | Extraer y registrar |
| Página pública de empresa | /careers/acme | 200 sin sesión | Sí, si está permitido | Tratar como otra fuente de listado |
| Formulario de inicio de sesión | /login | 200 con formulario de acceso | No | Excluir la ruta |
| Perfil de candidato | /account/profile | 401 o 403, o 200 solo con sesión | No | Detener y excluir |
| Historial de solicitudes | /account/applications | 200 limitado a la sesión | No | Detener y excluir |
| Bandeja de reclutador | /employer/messages | 200 limitado a la sesión | No | Detener y excluir |
| Carga de currículum | /apply/1842/upload | Formulario que acepta archivos personales | No | Detener y excluir |
Aplica la tabla antes de la primera navegación. Una lista de URL permitidas es más fácil de auditar que una lista de bloqueo, porque una nueva ruta de cuenta añadida por el sitio no puede entrar en silencio en la ejecución. Cada entrada debe llevar la referencia de aprobación del operador, la fecha en que se comprobó y la clase de página asignada.
Reglas de reconocimiento para un límite de autenticación
La señal más clara es un 401 HTTP con una cabecera WWW-Authenticate, pero las bolsas reales también redirigen a /login, devuelven 403 para una ruta protegida o sirven una página 200 cuyo único contenido es una petición de inicio de sesión. Un elemento de navegación exclusivo para candidatos, un avatar de cuenta o un control de «solicitar» que abre un formulario de currículum son marcadores de límite incluso cuando el estado es 200.
Cuando aparezca cualquiera de ellos, detén esa URL, registra la clase como authenticated y déjala fuera del denominador de completitud de listados públicos. Nunca proporciones credenciales, reproduzcas una cookie copiada de la sesión de una persona, completes un desafío ni continúes a través de una página que pide datos de candidato. La salida correcta es una exclusión con un motivo, no un registro parcialmente rellenado.
Consentimiento, robots y límites de velocidad son barreras separadas
Un intersticial de consentimiento es una barrera de política. El banner puede ocultar el listado hasta que se haga una elección, y las opciones disponibles pueden variar por región y por si ya existe una sesión. Registra consent_state como present, required o absent, captura la URL y dirige la decisión al operador. Programar un clic de aceptación no forma parte de un plan de extracción de listados públicos, porque la elección es del visitante, no del recopilador.
El Protocolo de exclusión de robots define cómo publica un sitio sus reglas de rastreo, incluidos los grupos seleccionados por token de agente de usuario. Obtén robots.txt, registra el estado de la respuesta y la regla que aplica al cliente declarado, y excluye una ruta no permitida. Elegir otro token de agente de usuario para caer en un grupo más permisivo es una evasión de política, no un requisito del navegador.
Una respuesta 429 con Retry-After es un límite de velocidad, definido junto con otras semánticas de estado en RFC 9110. Respeta la ventana, reduce el alcance solicitado o pide al propietario del sitio una API. Rotar rutas o perfiles para seguir solicitando durante la ventana cambia quién recibe la solicitud, no si la solicitud está permitida. Un 503 es una condición de servicio; trátalo como un fallo de disponibilidad y reintenta solo bajo la política acordada por el operador.
Matriz de atribución de fallos
La siguiente matriz evita que una respuesta bloqueada se interprete erróneamente como un defecto del navegador. Cada fila nombra la capa que produjo la observación y la siguiente acción permitida.
| Observación | Capa responsable | Qué no demuestra | Siguiente acción |
|---|---|---|---|
200 pero sin tarjetas en el contenedor | Renderización, contrato de selectores o resultado vacío | Que el sitio bloqueó el navegador | Comprobar preparación, selector y estado de la consulta; registrar empty_result |
200 con un diálogo de consentimiento | Política de consentimiento | Que la página no esté disponible | Registrar consent_gate y detenerse para una decisión del operador |
401 más WWW-Authenticate | Autenticación | Que otro perfil estaría autorizado | Excluir la URL |
403 en una ruta de candidato | Autorización | Que la ruta sea pública pero esté mal configurada | Excluir la URL |
Redirección a /login | Autenticación | Un problema de red o de configuración regional | Excluir la URL |
429 más Retry-After | Limitación de velocidad | Que la identidad del navegador sea incorrecta | Respetar la ventana o reducir el alcance |
Ruta listada en robots.txt | Política de rastreo del sitio | Que el HTML esté roto | Excluir la ruta |
| Página de desafío en lugar de resultados | Control de acceso | Que una opción de renderización la eliminará | Detenerse; no automatizar el desafío |
| Tiempo de espera de navegación agotado | Red, host o peso de la página | Que el sitio rechazó la solicitud | Registrar la etapa y volver a comprobar la ruta |
200 con menos de una página de resultados | Fin de paginación o filtro más restrictivo | Que la ejecución completó la consulta | Comparar la firma de la primera página y la consulta |
Un perfil de navegador, una ruta de proxy o una configuración regional distinta cambian lo que observa un servidor. Ninguno de esos cambios crea permiso, satisface una regla de robots, acepta una elección de consentimiento en nombre de un visitante ni convierte un 403 en autorización. Una recopilación está permitida por el propietario del sitio, los términos aplicables y la ley, y la capa del navegador solo puede mantenerse dentro o fuera de esa decisión.
El enrutamiento de red es una superficie de configuración separada. La guía de configuración de proxy del navegador cubre la selección de ruta, el manejo de credenciales y el comportamiento DNS; también deja claro que una ruta no valida la política de un destino. Usa una ruta que el operador esté autorizado a usar y mantén la ruta fija mientras comparas el comportamiento de extracción.
Medir la completitud y atribuir los fallos
Una pregunta de medición útil para esta carga de trabajo es: sobre un conjunto permitido de URL de listados públicos, cuántas publicaciones se descubrieron, cuántos campos obligatorios se rellenaron y qué fallos provinieron de qué capa. Esa pregunta tiene un denominador defendible. Una «tasa de éxito» medida contra una página de inicio de sesión o una respuesta limitada por velocidad no lo tiene.
Congela la entrada antes de la primera ejecución. El accesorio debe listar las URL de consulta, el rango de páginas esperado, el contrato de preparación y el contrato de selectores. Mantén una referencia de aprobación junto a él. Si la bolsa cambia su plantilla, el accesorio cambia como una versión nueva en lugar de editarse en el mismo lugar, para que los resultados antiguos y nuevos sigan siendo comparables.
Esquema de registro
Almacena un registro por publicación observada y un registro por página. El registro de página lleva el estado, los tiempos y el recuento. El registro de publicación lleva la identidad y las fuentes de los campos, como en el ejemplo con valores ilustrativos.
{
  "job_id": "1842",
  "canonical_url": "https://jobs.example.com/jobs/1842",
  "page_url": "https://jobs.example.com/jobs?q=analyst&p=2",
  "http_status": 200,
  "observed_at": "2026-11-07T14:30:00Z",
  "date_posted": "2026-11-03",
  "valid_through": "2026-12-01",
  "employer_name": "Example Analytics",
  "location_city": "Toronto",
  "field_source": "jsonld",
  "etag": "W/\"abc123\"",
  "content_hash": "9f2c1d7a4b8e0c31"
}
Mantén job_id como el identificador propio del sitio cuando sea estable. Mantén canonical_url como la dirección que declara la página, no la URL paginada que llevó hasta ella. Mantén page_url para que un duplicado pueda rastrearse hasta la página de listado que lo produjo. Almacena etag y content_hash para detectar páginas de detalle sin cambios y evitar reescribir registros idénticos.
Fusionar duplicados con una clave declarada
La misma publicación suele aparecer en la página de búsqueda de una bolsa, una página de empresa, un espejo regional y un agregador. Los identificadores de empleo son la clave más fuerte cuando existen, pero una nueva publicación puede recibir un identificador distinto y conservar el mismo empleador, título, ciudad y descripción.
| Clave candidata | Estabilidad | Riesgo de colisión | Usar cuando |
|---|---|---|---|
source_job_id más host de la bolsa | Alta mientras vive la publicación | Mismo id reutilizado tras un borrado | La bolsa publica un id estable |
canonical_url | Alta | Dos URL para una misma vacante | El enlace canónico está presente |
Empleador, título, ciudad, date_posted | Media | Mismo rol abierto dos veces en un día | Faltan el id y la URL canónica |
| Empleador, título, ciudad, hash de descripción | Media | Texto de plantilla idéntico entre equipos | La descripción es sustancial |
| Solo título y ciudad | Baja | Muchas vacantes reales comparten un título | Nunca, salvo como pista de revisión |
Fusiona con la clave más fuerte disponible y luego conserva las coincidencias más débiles como variant_urls en lugar de eliminarlas. Un registro fusionado debe retener cada URL que contribuyó a él, las marcas de tiempo de la primera y la última observación y la procedencia de cada campo.
Matriz de decisión de duplicados
| Situación | Fusionar | Motivo |
|---|---|---|
Misma canonical_url, distinta page_url | Sí | Una publicación alcanzada a través de dos páginas de listado |
Mismo empleador, título, ciudad y date_posted; distinto job_id | Sí, con variantes | Probablemente la misma vacante sindicada dos veces |
| Mismo empleador y título, distinta ciudad | No | La ubicación forma parte del rol |
Mismo empleador, título y ciudad, date_posted con más de 30 días de diferencia | No, salvo que coincida el hash de descripción | Una apertura posterior puede ser un rol nuevo genuino |
valid_through ya pasó pero la página sigue devolviendo 200 | Conservar, marcar expired | La página no se retiró según el calendario |
| Copia de agregador y página de empleo de la empresa | Fusionar en el registro de la empresa cuando ambos estén autorizados | La página de origen es el destino canónico preferible |
| La cadena de redirecciones termina en una nueva URL canónica | Fusionar y almacenar la cadena | La URL antigua ya no identifica la publicación |
Plan de ejecución y marcas de tiempo
El siguiente plan usa un objeto de contrato del sitio para que los selectores y la regla de preparación se nombren en un solo lugar. Los nombres son ilustrativos; sustitúyelos por el contrato acordado para el sitio permitido.
const contract = {
  list: "[data-testid='job-card']",
  detailLink: "a[data-testid='job-link']",
  next: "a[rel='next']",
};

const started = performance.now();
const response = await page.goto(listUrl, { waitUntil: 'domcontentloaded' });
await page.locator(contract.list).first().waitFor({ state: 'visible' });
const cards = page.locator(contract.list);
const count = await cards.count();
await page.waitForTimeout(250);
const stabled = await cards.count();
if (count !== stabled) throw new Error('card count changed before extraction');
const links = await cards.locator(contract.detailLink).evaluateAll(nodes => nodes.map(node => node.href));
Registra request_start, response_received, ready_signal y extract_done como marcas temporales separadas. Calcula la espera de preparación como ready_signal - request_start y el tiempo de extracción como extract_done - ready_signal. Si la ejecución informa una sola duración para la página, un selector lento y un servidor lento se vuelven indistinguibles. La documentación de optimización del rendimiento cubre el ajuste del entorno de ejecución para un despliegue existente; las marcas anteriores describen contra qué debería compararse ese ajuste.
Usa tres repeticiones del mismo accesorio e informa el mínimo, la mediana y el máximo de cada etapa en lugar de la mejor ejecución. Mantén las páginas fallidas en el denominador. Una página que agotó el tiempo antes de la preparación cuenta como una página intentada con un fallo de etapa, no como una publicación ausente.
Completitud y cobertura de campos
La completitud compara las publicaciones descubiertas con las publicaciones que informa la consulta permitida. Si la página uno dice 480 resultados a 40 por página, y la ejecución extrae 462 publicaciones únicas tras fusionar, informa 462 / 480 más el recuento de duplicados y el recuento de exclusiones. No eleves en silencio el numerador fusionando roles no relacionados ni reduzcas el denominador descartando páginas que fallaron.
La cobertura de campos es una proporción separada por campo. Informa date_posted presente en 440 de 462 registros, valid_through en 301 y jobLocation en 455. Una bolsa puede tener paginación completa y mala cobertura de campos, o lo contrario. Los dos números responden a preguntas distintas, y una única cifra de «éxito» oculta cuál falló.
Matriz de decisión de atribución
| Patrón en el registro | Interpretación que comprobar | Siguiente medición |
|---|---|---|
| Tarjetas presentes, JSON-LD ausente en todas las páginas de detalle | Puede que la bolsa no publique marcado | Confirmar en una segunda versión de plantilla antes de cambiar la extracción |
La espera de preparación crece mientras el estado sigue en 200 | Cambió la renderización en cliente o el peso de los scripts | Comparar las marcas de preparación en la misma versión del accesorio |
Las páginas 200 disminuyen en recuento sin un cambio de consulta | Límite de paginación o estado de filtros | Revisar la página uno y la cadena de enlaces siguientes |
429 aparece solo con mayor concurrencia | La tasa de solicitudes superó el límite del sitio | Reducir la concurrencia o solicitar una API |
403 aparece solo en rutas de cuenta | Se alcanzó el límite de autenticación | Excluir la ruta y revisar la lista de permitidos |
| La tasa de duplicados sube tras un cambio de plantilla | Nuevo patrón de URL o de id | Comparar las claves de fusión entre versiones |
| La cobertura de campos baja pero el recuento de tarjetas se mantiene | Desviación de marcado o de selectores | Comparar field_source por campo |
Lista de verificación previa a la ejecución
- Cada URL semilla es un listado público o una página de detalle pública, con una referencia de aprobación.
- Las rutas de cuenta, solicitud, currículum, mensajes y búsquedas guardadas quedan excluidas por la lista de permitidos.
- Se obtuvo
robots.txty se registró la regla aplicable. - La condición de preparación está escrita como un elemento visible más un recuento estable.
- La regla de detención de paginación incluye las URL visitadas y una firma de página repetida.
- La clave de fusión y las claves de respaldo más débiles se declaran antes de la extracción.
- El estado, los tiempos y el recuento a nivel de página se almacenan junto a los registros de publicación.
- Las páginas fallidas y excluidas permanecen en el denominador con un código de motivo.
- La ejecución se detiene ante un
401,403, una barrera de consentimiento, una página de desafío o un429. - El registro de la ejecución nombra la compilación del navegador, la ruta usada y la versión del accesorio.
FAQ
¿Basta el JSON-LD de JobPosting para identificar cada listado?
No. La cobertura varía según la bolsa y la plantilla, y algunas páginas renderizan tarjetas desde un objeto de estado interno sin ningún bloque de datos estructurados. Usa JSON-LD como fuente preferida, mantén un contrato DOM como respaldo y almacena field_source para que una caída de cobertura sea visible. Una página con tarjetas y sin nodo de publicación es una observación de marcado, no un fallo de acceso.
¿Debe detenerse la paginación en la primera página vacía?
Detente y luego verifica. Un contenedor vacío puede significar que la consulta se agotó, que un filtro redujo el conjunto o que el número de página fue fijado. Compara la firma de la página, el total anunciado y el enlace siguiente antes de registrar la ejecución como completa. Una sola página vacía es una condición de detención para las solicitudes, no prueba de que la consulta no devolvió nada.
¿Un perfil de navegador decide si la recopilación está permitida?
No. Únicamente el titular del sitio y el marco legal y contractual vigente pueden autorizar esa recopilación. Un perfil cambia las señales observables del navegador y un proxy cambia la ruta, pero ninguno satisface una regla de robots, una elección de consentimiento ni un límite de velocidad. La tabla de clases de acceso y la matriz de fallos son la superficie de decisión; la configuración del navegador queda aguas abajo de esa decisión.
Conclusión práctica
Empieza clasificando cada URL como listado público o datos autenticados, y elimina la segunda clase antes de cualquier solicitud. Luego define la señal de preparación, la regla de detención de paginación y la clave de fusión como un único contrato escrito. Mide la completitud y la cobertura de campos por separado, y atribuye cada fallo a la capa de estado, política o renderización que lo produjo.
La siguiente acción es pequeña: escribe la lista de permitidos y la referencia de aprobación para una consulta permitida de una bolsa de empleo pública, y luego confirma que la primera página devuelve 200 con un nodo JobPosting o el contrato DOM acordado. Todo lo demás en la ejecución depende de que ese límite se mantenga.
Fuentes
Este artículo forma parte de la guía: Despliegue y versión del navegador: mapa operativo
Artículos Relacionados
Scraping SERP a escala: requisitos del navegador
DesplieguePerfiles de navegador para monitoreo SEO y seguimiento SERP
DespliegueProtección de huellas del navegador para recopilar datos web
DespliegueCapturas fiables en navegadores headless
DespliegueEscalar contextos con perfiles Per-Context
RedMonitoreo de precios en ecommerce: la capa del navegador
Ejecuta la misma comprobación en BotBrowser
Carga un perfil, mantén dentro del navegador las señales que acabas de leer y confirma el resultado en tu propia máquina antes del despliegue.