Fuente aleatoria de crypto-js: qué rama usa tu build
Lee el código de crypto-js 4.2.0 y 3.1.2, y mide qué llamada de entropía hace cada versión, cuántas llamadas cuesta una petición y qué puede cambiar un objeto crypto simulado.
BotBrowser Team
Quieres la documentación estructurada de Huella digital?
Este artículo forma parte de la biblioteca editorial. Para pasos de configuración, material de referencia y actualizaciones continuas, entra en la sección de docs.
BotBrowser puede repetir un fixture autorizado del mismo origen bajo un perfil declarado y conservar observaciones acotadas sobre qué API llamó una página y con qué frecuencia, pero no puede inspeccionar el grupo de entropía del navegador, certificar la calidad del azar ni convertir un recuento de llamadas en una señal de identidad. Esta revisión lee dos compilaciones publicadas de crypto-js y luego mide la parte observable: qué llamada de entropía enlaza cada versión, cuánto cuesta una petición y qué puede sustituir un doble de prueba.
Resumen
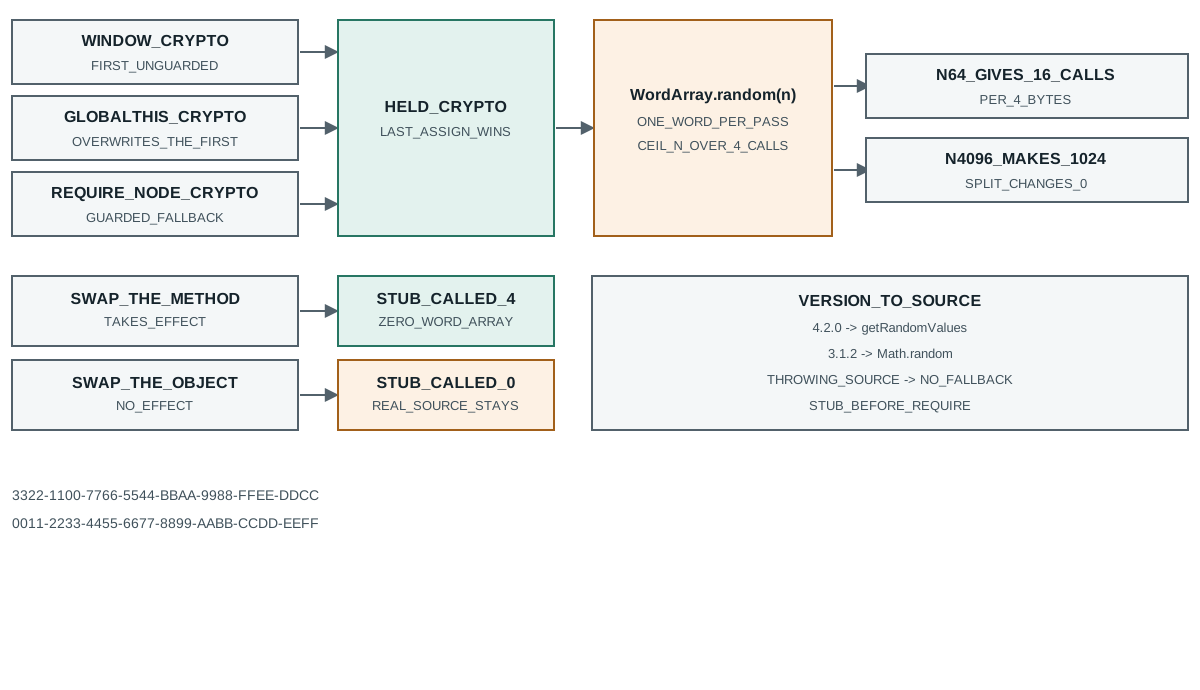
[email protected]llega acrypto.getRandomValuespor cada palabra que rellena;[email protected]llega aMath.random. La superficie de API parece idéntica, así que solo la fuente resuelta las distingue.- Una petición
WordArray.random(n)hace unasn / 4llamadas de entropía, así que 64 bytes cuestan dieciséis viajes al objeto crypto y no uno. - El bucle de enlace de
core.jsasigna tres globales sin comprobar si ya existe una fuente.globalThis.cryptosobrescribe un doble instalado enwindow.crypto, y por eso una prueba jsdom que solo simulawindow.cryptoobserva cero llamadas a su doble. - Después de cargar el módulo, sustituir el método en el objeto crypto retenido surte efecto; sustituir el objeto
globalThis.cryptocompleto no. - Un doble que lanza una excepción hace que
4.2.0emita su propio error genérico. No vuelve aMath.random.
Contenido
- Qué fuente de entropía enlaza cada compilación
- Cuánto cuesta una petición aleatoria
- Dónde pierde un doble frente a un global posterior
- De dónde sale el texto hexadecimal
- Qué toma del origen un cifrado con frase
- Registra una lectura de entropía de biblioteca
Qué fuente de entropía enlaza cada compilación
El core.js publicado de [email protected] empieza con una declaración var crypto; y luego ejecuta seis asignaciones en un orden fijo. El orden importa más que los comentarios que las acompañan, porque solo las tres últimas comprueban si ya se encontró una fuente.
// [email protected] core.js
if (typeof window !== 'undefined' && window.crypto) crypto = window.crypto;
if (typeof self !== 'undefined' && self.crypto) crypto = self.crypto;
if (typeof globalThis !== 'undefined' && globalThis.crypto) crypto = globalThis.crypto;
if (!crypto && typeof window !== 'undefined' && window.msCrypto) crypto = window.msCrypto;
if (!crypto && typeof global !== 'undefined' && global.crypto) crypto = global.crypto;
if (!crypto && typeof require === 'function') crypto = require('crypto');
Las tres primeras líneas no tienen guarda, así que cada una puede sobrescribir el resultado de la anterior. En un navegador, self y window son el mismo objeto, así que la segunda línea reescribe la primera sin cambiar nada. En un proceso Node que además define un objeto window, la tercera línea sobrescribe tanto la primera como la segunda con globalThis.crypto. Las líneas con guarda solo cuentan cuando no se encontró nada en absoluto.
Ese detalle explica un resultado de prueba que de otro modo parece imposible. Una suite jsdom suele definir globalThis.window = { crypto: doble } para controlar el azar, luego carga la biblioteca y vigila las llamadas al doble. En un proceso Node moderno la suite no ve ninguna, porque globalThis.crypto existe y la tercera línea sin guarda reemplaza el doble antes de que el módulo termine de cargarse.
La medición lo confirma. Dos procesos hijo arrancan igual salvo una línea, y cada uno cuenta llamadas al doble y a la fuente nativa durante una petición WordArray.random(16):
window stub with globalThis.crypto present -> {"stubCalls":0,"allZero":false}
window stub with globalThis.crypto absent  -> {"stubCalls":4,"allZero":true}
En el primer caso el doble no recibió nada y el objeto crypto real recibió cuatro llamadas. En el segundo, con globalThis.crypto en undefined antes de la carga, el doble recibió las cuatro y produjo un arreglo de palabras todo ceros, que es lo que debe producir un doble que rellena con bytes cero.
Las dos versiones de la biblioteca están en lados distintos de la misma API. Ambas exponen CryptoJS.lib.WordArray.random(nBytes), y el objeto resultante tiene la misma forma en las dos, así que una prueba que solo comprueba sigBytes pasa con cualquiera. Instrumentar las dos fuentes en un mismo proceso las separa:
one call each in one process: getRandomValues=4 (v4.2.0) Math.random=4 (v3.1.2)
v3.1.2 random(16): Math.random=4
Cuatro llamadas a getRandomValues en la compilación moderna y cuatro a Math.random en 3.1.2, para la misma petición de 16 bytes. El ayudante heredado lee Math.random() y lo escala a un entero de 32 bits; el moderno pide new Uint32Array(1) al objeto crypto y toma el elemento cero. Ninguna ruta es visiblemente más lenta para una página, y ninguna cambia el tipo devuelto, así que el número de versión en package.json es la única forma barata de saber cuál contiene un paquete empaquetado.
Cuánto cuesta una petición aleatoria
El ayudante de palabras rellena una palabra de 32 bits por pasada, así que el número de iteraciones sigue directamente al número de bytes pedido. Medir el objeto crypto en lugar del reloj hace visible la regla:
v4.2.0 random(4) -> getRandomValues calls=1
v4.2.0 random(16) -> getRandomValues calls=4
v4.2.0 random(64) -> getRandomValues calls=16
Dieciséis llamadas para una petición de 64 bytes, no una. El coste es Math.ceil(n / 4) para un entero positivo, y la cuota del navegador se aplica por llamada y no por petición, así que el límite práctico son 16.384 llamadas de cuatro bytes y no 65.536 bytes en una sola llamada. Un flujo de trabajo que genera mucho material aleatorio en un bucle paga por tanto muchas comprobaciones pequeñas de cuota en vez de una grande.
Esa regla tiene una consecuencia directa para un fixture que quiere mantenerse dentro de la cuota. Cuatro mil noventa y seis bytes cuestan mil veinticuatro viajes al objeto crypto, y dividir ese presupuesto en ocho llamadas de quinientos doce bytes cuesta el mismo total, porque cada una de esas llamadas se divide a su vez en ciento veintiocho palabras de cuatro bytes. Agrupar en el límite de la API no reduce el número de llamadas de entropía; solo el total de bytes lo hace. Un bucle que genera mucho material de clave en una prueba alcanzará la cuota con el mismo tamaño total, pida un arreglo o muchos.
El otro lado de la misma regla es el tiempo. En el equipo medido mil peticiones de treinta y dos bytes terminaron en pocos milisegundos, lo bastante poco para que el coste del bucle sea invisible junto al de aquello para lo que se usa el material. Por eso el recuento de llamadas, y no la duración, es lo útil que registrar: la duración se mueve con la máquina y la carga, y el recuento no.
Tamaños fraccionarios e inválidos muestran el borde del bucle, y ninguno lanza:
random(0) -> words=0 sigBytes=0 hexLen=0
random(4) -> words=1 sigBytes=4 hexLen=8
random(4.5) -> words=2 sigBytes=4.5 hexLen=10
random(16) -> words=4 sigBytes=16 hexLen=32
random(-1) -> words=0 sigBytes=-1 hexLen=0
Una petición negativa devuelve un arreglo de palabras vacío cuyo sigBytes es -1, y el codificador hexadecimal no emite nada en lugar de lanzar. Quien confíe en sigBytes como comprobación de longitud obtiene un valor que es falso pero no cero, justo el tipo de valor que pasa una condición if (words.sigBytes) y falla después en un serializador.
Para una petición bien formada la longitud de salida es estable. Cinco mil peticiones de dieciséis bytes en un proceso produjeron treinta y dos caracteres hexadecimales todas las veces:
5000 calls of random(16): hex length min=32 max=32
Esa estabilidad merece decirse porque separa dos cosas que una prueba podría confundir. Una longitud fija demuestra que el codificador es coherente; no dice nada del azar detrás de los caracteres. Ambas afirmaciones necesitan evidencia distinta, y solo la primera es barata de comprobar.
Dónde pierde un doble frente a un global posterior
Simular la fuente aleatoria es práctica normal en una suite determinista, y el fallo es sutil: el doble está instalado, las aserciones pasan y el doble nunca se llamó. Dos colocaciones se comportan distinto cuando el módulo ya está cargado.
post-load swaps -> {"methodSwapAllZero":true,"objectSwapAllZero":false}
Sustituir getRandomValues en el objeto que la biblioteca ya retiene cambia el siguiente resultado, y el arreglo de palabras vuelve todo ceros. Sustituir globalThis.crypto por un objeto nuevo después no cambia nada, porque la biblioteca conservó una referencia al objeto que resolvió durante la carga y nunca vuelve a mirar el global. La primera forma es la que una prueba puede usar; la segunda deja la fuente real en su sitio sin avisar.
El orden importa por la misma razón. Una suite que fija globalThis.window.crypto y luego carga la biblioteca pelea con la tercera asignación sin guarda. Fijar o limpiar globalThis.crypto antes de la carga es la colocación que llega al bucle de enlace en el momento en que se ejecuta.
Qué ocurre cuando el objeto crypto existe pero rechaza es un tercer comportamiento distinto. Un doble cuyo getRandomValues siempre lanza produjo esto:
getRandomValues always throws -> threw: Native crypto module could not be used to get secure random number.
La biblioteca absorbe el error original y lanza su propio mensaje. El nombre que tuviera el fallo de cuota ya no está cuando el llamador lo ve, así que una página que quiera distinguir un problema de cuota de una fuente ausente tiene que inspeccionar el objeto crypto y no el error que lanza la biblioteca. Igual de importante, 4.2.0 no vuelve a Math.random en ese caso. El riesgo de degradación silenciosa pertenece a 3.1.2, donde Math.random es la fuente y no el respaldo.
Un llamador aún puede separar ambos fallos sin leer la biblioteca. Comprueba si el objeto crypto expone getRandomValues antes de la petición; si lo hace, el error lanzado vino de la fuente y no de un enlace ausente. Esa comprobación cuesta una lectura de propiedad y convierte un error ambiguo en una decisión, que es lo que un fixture necesita para registrar source-missing aparte de source-refused.
De dónde sale el texto hexadecimal
El arreglo de palabras guarda palabras de 32 bits, y el codificador hexadecimal las lee del byte más significativo al menos. Nada en ese paso depende de la versión; lo que varía es cómo un grupo de cuatro bytes se convierte en palabra. Pasar los mismos dieciséis bytes de entropía por dos interpretaciones hace visible el efecto: La misma frontera de agrupación aparece cuando el texto se codifica para transporte: límites de btoa y atob muestra cómo una cadena de bytes y una de caracteres divergen y por qué un paso de decodificación es obligatorio antes de que el texto coincida.
entropy bytes: 00112233445566778899aabbccddeeff
WordArray(little-endian words, as the randomBytes branch) -> 3322110077665544bbaa9988ffeeddcc
WordArray(big-endian words)                               -> 00112233445566778899aabbccddeeff
endianness changes the hex: true
Ambas ejecuciones consumieron bytes idénticos y produjeron texto distinto. La diferencia es la regla de agrupación, no la entropía: una lectura trata cada grupo de cuatro bytes como little-endian, la otra como big-endian, y el codificador imprime fielmente el valor de 32 bits que recibió. Una comparación entre dos equipos que agrupan distinto informa por tanto de una diferencia que no tiene nada que ver con el azar.
La forma con signo no añade una segunda diferencia. Las palabras -1146447480 y -1122868 y sus equivalentes sin signo 3148519816 y 4293844428 codifican a los mismos dieciséis caracteres hexadecimales, porque el codificador enmascara cada byte:
signed words [-1146447480,-1122868] -> bbaa9988ffeeddcc
unsigned words [3148519816,4293844428] -> bbaa9988ffeeddcc
sign is lost in the hex: true
Por eso la rama Node, que lee cuatro bytes con readInt32LE() y puede producir palabras negativas, sigue coincidiendo con la rama de navegador en un equipo little-endian. El equipo medido informó little-endian, y en él ambas ramas forman las mismas palabras con los mismos bytes. Un equipo big-endian no lo haría, porque la rama de navegador toma la interpretación de máquina de un elemento Uint32Array mientras la rama Node fija little-endian de forma explícita. Esa última frase es una lectura de los dos caminos de código, no una medición: aquí solo se ejecutó el caso little-endian, y el caso big-endian queda como comprobación abierta para quien tenga ese hardware.
La lección práctica para una comparación entre equipos es más estrecha de lo que parece. Si dos equipos ejecutan la misma compilación y ambos son little-endian, la rama no importa y el hexadecimal coincide. Si las versiones difieren, cambia la fuente y el hexadecimal coincide solo por casualidad. Una diferencia entre dos artefactos dice cuál de las dos variables se movió solo cuando el orden de bytes se registra al lado, que es un campo más que el registro necesita.
Qué toma del origen un cifrado con frase
AES.encrypt tiene dos formas de entrada parecidas que usan la fuente aleatoria de modo distinto. Pasar una cadena como clave hace que la biblioteca derive clave e IV, y ese camino genera primero una sal. Pasar una clave ya analizada con un IV explícito omite la derivación.
AES.encrypt(passphrase) -> getRandomValues calls=2
AES.encrypt(key+iv) -> getRandomValues calls=0
passphrase output header="Salted__" saltBytes=8
explicit key+iv deterministic across runs: true
Ocho bytes de sal cuestan dos llamadas, lo que concuerda con la regla de una palabra por pasada. La cadena de salida lleva la sal de ocho bytes delante del texto cifrado tras una cabecera fija, así que dos ejecuciones con la misma frase y el mismo texto claro difieren solo en esos ocho bytes y en todo lo derivado de ellos. La forma con clave explícita hizo cero llamadas y produjo salida idéntica en dos ejecuciones, que es la propiedad que una prueba determinista necesita y la que un artefacto guardado no debe tener.
Los dos valores por defecto de derivación de clave también están muy lejos en coste. El camino de frase usa una derivación compatible con OpenSSL con una iteración por defecto, mientras el ayudante PBKDF2 independiente usa 250.000:
EvpKDF keySize=12 iterations=1: 0.06 milliseconds
PBKDF2 default iterations=250000: 851 milliseconds
Ambas cifras vienen de un equipo y se mueven con la carga, así que trátalas como orden de magnitud y no como referencia. Lo que sostienen es estable: elegir el ayudante de frase para un artefacto guardado compra una sal y una derivación rápida, no lenta, y subir el número de iteraciones es una decisión aparte que el llamador tiene que tomar explícitamente.
Registra una lectura de entropía de biblioteca
Una lectura que sobrevive a una revisión nombra sus entradas y sus límites. Seis campos cubren la parte observable sin guardar material generado:
- El nombre del paquete y la versión exacta, más el archivo que aporta el ayudante de palabras, porque el orden de enlace es propiedad de ese archivo.
- Los recuentos por fuente,
getRandomValuesyMath.random, sobre una petición de tamaño declarado. - El tamaño de la petición y el
sigBytesresultante, para poder contrastar el recuento con la regla de una palabra por pasada. - El orden de bytes del equipo, porque decide si las dos ramas coinciden en el texto.
- Si el doble se instaló antes o después de cargar el módulo, y qué objeto sustituyó.
- El texto de error producido cuando el objeto crypto rechaza, incluido si sobrevivió el nombre original.
Ese registro es contra lo que una suite puede aseverar, y sigue siendo lo bastante pequeño para una nota de revisión. Lo que no puede sostener es ninguna afirmación sobre calidad del azar, unicidad o lo que una página informaría de la máquina. Un recuento de llamadas es una forma, no una medición de entropía, y una longitud hexadecimal estable es propiedad del codificador y no evidencia sobre la fuente. Para el contrato del lado del navegador al que llegan estas llamadas, consulta observabilidad del azar criptográfico y huellas del navegador, y para un colector fijado que separa los resultados por componente de su propio resumen, consulta recolección y procedencia de FingerprintJS OSS.
Dos hábitos mantienen honesta una lectura de biblioteca con el tiempo. Primero, repite el recuento tras cualquier actualización de dependencia, porque un cambio de versión puede cambiar la fuente sin cambiar la API; es exactamente la diferencia entre 3.1.2 y 4.2.0. Segundo, registra la comprobación que fallaría si cambiara el orden de enlace, que aquí es el recuento de llamadas al doble con y sin un global nativo. Un registro que solo guarda la longitud producida no detecta ninguno de los dos cambios.
Fuentes públicas
- Código de crypto-js: core.js
- Versiones de crypto-js
- MDN: Crypto.getRandomValues
- Especificación de la API Web Cryptography
- MDN: Math.random
Conclusión
Lee el core.js etiquetado de la compilación que realmente publicas y luego cuenta las llamadas que recibe cada fuente en una petición de tamaño conocido. Anota la versión, los recuentos, el orden de bytes y la colocación del doble. Trata el texto producido como resultado del codificador, deja la entropía fuera del registro y repite el recuento cada vez que se mueva la dependencia.
Este artículo forma parte de la guía: ¿Qué es la huella digital del navegador?
Artículos Relacionados
Observabilidad de aleatoriedad criptográfica y huellas del navegador
Huella digitalClient Hints Fingerprinting: encabezados HTTP e identidad
Huella digitalUnicode: cuatro identidades de texto que lee una página
Huella digital¿Qué es la huella de fuentes? Coherencia de texto entre plataformas
Huella digitalBotD: qué detectores se ejecutan de verdad
Huella digitalCómo hardwareConcurrency revela los núcleos reales de tu CPU
Lleva BotBrowser de la investigación a producción
Usa estas guías para entender el modelo y después avanzar hacia validación multiplataforma, contextos aislados y despliegue de navegador preparado para escalar.