Qué prueban realmente las suites de detección públicas
Dos suites públicas publican 49 pruebas entre ambas. Leer sus propios catálogos muestra que 11 leen la conexión y que cuatro nombres compartidos se clasifican distinto.
BotBrowser Team
Quieres la documentación estructurada de Huella digital?
Este artículo forma parte de la biblioteca editorial. Para pasos de configuración, material de referencia y actualizaciones continuas, entra en la sección de docs.
BotBrowser mantiene un perfil declarado coherente en las superficies que una página puede leer y puede guardar un registro acotado de lo que la página reportó, pero no puede hacer que la lista de pruebas de una suite pública describa capas que esa suite nunca abre, ni puede hacer que dos suites coincidan sobre lo que significa un nombre de prueba. Este análisis lee dos suites públicas de detección desde sus propias páginas, cuenta lo que ofrece cada una y registra qué pruebas sitúan sus propios encabezados en la conexión y no en el documento, porque esa separación decide qué puede sostener un informe limpio de cualquiera de los dos sitios.
Resumen
- BrowserLeaks publica 25 rutas de prueba y BrowserScan publica 24, es decir 49 entradas sin ponderar cuánto trabajo hace cada una.
- Leyendo los encabezados de cada página, 7 rutas de BrowserLeaks y 4 de BrowserScan nombran una cantidad de la conexión, como un apretón de manos, una lista de cifrados, una trama HTTP/2 o una cabecera TCP.
- Eso deja 17 y 18 rutas cuyas secciones publicadas se quedan dentro del documento, más 1 y 2 rutas que no renderizan ninguna sección.
- Los dos catálogos comparten 5 nombres de ruta: WebRTC, canvas, TLS, WebGPU y client hints. Difieren en 20 y 19 rutas respectivamente.
- El nombre compartido TLS es el único que ambas suites clasifican como prueba de conexión.
- Los otros cuatro nombres compartidos se clasifican de forma distinta, y en cada caso la diferencia es de qué hablan las secciones de la página.
- BrowserScan repite 83 encabezados de navegación compartida en cada página, así que un recuento bruto exagera cuánto dice cada prueba.
- 3 páginas entre las dos suites no renderizan encabezados de sección, y la ejecución las informa como ilegibles en lugar de adivinar qué prueban.
Contenido
- Qué publica cada suite
- Dónde aparece la conexión en una página de prueba
- Por qué un nombre puede significar dos pruebas
- Qué puede sostener un informe limpio de una suite
- Cómo fallan de forma distinta los tres grupos
- Registrar una lectura de suite
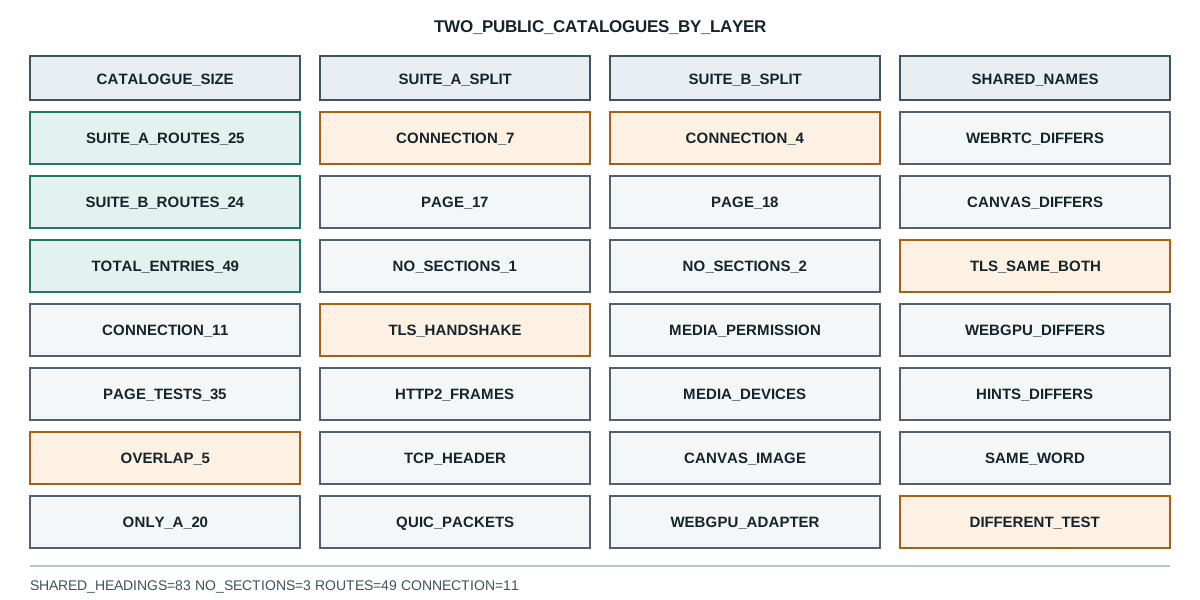
Qué publica cada suite
Ambos sitios publican su lista de pruebas como navegación, lo que hace legible el catálogo sin ejecutar nada. La sonda descarga cada portada, extrae todas las rutas internas, luego descarga cada ruta y conserva solo los encabezados de sección que la propia página añade: Un catálogo de suites públicas es otro objeto que un registro de una biblioteca: qué prueban realmente las suites de detección públicas cuenta 25 y 24 rutas publicadas y halla 11 que nombran la conexión. Un catálogo público y un registro de una sola biblioteca son objetos distintos, y el registro de detectores de BotD y los estados de componentes muestra la forma de registro mientras los grupos de señales de CreepJS y cómo los combina muestra un pliegue por grupos.
node=v26.9.0
parallel_pool=4
suite:BrowserLeaks -> front_status=200 bytes=12700 routes=25
suite:BrowserLeaks -> shared_chrome_headings=0
suite:BrowserLeaks -> routes=/ip /javascript /webrtc /canvas /webgl /fonts /geo /features /tls /proxy /settings /quic /http2 /tcp /chrome /webgpu /client-hints /dns /css /rects /donottrack /flash /silverlight /java /resource-urls
suite:BrowserScan -> front_status=200 bytes=134999 routes=24
suite:BrowserScan -> shared_chrome_headings=83
Las dos portadas difieren en tamaño por un factor de diez, y esa diferencia aparece en los encabezados compartidos. BrowserLeaks renderiza su menú sin etiquetas de encabezado, así que cada encabezado de una página de prueba pertenece a esa página. BrowserScan repite 83 encabezados de navegación en cada ruta, y restarlos es la diferencia entre leer una prueba y leer el menú.
Esa resta no es cosmética. Antes de hacerla, cada ruta de BrowserScan parecía una prueba de conexión, porque el menú compartido contiene las palabras DNS, HTTP2, SSL y TLS. Quien cuente encabezados sin quitar el bloque compartido concluiría que las 24 rutas prueban la conexión, y el número sería un artefacto de la plantilla.
Los tamaños también dicen algo sobre cómo está construida cada suite. Una portada de 12,700 bytes que lista 25 rutas es un directorio: nombra las pruebas y envía al lector hacia adelante. Una portada de 134,999 bytes con 83 entradas de navegación que llevan encabezado es un armazón de aplicación, y cada ruta lo hereda. Ambas decisiones son legítimas y producen problemas de medición distintos. En el directorio, el recuento de rutas se acerca al recuento de pruebas. En el armazón, el lector tiene que separar el armazón de la página antes de que cualquier recuento signifique algo, y quien no lo hace informa un número que pertenece a la plantilla.
Dónde aparece la conexión en una página de prueba
El clasificador lee los encabezados propios de cada página y marca una página como prueba de conexión cuando un encabezado nombra una cantidad que existe en el cable: un apretón de manos, una lista de cifrados, un client hello cifrado, una trama HTTP/2 o HTTP/3, un paquete QUIC, una cabecera IPv4 o TCP, un tamaño de segmento, un intercambio DNS o una dirección de proxy.
wire:BrowserLeaks/tls -> sections=5 TLS Fingerprint | TLS Handshake | Encrypted Client Hello | Supported Cipher Suites (in order as received)
wire:BrowserLeaks/http2 -> sections=2 HTTP/2 Fingerprint | HTTP/2 Frames
wire:BrowserLeaks/tcp -> sections=5 TCP/IP Fingerprint | IPv4 Header | TCP Header | Maximum Segment Size
wire:BrowserLeaks/quic -> sections=8 QUIC Fingerprint | QUIC Connection | QUIC Initial Packets | TLS Handshake
wire:BrowserScan/tls -> sections=7 HTTP/2 Fingerprint | TLS Fingerprint | TLS handshake | TLS protocol
split:BrowserLeaks -> wire=7 page=17 unreadable=1 total=25
split:BrowserScan -> wire=4 page=18 unreadable=2 total=24
Siete y cuatro. De 49 entradas publicadas, 11 nombran una cantidad de la conexión en sus propias secciones. El resto describe cosas que un script lee: el renderizado de canvas, las métricas de fuentes, el adaptador WebGPU, la zona horaria, el agente de usuario, el estado de permisos.
Esa proporción es la parte útil de la medición, y es menor de lo que sugieren los catálogos. Una suite que publica 25 rutas invita a leer que comprueba 25 cosas de un navegador. Lo que hace en realidad es comprobar 17 cosas que una página reporta, 7 cosas que reporta una conexión y 1 cosa para la que no renderiza secciones. Los tres grupos responden preguntas distintas, y una sola insignia de aprobado o fallo sobre ellos oculta qué grupo produjo el resultado.
Por qué un nombre puede significar dos pruebas
El solapamiento entre catálogos es de cinco nombres:
overlap -> shared=5 webrtc canvas tls webgpu client-hints
overlap -> BrowserLeaks_only=20 BrowserScan_only=19
Cinco nombres compartidos de 49 entradas es el primer hallazgo: las dos suites son en su mayoría productos distintos con un núcleo común pequeño. El segundo hallazgo es lo que ocurre dentro de ese núcleo.
Los cinco que sí se solapan son los que un navegador puede responder barato desde una página: qué renderiza en un canvas, qué reporta de su adaptador gráfico, qué dice en sus client hints, qué produce una pasada de recolección ICE y cómo se ve su apretón de manos. Las 39 rutas que solo publica una suite son las que exigen una decisión sobre qué medir. Una suite publica páginas para objetos JavaScript, fuentes, geolocalización, consultas de medios, rectángulos de elementos, Do Not Track y tiempos de recursos. La otra publica páginas para escaneo de puertos, vulnerabilidad de versión del navegador, lecturas de giroscopio, zona horaria frente a ubicación IP y permisos de dispositivos multimedia. Ninguna lista es un superconjunto, así que quien elige una suite elige qué preguntas hacer, no qué sitio es más completo.
wire:BrowserScan/tls -> sections=7 HTTP/2 Fingerprint | TLS Fingerprint | TLS handshake | TLS protocol
page:BrowserLeaks/canvas -> sections=11 Canvas Support Detection | Canvas Fingerprint | Image File Details
page:BrowserScan/canvas -> sections=5 Canvas Function Detection | Image Details | The reason for the generation of Canvas fingerprints.
page:BrowserLeaks/webrtc -> sections=8 Your Remote IP | WebRTC Support Detection | Your WebRTC IP
page:BrowserScan/webrtc -> sections=24 After authorizing media device permissions, WebRTC will leak local IP | Media Devices API Support | Audio Permissions
TLS es el único nombre compartido que ambas suites sitúan en la conexión, y ambas nombran un apretón de manos y una huella en sus secciones. Canvas es prueba de página en ambas, y ambas hablan de la imagen renderizada y sus detalles. Esos dos son consistentes.
WebRTC es donde diverge la clasificación. BrowserLeaks titula sus secciones con Your Remote IP y Your WebRTC IP, que son valores que la página reúne. BrowserScan titula con permisos de dispositivos multimedia y una afirmación de que WebRTC filtrará una dirección local tras la autorización. El mismo nombre de ruta describe una dirección reunida por la página en un sitio y una ruta de medios condicionada por permisos en el otro.
WebGPU y client hints divergen igual. La página de WebGPU de BrowserScan nombra un informe de adaptador y un resumen del informe; la de BrowserLeaks nombra detección de soporte y una huella, que son lecturas del lado de la página. Para client hints, BrowserLeaks separa la API de JavaScript de las cabeceras HTTP, y BrowserScan lista el agente de usuario y el soporte de API. Quien compare los dos sitios por nombre de ruta estaría comparando mediciones distintas.
Esa es la consecuencia práctica de un vocabulario compartido sin una definición compartida. Una prueba llamada canvas en un sitio y canvas en otro no establece lo mismo, y un informe que cita "la prueba de canvas" sin decir qué suite la produjo deja al lector sin saber cuál de las dos mediciones se hizo.
El mismo problema aparece dentro de una sola suite, y por eso los encabezados de sección importan más que los nombres de ruta. Una página de canvas que reporta la imagen renderizada y los detalles del archivo mide salida de renderizado. Una página de canvas que reporta detección de funciones y la razón por la que se genera una huella describe una capacidad y su mecanismo. Ambas son útiles, y un resultado de una no responde la pregunta de la otra. Leer los encabezados es lo que las separa, y es por lo que la sonda conserva la lista de encabezados junto a la clasificación y no solo el recuento.
Qué puede sostener un informe limpio de una suite
La sonda informa wire=7 para un catálogo y wire=4 para el otro, así que 11 de las 49 entradas publicadas llegan a la conexión en esta fecha.
wire:BrowserLeaks/ip -> sections=5 IPv6 Leak Test | DNS Leak Test | TCP/IP Fingerprint | TLS Fingerprint
wire:BrowserLeaks/proxy -> sections=1 Proxy Detection
wire:BrowserLeaks/dns -> sections=1 DNS Leak Test
wire:BrowserScan/dns-leak -> sections=4 Introduction to DNS Leak Test | How DNS leaks happen | How to perform a DNS leak test | How to Fix a DNS Leak
Las pruebas de conexión tampoco tienen todas la misma forma. Algunas son páginas de una sola sección que reportan un valor, como la de detección de proxy, y otras llevan una explicación junto a la medición, como la de fuga de DNS con su introducción, su mecanismo y sus pasos de remediación. Una página con una explicación larga y una con un solo campo medido cuentan como una ruta en el catálogo, así que recuento de rutas y cobertura no son el mismo número.
Esa diferencia decide cuánto vale una página de resultados. Una página de una sola sección que reporta un valor es una medición sin contexto: el lector recibe un número y tiene que saber cuál debería haber sido. Una página con introducción, mecanismo y remediación es una medición más un argumento sobre lo que el número significa. Para un equipo que valida un perfil declarado, el primer tipo es un hecho que comparar y el segundo es una afirmación que verificar, y un informe que trata ambos como una sola insignia pierde la distinción.
Hay una tercera forma que conviene nombrar, porque es la que engaña más fácil. Una página puede renderizar secciones que describen una prueba sin que la página la realice, y la clasificación de la sonda sigue a las secciones. La página de versión del navegador es el caso más claro: sus encabezados describen una declaración de vulnerabilidad y un agente de usuario, que son hechos legibles por la página, y la medición que sostiene es sobre alineación de versión y no sobre el contenido del documento. Quien vea una advertencia de versión y la trate como una señal de automatización ha leído un hecho de página como si fuera un veredicto.
Hay un límite que conviene decir. La sonda lee lo que cada página publica como sus secciones, que es la descripción de la suite sobre lo que mide. No ejecuta los scripts de las suites, así que una página cuyas secciones se quedan dentro del documento puede aún leer una cabecera en código que sus secciones no mencionan. La clasificación describe lo que la suite dice que prueba, que es lo que un lector usa al elegir una suite, y no sustituye leer un resultado concreto contra un perfil concreto.
El mismo límite se aplica en la otra dirección. Una página cuyas secciones nombran un apretón de manos no es por ello una auditoría completa de la conexión, porque las secciones son una lista de lo que la página muestra, no de todos los campos que inspecciona. Lo que la separación sí establece es el tamaño de la diferencia entre los dos grupos: 11 rutas nombran la conexión y 35 se quedan en el documento, y esos dos grupos no se pueden leer como una sola puntuación.
Dos de las rutas que no renderizan nada ilustran el límite desde otro lado. Una página de ajustes y un índice de herramientas devuelven 200 con decenas de kilobytes de marcado y ningún encabezado de sección, y una página de comentarios hace lo mismo. Ninguna de las tres es una prueba, y ninguna es una medición, así que la ejecución las informa como ilegibles en lugar de asignarlas a un grupo. Esa elección mantiene honesto el denominador: contarlas como pruebas de página inflaría el total del lado de la página, y contarlas como pruebas de conexión inflaría el lado que lleva las afirmaciones más pesadas.
Cómo fallan de forma distinta los tres grupos
Los tres grupos tienen modos de fallo distintos, y saber de qué grupo vino un resultado dice al lector cómo interpretar un cambio.
Los recuentos de wire y page se mueven de forma independiente, así que una ejecución que desplaza un grupo no dice nada del otro. Las tres rutas que no renderizan secciones muestran por qué la clasificación las mantiene aparte: una página de ajustes, un índice de herramientas y una página de comentarios devuelven 200 con 12,047, 58,935 y 50,936 bytes y ningún encabezado, y ninguna de las tres es una prueba.
Una prueba de página cambia cuando cambia el documento. Un renderizado de canvas distinto, una lista de fuentes distinta, una zona horaria distinta o un estado de permisos distinto aparecen como un valor de página distinto, y el mismo valor en dos ejecuciones significa que el documento fue el mismo en ambas. Eso hace que las pruebas de página sean buenas para detectar deriva dentro de un entorno y débiles para comparar entornos, porque dos máquinas que coinciden en cada prueba de página pueden diferir en cómo llegaron al sitio.
Una prueba de conexión cambia cuando cambia la conexión. Un orden de cifrados distinto, una lista de protocolos distinta, un conjunto de cabeceras distinto o una dirección de salida distinta aparecen en el cable, y el documento puede ser idéntico en dos ejecuciones que difieren en todo eso. Eso hace que las pruebas de conexión sean buenas para comparar entornos y débiles para detectar deriva dentro de uno, porque una conexión estable no oculta nada del documento y una cambiada no dice qué superficie de la página se movió.
Una página sin secciones no es una medición. Es una página, y la ejecución lo informa así. Quien la sume a cualquiera de los grupos está eligiendo una respuesta que la página no dio.
Esa es toda la razón para medir la separación antes de ejecutar una suite y no después. Un equipo que planea validar un perfil declarado con una suite pública puede mirar el catálogo primero y ver que la mayor parte de lo que la suite reporta describirá el documento. Esa es una comprobación útil, y no es la comprobación que el equipo se propuso hacer. La brecha entre las dos es el número que informa la sonda, y es 11 de 49 en esta fecha.
Registrar una lectura de suite
Una lectura de suite sostiene una afirmación estrecha: este catálogo, leído en esta fecha, se divide así. Cuatro campos la mantienen comprobable:
- El resumen de la portada, porque una suite que añade o quita una ruta cambia cada recuento de esta página sin cambio alguno en un navegador.
- El bloque de encabezados compartidos, porque una plantilla que repite su menú como encabezados infla cada recuento por página hasta que se resta.
- La regla de clasificación, porque la frontera entre prueba de página y prueba de conexión es una decisión, y otra regla produce otra separación.
- Las rutas que no renderizan secciones, porque una página que no dice nada en encabezados no es lo mismo que una página que no prueba nada.
Fuentes públicas
- BrowserLeaks
- BrowserLeaks TLS client test
- BrowserLeaks HTTP/2 fingerprinting
- BrowserScan
- BrowserScan HTTP2, SSL and TLS fingerprint
- BotBrowser: referencia de coherencia de automatización
Conclusión práctica
Separa en el informe lo medido en el documento de lo medido en la conexión antes de tratar un resultado limpio como amplio. Los catálogos aquí publican 49 entradas, y 11 de ellas nombran una cantidad de la conexión en sus propias secciones, así que una suite que parece completa en su portada está leyendo sobre todo lo que una página reporta. Cuando dos suites comparten un nombre de ruta, trata el nombre como una etiqueta y no como una definición, porque cuatro de los cinco nombres compartidos aquí describen mediciones distintas en los dos sitios. Sobre lo que una sola biblioteca hace con las señales que recoge antes de cualquier veredicto, lee los grupos de señales de CreepJS y cómo los combina; sobre las reglas que una página no puede evaluar en absoluto, lee las reglas de capa de red que una página no puede evaluar.
Este artículo forma parte de la guía: ¿Qué es la huella digital del navegador?
Artículos Relacionados
Reglas de capa de red que una página no puede evaluar
Huella digitalBotD: qué detectores se ejecutan de verdad
Huella digitalGrupos de señales de CreepJS y cómo los combina
Huella digitalPor qué una señal rara no condena a un navegador
Huella digitalperformance.now: resolución del reloj y fingerprinting
Huella digitalDetección de modo sin cabeza en CreepJS: tres veredictos
Lleva BotBrowser de la investigación a producción
Usa estas guías para entender el modelo y después avanzar hacia validación multiplataforma, contextos aislados y despliegue de navegador preparado para escalar.