公开检测站点到底在测什么
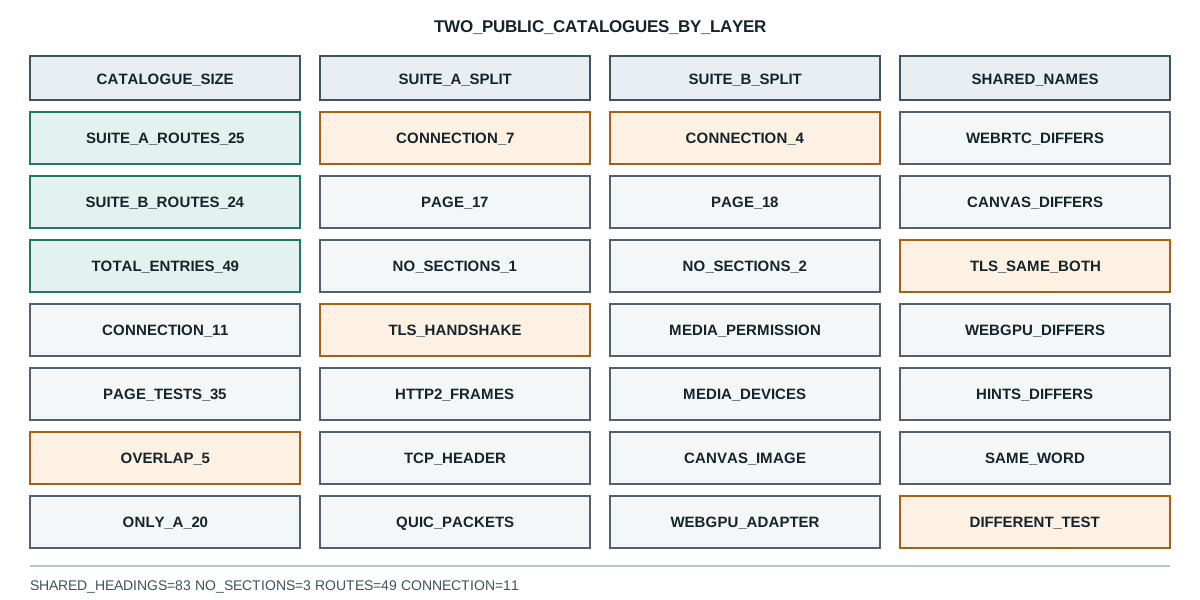
两个公开检测站合计发布 49 项测试。读它们自己的目录可见只有 11 项读连接,而有四个同名项在两边被归到不同层。
BotBrowser Team
BotBrowser 让声明好的配置文件在页面能读到的各个表面保持一致,并能保留一份页面自述环境的有限记录,但它不能让一个公开检测站的测试清单去描述该站从不打开的那些层,也不能让两个站对同一个测试名达成一致。两个公开检测站的目录从它们自己的页面读取:统计各自提供了多少项,并记录哪些测试按它们自己的分节标题属于连接层而不是文档层,因为这个划分决定了任何一边的干净报告能支撑什么。
摘要
- BrowserLeaks 发布 25 条测试路径,BrowserScan 发布 24 条,合计 49 项,且没有按每项的工作量加权。
- 读每页自己的分节标题,BrowserLeaks 有 7 条、BrowserScan 有 4 条路径点名了连接层数量,例如握手、密码套件列表、HTTP/2 帧或 TCP 头。
- 剩下 17 条和 18 条路径的分节都停在文档内部,另有 1 条和 2 条路径完全没有分节。
- 两份目录共享 5 个路径名:WebRTC、canvas、TLS、WebGPU 与 client hints。各自独有 20 条和 19 条。
- 共享名里只有 TLS 被两边同时归为连接测试。
- 另外四个共享名被归到不同类,而且差异都出在页面自己的分节在讲什么。
- BrowserScan 在每一页重复 83 个导航标题,所以不扣除的标题计数会高估每项测试说了多少。
- 两站合计有 3 个页面完全不输出分节标题,运行把它们记为不可读,而不是猜测它们测什么。
目录
每个站发布了什么
两个站都把测试清单当导航发布,所以不执行任何脚本就能读到目录。探针抓取每个首页,取出全部站内路径,再抓取每条路径,只保留页面自己新增的分节标题:
node=v26.9.0
parallel_pool=4
suite:BrowserLeaks -> front_status=200 bytes=12700 routes=25
suite:BrowserLeaks -> shared_chrome_headings=0
suite:BrowserLeaks -> routes=/ip /javascript /webrtc /canvas /webgl /fonts /geo /features /tls /proxy /settings /quic /http2 /tcp /chrome /webgpu /client-hints /dns /css /rects /donottrack /flash /silverlight /java /resource-urls
suite:BrowserScan -> front_status=200 bytes=134999 routes=24
suite:BrowserScan -> shared_chrome_headings=83
公开检测站目录与单个库的注册表是两种东西:公开检测站点到底在测什么统计出 25 与 24 条已发布路径,并找出 11 条点名连接的条目。 公开目录与单个库的注册表是两种对象,BotD 检测器注册表与组件状态展示注册表形态,CreepJS 的信号分组与合并方式展示按组折叠。 两个首页体积相差十倍,这个差别正体现在共享标题上。BrowserLeaks 的菜单不带标题标签,所以测试页上的每个标题都属于那一页。BrowserScan 在每条路径上重复 83 个导航标题,扣掉它们才是读一项测试与读一份菜单的区别。
这个减法不是外观问题。扣之前每条 BrowserScan 路径都像连接测试,因为共享菜单里有 DNS、HTTP2、SSL、TLS 这些词。不扣共享块就数标题的人会得出 24 条路径都在测连接,而这个数字是模板的产物。
体积差异也说明两个站的构造不同。12,700 字节、列 25 条路径的首页是一个目录:它点名测试,把读者送出去。134,999 字节、带 83 条含标题导航项的首页是一个应用外壳,每条路径都继承它。两种做法都合理,带来的测量问题不同。在目录里,路径数接近测试数;在外壳里,读者必须先把外壳和页面分开,计数才有意义,不做这一步的人报出的是属于模板的数字。
连接出现在测试页的哪里
分类器读每页自己的标题,当某个标题点名了只存在于线路上的量时,就把这一页记为连接测试:握手、密码套件列表、加密的 client hello、HTTP/2 或 HTTP/3 帧、QUIC 包、IPv4 或 TCP 头、段大小、DNS 交换、代理地址。
wire:BrowserLeaks/tls -> sections=5 TLS Fingerprint | TLS Handshake | Encrypted Client Hello | Supported Cipher Suites (in order as received)
wire:BrowserLeaks/http2 -> sections=2 HTTP/2 Fingerprint | HTTP/2 Frames
wire:BrowserLeaks/tcp -> sections=5 TCP/IP Fingerprint | IPv4 Header | TCP Header | Maximum Segment Size
wire:BrowserLeaks/quic -> sections=8 QUIC Fingerprint | QUIC Connection | QUIC Initial Packets | TLS Handshake
wire:BrowserScan/tls -> sections=7 HTTP/2 Fingerprint | TLS Fingerprint | TLS handshake | TLS protocol
split:BrowserLeaks -> wire=7 page=17 unreadable=1 total=25
split:BrowserScan -> wire=4 page=18 unreadable=2 total=24
七条和四条。49 项已发布条目里,11 项在自己的分节里点名了连接层数量。其余描述的是脚本能读的东西:canvas 渲染、字体度量、WebGPU 适配器、时区、用户代理、权限状态。
这个比例才是测量的有用部分,而且比目录给人的印象小。一个发布 25 条路径的站,容易让人读成它检查了浏览器的 25 件事。它实际检查的是页面报告的 17 件、连接报告的 7 件,以及 1 件它不输出分节的事。三组回答不同的问题,把它们压成一个通过或不通过的徽章会掩盖结果是哪一组产生的。
为什么同一个名字可以是两种测试
两份目录的重叠是五个名字:
overlap -> shared=5 webrtc canvas tls webgpu client-hints
overlap -> BrowserLeaks_only=20 BrowserScan_only=19
49 项里只有 5 个共享名,这是第一个发现:两个站主要是两个不同产品加一小块共同核心。第二个发现是这块核心内部发生了什么。
共享的五项正是浏览器可以从页面里廉价回答的:canvas 渲染什么、显卡适配器报什么、client hints 说什么、一次 ICE 收集产出什么、握手长什么样。各自独有的 39 条路径才是需要先决定要测什么的部分。一个站为 JavaScript 对象、字体、地理定位、媒体查询、元素矩形、Do Not Track 与资源加载时间出页面;另一个站为端口扫描、浏览器版本漏洞、陀螺仪读数、时区与 IP 位置对照、媒体设备权限出页面。两份清单互不包含,所以选站是在选问哪些问题,而不是选哪个更全。
wire:BrowserScan/tls -> sections=7 HTTP/2 Fingerprint | TLS Fingerprint | TLS handshake | TLS protocol
page:BrowserLeaks/canvas -> sections=11 Canvas Support Detection | Canvas Fingerprint | Image File Details
page:BrowserScan/canvas -> sections=5 Canvas Function Detection | Image Details | The reason for the generation of Canvas fingerprints.
page:BrowserLeaks/webrtc -> sections=8 Your Remote IP | WebRTC Support Detection | Your WebRTC IP
page:BrowserScan/webrtc -> sections=24 After authorizing media device permissions, WebRTC will leak local IP | Media Devices API Support | Audio Permissions
TLS 是唯一被两边都放在连接一侧的共享名,两边都在分节里点名握手与指纹。canvas 在两边都是页面测试,两边都讲渲染出的图像及其细节。这两项是一致的。
WebRTC 是分类分岔的地方。BrowserLeaks 用 Your Remote IP 和 Your WebRTC IP 做标题,这些是页面自己收集到的值。BrowserScan 用媒体设备权限和「授权后 WebRTC 会泄露本地地址」做标题。同一个路径名,在一个站描述页面收集到的地址,在另一个站描述受权限约束的媒体通道。
WebGPU 与 client hints 同样分岔。BrowserScan 的 WebGPU 页点名适配器报告与报告摘要;BrowserLeaks 的页面点名支持检测与指纹,那是页面侧的读法。client hints 上,BrowserLeaks 把 JavaScript API 与 HTTP 头分开,BrowserScan 列用户代理与 API 支持。按路径名比较两个站,比较的是不同的测量。
这就是共享词汇而没有共享定义的后果。一个站叫 canvas、另一个站也叫 canvas 的测试,并不确立同一件事,而一份引用「canvas 测试」却不说出自哪个站的报告,让读者无法判断做的是哪一种测量。
同一个问题也出现在单个站内部,这也是分节标题比路径名更重要的原因。报告渲染图像与文件细节的 canvas 页测的是渲染输出;报告函数检测与指纹生成原因的 canvas 页描述的是能力与机制。两者都有用,而其中一方的结果回答不了另一方的问题。读标题正是把它们分开的办法,也是探针在分类之外保留标题清单而不只留计数的原因。
检测站的干净报告能支撑什么
探针报告一个目录 wire=7、另一个 wire=4,所以 49 项已发布条目里有 11 项在这一天到达连接。
wire:BrowserLeaks/ip -> sections=5 IPv6 Leak Test | DNS Leak Test | TCP/IP Fingerprint | TLS Fingerprint
wire:BrowserLeaks/proxy -> sections=1 Proxy Detection
wire:BrowserLeaks/dns -> sections=1 DNS Leak Test
wire:BrowserScan/dns-leak -> sections=4 Introduction to DNS Leak Test | How DNS leaks happen | How to perform a DNS leak test | How to Fix a DNS Leak
连接测试本身也不是一种形态。有些只有一节,报一个值,例如代理检测;有些在测量旁边带解释,例如 DNS 泄露页有引言、成因和修复步骤。一节的长解释页和一节的单字段页在目录里都算一条路径,所以路径数与覆盖不是同一个数字。
这个差别决定结果页值多少。只有一节、报一个值的页面是没有上下文的测量:读者拿到数字,还得知道它本该是多少。带引言、成因与修复的页面是测量加一段关于数字含义的论证。对验证声明配置文件的团队来说,前者是拿来比对的事实,后者是拿来核对的论断,把两者当成一个通过徽章就丢掉了区别。
还有第三种形态值得点名,因为它最容易误导。页面可以输出描述某项测试的分节,而页面并不执行它,分类跟着分节走。浏览器版本页最清楚:它的标题描述漏洞声明与用户代理,那是页面可读的事实,而它支撑的测量是关于版本对齐,不是关于文档内容。看到版本警告就当成自动化信号的人,把页面侧事实当成了结论。
有一个限制需要说明。探针读的是每页作为分节发布的内容,也就是该站对自己测什么的描述。它不执行各站的脚本,所以分节停在文档内部的页面,仍可能在分节没提到的代码里读一个头。分类描述的是站方说自己测什么,这正是读者选站时用的东西,它不替代把某个具体结果对照某个具体配置文件来读。
同样的限制在另一个方向也成立。分节点名握手的页面并不因此就是完整的连接审计,因为分节是页面展示什么的清单,不是它检查的全部字段。划分真正确立的是两组之间的差距有多大:11 条路径点名连接,35 条停在文档,而这两组不能被读成一个分数。
两站合计有三个不输出任何分节的页面,从另一面说明了这个限制。一个设置页和一个工具索引返回 200、几十 KB 标记却没有任何分节标题,一个反馈页也一样。三者都不是测试,也都不是测量,所以运行把它们记为不可读而不归入任何一组。这个选择让分母保持诚实:算作页面测试会抬高页面一侧,算作连接测试会抬高承载更重断言的那一侧。
三组各自的失败方式
三组的失败模式不同,知道结果来自哪一组,才知道怎么解读变化。wire 与 page 两个计数各自独立变动,所以只挪动一组的运行对另一组什么也说明不了。
页面测试随文档变化。不同的 canvas 渲染、不同的字体列表、不同的时区或不同的权限状态,都表现为不同的页面值,两次运行同一个值说明文档相同。这让页面测试擅长发现同一环境内的漂移,不擅长比较环境,因为两台在所有页面测试上都一致的机器,到达站点的方式仍可能不同。
连接测试随连接变化。不同的密码套件顺序、不同的协议列表、不同的头集合或不同的出口地址都出现在线路上,而文档可以在两次运行里完全相同。这让连接测试擅长比较环境,不擅长发现单一环境内的漂移,因为稳定的连接不隐藏文档的任何东西,变化的连接也不说明哪个页面表面动了。
没有分节的页面不是测量。它就是页面,运行也这样记。把它归入任何一组,都是替页面给了一个它没给的答案。
这就是要在跑站之前而不是之后测量划分的全部理由。计划用公开检测站验证声明配置文件的团队,可以先看目录,发现该站报告的大部分内容描述的是文档。那是有用的检查,但不是团队本来要做的检查。两者之间的差距就是探针报告的数字,在这一天是 49 项里的 11 项。
记录一次站点读数
站点读数支撑一个窄断言:这份目录,在这个日期读到的,是这样划分的。四个字段让它保持可核对:
- 首页摘要,因为一个站增加或删除一条路径就会改变这一页的每个计数,而浏览器毫无变化。
- 共享标题块,因为把菜单当标题重复的模板会抬高每一页的计数,直到被扣掉。
- 分类规则,因为页面测试与连接测试的界线是一个决定,换一条规则就得到另一种划分。
- 不输出分节的路径,因为标题里什么都不说的页面,和什么都不测的页面不是一回事。
公开来源
- BrowserLeaks
- BrowserLeaks TLS client test
- BrowserLeaks HTTP/2 fingerprinting
- BrowserScan
- BrowserScan HTTP2, SSL and TLS fingerprint
- BotBrowser:自动化一致性参考
实践结论
在把干净结果当成宽泛结论之前,把报告里文档中测到的部分和连接上测到的部分分开写。这里的目录发布 49 项,其中 11 项在自己的分节里点名连接层数量,所以一个首页看起来很全的站,主要在读页面报告的东西。当两个站共享一个路径名时,把名字当标签而不是定义,因为这里五个共享名里有四个在两站描述不同的测量。关于一个库在任何结论之前如何处理它收到的信号,读CreepJS 的信号分组与合并方式;关于页面完全无法评估的那些规则,读页面脚本无法评估的网络层规则。
本文属于指南: 什么是浏览器指纹?原理、风险、信号与隐私边界