为什么一条异常信号定不了罪
一支探针读公开检测规则集:环境信号权重 0.7 仍然定不了罪,而一条跨层矛盾单独就能给出结论。
BotBrowser Team
BotBrowser 支持在已声明 profile 下回放授权的同源夹具,并保存一份有界的记录,说明页面暴露了哪些信号,但它不能让一条环境信号的权重超过规则集允许的上限,不能把佐证型信号变成定罪型信号,也不能阻止一条网络侧的矛盾在页面还没加载完时就决定了结论。本评测把一个公开检测规则集当作数据读取,复现它的评分算术,记录哪些类别有资格定罪、为什么权重 0.7 的信号单独出现在结论线之下、再加一条痕迹规则会对同样的信号产生什么、以及一条跨层矛盾如何单靠自己越过定罪线。
摘要
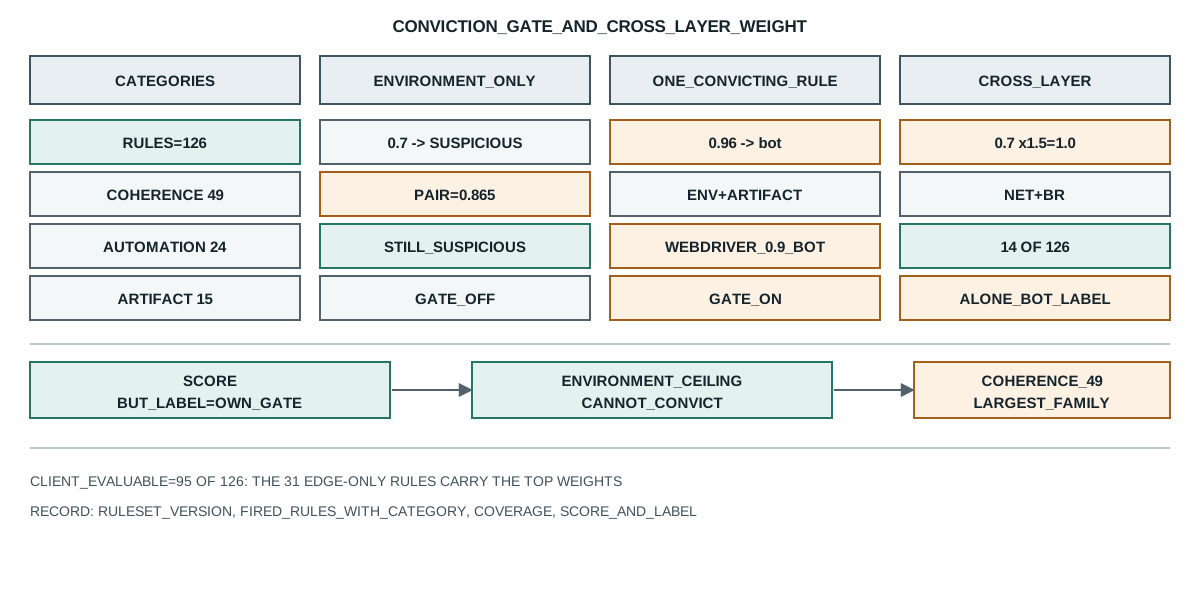
- 规则集共 126 条规则、七个类别,其中只有
coherence、automation、artifact三类可以定罪,其余四类只能佐证。 - 页面能触发 126 条中的 95 条,也就是说那 31 条网络与信誉规则在浏览器侧检查里根本不会运行。
- 一条权重 0.7 的环境信号评出 0.7 并落在
suspicious,因为环境规则无论多重都不能定罪。 - 两条环境信号合起来评出 0.865 仍然是
suspicious,说明守住这条线的是类别门而不是算术。 - 在那两条环境信号上加一条痕迹规则得到 0.96 和
bot,环境信号的权重一点没变。 - 一条权重 0.9 的自动化信号单独就定罪,所以泄漏
navigator.webdriver的页面没有任何余地。 - 126 条规则里只有 14 条跨越多个层,它们的权重会被放大:0.7 变成 1.0。
- 分数与规则排列顺序无关,所以记录必须写明命中了哪几条,而不是命中了几条。
目录
哪些类别有资格定罪
基于规则的检测器是一串关于访客的断言,每条带一个权重和一个类别,而类别决定一条命中的规则被允许做什么。探针读取的规则集有七个类别、共 126 条规则:
categories -> coherence=49 automation=24 artifact=15 behavioral=7 reputation=4 environment=26 prevalence=1
convicting -> coherence,automation,artifact (others corroborate only)
三个类别可以定罪,其余四个只能加进分数。这个划分就是整个设计。一条 environment 规则描述的是看起来单薄的表面,比如插件列表很短、语音列表缺失、hardwareConcurrency 远低于机器能力。这些表面在大量合法访客身上确实很单薄:精简过的工作站镜像、锁死的企业构建、没有音频设备的浏览器。把其中任何一条当成证据就会误判这些访客,所以规则集让它们抬高分数然后停在那里。一个会命名自身组件的检测库做的是同一个区分:BotD 检测器注册表与组件状态 记录了具名检测器如何报告它观察到的内容,而不是只给一个分数。
behavioral 类别同理。读者只是在看一个静态页面时,几乎不产生输入,所以一条关于击键熵或指针轨迹的规则分不清「正在阅读的人」和「没有注入任何事件的驱动器」。规则集出于同样理由把它标为佐证型。
一条 automation 规则性质不同。navigator.webdriver 为真、CDP 的 Runtime.enable 状态可见、或者 user agent 里带着无头标记,描述的是正常浏览会话不会出现的状态。它们不是合法访客偶尔拥有的单薄表面,而是只有驱动器接管浏览器时才会到达的状态,所以规则集允许它们定罪。
artifact 覆盖的是页面主动自相矛盾的情形:一个原生函数的源码文本不是引擎的、一个 Worker 与主页报告的值不同、一块画布不满足自己的不变量。这些都是内部不自洽而不是表面单薄,所以可以定罪。
coherence 是两层相互不一致的类别,49 条规则,是最大的一族。一次 TLS 握手暗示一种操作系统,而 user agent 声称另一种,这就是连接所说的和页面所说的互相矛盾。没有合法访客会产生这种矛盾,因为两层由同一个客户端生成。
为什么一条很重的环境信号也停在半路
有意思的是类别门对一条很重的环境规则做了什么。探针取四条环境信号,各自单独评分:
alone:br.webgl_not_angle -> weight=0.55 category=environment score=0.55 verdict=suspicious
alone:br.font_linux_leak -> weight=0.7 category=environment score=0.7 verdict=suspicious
alone:br.screen_zero -> weight=0.7 category=environment score=0.7 verdict=suspicious
alone:br.voices_empty -> weight=0.5 category=environment score=0.5 verdict=suspicious
权重 0.7 的规则越过 0.35 的可疑线,停在 0.7,离 0.65 的定罪线并没有差多少,只是类别门拒绝放行。单看数字,0.7 像是一个很强的发现;连类别一起看,它只是一个可能真的单薄的表面。
当一个团队读到写着「可疑」的报告时,这个区别很要紧。来自环境信号的可疑标签在告诉你:页面在某个具体的、被命名的方面显得不寻常。它没有说页面是自动化的,而一份只印分数、不印类别的报告恰恰会诱导这种误读。0.7 不是「走到定罪 70% 的路」,它是一条已经顶到自身类别上限的佐证观察。
同一个探针还显示,把环境信号叠起来也解决不了:
environment-pair -> weights=0.55+0.7 score=0.865 verdict=suspicious convicting=false
两条环境规则按 noisy-or 合成 0.865,远超 0.65,结论仍然是 suspicious。打印出的 convicting=false 就是原因:没有任何命中的规则属于可定罪类别,所以分数可以涨、标签不能变。这是刻意的设计,也是团队最容易搞错的一点:他们以为数字更高就意味着结论更强。
实际后果是关于把力气花在哪。如果一个部署只被环境信号标记,那么去加固这些规则描述的表面是场必输的仗,因为这些规则本就接受单薄环境为常态。力气该放在可定罪的类别上:保持 navigator.webdriver 与 CDP 状态干净,并让每个 realm 报告相同的值。
定罪线到底在哪里
探针在那两条环境信号上加一条可定罪类别的规则,结论就翻转了:
plus-artifact -> score=0.96 verdict=bot convicting=true categories=environment,environment,artifact
环境信号本身没有任何变化。那两条评出 0.865 的规则分数照旧,加上第三条把总分推到 0.96、标签变成 bot,只因为 convicting 现在为真。决定因素从来不是环境权重,而是有没有一条可定罪类别的规则在场。
单条候选把同一点从另一面说清:
alone:br.webdriver_present -> weight=0.9 category=automation score=0.9 verdict=bot
alone:br.cdp_runtime_enabled -> weight=0.85 category=automation score=0.85 verdict=bot
alone:br.ch_he_headless -> weight=0.85 category=automation score=0.85 verdict=bot
每一条都单独定罪,权重接近 1 但没到 1。这里没有余地:泄漏 navigator.webdriver 的页面被一条信号定罪,唯一的退路是不要泄漏。这个不对称是刻意的,因为规则集把自动化状态当作类别事实,而不是概率提示。
在已经定罪的页面上再堆佐证信号,只会抬高分数、不改标签:
stack -> one=0.9 two=0.955 three=0.987
三条信号把分数推到 0.987,而一条的时候结论就已经是 bot。一份为命中三条的页面显示 0.99、为命中一条的页面显示 0.9 的报告,暗示着规则集并没有做出的置信度差别:两者都被定罪,多余的信号对决定几乎没有贡献。分数是「触发了多少条规则」的摘要,标签是另一道门。
一条跨层矛盾值多少
最后一块是施加在跨层规则上的放大:
cross-layer rules -> 14 of 126
amplify:net.tls_vs_ua_browser -> layers=network+browser weight=0.7 effective=1
amplify:net.h2_vs_ua_browser -> layers=network+browser weight=0.6 effective=0.9
amplify:net.datacenter_origin_proxied -> layers=network+browser+reputation weight=0.8 effective=1
126 条里有 14 条跨了不止一层,每条的权重乘 1.5、封顶 1。0.7 的规则变成 1.0,0.6 的变成 0.9。这个放大是规则集用算术陈述自己的论点:两个独立生成的层之间的矛盾,比单独读一层的强读数更值钱,因为同一个客户端同时生成两者,很难故意让它们不一致。
一条跨层规则单独定罪:
amplify-alone:net.tls_vs_ua_browser -> score=1 verdict=bot
一条规则、分数 1、结论 bot。不需要叠加,因为这条规则的类别是 coherence,放大后的权重已经顶到量表顶端。这是团队最该担心的形状:一处配置失配,让网络路径暗示一种操作系统而 profile 声称另一种,一次观察就产生定罪。
这也解释了浏览器侧的覆盖数字为什么重要:
coverage -> clientEvaluable=95 of 126, edge-only=31
layer:network -> rules=28 clientEvaluable=0
layer:reputation -> rules=4 clientEvaluable=0
所有网络规则都只在边缘可评估,所以在浏览器里加载一个检测脚本的页面永远触碰不到那些有效权重最高的跨层规则。一个团队在浏览器里加载检测器来验证 profile,检查了 95 条规则,把 31 条「一次观察就能定罪」的规则原封不动留在那里。两半回答不同的问题,浏览器侧的干净运行不是关于边缘的证据。当请求头与页面报告的取值不一致时,这项对比用的是同一个客户端产出的两个来源,client hints 与 500 字符上限 描述了这个对比。解析器读取的请求头表面,正是 coherence 规则会比较的浏览器侧取值之一,client hints 与 500 字符上限 详细记录了这一点。
最后一行排除了一条捷径:
order-free -> forward=0.887 reverse=0.887 same=true
同样三条规则换个顺序分数一样,因为合成本身是对权重求积,与顺序无关。所以报告无法靠只显示分数告诉你哪条规则起了作用,唯一办法是写明命中的规则、它们的类别和层。只报条目数,是同一份数据里信息量最低的形式。
记录一次结论读数
一条结论读数支撑的是一个窄结论:这个规则集版本、这些命中的规则,产出了这个分数和这个标签。四个字段让它保持可核对:
- 规则集版本与摘要,因为一次更新可能改变权重、类别或可定罪集合,同样的信号会评出不同结果。
- 命中的规则及其类别与层,因为标签取决于其中是否有可定罪的规则,而分数把这个藏了起来。
- 覆盖边界,因为浏览器侧的运行永远看不到那些有效权重最高的边缘规则。
- 分数与标签一起写,因为带佐证信号的 0.99 和带一条可定罪信号的 0.9 是同一个结论,而只印分数的报告暗示了类别门从未给予的确定性。
公开来源
- MDN:Navigator.webdriver
- MDN:WebGLRenderingContext.getParameter()
- RFC 8446:TLS 1.3
- RFC 9113:HTTP/2
- BotBrowser:自动化一致性参考
实践结论
读检测器的结论要按规则和类别读,而不是按分数读:环境规则的 0.7 和自动化规则的 0.7 是同一个数字、完全不同的发现。只由环境信号构成的可疑标签,当它是「表面单薄」的描述;加固力气放在可定罪类别上,那里一条泄漏就单独决定结论。还要记住,浏览器侧的运行只覆盖页面能评估的规则,把权重被放大到量表顶端的跨层规则完全留在视野之外,所以页面内的干净结果说明不了客户端所用的那条连接。本篇讲评分机制,逐信号读法见原生函数被改写与 toString 白名单能看见什么;防止 coherence 规则触发所需的 realm 一致性见跨 realm 的浏览器 API 完整性。
本文属于指南: 什么是浏览器指纹?原理、风险、信号与隐私边界