CreepJS 的信号分组与判定串如何拼起来
一支探针读 CreepJS:九个独立分组模式拼成一条有顺序的判定串,而其中一个模式必须靠两个分组互相矛盾才会触发。
BotBrowser Team
BotBrowser 支持在已声明 profile 下回放授权的同源夹具,并保存一份有界的记录,说明每个探测分组报告了什么,但它不能让一个分组与描述另一种表面的分组自动一致,不能隐藏一个「被拦下而不是回答」的分组,也不能改变判定串给出原因的顺序。本评测从 CreepJS 的公开源码出发,复现它的九模式判定,记录哪些模式单个分组就能置位、哪一个必须先有两个分组互相矛盾、九位的顺序如何决定报出哪个原因,以及两个服务端模式在页面内部永远贡献不了什么。
摘要
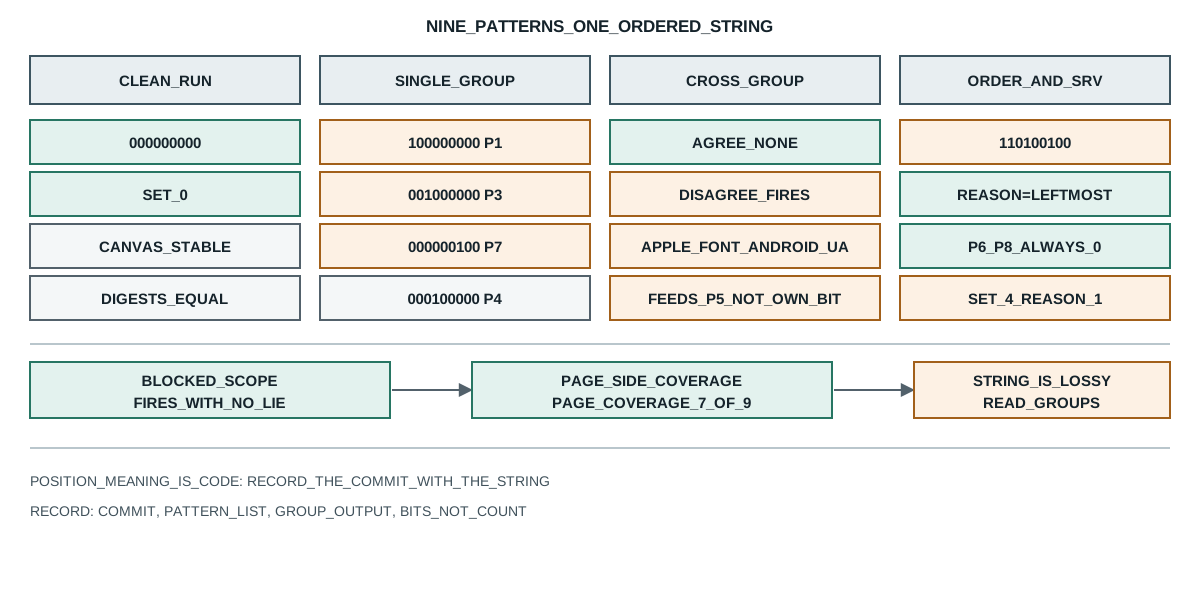
- CreepJS 跑二十多个探测分组,把结果折成一条九位判定串,位置固定,同时保留每个分组各自的摘要。
- 干净 profile 一位都不置:探针打印
clean -> botHash=000000000 set=0 badBot=none。 - 四个模式单个分组就能置位:Worker 作用域撒谎、特性版本不匹配、
Function.prototype.toString被替换、Worker 作用域被拦下。 - 被拦下的 Worker 作用域是最便宜的单条线索,因为什么都没撒谎它也会触发:
worker-blocked -> botHash=000000100。 - 有一个模式必须两个分组同时在场:字体平台与 Worker user agent 声称的系统不一致。
- 这种跨组不一致没有自己的位,它喂给「极端谎言」那位,所以
font-vs-ua-feeds-extreme -> botHash=000010000 badBot=extremeLieCount。 - 九位的顺序决定报出的原因:置了四位时探针打印
botHash=110100100 badBot=liedWorkerScope,把输入顺序反过来结果不变。 - 两个模式在服务端计算,所以页面内部它们永远是零:
server-bits -> positions=6,8 always=00。
目录
九位分别是什么、来自哪里
CreepJS 不给一个分数。它跑一组独立的探测分组,把每个分组的输出各自压成一个摘要,然后把九个特定模式折成一条有顺序的判定串。这九位来自不同分组,这正是设计本身:
clean -> botHash=000000000 set=0 badBot=none
什么都没触发的浏览器是九个零。每个位置对应一个模式,取自页面不同部位:Worker 作用域自己的报告、由字体测量推出的平台版本、Function.prototype.toString 是否仍表现得像原生、特性列表是否与声明的版本相符、单条谎言的数量是否极端、松散指纹是否过多、Worker 作用域是否干脆被拦下、群体混入评分,以及一个服务端模式。
两个分组之间的平台不一致,正是为什么一条异常信号定不了罪里与单一单薄表面评分不同的那种情况。分组摘要与判定串回答不同的问题。摘要在说「这两次 canvas 分组跑出了同样的字节」,那是对单一表面稳定性的陈述。判定串在说「这九个具名条件为真」,那是对整页的陈述。一个 profile 可以有完全稳定的 canvas 摘要,同时仍然置位,因为那一位来自另一个分组。
读任何指纹报告时都值得抓住这个区分。稳定的分组摘要常被误当成好结果,而它不是同一个主张。稳定意味着该分组可复现,它对「这个分组的输出是否与另一个分组一致」什么都没说。
哪些分组能单独置位
九个模式里有四个不需要任何比较,单个分组就能置位。探针把每个都对着干净基线跑一遍:
worker-scope-lied -> botHash=100000000 set=1 badBot=liedWorkerScope
features-version-lied -> botHash=000100000 set=1 badBot=outsideFeaturesVersion
proxy-toString -> botHash=001000000 set=1 badBot=functionToStringHasProxy
worker-blocked -> botHash=000000100 set=1 badBot=workerScopeIsBlocked
每一行只置一位,且每一位落在不同位置,所以字符串本身就记下了是哪个分组说的。Worker 作用域报告了不一致的值置第一位;特性列表与声明版本不符置第四位;Function.prototype.toString 不再像原生置第三位;Worker 作用域根本创建不出来置第七位。
Worker 报告与主页不同的取值,是少数合法客户端根本不会产生的线索,跨 realm 的浏览器 API 完整性 详细记录了这一点。被拦下的 Worker 那个案例值得停一下,因为它没有任何谎言也会触发。没有谁报错了值,只是页面拿不到一个能回答的 Worker 作用域。这让它成为整套里最便宜的单条线索:一个页面可以在它确实暴露的每个表面上完全一致,却因为没暴露某一个而置位。只读「回答了的那部分表面」的测试会漏掉它。
Function.prototype.toString 那位是页面最能直接影响的位置,原生函数被改写与 toString 白名单能看见什么 分析了哪些改写能扛过那条检查、哪些包装能通过。这里的判定串只记录该模式触发了,它不说是哪种改写造成的。
哪一位需要两个分组互相矛盾
有一个模式无法从单个分组评估,因为它存在的目的就是比较两者。探针给它一个 user agent 和一个字体平台,记录比较结果:
cross:agree-win -> uaOS=WINDOWS fontOS=WINDOWS fontOSBad=false
cross:agree-mac -> uaOS=APPLE fontOS=APPLE fontOSBad=false
cross:disagree-ua-mac-font-win -> uaOS=APPLE fontOS=WINDOWS fontOSBad=true
cross:disagree-ua-win-font-mac -> uaOS=WINDOWS fontOS=APPLE fontOSBad=true
cross:android-with-mac-font -> uaOS=LINUX fontOS=APPLE fontOSBad=true
两个分组指向同一平台族时什么都不触发。指向不同族时,两个方向都会触发,而一个 Android user agent 配上读起来像 Apple 的字体平台同样会触发。方向不重要,只有不一致重要,这正是它属于一致性检查、而不是对单一取值设阈的原因。
Android 那个案例对部署最有意义。一个报告 Android user agent、而字体测量解析成桌面 Apple 族的 profile 会触发这个模式,尽管两个分组单独看都不像错的。user agent 是合理的 Android 串,字体平台是合理的 Apple 串,它们只是不可能同属于一台设备。
这个模式拿那份不一致做了什么,是最容易漏掉的部分:
font-vs-ua-feeds-extreme -> botHash=000010000 set=1 badBot=extremeLieCount
跨组不一致没有自己的位,它喂给第五位「极端谎言」,与单条谎言的绝对计数并列。所以一份说「极端谎言置位」的报告,可能意味着页面累积了大量小不一致,也可能意味着一条跨组不一致就够了。这一位不区分这两种情况,读它的人必须回到分组输出才知道是哪一种。
这个设计是刻意的,也有代价。把定性的不一致和定量的计数折进同一位,意味着判定串丢掉了底层分组仍保留的信息。字符串是摘要,而摘要在某个具体的、有文档的位置上是有损的。
为什么位的顺序要紧
九位并不等价,因为判定把第一个置位当作它的原因报出来。探针一次置四个模式,然后用不同的输入顺序重复同样四个:
many-bits -> botHash=110100100 set=4 badBot=liedWorkerScope
many-bits-reversed-input -> botHash=110100100 set=4 badBot=liedWorkerScope
四位置上,报出的原因永远是最左那位。输入顺序不改变字符串也不改变原因,说明顺序住在固定列表里,而不是分组碰巧完成的先后。一个置了四个模式的页面只会被告知其中一个,而那一个是位置最靠左的。
实际后果是:单一原因不等于单一发现。一份只给一个原因、同时有四位为真的报告,是在告诉你共有四个,并选择把最左那个摆到台面上。只读原因的人会低估页面实际做了什么。
九位里有两个位置在页面内部永远置不上:
server-bits -> positions=6,8 always=00
松散指纹过多与群体混入两位在能比较许多会话的地方计算,所以一个自我评估的浏览器无论页面做什么都报零。页面侧的运行因此只覆盖九个模式中的七个,而它覆盖不到的那两个恰恰需要一群人而不是一次会话。
单比特字符串把同一件事说在粒度上:
single:liedWorkerScope -> 100000000 position=1
single:functionToStringHasProxy -> 001000000 position=3
single:workerScopeIsBlocked -> 000000100 position=7
三种不同的发现,三条不同的字符串,每条恰好一位。字符串对「哪个模式触发」很精确,对「有多强」完全沉默。一个因为 Worker 作用域报了一个错值而置第一位的页面,和一个因为作用域自相矛盾了六处而置第一位的页面,产出同一条字符串。
平台版本那位依赖的 Windows 版本映射,说明它同样粗糙:
win-release:0.3.0 -> 8.1
win-release:8.0.0 -> 10 (1903|1909)
win-release:13.0.0 -> 11
win-release:15.0.0 -> 11
从 13 往上的每个平台版本都映射到 Windows 11,所以这个模式分不出一个 Windows 11 构建和另一个。它是族级检查,这既让它擅长发现不匹配,也让它对识别具体构建毫无用处。
记录一次分组交叉核对读数
一条分组交叉核对读数支撑的是一个窄结论:这个库版本、这些分组,产出了这条判定串。四个字段让它保持可核对:
- 库的提交与有顺序的模式列表,因为位置及其含义就是代码,重排会悄悄改变报出的原因。
- 分组输出与判定串并排,因为字符串把定性的不一致和定量的计数折进同一位,而分组仍保留着那个区分。
- 哪些模式被评估、哪些没有,因为九个里有两个需要一群人,页面侧运行里恒为零。
- 置位的字符串而不是计数,因为四位为一且只报一个原因,与一位为一,是不同的发现,而计数分不出来。
公开来源
实践结论
把 CreepJS 的结果当成一条有顺序的具名模式串来读,而不是一个分数,因为字符串说的是哪个分组开口,分数只会说有几个。把被拦下的 Worker 作用域当成一条独立的发现,尽管什么都没撒谎,它是最便宜、也最容易被忽略的单条模式。预期字体与 user agent 那位在两个方向上都会触发,并记住它喂给极端谎言那位而不是自己一位,所以只看原因分不出一次定性不匹配和一堆小问题。九个位置里那一条依赖的完整性检查,见原生函数被改写与 toString 白名单能看见什么;由多层拼出的判定如何评分与设门,见为什么一条异常信号定不了罪。
本文属于指南: 什么是浏览器指纹?原理、风险、信号与隐私边界