页面脚本无法评估的网络层规则
公开规则集把 126 条规则分成两类:95 条页面可判,31 条必须看网络。真实握手显示最重的规则都落在页面看不到的一侧。
BotBrowser Team
BotBrowser 让声明好的配置文件在页面能读到的各个表面保持一致,并能够保留一份页面自述环境的有限记录,但它不能提供 TLS 握手、HTTP/2 设置帧,也到不了代理在连接远端呈现的地址。公开规则集被当作数据读入,按每条规则所需的信息位置分组,再在真实握手上测量这些连接层事实,所以这个分组建立在观测到的字节上,而不是对网络能看到什么的假设上。
摘要
- 规则集共 126 条。页面可以判定其中 95 条,剩下 31 条需要永远不会到达页面的信息。
- 31 条网络规则每条都至少读一个页面之外的值,其中 25 条只读这类值。
- 这批规则包含 23 条一致性、4 条信誉、3 条自动化、1 条痕迹,按层分布为网络 28 次、浏览器 14 次、信誉 4 次。
- 31 条里只有 6 条把页面值和网络值配对,也只有这 6 条页面能答一半:它提供一侧,对另一侧没有任何信息。
- 每条网络规则的权重都不低于 0.5。4 条在 0.85 及以上,8 条在 0.7 到 0.84 之间,19 条在 0.5 到 0.69 之间。
- 最重的三条权重都是 0.9,三条都描述 HTTP/2 的帧行为,任何页面脚本都读不到。
- 两次握手只有协议列表不同,在同为 TLS 1.3、同一密码套件、同一密钥交换组的情况下分别得到
alpn=h2与alpn=http/1.1。 - 携带初始窗口 1048576 与最大帧 32768 的设置帧,到达对端时是一条 18 字节记录,对端直接读取;发出它的页面读不到这两个数字中的任何一个。
- 真实连接的服务端报告初始窗口 65536、最大帧 16777215、并发流 256,这些数字客户端网络栈可见,页面上任何脚本都不可见。
- 页面侧报告能描述它暴露的环境,却无法证伪一条它从未见过输入的规则。
目录
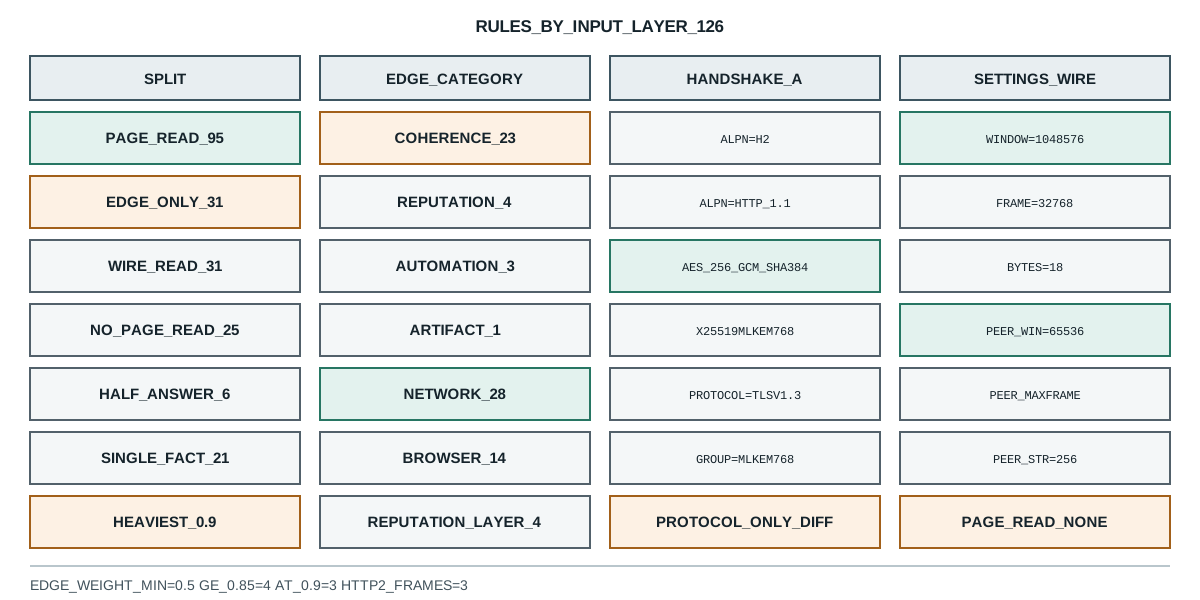
规则集在哪里分开
规则集是一串断言,每条断言都写明它读哪些值。这里重要的既不是类别也不是权重,而是这些值住在哪里。探针把公开规则集当作数据读入,按页面内脚本能否读到同样的输入给每条规则分类:
node=v26.9.0
ruleset=0.74.49 rules=126 digest=cf896731d6c894fb38266206bc121db1f235f536ffbf334aa2c0da7468cc0e59
split -> page_evaluable=95 edge_only=31
edge_categories -> coherence=23 reputation=4 automation=3 artifact=1
edge_layers -> network=28 browser=14 reputation=4
edge_rules_with_a_wire_only_read -> 31 of 31
every_edge_rule_needs_the_wire -> true
edge_rules_with_no_page_read_at_all -> 25
分组的第一行决定了页面能理解检测器的多少。95 条规则读的是文档里存在的值:用户代理字符串、语言列表、屏幕几何、时区、原生函数的形态。想知道这些规则会给出什么结论的页面,读同样的值就能算出同样的答案。
另外 31 条读的是别的东西。按层计数之和大于 31,因为一条规则可以跨层;按类别计数显示它们聚在哪里:一致性 23 条遥遥领先,这也符合名字,因为一致性规则的存在就是为了比对两个本应一致的信息源。信誉 4 条问的是地址或网络是否属于托管网段或已知代理出口。自动化 3 条与痕迹 1 条补齐全集。
撑起论点的是 every_edge_rule_needs_the_wire -> true 这一行。31 条里每一条都至少点名一个不是页面值的输入,所以没有一条能在文档内部判定。下一行把范围收得更紧:31 条里有 25 条只读网络值。对这 25 条来说,页面不是部分证人,它根本不是证人。不存在返回同一个数字的页面侧查询,不存在用缺失代替某个值的属性,也不存在能把它还原出来的算术。
这个区别分开了两类表面上很像的报告。页面侧扫描给出的是它能触及的那些表面的结论,网络侧检查给出的是关于一条连接的结论。两者被合并成一个分数时,合并掩盖了哪一半产生了哪条结论,读者也就无法判断:一个干净的结果意味着页面一致,还是意味着连接从未被检查过。网络层与浏览器一致性列出了会话暴露的各个层,网络信息指纹说明页面自己能读到其中哪几层。 一份公开检测站目录从外部显示了同一个缺口:公开检测站点到底在测什么统计它们已发布的测试里有多少项点名了连接。
哪六条规则只能答一半
31 条里有 6 条把一个页面值和一个网络值配对。这些是最值得看的情形,因为页面能提供比对的一半,对另一半则一无所知:
| 权重 | 页面侧 | 网络侧 |
|---|---|---|
| 0.85 | browser.webrtc_public_ip | network.observed_ip |
| 0.7 | browser.ua_browser | network.ja4_browser_hint |
| 0.6 | browser.ua_browser | network.h2_browser_hint |
| 0.6 | browser.ua_platform | network.ch_platform_header |
| 0.6 | browser.ua_browser | network.ch_ua_browser |
| 0.55 | browser.nav_language_primary | network.accept_language_primary |
探针直接把最重的那条形态打印出来:
cross_layer -> weight=0.85 net.webrtc_ip_vs_observed page=browser.webrtc_public_ip wire=network.observed_ip
page_side_view -> net.webrtc_ip_vs_observed page_reads=1 wire_reads=1
page_side_view -> predicate=not_equal needs_both_sides=true
page_side_view -> a page can supply browser.webrtc_public_ip and nothing for network.observed_ip
谓词是 not_equal,这正是这一对难以从页面内部回答的原因。页面可以读到自己 ICE 收集报告的地址,一个会返回公网地址的 WebRTC 实现返回的就是页面能拿来自我比对的真实值。页面读不到的是接收端针对同一条连接观测到的地址,因为那个值只存在于远端。页面拿自己的 WebRTC 地址和它自己对自身地址的判断相比,是在拿一个本地值和另一个本地值相比,那不是这条规则。
其余五条结构相同。页面读得到自己的用户代理,读不到 TLS 握手隐含的浏览器族。页面读得到 navigator.language,读不到网络栈发出的 Accept-Language 首选语言。页面读得到平台字符串,读不到 client hints 的平台头。每个情形里页面值是真的,网络值也是真的,只有其中一个能从脚本够到。
还有第二个容易忽略的后果。因为规则需要两侧,页面甚至无法知道自己会不会触发它。它只能算出自己那一半然后停下。把某个页面表面改成与目标配置文件一致,只是改掉了双输入比对中的一个输入,比对现在是否一致,取决于一个部署无法从页面查询的事实。
真实握手往线路上放了什么
这些值存在于页面之外这句话很容易说,值得测。探针向同一主机开两条 TLS 连接,只有客户端提供的协议列表不同,然后读回连接协商的结果:
handshake:dual_alpn -> alpn=h2 protocol=TLSv1.3 cipher=TLS_AES_256_GCM_SHA384 group=X25519MLKEM768
handshake:http11_only -> alpn=http/1.1 protocol=TLSv1.3 cipher=TLS_AES_256_GCM_SHA384 group=X25519MLKEM768
wire_only_distinction -> alpn_differs=true
两条连接都落在 TLS 1.3,都使用 TLS_AES_256_GCM_SHA384,都用 X25519MLKEM768 密钥交换组。唯一的差别是协商出的协议,h2 对 http/1.1,而这个差别来自对端在握手期间读到的一个客户端参数。文档里没有任何东西能观测到它。通过任一条连接加载的页面看到的 API 一样、自己请求上的头一样、环境一样;承载请求的协议是连接的性质,不是文档的性质。
HTTP/2 设置帧也是如此。探针构造两条设置帧,在本地监听端从原始字节解析回来,所以数字来自帧本身,而不是来自某个客户端对象:
settings_frame:wide -> enable_push=0 initial_window=1048576 max_frame=32768 bytes=18
settings_frame:narrow -> enable_push=1 initial_window=65535 max_frame=16384 bytes=18
settings_frame_differs -> initial_window_differs=true max_frame_differs=true
两条帧都是 18 字节。它们分别携带初始窗口 1048576 与 65535、最大帧 32768 与 16384,以及相反的推送设置。想知道客户端怎么工作的对端,会在任何文档存在之前就读到这些六字节条目。页面读不到自己发出的帧,因为帧由文档之下的网络栈写出,不会向上暴露。
真实连接的服务端一侧对客户端网络栈同样可读:
peer_settings:botbrowser.io -> initial_window=65536 max_frame=16777215 max_streams=256 header_table=4096
初始窗口 65536、最大帧 16777215、并发流 256、头部表 4096 都是客户端从服务端收到的值。页面可以发请求、看响应,却读不到这四个数字中的任何一个,因为它们描述的是请求所走的传输层。
合起来看,这些测量确立的是缺口形态,而不是某个具体检测。连接携带协议列表、密码套件、密钥交换组、设置帧和观测到的地址。文档携带用户代理、语言、平台和一组渲染表面。两边恰好只在上表那六个位置重叠,而每一个位置上的比对都需要各取一侧。
最重的规则为什么在另一侧
如果网络规则只是一小截弱检查,页面侧扫描就足以覆盖主题。权重说的正相反:
edge_weight_bands -> ge_0.85=4 0.7_to_0.84=8 0.5_to_0.69=19 lt_0.5=0
heaviest -> weight=0.9 net.h2_rapid_reset layers=network
heaviest -> weight=0.9 net.h2_continuation_flood layers=network
heaviest -> weight=0.9 net.h2_control_flood layers=network
heaviest -> weight=0.85 net.webrtc_ip_vs_observed layers=network+browser
heaviest -> weight=0.8 net.ja4_unstable_within_session layers=network
single_wire_fact_rules -> 21
没有一条网络规则权重低于 0.5。分布集中在中段和高端:19 条在 0.5 到 0.69,8 条在 0.7 到 0.84,4 条在 0.85 及以上。最重的三条权重都是 0.9,三条都描述 HTTP/2 连接上的帧行为。一条讲流重置来得比客户端处理完响应还快,一条讲续帧洪泛,一条讲控制帧洪泛。每一条都是传输层的时间或数量性质,每一条都在接收端靠数帧来测量。
剩下两条重规则描述的是稳定性而不是单个值。net.ja4_unstable_within_session 权重 0.8,问客户端握手参数在一次会话内是否变过;net.webrtc_ip_vs_observed 权重 0.85,问同一客户端的两个地址是否对不上。两条都需要不止一次观测,跨时间或跨层,这也是页面答不了它们的第二个原因:即使脚本能读一个握手参数,它也拿不到上一个。
31 条里有 21 条更简单。它们是针对单个网络事实的存在性检查,例如客户端发出的某个头是否缺失、接受的编码是否漏掉某种压缩方式、握手是否带了当前客户端通常会带的参数。一个事实决定一条规则,而这个事实完全住在文档之外。一个输入加不低于 0.5 的权重,这个组合才是网络子集属于检测器实体的原因,而不是脚注。
实际的读法关乎覆盖面,而不是分数。页面侧复核能描述 126 条中的 95 条,对读连接的那 31 条一条也描述不了。当报告列出结论却不说明哪一层产生了它们时,缺的那 31 条是隐形的:报告对自己看到的东西没有说错,它对有四条规则权重 0.85 及以上的那一层则完全沉默。
读网络层结论有什么不同
页面侧结论和网络层结论支撑的是不同的断言,这个差别决定了记录里必须写什么。
页面侧结论只用文档就能复现:任何人在同一环境加载同一页面都能读到同样的值并得出同样结论,两次运行不一致说明环境变了。网络层结论只有带着连接才能复现:同一份文档换协议列表、换密码套件或换线路加载,输入就不同,两次不一致的运行差别可能在传输层而不是浏览器。
这让网络层结论的字段更长。它要写明观测来自哪条连接,而不只是哪个页面,在上面几次运行里就是协商出的 alpn=h2 或 alpn=http/1.1,不是某个网址。它要写明每个比对里哪一侧被测量过,因为像权重 0.85 的 net.webrtc_ip_vs_observed 这样的规则,只读 browser.webrtc_public_ip 不能算回答。它要保留规则身份而不是计数,因为 31 条规则分布在 23 条一致性、4 条信誉、3 条自动化、1 条痕迹里,不归约成一个单独看有意义的数字。
有一个限制值得直说。让每个页面表面都与声明目标一致的配置文件,并不会因此改变握手、设置帧或远端观测到的地址;那些是由客户端不同部分产生的不同事实。把页面侧报告当作关于连接的证据是夸大了测量范围,把网络层报告当作关于文档的证据则犯了相反的错。两份报告描述两层,关于浏览器整体的断言需要两者。
记录一次读数
网络层读数支撑一个窄断言:这个规则集版本、这条连接,产生了这些输入。四个字段让它保持可核对:
- 规则集版本与摘要,因为一条规则增加或减少输入就会改变分组的含义,而客户端毫无变化。
- 每条规则所需的层,因为 31 条里有 25 条不读页面任何东西,省略层的报告会暗示页面已经覆盖了它们。
- 实际所用连接上测到的网络值,因为协议列表、密码套件和设置帧属于那条连接,而不属于浏览器整体。
- 需要两侧的那六条比对,在只读到页面值时标记为只测了一半。
公开来源
- RFC 8446: The Transport Layer Security (TLS) Protocol Version 1.3
- RFC 9113: HTTP/2
- RFC 7301: TLS Application-Layer Protocol Negotiation Extension
- MDN: Navigator.userAgentData
- MDN: Accept-Language
- BotBrowser:自动化一致性参考
实践结论
在报告里把文档中测到的部分和连接上测到的部分分开写,因为只有后者能覆盖权重达到 0.9 的那些规则。当唯一证据是一个页面值时,在规则旁写 half-measured,而不是写一个结果。把连接和结论一起保存,因为协商出的 alpn 和设置帧描述的是那条具体链路,而不是浏览器整体。关于一条触发的规则能否定罪的评分,读为什么单个异常信号从不定罪一个浏览器;关于一个库在任何结论之前如何给自身结论分组,读CreepJS 的信号分组与合并方式。
本文属于指南: 什么是浏览器指纹?原理、风险、信号与隐私边界