Bascule de proxy et continuité visible pour l’utilisateur
Distinguez échecs du proxy et de la destination, prévoyez des routes approuvées ordonnées, bornez les tentatives et consignez un changement de route comme une nouvelle affectation.
Vous voulez la documentation structurée pour Réseau ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
Pourquoi une route défaillante n’est pas une session continue
Une session de navigateur qui passe par un proxy dépend de deux éléments pouvant tomber en panne indépendamment : la route vers le proxy et la destination qui se trouve derrière. Quand la route échoue, l’exploitant d’un site web a besoin de trois réponses. Que peut encore voir l’utilisateur ? Que peut-on répéter sans risque ? Le passage à une autre route approuvée compte-t-il encore comme la même session ? La réponse courte est qu’une bascule peut rétablir le service, mais qu’elle ne fait pas continuer à l’identique la page, ses requêtes en cours ou son état applicatif, et qu’un changement de route de sortie est une nouvelle affectation réseau qui doit figurer dans le registre.
Les navigateurs proposent déjà un comportement de repli standard. Un fichier de configuration automatique de proxy peut renvoyer une liste ordonnée de routes, et le navigateur essaie l’entrée suivante après un échec de connexion. Le guide MDN sur les fichiers PAC décrit le format de la liste, et la documentation proxy de Chromium décrit la façon dont elle est évaluée. Ce comportement choisit où va la connexion suivante. Il ne dit rien de la survie de la page en cours de chargement, du formulaire à moitié envoyé ou du média en cours de lecture. Garder ces deux questions séparées est le cœur d’un bon plan de bascule.
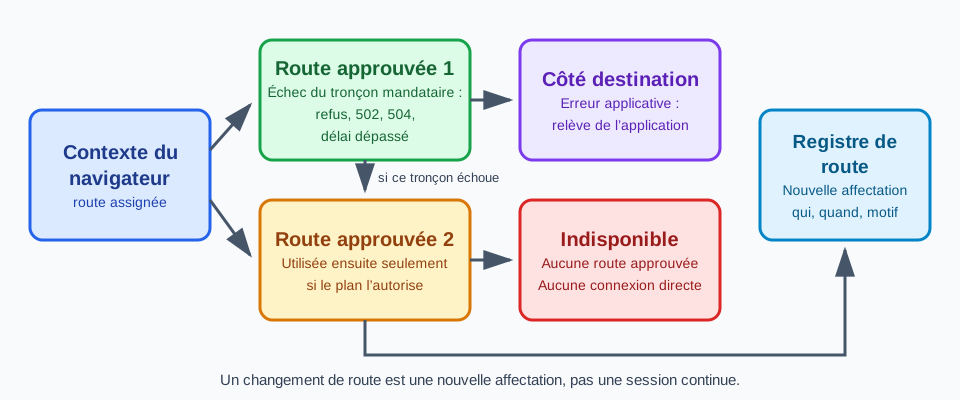
Trois termes gardent la suite précise. Une route est le chemin approuvé qu’un contexte de navigateur utilise pour atteindre des destinations, y compris le point d’accès du proxy et le compte qui se trouve derrière. Une catégorie d’échec indique quelle partie du chemin a échoué et qui prend la suite. Un énoncé de continuité décrit ce que vit ensuite l’utilisateur : la page se termine, une nouvelle tentative bornée réussit, un état indisponible clairement signalé apparaît, ou une nouvelle affectation de route ouvre un nouveau parcours. Proxy par contexte explique la propriété de la route au niveau du contexte. La bascule commence une fois cette affectation en place et examine ce qui se passe quand la route affectée cesse de fonctionner.
Le périmètre ici est le travail autorisé sur des routes approuvées. Un échec n’autorise jamais une connexion directe silencieuse ni une route non approuvée, et rien dans ces conseils ne décrit comment alterner les fournisseurs pour masquer une activité ou éviter les décisions d’accès d’une destination. L’objectif est un comportement prévisible pour l’utilisateur et un registre exact pour l’exploitant.
Distinguer les échecs du tronçon proxy de ceux de la destination
Une requête qui passe par un proxy HTTP traverse au moins deux tronçons : du client au proxy, puis du proxy à la destination. La RFC 9110 définit les codes d’état qui signalent un problème sur le second tronçon lorsqu’un proxy ou une passerelle intervient. Un 502 Bad Gateway signifie que le proxy a reçu une réponse invalide du serveur qu’il a contacté, et un 504 Gateway Timeout signifie qu’il n’a pas reçu à temps de réponse de ce serveur. La référence MDN sur le 502 explique ce même rôle de passerelle. Ces codes viennent du proxy et décrivent son côté amont. Ce ne sont pas les erreurs applicatives propres à la destination.
Les échecs qui surviennent avant la fin du tronçon proxy sont différents. Une connexion refusée vers le point d’accès du proxy, une résolution DNS échouée pour l’hôte du proxy ou un délai dépassé pendant la connexion se produisent avant qu’une requête n’atteigne une destination. Pour HTTPS, le navigateur demande d’abord au proxy d’ouvrir un tunnel avec la méthode CONNECT, et il ne démarre l’échange TLS avec la destination qu’après la réponse de succès du proxy. Un proxy qui refuse le tunnel, répond 407 Proxy Authentication Required ou répond par un état de passerelle à ce stade a fait échouer le tronçon proxy, même si la destination n’a jamais été contactée. Le guide MDN sur les serveurs proxy et les tunnels décrit ce tunnel.
Les échecs de destination forment une catégorie distincte. Une fois le tunnel ouvert, une erreur applicative, une erreur de certificat ou un rejet au niveau de l’application relèvent de la destination et de son responsable. Un 503 peut venir de l’un ou de l’autre côté : vérifiez qui l’a émis avant de l’attribuer. Rejouer une erreur de destination par une autre route aide rarement et peut répéter une action que la destination a déjà traitée. Une bonne catégorie d’incident nomme le tronçon, l’état ou l’erreur observé et le responsable : le support du fournisseur pour les échecs du tronçon proxy, le responsable de l’application pour les échecs de destination.
Pour chaque catégorie, écrivez à l’avance le résultat visible par l’utilisateur. Lorsque l’ouverture du tunnel est refusée, la page ne se charge pas et l’utilisateur voit une erreur de connexion ou l’état indisponible de l’application. Lorsqu’une navigation reçoit un 502 ou un 504 du proxy, l’utilisateur voit un document d’erreur, et une tentative ultérieure peut réussir. Lorsqu’une sous-ressource dépasse son délai, la page s’affiche partiellement, avec des images manquantes ou une fonction qui ne démarre pas. Lorsque la destination renvoie une erreur applicative, l’utilisateur voit le message propre à l’application. Nommer ces résultats permet au support d’expliquer ce qui s’est passé sans inspecter le trafic.
Le repli au niveau du navigateur ne réagit qu’à un ensemble étroit d’événements. La documentation de Chromium indique qu’en général seuls les échecs au niveau de la connexion permettent le repli de proxy, comme l’échec de résolution du nom DNS du proxy ou de connexion d’un socket vers lui, et que les échecs lors de l’établissement d’un tunnel CONNECT ont cessé d’être traités comme des déclencheurs à partir de la version 67. Un proxy qui répond 502 ne conduit donc pas le navigateur à essayer de lui-même l’entrée suivante de la liste. L’exploitant qui s’attend à ce que la route suivante soit utilisée après une erreur de passerelle compte sur un comportement que le navigateur ne fournit pas.
La même documentation précise que le repli n’offre aucune option de configuration et qu’un proxy marqué comme défaillant est placé en fin de liste pendant un certain temps au lieu d’être retiré. L’ordre des tentatives peut donc différer de l’ordre écrit. Consignez l’ordre que vous observez lors d’une répétition plutôt que de supposer l’ordre écrit.
Ce que l’utilisateur peut encore voir et répéter sans risque
Quand une route échoue au milieu d’un parcours, trois choses sont vraies de la page que l’utilisateur a sous les yeux. Le contenu déjà affiché reste à l’écran, car il se trouve dans la page et non dans la route. Les requêtes en cours se terminent par une erreur ou un délai dépassé, et la page décide comment le présenter. Les requêtes pas encore envoyées utilisent la route en vigueur au moment où elles démarrent. Une bascule produit donc une page en partie ancienne et en partie nouvelle, et l’application doit indiquer clairement les parties auxquelles elle se fie.
Un contenu affiché ne prouve pas qu’une opération est terminée. Un formulaire qui reste visible après un délai dépassé a pu être reçu ou non, et un indicateur de chargement qui ne se résout jamais ne dit rien à l’utilisateur. Donnez à chaque étape d’un parcours un signal d’achèvement que l’utilisateur et l’exploitant peuvent voir, comme un message de confirmation, un identifiant de requête renvoyé par le serveur ou un changement d’état sur une page de statut. Sans ce signal, l’hypothèse la plus sûre après un délai dépassé sur une requête qui modifie un état est que son résultat est inconnu.
L’idempotence détermine ce qui peut être répété. L’entrée du glossaire MDN définit une méthode idempotente comme une méthode pour laquelle émettre la même requête une ou plusieurs fois a le même effet voulu sur le serveur. La RFC 9110 classe PUT, DELETE et les méthodes sûres comme GET et HEAD parmi les méthodes idempotentes, tandis que POST ne l’est pas. Elle autorise un client à rejouer automatiquement une requête idempotente après un échec de connexion, avant d’avoir lu la réponse. Elle précise aussi qu’un client ne devrait pas rejouer automatiquement une requête non idempotente, sauf s’il dispose d’un moyen de savoir que la sémantique de la requête est en réalité idempotente, ou d’un moyen de détecter que la requête d’origine n’a jamais été appliquée.
Ces définitions décrivent un contrat de méthode et non ce que fait une application donnée. Un point d’accès GET qui modifie un état rompt le contrat, et un POST qui porte une clé vérifiée par le serveur peut être sûr à répéter. Marquez chaque opération du parcours comme répétable, répétable seulement avec une clé vérifiée par le serveur, ou non répétable sans confirmation de l’utilisateur. Un navigateur ne peut pas déduire d’un délai dépassé si une action non idempotente a déjà pris effet ; une nouvelle tentative de paiement, de message ou de modification de compte doit donc interroger l’utilisateur ou vérifier d’abord le statut.
Idempotent ne veut pas dire gratuit. Répéter une lecture par une autre route peut renvoyer une autre version régionale de la page, une autre copie en cache ou un autre état de limitation de débit, et la destination peut compter la répétition comme une charge supplémentaire. Gardez les répétitions peu nombreuses et bornées, comme décrit dans la section suivante, et ne rendez pas une répétition silencieuse lorsque la différence compterait pour l’utilisateur.
L’authentification demande la même attention. Un cookie de session posé par la destination appartient au contexte du navigateur et non à la route ; il subsiste donc en général après un changement de route. Une destination peut néanmoins demander à l’utilisateur de confirmer une connexion après un changement de localisation réseau. Traitez cette confirmation comme un résultat normal et ne concevez pas le parcours en supposant qu’elle n’aura pas lieu. Gardez les identifiants du proxy hors des registres d’échec ; authentification du proxy dans le navigateur et hygiène des identifiants explique comment les traiter.
Planifier des routes ordonnées et un budget de tentatives borné
Un plan de bascule est un court document en quatre parties : la liste ordonnée des routes approuvées, les catégories d’échec qui autorisent le passage à la route suivante, le budget de tentatives de chaque route et l’état final lorsque la liste est épuisée. Rédigez-le avant un incident et conservez-le auprès du responsable de la route, car le contact du fournisseur, le responsable réseau et le responsable de l’application en détiennent chacun une partie.
Ne listez que des routes approuvées pour la charge de travail, la région et la catégorie de destination, dans l’ordre où elles doivent être essayées. Une seconde route demande la même approbation que la première, y compris l’autorisation de la cible et le traitement des données. Une route qui se trouve être joignable n’est pas une route de remplacement approuvée. Si un fichier PAC ou une liste de proxys du navigateur exprime le plan, lisez la liste comme sa forme technique : chaque entrée est une route que le plan accepte. Une entrée directe dans cette liste est la décision de sortir de la frontière du proxy. La documentation de Chromium indique aussi que, lorsqu’un fichier PAC ne peut pas être récupéré, la résolution peut retomber sur l’option suivante, souvent une connexion directe silencieuse, sauf si le script est marqué comme obligatoire ; vérifiez donc ce que fait votre configuration dans ce cas.
Donnez à chaque route un petit nombre fixe de tentatives et une limite de durée pour l’ensemble du parcours, et consignez les deux comme des valeurs de politique choisies par l’équipe. Ces valeurs reviennent au responsable de l’application, car un document en cours de lecture, une étape de paiement et une synchronisation en arrière-plan ne tolèrent pas les mêmes attentes. Espacez les tentatives pour qu’un fournisseur en cours de rétablissement ne reçoive pas une rafale de requêtes répétées, et ne rejouez automatiquement que les opérations marquées répétables. Les opérations non répétables passent par la voie de confirmation de l’utilisateur décrite plus haut.
Décidez à l’avance quels échecs autorisent un changement. Passer à la route suivante est raisonnable lorsque l’échec relève du tronçon proxy : le point d’accès est injoignable, le tunnel est refusé, ou le proxy renvoie de façon répétée des états de passerelle pour des destinations différentes. Ce n’est pas raisonnable lorsque l’échec relève de la destination. Ce ne l’est pas non plus lorsque le proxy rejette les identifiants, car un 407 signale un problème de compte qu’une autre route ne réparera pas et que le fournisseur doit résoudre. La décision d’accès d’une destination est une décision et non un échec à contourner par une autre route ; changer de route en réponse à une telle décision sort de l’usage approuvé.
Montrez à l’utilisateur une progression honnête pendant l’exécution du plan. Un message comme reconnexion en cours est exact tant qu’il reste des tentatives, et un message d’indisponibilité est exact une fois le budget épuisé. Une boucle sans fin ne donne ni l’un ni l’autre. Si plusieurs contextes de navigateur partagent une route, un échec les atteint chacun ; appliquez donc le plan par contexte et tenez aussi le registre par contexte.
Changements de route et états indisponibles
Un changement de route modifie la sortie que voit la destination. C’est une nouvelle affectation de route et non la continuation de l’ancienne. Consignez-la avec l’identifiant du contexte, le nom de la route précédente, le nom de la nouvelle route, l’heure, la catégorie du déclencheur et la personne qui l’a approuvée. La destination observe une nouvelle origine réseau et peut raisonnablement traiter les requêtes suivantes comme venant d’un autre endroit ; tout ce qui dépendait de l’origine précédente, comme une page régionale, un état de limitation de débit ou la confirmation d’une connexion, doit donc être considéré comme possiblement modifié. Ce registre permet au support d’expliquer pourquoi l’utilisateur a vu une nouvelle invite et permet à une revue de version de comparer les parcours avant et après un changement.
Ne présentez pas le résultat comme une seule session continue. Dans les rapports et les notes de support, étiquetez le segment avant le changement et le segment après comme des affectations de route distinctes au sein d’un même contexte de navigateur. Les cookies et le stockage vivent avec le contexte ; l’état de l’application peut donc subsister alors que l’origine réseau a changé. Les deux faits relèvent du registre, car la continuité des données et la continuité de la route sont indépendantes. Une explication destinée à l’utilisateur doit dire ce qui s’est passé en termes ordinaires : la connexion a été rétablie par une autre route approuvée, et il se peut que l’on vous demande de confirmer.
Les requêtes parties avant le changement se terminent par l’ancienne route ou échouent, et celles qui partent ensuite utilisent la nouvelle route ; une page peut donc combiner des réponses des deux. Ne renvoyez pas une requête non idempotente simplement parce que la route a changé. Appliquez les mêmes règles qu’avant : ne rejouez que ce qui est marqué répétable, et vérifiez le statut avant toute autre chose.
Lorsqu’il n’existe aucune route de remplacement approuvée, le plan se termine par un état indisponible, et cet état final est explicite. Il indique que le service est injoignable, nomme ce que l’utilisateur peut faire ensuite, comme réessayer plus tard ou contacter le support, et écrit une entrée de journal avec la catégorie d’échec et le responsable de la route. Il ne se termine ni par une connexion directe implicite, ni par un fournisseur non approuvé, ni par une boucle silencieuse. Une page qui se charge par une connexion directe après l’échec du proxy peut ressembler à un succès, mais elle a modifié la frontière réseau sans décision, peut exposer à la destination l’adresse propre de l’organisation et rompt la prémisse sous laquelle le parcours avait été approuvé.
Concevez l’état indisponible avec soin. Conservez localement ce que l’utilisateur a saisi lorsque l’application le permet, désactivez les commandes qui répéteraient une action non répétable tant que le statut n’est pas confirmé, et renvoyez vers une page de statut lorsqu’il en existe une. Un texte indiquant que le service n’a pas pu être atteint par la route approuvée est plus utile qu’une erreur générique, car il dit au support quel responsable contacter.
Revenir à la route principale après son rétablissement est un autre changement de route, et le même registre s’applique. Évitez les allers-retours en réaction à de brèves interruptions. Conservez une route pendant la durée d’un parcours et réévaluez à une limite naturelle, comme une nouvelle tâche ou un nouveau contexte de navigateur, afin que chaque segment du registre ait un début clair et un motif clair.
Revue opérationnelle et adéquation du produit
Répétez chaque catégorie d’échec avant de vous fier au plan. Utilisez une destination que vous maîtrisez, une route de test qui refuse les connexions, un proxy de test qui renvoie un état de passerelle et un point d’accès de destination qui renvoie une erreur applicative. Consignez le résultat visible par l’utilisateur de chaque répétition et le responsable que nomme le registre. Ne répétez pas contre des destinations tierces d’une manière qui les surcharge ou qu’elles n’attendraient pas.
Recommencez la répétition après un changement de forfait du fournisseur, une migration de point d’accès, un changement de région, une mise à jour majeure du navigateur ou une modification importante de la destination. Gardez le dernier plan accepté disponible pendant que vous évaluez un candidat, et comparez le même parcours dans les deux. Les critères d’acceptation sont le résultat pour l’utilisateur, l’échec borné et le responsable du rétablissement, et non une étiquette de protocole.
Plusieurs équipes se partagent en général ce plan. Le fournisseur répond de la disponibilité des routes, le responsable réseau qualifie les routes et leur ordre, le responsable de l’application décide quelles opérations sont répétables et ce que dit l’état indisponible, et le responsable du contexte applique la route affectée et tient le registre. Une courte transmission entre ces responsables constitue une preuve plus solide qu’une seule ligne de journal, et elle garde les identifiants et le trafic détaillé dans les systèmes contrôlés qui les protègent déjà.
BotBrowser documente l’affectation d’un proxy par contexte et le changement de proxy à l’exécution au moyen d’une commande CDP pour un contexte de navigateur existant (ENT Tier3), où les requêtes en cours se terminent par le proxy précédent et les nouvelles utilisent le proxy mis à jour, de sorte qu’un exploitant peut appliquer un changement de route contrôlé et consigné. BotBrowser ne documente ni contrôle d’état ni bascule automatique du proxy, ne peut pas migrer les requêtes en cours ni garantir la continuité de la page lors d’un changement de route, et ne peut pas réparer la route défaillante d’un fournisseur.
En pratique, traitez la commande de changement comme l’étape qu’autorise le plan et non comme une boucle de rétablissement. La documentation de BotBrowser indique d’attendre la fin de chaque commande avant d’envoyer un autre changement pour le même contexte ou de lancer une navigation qui dépend de la nouvelle route, et précise que la commande détecte de nouveau l’adresse de sortie, sauf si celle-ci est fournie avec la commande, et met à jour le fuseau horaire, les paramètres régionaux et la langue de ce contexte. Consignez ces changements dans le registre de route avec la nouvelle route, car ils font partie de ce que voit la destination après le changement. Changement dynamique de proxy décrit la commande plus en détail, et sémantique du proxy HTTP et requêtes du navigateur explique comment les navigateurs utilisent les tunnels CONNECT et les réponses du proxy.
Exécuter les vérifications de bascule
Appliquez ces vérifications à une répétition en préproduction et consignez un succès ou un échec pour chacune.
- Répétez un tunnel refusé, un état de passerelle venant du proxy, un délai de connexion dépassé et une erreur applicative de la destination. Succès si le registre classe chaque cas comme échec du tronçon proxy ou de la destination, nomme un responsable et indique le résultat visible par l’utilisateur. Échec si l’un d’eux n’est signalé que comme une erreur de page générique.
- Exécutez un cas où le proxy renvoie un état de passerelle et un cas où la destination renvoie une erreur applicative pour la même page. Succès si les deux apparaissent comme des résultats distincts avec des responsables différents. Échec s’ils sont fusionnés dans un seul décompte d’échecs.
- Comparez le plan écrit avec la liste de routes configurée. Succès si les routes ordonnées correspondent aux routes approuvées, si le budget de tentatives et la limite de durée du parcours sont écrits, et si aucune entrée directe ni route non approuvée n’apparaît. Échec si la configuration contient une entrée que le plan ne liste pas.
- Pendant un délai dépassé répété, classez chaque opération du parcours comme répétable, répétable seulement avec une clé vérifiée par le serveur, ou non répétable sans confirmation. Succès si seules les opérations répétables ont été renvoyées automatiquement. Échec si une requête non idempotente a été renvoyée sans clé ni confirmation de l’utilisateur.
- Déclenchez un passage contrôlé à la route approuvée suivante. Succès si le registre montre le contexte, la route précédente, la nouvelle route, l’heure, la catégorie du déclencheur et l’approbateur comme une nouvelle affectation de route. Échec si un rapport présente les deux segments comme une seule session continue.
- Désactivez la route de remplacement et répétez l’échec. Succès si le parcours se termine par l’état indisponible avec la catégorie d’échec et le responsable de la route consignés, et si le registre réseau ne montre aucune connexion hors de la route approuvée. Échec si la page se charge par une connexion directe ou si les tentatives se poursuivent sans fin.
Sources
Articles Connexes
Faites passer BotBrowser de la recherche à la production
Utilisez ces guides pour comprendre le modèle, puis passez à la validation multi-plateforme, aux contextes isolés et au déploiement navigateur prêt pour l'échelle.