Cycle de vie et confidentialité du cache des service workers
Comment l’enregistrement, l’installation, l’activation et la mise à jour d’un service worker déterminent le propriétaire de chaque cache et comment le versionner et le vider.
Vous voulez la documentation structurée pour Identité ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
Pourquoi le cache d’un service worker a besoin d’un responsable
Un service worker permet à un site de répondre à des requêtes réseau depuis un stockage local, généralement Cache Storage. C’est utile pour les pages hors ligne et les visites répétées plus rapides. Cela signifie aussi qu’une réponse peut survivre à la page, à la visite et parfois au compte qui l’a fait enregistrer. La spécification Service Workers décrit le worker et son cycle de vie, et la référence CacheStorage de MDN décrit les caches nommés que le worker ou la page peuvent ouvrir.
Cache Storage appartient à l’origine, pas à une version précise du worker. Un cache créé par un ancien worker reste en place quand un nouveau worker prend le relais, et rien ne le supprime sauf si le code de l’application le fait, si le navigateur évince des données faute d’espace ou si l’utilisateur ou une réponse Clear-Site-Data efface les données du site. Le moment de cette éviction varie selon les navigateurs et les versions : considérez-la comme un filet de sécurité, pas comme un plan de nettoyage.
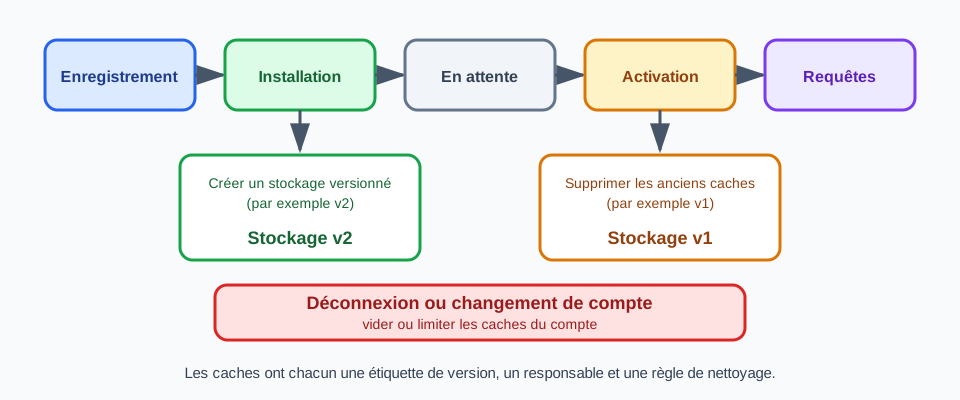
La question pratique est donc la propriété. Pour chaque cache, une équipe devrait pouvoir dire quelle version du worker l’a créé, quelle version a le droit de le supprimer et à quelle session ou à quel compte son contenu appartient. Un cache sans responsable nommé est un cache que personne ne videra.
Prenez une tablette partagée à un guichet d’accueil. Le personnel se connecte, ouvre un tableau de bord et se déconnecte en fin de service. Si le worker a enregistré des réponses d’API propres au compte pendant ce temps, la personne suivante qui ouvre le tableau de bord peut retrouver ces réponses dans le stockage du navigateur, même si l’interface affiche un état déconnecté. Rien de cette défaillance n’apparaît à l’écran, et c’est pourquoi elle passe facilement inaperçue. Le même schéma se retrouve sur les ordinateurs familiaux, les bornes et tout profil de navigateur utilisé par plusieurs comptes au fil du temps.
Cache Storage n’est d’ailleurs qu’un des endroits où un site conserve un état. Le cache HTTP du navigateur, les cookies, localStorage, IndexedDB et les enregistrements de service workers sont des stockages distincts, avec des voies de nettoyage distinctes. En vider un ne vide pas les autres. Quand une revue demande ce qui reste après une déconnexion, elle doit énumérer chaque stockage utilisé par l’application et les vérifier un par un, plutôt que de conclure d’une seule liste vide que l’appareil est propre.
L’obsolescence et la confidentialité ont une cause commune. Un cache qui n’est jamais nettoyé peut servir un script périmé après une correction, et une vue de compte périmée après une déconnexion. Dans les deux cas, l’utilisateur voit un contenu que le serveur ne renverrait plus. Traiter le nettoyage comme une partie de la livraison, et non comme une tâche ultérieure, répond aux deux risques avec la même règle et la même revue.
Les étapes du cycle de vie
Une page demande au navigateur d’enregistrer un worker pour une portée. Le navigateur télécharge le script et exécute l’étape d’installation. Un worker installé alors qu’un ancien worker contrôle encore des pages ouvertes passe à un état d’attente jusqu’à la fermeture de ces pages ou jusqu’à ce que l’application choisisse d’ignorer l’attente. L’étape d’activation s’exécute ensuite, et à partir de là le worker traite les événements fetch des pages qu’il contrôle. Le guide du cycle de vie de web.dev parcourt ces étapes avec des exemples.
Les mises à jour découlent du script lui-même. Quand le navigateur constate que le script du worker diffère de celui qui est installé, il installe la nouvelle version à côté de l’ancienne au lieu de la remplacer sur place. La fréquence à laquelle le navigateur vérifie si le script a changé dépend de la navigation, des événements fonctionnels et de la politique du navigateur lui-même ; un déploiement ne doit donc pas supposer que chaque utilisateur reçoit le nouveau worker à un moment prévisible.
C’est pourquoi un nouveau worker peut être installé sans être en service. Une personne qui relit et voit le nouveau script sur le serveur ne peut pas en conclure qu’il sert déjà des pages. Le worker est actif, en attente ou remplacé, et la vérification doit lire cet état au lieu de le supposer. Consultez le guide Using Service Workers pour voir les événements concernés.
Deux appels modifient le comportement de l’attente et méritent une décision délibérée. Ignorer l’étape d’attente fait qu’un nouveau worker s’active immédiatement, et réclamer les clients lui permet de prendre le contrôle des pages ouvertes avant lui. Les deux peuvent convenir pour une petite correction, mais ils signifient aussi qu’une page ouverte qui a chargé d’anciens scripts peut se mettre à recevoir des réponses d’un cache préparé pour la nouvelle version. Si l’ancienne page et le nouveau cache ne sont pas compatibles, l’utilisateur voit un comportement cassé qu’aucune version ne contient à elle seule. Consignez si l’application ignore l’attente et ce que cela provoque sur les pages ouvertes.
La portée d’enregistrement compte aussi. Un worker ne contrôle que les pages situées dans sa portée, et les pages de la même origine partagent l’accès aux mêmes entrées de cache. Un cache rempli par un worker peut donc être lu par des pages que ce worker ne contrôle pas, une raison de plus de nommer chaque cache et son responsable.
L’étape fetch est celle où le worker décide quoi servir. Les ressources statiques qui ne changent qu’avec une version se prêtent à une approche cache d’abord, car l’étiquette de version contrôle déjà la fraîcheur. Les pages personnalisées et les réponses d’API se prêtent généralement à une approche réseau d’abord, et certaines ne devraient jamais être stockées. Rédiger la stratégie par catégorie de requête, plutôt qu’une règle unique pour le site entier, simplifie la règle de nettoyage qui suivra, puisque chaque catégorie correspond à un cache dont le responsable et la durée de vie sont connus.
Une mise à jour déployée peut s’observer au lieu de se deviner. Les outils de développement listent le worker enregistré, l’adresse de son script et indiquent si une version plus récente est en attente. Après une livraison, chargez l’application dans un contexte neuf, lisez ce panneau et notez l’état dans le dossier de livraison. Si un worker en attente est signalé, décidez s’il faut attendre la fermeture des pages, inviter l’utilisateur à recharger ou ignorer l’attente, et consignez cette décision.
Caches versionnés et nettoyage à l’activation
Donnez à chaque cache un nom qui porte une étiquette de version, par exemple un préfixe pour la coque de l’application suivi d’une étiquette de version. Créez le nouveau cache versionné et remplissez-le pendant l’étape d’installation, car c’est le moment où le nouveau worker prépare ses propres ressources pendant que l’ancien continue de servir les pages depuis l’ancien cache.
Séparez les caches par finalité, pas seulement par version. Un cache pour les fichiers de la coque de l’application, un cache pour les images et un cache pour les données du compte n’ont pas la même durée de vie. Le cache de la coque est remplacé à chaque version, celui des images peut être élagué selon l’ancienneté ou le nombre, et celui du compte s’arrête avec la session. Les garder dans des caches nommés distincts permet à la règle de nettoyage de traiter chacun correctement et à la personne qui relit de dire quel cache contient quoi sans ouvrir les entrées une à une.
Supprimez les anciens caches pendant l’étape d’activation. L’activation est le premier moment où l’ancien worker n’est plus nécessaire, et supprimer son cache plus tôt peut casser des pages encore en cours d’exécution. Une règle courante énumère les noms de cache, conserve ceux qui correspondent à la version actuelle et supprime les autres. Mettez cette règle par écrit pour qu’une revue puisse la tester.
Soyez attentif aux noms que la règle de nettoyage peut supprimer. Cache Storage est partagé par l’origine entière ; une liste de noms de cache peut donc inclure des caches créés par un autre code de la même origine, comme un ancien worker destiné à une autre fonction. Limitez la suppression aux noms qui commencent par votre propre préfixe. Rappelez-vous aussi qu’une requête en échec pendant le remplissage du nouveau cache à l’installation peut empêcher complètement l’installation du nouveau worker, ce qui laisse en place l’ancien worker et son cache. Vérifiez l’état du worker après une livraison au lieu de supposer que l’installation s’est terminée.
Cache Storage n’applique pas de lui-même les règles de fraîcheur HTTP. Une entrée reste en place jusqu’à ce que le code la supprime, ce qui explique qu’une réponse périmée puisse continuer à apparaître après une correction côté serveur. Gardez l’étiquette de version dans le nom du cache, placez le contenu qui change sous un nouveau nom et laissez la règle d’activation supprimer le précédent.
N’utilisez pas un worker pour intercepter, réécrire ou conserver des données au-delà de ce dont la page a besoin pour fonctionner. L’objectif de ce cycle de vie est un stockage plus réduit et plus prévisible, pas une couche cachée qui retient des réponses que personne ne voit. Gardez le nettoyage visible pour les personnes qui exploitent le site.
Gardez le code de nettoyage court et testé. Une routine qui liste les noms, filtre par préfixe et supprime les anciennes versions est assez courte pour être lue en revue. Exécutez-la dans un contexte qui contient déjà plusieurs anciennes versions, car une routine testée uniquement sur une installation neuve ne rencontre jamais le cas pour lequel elle existe. Pendant les tests, affichez dans la console de développement les noms qu’elle supprime afin de comparer le résultat avec la liste des caches ensuite.
Déconnexion, changement de compte et Clear-Site-Data
Certaines réponses sont propres à un utilisateur connecté. Un cache qui les contient n’est pas une ressource hors ligne anodine : après une déconnexion ou un changement de compte sur un appareil partagé, l’utilisateur suivant peut voir ce que le compte précédent a enregistré. Il est préférable de ne pas mettre en cache les réponses authentifiées ou propres à un compte. Si une fonction en a besoin hors ligne, limitez le cache à ce compte et supprimez-le à la fin de la session.
L’ordre des étapes de déconnexion compte. Terminez d’abord la session côté serveur, supprimez ensuite les caches du compte, puis effacez l’état que la page conserve en mémoire. Si l’application a plusieurs onglets ouverts, prévenez les autres onglets que le compte a changé, par exemple avec un message de diffusion, afin qu’un onglet resté ouvert ne continue pas d’afficher les données en cache du compte précédent. Testez la séquence avec deux onglets ouverts, car un test avec un seul onglet masque ce cas.
À la déconnexion, l’application peut supprimer les caches du compte depuis le code de la page et demander au worker d’abandonner tout état en mémoire. La spécification Clear-Site-Data définit aussi un en-tête de réponse dont les directives peuvent demander au navigateur de vider les données en cache ou stockées pour l’origine, et la directive de stockage couvre le stockage de l’origine accessible aux scripts et désenregistre ses service workers ; la spécification ne cite pas Cache Storage par son nom. La prise en charge des directives et leur couverture exacte varient selon le navigateur ; confirmez donc le résultat dans chaque navigateur utilisé par vos utilisateurs au lieu de vous fier au nom de l’en-tête.
Les en-têtes du serveur aident, mais ils ne remplacent pas la logique du worker. Une réponse marquée comme ne devant pas être stockée indique aux caches partagés et privés comment se comporter, pourtant Cache Storage laisse cette décision au code du worker, qui choisit de placer ou non une réponse dans un cache. Faites vérifier au worker ce qu’il s’apprête à stocker et gardez par défaut les réponses propres à un compte hors des caches de longue durée. Une courte liste explicite de chemins pouvant être mis en cache se relit plus facilement qu’une longue liste d’exceptions.
Un changement de compte mérite la même attention qu’une déconnexion, car le profil du navigateur reste le même alors que l’utilisateur change. Videz ou limitez les caches du premier compte avant que le second ne se charge, puis lisez la liste des caches pour le confirmer. Lire la liste est un signal plus fort que de croire que le code de nettoyage s’est exécuté.
Les personnes qui partagent un appareil méritent un moyen visible d’effacer les données stockées. Si l’application conserve des données de compte hors ligne, proposez à la déconnexion ou dans les paramètres une commande claire qui les supprime, et indiquez en termes simples ce qui sera supprimé. Les utilisateurs d’appareils partagés ne peuvent pas inspecter Cache Storage eux-mêmes ; l’application est donc le seul endroit où ce choix peut être offert.
Gardez aussi cette frontière claire pour les utilisateurs. Une déconnexion visible qui laisse discrètement des réponses du compte sur l’appareil est un défaut de confidentialité, même si aucun traceur n’intervient. Pour plus de contexte sur la façon dont les navigateurs séparent l’état, consultez le partitionnement du stockage et la confidentialité et la gestion des cookies.
Tester le comportement du cache par contexte
BotBrowser permet d’attribuer à chaque BrowserContext son propre stockage et son propre état de session, et les service workers créés dans un contexte héritent de l’empreinte de ce contexte, de sorte qu’une équipe peut tester séparément le cycle de vie du cache d’un worker pour chaque identité. BotBrowser n’écrit pas, ne versionne pas et ne purge pas les caches de service worker d’une application, et il ne peut pas rendre sûre une conception de cache périmé ou qui fuit ; le nommage des caches, le nettoyage à l’activation et le vidage à la déconnexion restent des responsabilités de l’application.
L’isolation par contexte est utile parce que le même site peut être chargé dans deux contextes avec des comptes différents, et que chaque contexte affiche son propre enregistrement et sa propre liste de caches. Si le second contexte affiche des entrées créées par le premier, l’application a un problème de portée, pas un problème de navigateur. La documentation sur l’isolation multicompte décrit le modèle de stockage par contexte, et l’isolation de navigateur multicompte explique comment les équipes la planifient.
Un test pratique utilise deux contextes. Dans le premier contexte, connectez-vous avec un compte, chargez l’application, laissez le worker s’installer et ouvrez quelques pages. Consignez l’état de l’enregistrement et les noms des caches. Dans le second contexte, connectez-vous avec un autre compte et consignez les mêmes informations. Les deux listes ne doivent pas partager d’entrées propres à un compte. Déconnectez-vous ensuite dans le premier contexte et relisez sa liste de caches. Enfin, confirmez que le second contexte conserve ses propres entrées, ce qui montre que le nettoyage dans un contexte n’a pas atteint l’autre.
Gardez le dossier court et reproductible. Notez la version du navigateur, le nom du contexte, la version du script du worker, la liste des caches avant et après la mise à jour, la liste des caches après la déconnexion et l’état du worker. Ne collez pas de corps de réponse, de jetons ni de données de clients dans le dossier. Une courte liste de noms de cache avec des résultats de réussite ou d’échec suffit pour une revue de livraison, et elle permet à la personne suivante de refaire la même vérification après le prochain déploiement.
Exécutez la même revue du cycle de vie dans chaque contexte qui compte pour le produit et consignez le résultat par contexte. Ne réutilisez pas la réussite d’un contexte pour un autre.
Exécuter les vérifications du cycle de vie du cache
Exécutez ces vérifications dans les outils de développement du navigateur ou avec un court script, et consignez réussite ou échec pour chaque cache.
- Nommez les étapes du cycle de vie utilisées par le worker (enregistrement, installation, attente, activation, fetch). Réussite si les caches versionnés sont créés dans le gestionnaire d’installation et supprimés dans celui d’activation. Échec si le nettoyage s’exécute à l’installation.
- Listez les noms de cache, leur étiquette de version et leur responsable. Réussite si chaque nom correspond à une version du worker et à une catégorie de données. Échec pour tout nom que personne ne sait expliquer.
- Rédigez la règle de nettoyage à l’activation et la règle de déconnexion. Réussite si les deux indiquent ce qui est conservé et ce qui est supprimé.
- Une fois le nouveau worker activé, listez de nouveau les caches. Réussite si aucun cache d’une ancienne version ne subsiste. Échec si un ancien nom est toujours présent. Tant que le worker est en attente, consignez l’ancien cache comme en suspens.
- Vérifiez l’état du worker après la mise à jour. Réussite si le nouveau worker est actif ou signalé en attente. Échec si la revue a supposé qu’il était en service sans lire l’état.
- Repérez les caches qui contiennent des réponses authentifiées ou propres à un compte. Réussite s’ils sont limités au compte et disparaissent après la déconnexion ou un changement de compte. Échec s’ils sont traités comme de simples ressources hors ligne.
- Répétez les vérifications 1 à 6 dans chaque contexte du navigateur et consignez un résultat distinct pour chacun.
Sources
Articles Connexes
Faites passer BotBrowser de la recherche à la production
Utilisez ces guides pour comprendre le modèle, puis passez à la validation multi-plateforme, aux contextes isolés et au déploiement navigateur prêt pour l'échelle.