Authentification proxy du navigateur et hygiène des identifiants
Séparez les identifiants du proxy des connexions au site, gardez-les hors des journaux et du code, encodez-les bien dans l’URL et lisez les erreurs 407 et SOCKS.
Vous voulez la documentation structurée pour Réseau ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
Pourquoi les identifiants du proxy exigent un traitement distinct
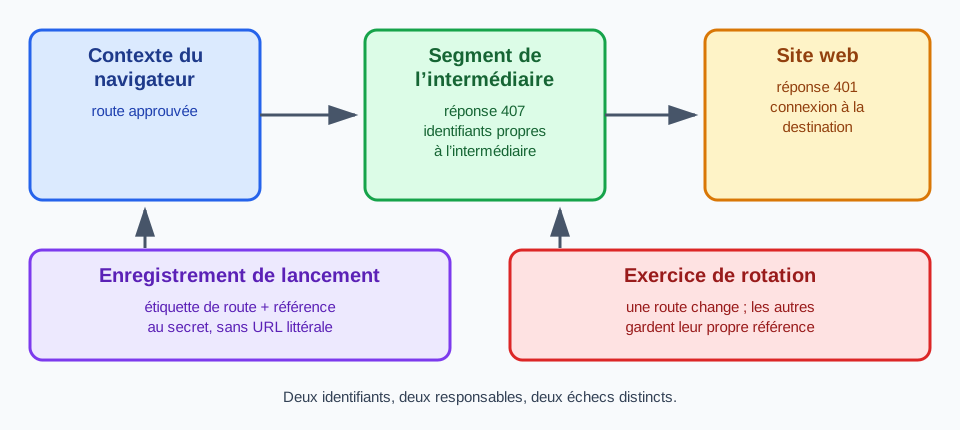
Un navigateur qui passe par un proxy authentifié manipule deux jeux d’identifiants sans rapport entre eux. L’identifiant du proxy montre que votre organisation peut utiliser la route. La connexion à la destination montre qu’une personne peut utiliser un compte sur un site web. Ils sont émis par des parties différentes, expirent selon des calendriers différents, et la fuite de l’un appelle une réponse différente de celle de l’autre. Les traiter comme une seule « connexion » est la première erreur de nombreuses revues d’identifiants.
La distinction est pratique, pas seulement conceptuelle. L’identifiant du proxy appartient généralement à un compte de service ou à un tableau de bord du fournisseur, et il est partagé par les tâches qui utilisent la route. La connexion à la destination appartient à un utilisateur ou à un compte de test et circule dans le trafic de la page. Si les deux se trouvent dans un même fichier de configuration ou dans un même secret, la rotation de l’identifiant du proxy peut verrouiller un compte de test, et un changement de mot de passe de la destination peut ressembler à une panne du proxy. Conservez-les dans des secrets séparés, avec des responsables distincts et des historiques de rotation distincts.
Ces recommandations concernent les proxys que votre organisation est autorisée à utiliser, selon les conditions du fournisseur qui a émis les identifiants. Elles ne portent pas sur la recherche, les essais au hasard, le partage ou la revente d’identifiants, et elles ne décrivent aucun moyen de contourner les contrôles d’accès d’un fournisseur. Si un identifiant n’est pas à vous, aucune pratique de gestion ne rend la route acceptable.
Les noms de protocoles fixent aussi des attentes. L’authentification HTTP Basic et la méthode nom d’utilisateur et mot de passe de SOCKS5 sont des moyens de présenter un nom d’utilisateur et un mot de passe. Aucune des deux ne protège la confidentialité du secret à elle seule : Basic utilise un encodage que n’importe qui peut inverser, et la méthode SOCKS5 envoie les valeurs telles quelles si autre chose ne protège pas la connexion. La confidentialité dépend du transport entre le navigateur et le proxy, de ce que le fournisseur journalise et de la façon dont votre propre outillage traite la valeur. Ces éléments diffèrent d’un déploiement à l’autre ; une revue doit donc les nommer plutôt que les supposer.
Les endroits par où un identifiant peut fuir sont plus nombreux qu’il n’y paraît. Un secret peut se retrouver dans le gestionnaire de versions, dans une ligne de commande visible dans la liste des processus, dans le journal d’une tâche qui répète ses arguments de lancement, dans un message d’erreur qui cite l’adresse du proxy, dans une capture d’écran d’un terminal, dans un ticket de support ou dans un fichier de configuration partagé. L’hygiène des identifiants consiste à décider, pour chacun de ces endroits, si le secret peut y figurer, puis à vérifier qu’il n’y figure pas.
La configuration des routes est présentée dans Configuration du proxy, et la façon dont les navigateurs utilisent les tunnels CONNECT et les en-têtes de proxy est expliquée dans Sémantique du proxy HTTP et requêtes du navigateur. L’accent est mis ici sur l’identifiant lui-même : comment il est présenté, écrit, stocké, renouvelé et tenu à l’écart des endroits où il n’a pas sa place.
Comment lire les échecs d’authentification 407, 401 et SOCKS
Lorsqu’un proxy exige une authentification, il répond à la requête par le statut 407 Proxy Authentication Required et un en-tête Proxy-Authenticate qui nomme le schéma accepté. Le client réessaie alors avec un en-tête Proxy-Authorization. RFC 9110 définit les deux en-têtes et le statut, et les pages MDN sur Proxy-Authorization et 407 les résument pour les développeurs web. Le point important est de savoir à qui appartient la demande d’authentification : un 407 est émis par un proxy, il désigne donc le segment du proxy dans la route.
Une réponse 401 Unauthorized est la demande d’authentification propre à la destination. Elle porte un en-tête WWW-Authenticate et reçoit une réponse avec un en-tête Authorization. Les deux échanges peuvent survenir pendant un même chargement de page, et chacun utilise son propre identifiant. Un 407 signifie que le proxy n’a pas accepté l’identifiant du proxy. Un 401 signifie que le proxy a accepté la route et que la destination n’a pas accepté la connexion. Les confondre envoie l’enquête vers le mauvais responsable et le mauvais secret.
Les destinations HTTPS ajoutent un détail. Le navigateur demande d’abord au proxy d’ouvrir un tunnel avec une requête CONNECT, et l’authentification du proxy a lieu sur cette requête. La session TLS de la destination et toute demande 401 n’apparaissent qu’une fois le tunnel établi. Un échec d’authentification du proxy sur une page HTTPS se manifeste donc par un échec d’établissement du tunnel, souvent avant tout contenu de page, et non par une réponse du site. Par ailleurs, Proxy-Authorization est destiné au proxy qui l’a demandé et n’est pas transmis à la destination.
HTTP Basic est défini dans RFC 7617. Le client joint le nom d’utilisateur et le mot de passe par deux-points et applique Base64. Base64 est un encodage réversible qui n’apporte aucun secret ; la RFC précise que Basic n’offre pas de confidentialité à lui seul et qu’il doit être utilisé sur une connexion protégée. Comme les deux-points servent de séparateur, le nom d’utilisateur ne peut pas en contenir, alors que le mot de passe le peut. Quand un identifiant contient de tels caractères, la façon de les écrire dans une URL compte.
SOCKS5 utilise un échange différent. Une fois que le client et le serveur se sont accordés sur la méthode nom d’utilisateur et mot de passe définie dans RFC 1929, le client envoie le nom d’utilisateur et le mot de passe, chacun de 255 octets au plus, et le serveur répond par un statut. Un statut nul signifie le succès. Toute autre valeur est un échec, et le serveur ferme la connexion. Le navigateur ne reçoit pas de page 407, car SOCKS n’a pas de codes de statut HTTP. Un échec d’authentification sur une route SOCKS5 se manifeste par une connexion refusée ou fermée pendant l’établissement ; le texte de l’erreur est donc généralement moins précis qu’une réponse HTTP. La méthode ne chiffre pas elle-même les valeurs.
Un rapport borné d’un échec d’authentification nomme le segment et la catégorie, rien de plus. Par exemple : « authentification du proxy refusée pour la route R, demande reçue, aucun tunnel ouvert ». Il n’inclut ni la valeur de Proxy-Authorization, ni le nom d’utilisateur, ni l’URL complète du proxy, ni le corps de la réponse du fournisseur. Signaler le résultat comme une erreur d’authentification, et non comme un délai dépassé ou une panne réseau générique, garde la bonne action suivante : vérifier l’identifiant et son expiration, pas la configuration DNS ni la destination.
Les nouvelles tentatives répétées ont besoin d’une limite. Une route qui renvoie 407 alors qu’un identifiant correct a été fourni continuera généralement à le faire, et de nombreuses tentatives rapprochées peuvent verrouiller le compte ou déclencher une protection côté fournisseur. Arrêtez-vous après un petit nombre de tentatives défini par votre propre politique, marquez la route comme échouée avec une catégorie d’authentification et confiez-la au responsable qui peut renouveler ou faire tourner l’identifiant. N’essayez pas d’autres identifiants qui n’ont pas été attribués à la route dans l’espoir d’en trouver un qui fonctionne.
Comment écrire les identifiants dans une URL de proxy
Une URL de proxy suit la syntaxe générique de RFC 3986. Les identifiants se placent dans le composant userinfo, avant l’hôte : le schéma, puis le nom d’utilisateur, deux-points, le mot de passe, une arobase, l’hôte et le port. La même RFC qualifie de déconseillée la forme utilisateur et mot de passe dans userinfo, parce que transmettre des informations d’authentification en clair s’est avéré un risque de sécurité. C’est une raison de manipuler la chaîne avec soin, pas de l’écrire autrement, puisque de nombreuses interfaces de lancement attendent exactement cette forme.
Plusieurs caractères ont une signification dans une URL et doivent être encodés en pourcentage lorsqu’ils apparaissent dans un nom d’utilisateur ou un mot de passe. L’arobase termine le userinfo : une arobase littérale dans un mot de passe serait lue comme le début de l’hôte. La barre oblique, le point d’interrogation et le dièse terminent la partie autorité. Le signe pourcentage introduit une valeur encodée, donc un signe littéral doit lui-même être encodé. Les deux-points séparent le nom d’utilisateur du mot de passe. Encoder un caractère revient à le remplacer par un signe pourcentage suivi de son code hexadécimal à deux chiffres.
Par exemple, le mot de passe p@ss:word s’écrit p%40ss%3Aword dans l’URL, et la valeur complète pourrait ressembler à http://svc_user:p%40ss%3Aword@proxy.example.com:8080. L’hôte de cet exemple est un espace réservé de documentation. Encodez séparément le nom d’utilisateur et le mot de passe, puis seulement ensuite assemblez l’URL, car encoder l’URL terminée changerait aussi ses séparateurs. Une fonction éprouvée de la bibliothèque standard de votre langage est plus sûre que des remplacements écrits à la main, comme encodeURIComponent en JavaScript ou urllib.parse.quote avec un ensemble sûr vide en Python.
Les outils analysent le userinfo de façons légèrement différentes ; une valeur qui fonctionne dans un client peut donc échouer dans un autre. Après l’encodage, testez la chaîne exacte dans l’outil qui l’utilisera, et traitez une erreur d’analyse comme un problème de configuration. N’affaiblissez pas l’encodage pour faire passer une chaîne en échec. Un mot de passe qui contient un signe plus, une espace ou du texte non ASCII mérite son propre test, car les encodeurs ne s’accordent pas sur ces caractères ; dans une URL, l’espace s’écrit %20, et le signe plus relève de l’encodage des formulaires.
Un mauvais encodage produit un échec trompeur. Si une arobase non encodée coupe le userinfo au mauvais endroit, l’outil peut envoyer au proxy un mot de passe tronqué et recevoir un 407, ou tenter de résoudre un hôte inexistant et signaler une erreur réseau. Dans les deux cas, l’identifiant lui-même était correct. Quand un échec apparaît juste après un changement de mot de passe, comparez la chaîne encodée avant de soupçonner le fournisseur.
Lorsqu’un fournisseur prend en charge une autre méthode d’authentification, par exemple l’acceptation des requêtes issues d’une adresse source approuvée, vous pouvez peut-être lancer avec une URL sans userinfo. Cela retire le secret de la ligne de commande, mais déplace la confiance vers l’adresse et son responsable ; consignez donc cette méthode comme une méthode distincte, avec son propre responsable et sa propre revue. Certains fournisseurs ne la proposent pas, et ce sont les conditions du fournisseur qui décident si vous pouvez l’utiliser.
Gardez l’URL littérale hors des endroits durables. Les fichiers source, les images de conteneur, l’historique du shell et les commentaires de tickets conservent les valeurs longtemps après le changement d’un identifiant. C’est une référence au secret, et non la valeur, qui doit figurer à ces endroits.
Stocker, renouveler et masquer les identifiants
Stockez chaque identifiant de proxy dans un gestionnaire de secrets ou un espace équivalent que votre organisation contrôle déjà, et désignez-le par son nom. Un enregistrement de lancement contient alors une étiquette de route, par exemple « regional-checks-eu », et une référence au secret, comme le nom de l’entrée stockée, et non l’URL littérale du proxy. Toute personne qui lit l’enregistrement peut savoir quelle route a été utilisée et qui en est responsable, sans pouvoir l’utiliser.
Résolvez la référence le plus tard possible. Le lanceur récupère la valeur, encode le nom d’utilisateur et le mot de passe, construit l’URL, démarre le navigateur et ne conserve pas la valeur dans son propre état ni dans ses journaux. Construisez l’URL dans la portée la plus réduite possible et ne l’écrivez pas dans un fichier qui survit au lancement. Cela garde aussi la même définition de tâche valable après une rotation, puisque seule la valeur stockée change.
Soyez lucide sur ce qu’expose un argument de ligne de commande. Un argument de lancement est visible des autres comptes du même hôte qui peuvent lister les processus, et il peut être capturé par des agents de supervision, des rapports d’incident ou la sortie d’inspection d’un environnement de conteneurs. Intégrer l’identifiant dans l’argument ne le rend donc pas privé sur cet hôte. Limitez qui peut se connecter à la machine et lire les informations de ses processus, et préférez des identifiants limités à une route, restreints dans ce qu’ils permettent et de courte durée lorsque le fournisseur le permet.
Le masquage est un contrôle distinct, qu’il faut tester au lieu de le supposer. Les journaux de tâches, les scripts d’enrobage, les gestionnaires d’erreurs et les rapports de test impriment souvent les arguments de lancement en cas de problème. Masquez le userinfo avant l’écriture d’une ligne, remplacez le mot de passe par un marqueur fixe et masquez aussi la forme encodée, car un journal peut contenir l’une ou l’autre. Après un lancement en échec, lisez les fichiers de sortie réels et la liste des processus, et cherchez-y le nom d’utilisateur et le mot de passe, sous leur forme brute comme encodée.
La rotation exige un responsable et un plan. Décidez à quelle fréquence chaque identifiant est remplacé, qui peut le remplacer et comment la nouvelle valeur parvient au lanceur. Remplacez la valeur stockée, relancez les contextes qui utilisent cette route et confirmez que l’ancienne valeur ne fonctionne plus. Une rotation déclenchée par une fuite présumée demande aussi de vérifier où l’ancienne valeur a été écrite, car les journaux et les tickets peuvent la conserver après sa révocation par le fournisseur.
Donnez à chaque route son propre identifiant et sa propre référence. Lorsqu’un identifiant partagé sert plusieurs routes et contextes, une seule rotation interrompt ces routes en même temps et une seule fuite expose chacune d’elles. Des références séparées permettent de remplacer l’identifiant d’une route pendant que les autres continuent avec les leurs. Si le fournisseur rattache les identifiants à une offre ou à un sous-compte, reproduisez cette structure dans votre propre nomenclature.
Les faits côté fournisseur restent chez le fournisseur. La durée de conservation des journaux de requêtes, l’enregistrement ou non du nom d’utilisateur, la protection de la connexion au proxy par TLS et l’expiration des identifiants sont propres à chaque fournisseur. Demandez-les par écrit et consignez les réponses avec la route. Ne supposez pas qu’un schéma d’apparence sûre dans une URL signifie que le premier segment est chiffré : un proxy HTTPS protège la connexion vers le proxy, un proxy HTTP ne la protège pas, et une route SOCKS5 demande sa propre évaluation.
Gardez les connexions aux destinations hors de ce stockage. Le mot de passe d’un compte de destination appartient au titulaire du compte et à l’application qui se connecte, avec son propre stockage et sa propre rotation. Le placer à côté de l’identifiant du proxy élargit le cercle de ceux qui peuvent lire chacun d’eux et lie deux rotations sans rapport.
Revue opérationnelle
Traitez la gestion des identifiants comme une propriété que l’on vérifie après les changements, et non comme une étape de mise en place que l’on termine une fois pour toutes. Répétez la revue après un changement de fournisseur, un changement d’offre, une rotation d’identifiant, une mise à jour du lanceur, un changement de journalisation, une mise à jour majeure du navigateur ou l’ajout d’une nouvelle route. Consignez ce que vous avez vérifié, l’étiquette de route, la référence au secret et le résultat, sans copier de secret dans l’enregistrement.
Attribuez les rôles comme vous attribuez les routes. Le responsable de la route décide quel identifiant sert quel contexte et approuve les rotations. Le responsable de la plateforme contrôle le stockage des secrets et la chaîne de journalisation. Le responsable de l’application définit ce que voit l’utilisateur lorsqu’une route est indisponible. Un court passage de relais entre ces trois responsables constitue une preuve plus solide qu’un document partagé où les identifiants sont collés.
Définissez le résultat visible d’un échec d’authentification avant qu’il ne survienne. Une tâche peut s’arrêter avec un message clair indiquant que la route demande une intervention, une fonctionnalité peut afficher un état indisponible, ou une route alternative approuvée peut prendre le relais lorsque votre politique l’autorise. Une connexion directe qui charge la page par hasard n’est pas une alternative implicite. Elle modifie la frontière réseau et l’origine du trafic sans décision ; elle ne doit donc pas être le résultat silencieux d’un identifiant en échec.
BotBrowser prend en charge les identifiants de proxy intégrés dans l’URL de --proxy-server pour les routes HTTP, HTTPS, SOCKS5, SOCKS5H et QUIC, avec encodage en pourcentage des caractères spéciaux, de sorte qu’un opérateur peut fournir au lancement les identifiants d’une route approuvée sans page.authenticate(). BotBrowser ne peut pas fournir de stockage des secrets, de rotation ni de masquage dans les journaux, et il ne rend pas les identifiants intégrés privés face à la liste des processus ou aux journaux du fournisseur ; ces contrôles restent du ressort de votre outillage de déploiement et du fournisseur du proxy.
Le routage par contexte aide à garder les références séparées. Lorsqu’un même déploiement de navigateur sert plusieurs flux approuvés, chaque contexte peut utiliser sa propre route et donc son propre identifiant, comme le décrit Proxy par contexte. Ce réglage choisit parmi des routes que votre déploiement a déjà qualifiées ; il n’émet aucun identifiant et ne modifie pas ce que le fournisseur autorise.
Lorsqu’une route échoue à l’authentification, les actions responsables sont de renouveler ou de faire tourner l’identifiant par l’intermédiaire de son responsable, de choisir une autre route approuvée ou d’arrêter le flux. Chercher des identifiants ailleurs, emprunter ceux d’une autre équipe ou passer à un autre compte fournisseur sans approbation n’en font pas partie. L’enregistrement doit montrer quelle action a été menée et par qui.
Les messages d’état et les réponses du support doivent employer le même vocabulaire que l’enregistrement. « Authentification du proxy refusée » est plus précis et plus utile que « erreur réseau », et « connexion à la destination requise » indique qu’un autre responsable doit agir. Une formulation précise évite qu’un incident soit envoyé à la mauvaise équipe et garde les secrets hors des tickets que beaucoup de personnes peuvent lire.
Exécuter les vérifications d’hygiène des identifiants
Appliquez ces vérifications à chaque route et consignez un succès ou un échec pour chacune, sans copier de secret dans l’enregistrement.
- Suivez une requête en échec jusqu’à son segment. Succès si un 407 avec une demande Proxy-Authenticate est attribué au segment du proxy, si un 401 avec une demande WWW-Authenticate est attribué à la destination, et si ni la valeur de Proxy-Authorization ni celle d’Authorization n’apparaissent dans l’enregistrement. Échec si les deux sont fusionnés en une seule catégorie « connexion échouée ».
- Lisez l’enregistrement de lancement. Succès s’il montre une étiquette de route et une référence au secret. Échec s’il contient une URL de proxy littérale, un nom d’utilisateur ou un mot de passe.
- Recherchez le nom d’utilisateur et le mot de passe, sous forme brute et encodée en pourcentage, dans les journaux de tâches, la sortie d’erreurs et la liste des processus d’un lancement normal et d’un lancement volontairement en échec. Succès si les journaux et la sortie d’erreurs ne contiennent aucune correspondance et si la liste des processus n’en contient pas ou n’est lisible que par des comptes que vous avez approuvés. Échec si l’identifiant apparaît dans un journal, dans la sortie d’erreurs ou dans une liste de processus que d’autres comptes peuvent lire.
- Lancez avec un mot de passe de test contenant des caractères réservés, comme une arobase, des deux-points, une barre oblique et un signe pourcentage. Succès si le mot de passe est encodé en pourcentage dans l’URL et si la route s’authentifie. Échec si la connexion ne fonctionne qu’après un affaiblissement de l’encodage.
- Fournissez volontairement un identifiant erroné ou expiré. Succès si l’exécution s’arrête dans votre limite de tentatives et signale une erreur d’authentification pour la route nommée. Échec si elle signale un délai dépassé, une erreur DNS ou une panne réseau générique, ou si elle réessaie sans limite.
- Faites tourner l’identifiant d’une route. Succès si cette route s’authentifie avec la nouvelle valeur, si l’ancienne valeur est refusée et si les autres routes et contextes continuent de fonctionner avec leurs propres références. Échec si la rotation d’une route change le résultat d’une autre.
- Répétez les vérifications 1 à 6 après un changement de fournisseur, un changement d’offre, une mise à jour du lanceur ou une mise à jour majeure du navigateur. Conservez le dernier enregistrement accepté jusqu’à la réussite de la nouvelle exécution.
Sources
- RFC 9110 : HTTP Semantics
- RFC 7617 : The Basic HTTP Authentication Scheme
- RFC 1929 : Username/Password Authentication for SOCKS V5
- RFC 3986 : Uniform Resource Identifier (URI) Generic Syntax
- MDN : en-tête Proxy-Authorization
- MDN : 407 Proxy Authentication Required
- BotBrowser : configuration du proxy
Articles Connexes
Faites passer BotBrowser de la recherche à la production
Utilisez ces guides pour comprendre le modèle, puis passez à la validation multi-plateforme, aux contextes isolés et au déploiement navigateur prêt pour l'échelle.