Sémantique des proxys HTTP et requêtes du navigateur
Comprendre les proxys HTTP, les tunnels CONNECT, les en-têtes, les redirections et le DNS pour des configurations fiables.
BotBrowser Team
Vous voulez la documentation structurée pour Réseau ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
BotBrowser peut rejouer un parcours de requêtes autorisé avec un profil et une route proxy déclarés, mais il ne peut pas rendre un proxy transparent, prouver que chaque intermédiaire conserve les en-têtes ni certifier la conservation des journaux par des tiers. La réponse pratique consiste à observer chaque saut et à séparer les décisions de confidentialité, de cohérence et de protection.
Résumé
- Les requêtes HTTP transmises utilisent généralement la forme absolue ; HTTPS utilise généralement
CONNECT, puis un tunnel chiffré. - L'authentification du proxy (
407) et celle de l'origine (401) sont des défis distincts avec des en-têtes distincts. - DNS, redirections, service workers, WebRTC et caches peuvent créer des chemins qu'un test de la première page ne voit pas.
- Comparez séparément l'intention du navigateur, l'observation du proxy et celle de l'origine ; un rejeu BotBrowser ne prouve que la route et le fixture déclarés.
Sommaire
- Pourquoi la sémantique du proxy compte dans un navigateur
- Formes de requête et premier saut
- Tunnels CONNECT, TLS et résolution des noms
- En-têtes, authentification et politique de transfert
- Fonctions du navigateur qui créent des requêtes supplémentaires
- Méthode pratique de vérification
Pourquoi la sémantique du proxy compte dans un navigateur
Un proxy HTTP est plus qu'une adresse placée entre un navigateur et un site web. Il modifie la route, la forme de la requête et parfois l'endroit où un nom est résolu. Ces détails influencent l'authentification, les cookies, les redirections, les certificats TLS, le cache, les journaux et la source apparente d'une requête. Une configuration peut sembler correcte dans une commande de lancement tout en produisant un échange réseau différent de celui attendu par l'application. Pour voir comment le choix de la famille d'adresses influence la route du navigateur, consultez Sélection d'adresses IPv6 pour les applications web. Lorsqu’une requête échoue, la carte diagnostique du scraper bloqué distingue erreurs de route ou de confiance et refus HTTP reçu.
Les conseils présentés ici s'appuient sur les normes et sur le comportement observable, et non sur un fournisseur en particulier. Pour une référence pratique de configuration, consultez Configuration proxy du navigateur : guide SOCKS5, HTTP et HTTPS. Si votre déploiement utilise aussi WebRTC, Qu'est-ce qu'une fuite IP WebRTC ? décrit un chemin de trafic distinct que les paramètres de proxy HTTP ne contrôlent pas automatiquement.
Les idées clés sont les suivantes :
- Une requête envoyée à un proxy peut utiliser une URI absolue, alors qu'une requête envoyée à travers un tunnel utilise la forme origine.
CONNECTcrée un tunnel d'octets vers un hôte et un port. Après une réponse positive, le proxy transmet normalement les octets TLS chiffrés sans interpréter les messages HTTP qu'ils contiennent.- L'authentification du proxy et l'authentification de l'origine sont des défis distincts, avec des en-têtes différents.
- Un navigateur peut résoudre un nom d'hôte localement ou demander au proxy de le résoudre, selon le protocole et l'implémentation.
- Les redirections, les service workers, les caches et les protocoles non HTTP peuvent créer des requêtes faciles à manquer dans un test simple.
Les normes sont précises sur la syntaxe des messages, mais laissent volontairement une marge à la politique de déploiement. Un proxy peut restreindre les destinations, réécrire certains en-têtes ou enregistrer des métadonnées. Considérez-le comme un service réseau doté de son propre contrat, et non comme un câble transparent.
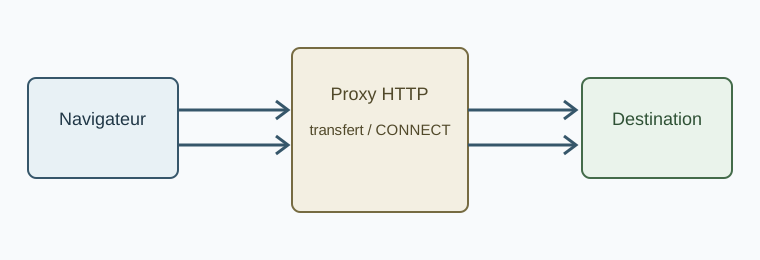
Formes de requête et premier saut
HTTP/1.1 définit quatre formes de cible de requête dans la RFC 9110, section 7.1 : la forme origine, la forme absolue, la forme autorité et la forme astérisque. Un navigateur qui utilise un proxy de transfert envoie couramment la forme absolue pour une requête HTTP ordinaire. Par exemple, au lieu d'envoyer GET /products HTTP/1.1, il peut envoyer :
GET http://shop.example/products HTTP/1.1
Host: shop.example
Accept: text/html
Le proxy utilise l'URI complète pour choisir le saut suivant. L'en-tête Host reste important, car il identifie l'autorité attendue par le serveur d'origine et il est obligatoire pour les requêtes HTTP/1.1. Dans une requête bien formée, l'autorité de l'URI et le champ Host concordent. Un proxy peut rejeter une discordance plutôt que de deviner la destination voulue par le client.
Lorsqu'un navigateur se connecte directement à une origine HTTP, il utilise normalement la forme origine. La première ligne ne contient que le chemin et la chaîne de requête :
GET /products?sort=price HTTP/1.1
Host: shop.example
Cette distinction est utile lors de la lecture d'une capture de paquets ou d'un journal d'accès du proxy. Voir une URI absolue dans la ligne de requête indique que le premier saut est un proxy de transfert, mais ne prouve pas que l'origine a reçu cette même forme. Le proxy convertit généralement la requête dans la forme attendue par le saut suivant.
La forme autorité est utilisée par CONNECT et se compose d'un hôte et d'un port, comme shop.example:443. La forme astérisque, OPTIONS *, s'adresse au serveur lui-même plutôt qu'à une ressource particulière. Les navigateurs la génèrent rarement lors du chargement ordinaire d'une page, mais un test de diagnostic ou de compatibilité peut le faire.
Les URL HTTP et HTTPS sont des cas différents
Pour une URL http://, un navigateur peut envoyer la requête HTTP à un proxy HTTP en HTTP lisible. Le proxy peut inspecter la méthode, le chemin, les en-têtes et le statut de la réponse. Le tronçon du proxy vers l'origine peut utiliser HTTP ou TLS selon sa politique de relais ; ce choix est indépendant du schéma envoyé par le navigateur.
Pour une URL https://, le navigateur demande généralement à un proxy HTTP d'ouvrir un tunnel :
CONNECT shop.example:443 HTTP/1.1
Host: shop.example:443
Le proxy renvoie un statut tel que 200 Connection Established. Le navigateur lance alors une négociation TLS à travers la connexion établie. La requête HTTP, les en-têtes de réponse et le corps de la réponse se trouvent à l'intérieur de TLS et ne sont pas visibles par un proxy de transfert classique. Le proxy voit tout de même l'autorité de destination, le minutage de la connexion, le volume d'octets et les métadonnées nécessaires à sa propre politique.
Le modèle du tunnel explique pourquoi une page HTTPS peut échouer avant même que la page ne se charge. Un proxy peut rejeter CONNECT, exiger une authentification, refuser le port ou ne pas réussir à résoudre la destination. Dans ces cas, il n'y a aucune réponse HTTP de l'origine à inspecter. Les outils de développement du navigateur peuvent afficher une erreur réseau plutôt qu'un code de statut normal, car l'échec s'est produit pendant l'établissement de la route. Pour comprendre comment le navigateur décide de faire confiance à la connexion elle-même, consultez Certificats TLS et confiance de la connexion du navigateur.
Considérations sur HTTP/2 et HTTP/3
La RFC 9112 décrit la messagerie HTTP/1.1, y compris les règles d'analyse qui protègent les limites des messages. Les navigateurs modernes peuvent utiliser HTTP/2 ou HTTP/3 vers une origine une fois le tunnel établi, selon la prise en charge du navigateur et du proxy. Les concepts de requête restent similaires, mais la représentation sur le réseau change : HTTP/2 utilise des trames binaires et des pseudo-en-têtes tels que :method et :authority, tandis que HTTP/3 s'exécute sur QUIC.
Ne déduisez pas le protocole utilisé entre chaque paire de participants à partir de la seule URL. Un protocole peut être utilisé entre le navigateur et le proxy, et un autre entre le proxy et l'origine. Un proxy qui accepte CONNECT en HTTP/1.1 peut transporter une session TLS HTTP/2 sous forme d'octets opaques. À l'inverse, un proxy qui comprend HTTP/2 peut représenter les requêtes de proxy avec CONNECT étendu. Lors du diagnostic d'un problème, consignez chaque saut séparément.
Tunnels CONNECT, TLS et résolution des noms
CONNECT est une méthode définie pour créer un tunnel vers une autorité cible. La cible n'est pas une URL arbitraire avec un chemin. Il s'agit normalement d'un hôte et d'un port, le plus souvent le port 443 pour HTTPS. Dès que le proxy envoie une réponse positive, il cesse de traiter des messages HTTP et transmet les données dans les deux sens jusqu'à la fermeture de la connexion.
Ce que le proxy peut voir
Dans un tunnel HTTPS normal, le proxy voit la requête qui lui est adressée, notamment l'hôte et le port cibles, ainsi que les métadonnées de connexion. Il ne peut pas lire le chemin HTTP chiffré, les cookies, les valeurs d'autorisation ni le corps de la réponse. Il peut néanmoins appliquer une politique selon la cible, limiter les ports, plafonner la durée de connexion ou fermer le tunnel ; comparez cette limite à la sémantique CONNECT de la RFC 9110.
La validation du certificat TLS s'effectue dans le navigateur pour un tunnel de bout en bout. Le navigateur vérifie le nom du certificat, sa période de validité et sa chaîne de confiance pour l'hôte d'origine. Le certificat du proxy n'intervient pas, sauf si le déploiement effectue volontairement une interception TLS. L'interception modifie le modèle de confiance et exige une autorité de certification de confiance dans le profil du navigateur. Elle doit être documentée et testée comme une architecture distincte.
La valeur SNI du navigateur et d'autres détails de la négociation TLS peuvent révéler l'hôte visé à un observateur du réseau, selon la version de TLS et les fonctions de confidentialité utilisées. Un proxy qui ne fait que transmettre des octets ne supprime pas ces signaux au niveau du protocole. La confidentialité du DNS, celle de TLS et le proxy HTTP sont des contrôles liés mais distincts.
Où se fait le DNS
La résolution des noms est une source fréquente de confusion. Avec un proxy HTTP, le navigateur peut envoyer le nom d'hôte dans l'URI absolue ou dans l'autorité de CONNECT et laisser le proxy le résoudre. Certaines implémentations résolvent d'abord localement, notamment pour appliquer des politiques locales ou choisir une famille d'adresses. Le comportement exact dépend du navigateur, du type de proxy et de la configuration.
Une résolution locale signifie que le résolveur local peut connaître la destination, même si la connexion TCP suivante passe par le proxy. Une résolution côté proxy garde cette recherche au niveau du proxy, mais ne garantit pas que chaque requête auxiliaire emprunte le même chemin. Les vérifications de révocation des certificats, les vérifications de portail captif, la prérésolution DNS, les connexions spéculatives et les extensions peuvent avoir un comportement réseau distinct.
Lorsque l'emplacement du DNS importe, testez davantage que la navigation depuis la barre d'adresse. Observez un profil à froid, un nouveau processus de navigateur, des redirections vers un nouveau nom d'hôte, une iframe, un worker et une résolution en échec. La présentation HTTP de MDN est une référence utile pour séparer la sémantique HTTP de l'ordonnancement réseau propre à chaque navigateur.
En-têtes, authentification et politique de transfert
Les en-têtes HTTP n'ont pas les mêmes destinataires dans un déploiement avec proxy. Certains décrivent la requête destinée à l'origine, d'autres décrivent la connexion avec le proxy, et d'autres encore sont ajoutés par des intermédiaires. La RFC 9110, section 5 définit les règles générales des champs et avertit que les intermédiaires doivent traiter avec soin les champs saut par saut.
L'authentification du proxy n'est pas celle de l'origine
Un proxy qui exige des identifiants répond par 407 Proxy Authentication Required et inclut Proxy-Authenticate. Le client répond avec Proxy-Authorization. Une origine qui exige des identifiants répond par 401 Unauthorized, utilise WWW-Authenticate et attend Authorization.
Ces défis peuvent survenir à des moments différents. Pour une URL HTTP, le défi du proxy peut arriver avant que le proxy ne transmette la requête. Pour une URL HTTPS, le défi se produit généralement en réponse à CONNECT, avant le début de TLS. Un navigateur peut relancer la connexion avec les identifiants, mais une bibliothèque d'automatisation peut présenter le défi comme un échec de navigation, sauf si les identifiants du proxy ont été configurés par l'API qu'elle prend en charge.
Ne placez pas les identifiants de l'origine dans un champ d'identifiants du proxy, ni les identifiants du proxy dans un en-tête Authorization destiné à un site web. Ils n'ont pas la même portée et sont souvent consignés par des systèmes différents. Utilisez un magasin d'identifiants ou le mécanisme de configuration de proxy documenté du navigateur plutôt que de construire des en-têtes dans le JavaScript de la page.
Champs d'identité transférés
Des en-têtes tels que Via, Forwarded et X-Forwarded-For sont couramment utilisés par les intermédiaires, mais leur présence relève d'un choix de politique. Un proxy peut les ajouter, les conserver ou les supprimer. Forwarded peut décrire l'adresse du client, le protocole et l'hôte lorsqu'une requête traverse des intermédiaires. Comme ces champs peuvent contenir des informations réseau sensibles, les applications ne doivent leur faire confiance que lorsqu'ils proviennent de sauts de proxy connus.
Le navigateur lui-même ne garantit pas qu'un proxy ajoutera un en-tête de transfert particulier. Si une application dépend de l'adresse d'origine du client, définissez explicitement le contrat entre le proxy et l'application. Si une application n'a pas besoin de cette adresse, évitez d'accepter des valeurs de transfert arbitraires provenant d'Internet public.
Champs saut par saut et champs de bout en bout
Certains champs décrivent une seule connexion et ne doivent pas être transmis tels quels à travers un proxy. Le champ Connection peut désigner des champs saut par saut en HTTP/1.1. Un proxy supprime ou consomme ces champs avant de transmettre la requête. Les champs de bout en bout, tels que Cache-Control, sont destinés à voyager jusqu'à l'origine et à revenir, sous réserve du comportement normal des intermédiaires.
Cela compte pour le débogage. Un en-tête visible dans les outils de développement du navigateur peut différer de celui reçu par l'origine. À l'inverse, un proxy peut ajouter un champ que la page n'a jamais généré. Capturez l'échange entre le navigateur et le proxy et examinez un journal côté origine lorsque cette distinction est importante.
Fonctions du navigateur qui créent des requêtes supplémentaires
Le chargement d'une page est une séquence, pas une requête unique. Le document principal peut déclencher des feuilles de style, des scripts, des images, des polices, des frames, des préchargements, des workers, des manifestes et des appels d'API. Chaque URL peut cibler une destination et un état de cache différents. Une politique de proxy qui fonctionne pour le document peut tout de même échouer sur un hôte de polices ou un domaine d'API.
Les redirections en sont un exemple courant. Une réponse 301, 302, 303, 307 ou 308 peut amener le navigateur à émettre une nouvelle requête vers une autre autorité. La gestion de la méthode et du corps diffère selon le code de statut et les règles du navigateur. La nouvelle requête utilise toujours le proxy configuré, mais elle peut nécessiter une seconde résolution DNS, une nouvelle décision d'authentification auprès du proxy et un nouveau tunnel TLS.
Les cookies traversent eux aussi les frontières entre requêtes. Une réponse Set-Cookie d'un hôte peut influencer les requêtes suivantes selon les règles de domaine, de chemin, de Secure et de SameSite. Un proxy peut voir les valeurs des cookies en HTTP simple, mais pas en HTTPS à l'intérieur d'un tunnel. Un journal de proxy qui n'enregistre que la première requête ne peut pas expliquer chaque changement d'état ultérieur.
Les service workers ajoutent une couche supplémentaire. Une fois installé, un service worker peut répondre à un fetch depuis son cache ou générer une requête par programme. L'absence d'entrée réseau ne prouve pas que le routage par le proxy a été contourné ; elle peut signifier qu'aucune requête réseau n'était nécessaire. À l'inverse, un service worker peut contacter un hôte d'API qui n'apparaît pas clairement dans la source du document.
Le trafic non HTTP demande son propre examen. Les négociations WebSocket commencent comme des requêtes HTTP, mais la connexion devient ensuite un flux bidirectionnel de longue durée. Les médias et canaux de données WebRTC utilisent ICE et peuvent contacter des serveurs STUN ou TURN en dehors du HTTP ordinaire de la page. La documentation de l'API WebRTC sur MDN explique pourquoi ces flux doivent être testés séparément. Un guide de proxy qui ne couvre que GET et CONNECT n'est pas un inventaire réseau complet.
Méthode pratique de vérification
Une validation fiable compare ce que le navigateur voulait faire, ce que le proxy a reçu et ce que l'origine a observé. La séquence suivante garde ces observations séparées.
1. Établir une référence
Commencez par une connexion directe dans un profil de navigateur propre. Chargez une URL HTTP et une URL HTTPS, notez l'URL finale après les redirections et le protocole négocié lorsque le navigateur l'expose. Enregistrez le statut de la réponse, une sélection d'en-têtes de requête et les informations de minutage. Ne réutilisez pas un cache chaud lorsque vous comparez des changements de proxy.
2. Tester la négociation du proxy
Utilisez un journal d'accès du proxy ou un point de terminaison de test contrôlé. Pour une URL HTTP, vérifiez si le proxy reçoit la forme absolue. Pour une URL HTTPS, vérifiez la présence d'une requête CONNECT avec l'autorité attendue et d'une réponse de tunnel positive. Un 407 signifie que l'authentification auprès du proxy est incomplète. Un refus de connexion ou un délai d'attente indique un problème de route ou de politique avant même que l'origine n'intervienne.
3. Vérifier la vue de l'origine
Faites enregistrer par la destination l'adresse source, Host, les champs de transfert, la version du protocole et le chemin de la requête. Comparez cet enregistrement avec le journal du proxy. L'origine doit voir l'adresse de sortie du proxy lorsque la route fonctionne comme prévu. Il ne faut pas s'attendre à ce qu'elle voie l'adresse locale du navigateur, sauf si un intermédiaire la transmet délibérément.
4. Parcourir le graphe des requêtes
Testez une page comportant une redirection, une image inter-origines, une police, une iframe, un worker et un appel fetch. Incluez un nom d'hôte inexistant et un hôte disposant d'enregistrements IPv4 et IPv6. Cela révèle si la résolution des noms, le choix de la famille d'adresses et l'authentification auprès du proxy se comportent de façon cohérente au-delà du premier document.
5. Répéter avec un état chaud
Exécutez la même navigation une fois que des cookies, un service worker et des entrées de cache existent. Comparez les requêtes réseau avec l'exécution à froid. Une requête absente peut indiquer un succès de cache, et non un changement de routage. Effacez l'état entre les expériences contrôlées et notez quel état a été utilisé.
Symptômes courants et leur signification
Si les pages HTTP se chargent mais que les pages HTTPS échouent, examinez l'autorisation de CONNECT, la politique des ports de destination et les erreurs de certificat TLS. Si le document se charge mais qu'un appel d'API échoue, examinez le nom d'hôte de l'API, la réponse CORS et la question de savoir si un service worker a traité l'appel. Si seuls certains domaines échouent, comparez leurs enregistrements DNS et les règles de liste d'autorisation du proxy. Si l'origine signale une adresse client inattendue, examinez le traitement de Forwarded et de X-Forwarded-For à chaque intermédiaire.
Évitez de considérer une seule page externe de type « quelle est mon IP » comme un test complet. Elle ne mesure généralement qu'un seul chemin HTTP et peut être mise en cache, redirigée ou servie par un CDN. Des vérifications fondées sur les normes, associées aux journaux des deux côtés, expliquent bien mieux le comportement du navigateur.
Choix de configuration pour des requêtes cohérentes
Utilisez un proxy HTTP lorsque vous avez besoin d'une interface classique de proxy de transfert et que le fournisseur prend en charge les destinations HTTP et HTTPS. Utilisez une configuration SOCKS lorsque le fournisseur ou l'application a besoin d'un relais TCP plus général, et vérifiez comment la résolution des noms d'hôte est choisie. Le guide de configuration du proxy documente les formes d'URL propres à chaque protocole et la gestion des identifiants dans BotBrowser.
Conservez une seule source de vérité pour les paramètres de proxy. Mélanger un proxy en ligne de commande, un objet proxy d'un framework d'automatisation et une interception de requêtes au niveau de la page peut produire des routes contradictoires. Configurez les identifiants via l'interface prise en charge du navigateur ou du framework, puis vérifiez le comportement résultant de 407 et de CONNECT à l'aide des journaux.
Alignez la sortie géographique du proxy sur les attentes de l'application lorsque la localisation influence le contenu, mais ne supposez pas qu'une adresse IP détermine tous les signaux du navigateur. Les paramètres régionaux, le fuseau horaire, la langue, le DNS, WebRTC et le choix de la famille d'adresses peuvent être indépendants. Pour le comportement propre à WebRTC, utilisez un test dédié fondé sur le guide des fuites d'IP WebRTC.
Enfin, documentez les limites du service de proxy. Consignez les protocoles qu'il accepte, les ports qu'il autorise, l'endroit où le DNS est résolu, la façon dont les identifiants sont renouvelés, les en-têtes qu'il ajoute et la durée de conservation des journaux. Ce contrat opérationnel transforme un vague « problème de proxy » en un chemin de requête testable.
La sémantique des proxys HTTP est prévisible lorsque chaque saut est identifié. Lisez la forme de la requête, distinguez 407 de 401, comprenez quand CONNECT crée un tunnel et testez le graphe complet des requêtes du navigateur. Ces habitudes facilitent le dépannage de l'automatisation de navigateur et de la navigation quotidienne, sans s'appuyer sur des hypothèses quant à ce que fait un proxy en coulisses.
BotBrowser prend en charge la configuration de routes proxy HTTP, HTTPS, SOCKS5 et SOCKS5H, avec des options de routage DNS. Cette configuration ne peut pas fusionner l'authentification du proxy et celle de l'origine, et ne détermine pas la façon dont le fournisseur achemine le trafic en amont.
Conclusion
L'étape suivante consiste à capturer à froid une requête HTTP et un CONNECT HTTPS, puis à comparer le journal du proxy avec celui de l'origine. Traitez les écarts comme des preuves propres à un saut, limitez les identifiants et les en-têtes transmis à leur destinataire et documentez ce que la route ne couvre pas. BotBrowser rend le fixture autorisé reproductible, mais ne remplace ni la politique du fournisseur, ni le réseau du navigateur, ni la revue de confidentialité en production.
Questions fréquentes
CONNECT dissimule-t-il la destination au proxy ?
Non. Le proxy voit l'autorité et les métadonnées de connexion ; les messages HTTP du tunnel sont chiffrés sauf interception TLS volontaire.
Un proxy garantit-il un DNS distant ?
Non. Le lieu de résolution dépend du navigateur, du type de proxy et de la configuration. Testez la route réelle et les requêtes auxiliaires.
Une navigation réussie prouve-t-elle que toutes les requêtes ont utilisé le proxy ?
Non. Redirections, caches, service workers, WebRTC et autres hôtes peuvent créer des chemins distincts. Vérifiez le graphe des requêtes et l'état du fixture.
Pour approfondir, consultez DNS sur TLS : confidentialité, déploiement et pannes.
Sources
Cet article fait partie du guide : Vue d’ensemble de la configuration proxy : carte des décisions réseau
Articles Connexes
Referrer-Policy pour une navigation cohérente et privée
RéseauBases de la compatibilité HTTP/3 et QUIC dans le navigateur
RéseauCertificats TLS et confiance de la connexion du navigateur
RéseauRoutage proxy QUIC pour HTTPS et HTTP/3
RéseauCohérence proxy, DNS et WebRTC pour le navigateur
RéseauEn-têtes Fetch Metadata : contexte CSRF et confidentialité
Exécutez la même vérification dans BotBrowser
Chargez un profil, gardez dans le navigateur les signaux que vous venez de lire, puis confirmez le résultat sur votre propre machine avant le déploiement.