DataView: orden de bytes, alineación y límites
Una sonda sobre búferes fijos: orden de bytes por defecto, lecturas no alineadas, errores de límites, precisión de flotantes, búferes compartidos y los captadores de BigInt.
BotBrowser Team
Quieres la documentación estructurada de Huella digital?
Este artículo forma parte de la biblioteca editorial. Para pasos de configuración, material de referencia y actualizaciones continuas, entra en la sección de docs.
BotBrowser permite reproducir una fixture autorizada del mismo origen bajo un perfil declarado y mantener un registro acotado de qué disposición binaria leyó una página y en qué orden de bytes, pero no puede cambiar el orden de bytes que usa un protocolo, no puede hacer que un arreglo tipado tolere un desplazamiento no alineado, y no puede recuperar un campo una vez que una lectura fuera de límites ha lanzado. Esta revisión ejecuta una sonda sobre nueve búferes fijos y registra el orden de bytes por defecto frente a uno explícito, que las lecturas no alineadas funcionan mientras una vista de arreglo tipado se niega, que una lectura fuera de límites lanza mientras un arreglo tipado descarta la escritura en silencio, qué precisión de flotante da cada ancho, cómo una vista y un arreglo tipado comparten un búfer, qué informa una vista con desplazamiento, cómo los bytes se vuelven texto, y qué añaden los captadores de BigInt.
Resumen
setUint32escribe el byte alto primero por defecto, por lo que0x01020304se guarda como01020304y se relee16909060en big-endian frente a67305985en little-endian.- Un
DataViewlee en cualquier desplazamiento, por lo quesetUint32(1, ...)funciona, mientras que unUint32Arrayen el desplazamiento uno lanza unRangeError. - Un
getUint32fuera de límites lanza unRangeError, mientras quetyped[10] = 7sobre un arreglo de cuatro bytes se descarta en silencio y la longitud sigue siendo cuatro. Float32no puede contener0.1exactamente y se relee0.10000000149011612, mientras queFloat64se relee0.1, así que el ancho que usa un campo es parte de su significado.- Un
DataViewy unUint8Arraysobre el mismo búfer ven las escrituras del otro, así que una escritura de byte cambia lo que lee la vista. - Una vista con desplazamiento informa su propio
byteLengthybyteOffsetmientrasbuffer.byteLengthsigue siendo la asignación completa, y una lectura uno más allá del final de la vista lanza. - Los bytes no son texto: los mismos cuatro bytes se decodifican como
hiéen UTF-8 yhiéen latin1. getBigUint64devuelve unBigInt, y sumarle unNumberlanza unTypeError.
Contenido
- Qué orden de bytes escribe DataView por defecto
- Dónde una vista es más permisiva que un arreglo tipado
- Qué cuesta cada ancho en precisión
- Qué informa una vista con desplazamiento y cómo se comparte el búfer
- Cómo los bytes se vuelven texto y dónde entra BigInt
- Registrar una lectura binaria
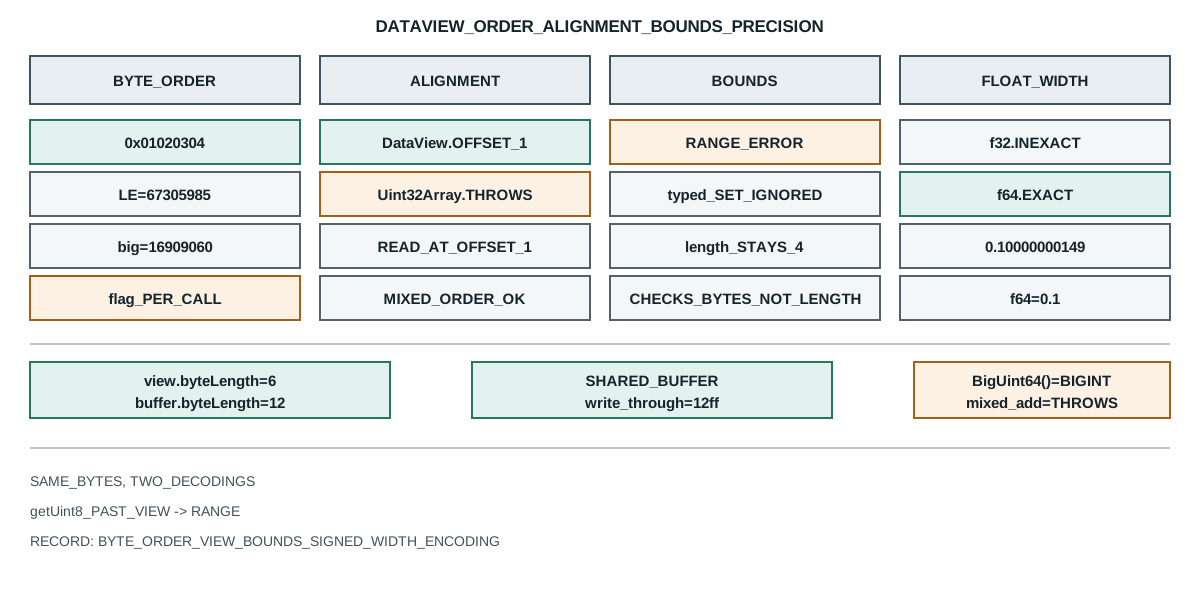
Qué orden de bytes escribe DataView por defecto
DataView elige el orden de bytes por llamada, y el valor por defecto es big-endian. La sonda escribe un entero y luego lo relee de ambas formas:
node=v26.9.0
default-bytes -> 01020304 readLE=67305985 readBE=16909060
unaligned-read -> deadbeef
typed-aligned-required -> RangeError
bounds -> dataview=RangeError typed-set-ignored=true length=4
float-precision -> f32=0.10000000149011612 f64=0.1 f32-exact=false
method-set -> Int8,Uint8,Int16,Uint16,Int32,Uint32,Float32,Float64,BigInt64,BigUint64
shared-buffer -> bytes=12340000 view=1234
write-through -> view-after-byte-write=12ff
offset-view -> byteLength=6 byteOffset=4 bufferByteLength=12
getUint8-at-view-end -> 0 end-throws=RangeError
decode -> utf8=hié latin1=hié bytes=4
bigint -> value=18446744073709551615 mixed-add=TypeError
Los cuatro bytes en el cable son 01 02 03 04 en orden de memoria, y la misma memoria se lee como dos números distintos según el indicador. 16909060 es 0x01020304, que es la lectura que coincide con la escritura, y 67305985 es 0x04030201, los mismos bytes leídos al revés. Así que la escritura puso el byte alto de 0x01020304 en el desplazamiento cero. Un lector que pasa true donde el escritor usó el valor por defecto ve el entero con los bytes invertidos, y el error es invisible en un volcado hexadecimal porque los bytes parecen correctos.
Esa asimetría es la razón por la que un campo de red siempre tiene su orden de bytes escrito en la especificación, mientras que un formato de archivo escrito por un proceso local suele heredar el orden del host. Una página que lee una cabecera sin pasar el segundo argumento obtiene el orden de la plataforma, que es little-endian en todo objetivo convencional actual y fallaría en silencio en uno big-endian. Pasar el indicador explícitamente es la única forma en que un registro puede declarar qué leyó.
Hay una consecuencia de segundo orden que sorprende a un lector que sí recuerda el indicador. El indicador es por llamada, no por vista, así que un solo DataView puede leer su primer campo en big-endian y el segundo en little-endian, y ambos son legales. Un formato binario con una cabecera big-endian heredada seguida de un cuerpo little-endian tiene exactamente esta forma, y un analizador que fija el orden una vez, en la construcción, no tiene forma de expresarlo. El indicador tiene que viajar con el campo, lo que significa que la tabla de campos en el analizador debe nombrar el orden junto con el ancho y la interpretación con o sin signo.
Los métodos de flotante aceptan el mismo indicador, y el fallo allí es aún más silencioso. Un Float32 escrito en big-endian y leído en little-endian no lanza ni produce un entero equivocado reconocible; produce un denormal pequeño o un valor enorme, y ambos parecen medidas plausibles hasta que la página los compara con un rango. Un lector que valida un flotante contra límites esperados detecta la colisión solo cuando los bits invertidos caen fuera del rango, y una página que confía en el valor a ciegas no tiene detección alguna.
Dónde una vista es más permisiva que un arreglo tipado
Un DataView no exige que su desplazamiento esté alineado al ancho que lee, mientras que una vista de arreglo tipado sí. La sonda escribe y lee un entero en el desplazamiento uno:
unaligned-read -> deadbeef
typed-aligned-required -> RangeError
El DataView leyó los cuatro bytes que empiezan en el desplazamiento uno y devolvió el valor que escribió. El Uint32Array sobre el mismo búfer en el mismo desplazamiento lanzó un RangeError, porque una vista de arreglo tipado exige que su byteOffset sea múltiplo del tamaño de su elemento. Esa es la diferencia estructural: un DataView es un cursor sobre bytes, y un arreglo tipado es una ventana que debe alinearse con su propia rejilla de elementos.
La semántica de los elementos del array tipado está en ArrayBuffer y vistas de array tipado. La elección entre ambos se deduce de eso. Un analizador que recorre una cabecera campo por campo con anchos mixtos y sin relleno usa un DataView. Una página que lee un bloque grande de un solo tipo, como un búfer de píxeles o un arreglo de muestras, usa un arreglo tipado y paga el requisito de alineación una vez. Una página que necesita ambos puede crear un DataView y varias vistas de arreglo tipado sobre el mismo búfer, una para cada propósito, porque todas comparten la memoria.
La regla de alineación tiene una consecuencia de rendimiento fácil de invertir. Una lectura alineada de arreglo tipado puede corresponder a una sola carga de máquina, mientras que una lectura de DataView tiene que ensamblar los bytes y puede ser más lenta en el mismo campo. Por eso una página que analiza un bucle caliente de un solo tipo de elemento usa un arreglo tipado incluso cuando el búfer no está alineado al inicio, avanzando hasta el primer desplazamiento alineado y saltando los bytes iniciales, y por eso una página que analiza una cabecera fría de anchos mixtos usa un DataView y acepta el costo por campo. Los dos no son intercambiables a la misma velocidad, y elegir uno por la razón del otro es una fuente común de un analizador lento que además es difícil de arreglar después.
Los límites se comportan de forma distinta en los dos, y la diferencia es la peligrosa. La sonda lee un entero más allá del final y escribe un byte más allá del final:
bounds -> dataview=RangeError typed-set-ignored=true length=4
La lectura del DataView lanzó un RangeError, que detiene un analizador en el campo exacto que no se pudo leer. La escritura del arreglo tipado en el índice diez sobre un arreglo de cuatro bytes no hizo nada en absoluto, y la longitud siguió en cuatro, así que una página que llena un búfer por índice y solo revisa la longitud después no puede distinguir una escritura descartada de una exitosa. En un camino de código que decodifica entrada no confiable, el comportamiento que lanza es el que falla ruidosamente y el silencioso es el que produce un resultado plausible pero equivocado.
Qué cuesta cada ancho en precisión
La vista expone diez tipos de elemento, y los dos anchos de flotante difieren en lo que pueden representar:
method-set -> Int8,Uint8,Int16,Uint16,Int32,Uint32,Float32,Float64,BigInt64,BigUint64
float-precision -> f32=0.10000000149011612 f64=0.1 f32-exact=false
A ambos anchos se les dio el mismo literal 0.1, y solo la lectura de sesenta y cuatro bits volvió como 0.1. La lectura de treinta y dos bits devolvió 0.10000000149011612, que es el valor más cercano que puede contener un flotante de treinta y dos bits. Una página que lee un campo como Float32, lo redondea para mostrarlo y lo compara con un 0.1 almacenado obtiene una discrepancia que no tiene nada que ver con los datos.
Los anchos enteros tienen el mismo problema en otra forma. Int8 y Uint8 difieren solo por encima de 127, donde la forma con signo se desborda a negativo, así que un byte que el emisor escribió como 200 se lee como -56 mediante getInt8. Una página que elige el captador con signo para un campo que la especificación declara sin signo obtiene un número negativo en un rango documentado como positivo, y el error solo aparece cuando un valor cruza el punto medio.
El caso de Float64 también muestra por qué una comparación de dos flotantes entre dos entornos de ejecución necesita cuidado. El valor 0.1 no es exactamente representable en binario en ningún ancho, y la lectura de sesenta y cuatro bits imprimió 0.1 solo porque la visualización lo redondeó. Un registro que almacena el valor mostrado en lugar de los bits crudos ha guardado un número redondeado, y dos entornos que coinciden en la visualización aún pueden contener bits distintos.
El mismo punto de precisión decide cómo se compara un resumen criptográfico o una suma de comprobación. Una página que lee una palabra de resumen de treinta y dos bits como Float32 y la compara con un literal almacenado está comparando valores redondeados, y dos resúmenes que difieren solo en los bits bajos pueden compararse como iguales tras el viaje de ida y vuelta. La solución es mantener un resumen binario en su ancho entero, usar getUint32 en lugar de un captador de flotante, y comparar los enteros directamente. Una suma de comprobación nunca es un flotante, y leerla como flotante es el error que hace que una verificación pase cuando debería fallar.
Cómo una vista y un arreglo tipado comparten un solo búfer
Un DataView contiene una referencia a un ArrayBuffer, no una copia, así que toda otra vista sobre ese búfer ve la misma memoria. La sonda escribe mediante el DataView y luego mediante el Uint8Array:
shared-buffer -> bytes=12340000 view=1234
write-through -> view-after-byte-write=12ff
La escritura big-endian de 0x1234 quedó como 12 34 00 00, que es lo que vio la vista de bytes. Escribir 0xff en el segundo byte cambió el entero que lee la vista a 0x12ff sin tocar el DataView en absoluto. Una página que toma una instantánea de una vista y espera que se mantenga frente a las escrituras de otra vista tiene un valor obsoleto; una página que depende de la compartición a propósito tiene una forma barata de reinterpretar la misma memoria.
Esa compartición es la razón por la que un DataView encaja bien en un analizador de protocolo que también quiere una suma de comprobación a nivel de bytes. El analizador lee campos mediante la vista, y un Uint8Array sobre el mismo búfer suma los bytes, y ninguno copia el búfer. El costo es que cualquier mutación es visible en todas partes, así que un analizador que escribe de vuelta en el búfer que está leyendo puede corromper una suma de comprobación calculada antes a menos que se fije el orden.
Qué informa una vista con desplazamiento y cómo se comparte el búfer
Se puede crear una vista sobre un segmento de un búfer, y esta informa el segmento en lugar de la asignación:
offset-view -> byteLength=6 byteOffset=4 bufferByteLength=12
getUint8-at-view-end -> 0 end-throws=RangeError
La vista cubre seis bytes que comienzan en el desplazamiento cuatro, y su buffer.byteLength sigue informando la asignación completa de doce bytes. Una página que calcula el desplazamiento de un campo a partir de buffer.byteLength en lugar de la propia byteLength de la vista lee más allá del segmento, y por eso importa la última línea: leer el índice seis, uno más allá de los propios seis bytes de la vista, lanza aunque el búfer subyacente tenga espacio. Los límites de la vista, no los del búfer, deciden qué puede tocar una lectura.
Esa distinción es la que hace tropezar a un subanalizador. Una función a la que se le pasa una vista sobre un segmento de carga de datos no puede leer el siguiente campo del marco externo, porque la vista termina donde termina el segmento, y el lanzamiento es la única señal de que el llamador pasó una vista más estrecha de lo que la función asumió. Un registro que guarda la longitud del búfer pero no el desplazamiento y la longitud de la vista no puede reconstruir qué lecturas fueron legales.
Cómo los bytes se vuelven texto y dónde entra BigInt
El lado de texto del mismo búfer tiene su propia frontera, que los límites de atob y btoa cubre para el caso base64. Los bytes no son texto hasta que se nombra una codificación, y los mismos cuatro bytes se decodifican de dos formas:
decode -> utf8=hié latin1=hié bytes=4
Los cuatro bytes son 68 69 c3 a9. Leídos como UTF-8 son h, i y la secuencia de dos bytes para é, dando hié. Leídos como latin1 cada byte es su propio carácter, dando hié. Una página que decodifica un campo con la etiqueta equivocada obtiene una cadena plausible en lugar de un error, así que un protocolo que no nombra su codificación deja al lector adivinar entre dos respuestas válidas.
Los campos más grandes necesitan sus propios captadores, y cambian el tipo de valor:
bigint -> value=18446744073709551615 mixed-add=TypeError
getBigUint64 devolvió el valor completo sin signo de sesenta y cuatro bits como un BigInt, que es la única forma de representarlo, porque un Number pierde precisión por encima de 2^53. La sonda luego le sumó 1 como un Number y obtuvo un TypeError, que es el lenguaje negándose a mezclar los dos tipos numéricos en silencio. Una página que lee un campo de sesenta y cuatro bits y quiere compararlo con un Number tiene que convertir a propósito, y la conversión es donde se pierde precisión si es que ocurre.
La forma con signo, getBigInt64, importa por la misma razón al otro lado del cero. Un contador de sesenta y cuatro bits que se desborda, o una marca de tiempo con signo de un protocolo que permite valores negativos, necesita el captador con signo, y leerlo sin signo convierte un pequeño negativo en un positivo enorme. Los dos captadores leen los mismos ocho bytes y difieren solo en cómo se interpreta el bit superior, así que una tabla de campos que registra "entero de sesenta y cuatro bits" sin la interpretación con o sin signo no ha registrado lo suficiente para reproducir el valor.
Hay un límite más que vale la pena nombrar. Un BigInt no se puede pasar al serializador JSON, así que una página que lee un campo de sesenta y cuatro bits e intenta registrar el objeto analizado lanza en el campo que es un BigInt mientras todos los demás campos se registran bien. El camino del registro tiene que convertir a propósito, normalmente a una cadena decimal, y una página que omite la conversión pierde toda la línea de registro en lugar del único campo. Esa es la misma forma que la vista con desplazamiento: el fallo es ruidoso en el límite exacto, y el registro tiene que nombrar el tipo para explicarlo.
Registrar una lectura binaria
Una lectura binaria respalda una afirmación estrecha: este entorno de ejecución, este búfer, este desplazamiento y este orden de bytes produjeron este valor. Cinco campos la mantienen verificable:
- El orden de bytes con que se leyó cada campo, porque el valor por defecto es big-endian y un campo de un archivo little-endian se lee con los bytes invertidos.
- El desplazamiento y la longitud de la vista, no solo el búfer, porque una lectura más allá del final de la vista lanza aun cuando el búfer tenga espacio.
- La interpretación con o sin signo y el ancho de cada campo entero, porque una lectura con signo de un byte sin signo convierte
200en-56. - El ancho del flotante, porque
Float32yFloat64no coinciden en el valor que devuelven para el mismo literal. - La codificación de texto, porque los mismos bytes son
hiéen UTF-8 yhiéen latin1.
Fuentes públicas
- MDN: DataView
- MDN: DataView.prototype.getUint32
- MDN: DataView.prototype.getBigUint64
- MDN: ArrayBuffer
- ECMAScript: objetos DataView
- BotBrowser: referencia de consistencia de automatización
Conclusión práctica
Pasa el indicador de orden de bytes en cada lectura y escritura, porque el valor por defecto es big-endian y un campo de un archivo little-endian local no lo es. Usa un DataView para una cabecera de anchos mixtos y un arreglo tipado para un bloque homogéneo, y recuerda que los límites de la propia vista deciden qué puede tocar una lectura. Nombra la interpretación con o sin signo, el ancho y la codificación de texto para cada campo, y trata una lectura de BigInt64 como un tipo separado en lugar de un Number grande. Para la vista de elementos en sí, lee Vistas de ArrayBuffer y arreglos tipados; para convertir bytes en cadenas, lee límites de atob y btoa.
Este artículo forma parte de la guía: ¿Qué es la huella digital del navegador?
Artículos Relacionados
ArrayBuffer y TypedArray: un búfer, muchas vistas
Huella digitalTextDecoder y TextEncoder: bytes frente a cadenas
Huella digitalICU: alias de zona horaria y la TZ que informas
Huella digitalObservabilidad de aleatoriedad criptográfica y huellas del navegador
Huella digitalOrden de array y comparadores: una función fácil de errar
Huella digitalbtoa y atob: límites Latin-1 y la verdad sobre el relleno
Lleva BotBrowser de la investigación a producción
Usa estas guías para entender el modelo y después avanzar hacia validación multiplataforma, contextos aislados y despliegue de navegador preparado para escalar.