Intl.Collator: el orden local no es el de código
Una sonda sobre listas fijas: cómo la comparación local difiere de la ordenación por unidades de código y cómo numeric, sensitivity, caseFirst y la puntuación cambian el resultado.
BotBrowser Team
Quieres la documentación estructurada de Huella digital?
Este artículo forma parte de la biblioteca editorial. Para pasos de configuración, material de referencia y actualizaciones continuas, entra en la sección de docs.
BotBrowser admite reproducir un fixture autorizado del mismo origen bajo un perfil declarado y conservar un registro acotado de qué ordenó una página y en qué local, pero no puede cambiar los datos de collation que aporta un runtime, no puede hacer que dos locales coincidan en un mismo orden y no puede recuperar la collation que usó una comparación después del hecho. Esta revisión ejecuta una sola sonda sobre diez listas fijas y registra cómo una comparación local difiere de una ordenación simple por unidades de código, cómo numeric, sensitivity, caseFirst e ignorePunctuation cambian cada uno el resultado, qué reporta realmente resolvedOptions(), a qué recurre un local no admitido y por qué pasar el collator en lugar de su función compare lanza una excepción.
TL;DR
- Una ordenación por unidades de código deja
Áppleal final, mientras que una ordenación local la deja en tercer lugar, así que los dos órdenes no coinciden en las mismas cinco palabras. - El local cambia el orden del mismo par: el sueco compara
ädespués dez, el alemán y el inglés lo comparan antes, así que la sonda imprimepair-sv -> z,äypair-de -> ä,z. numeric: trueordenaitem2antes deitem10, mientras que el valor por defecto los trata como texto y colocaitem10antes deitem2.sensitivitydecide qué diferencias cuentan:basetrataa,Ayácomo iguales,accentsepara la forma acentuada ycasesepara la mayúscula.ignorePunctuation: truehace queabya-bcomparen iguales, mientras que el valor por defecto los compara separados.caseFirstsolo aparece cuando el caso importa, y cambiaAaBbaaAbB.resolvedOptions()reporta la collation que concedió el runtime, incluida una collation nombrada en la etiqueta de local, y un local no admitido recurre aen-USen lugar de lanzar una excepción.Array.prototype.sort(collator)lanza unTypeError; solo funcionasort(collator.compare).
Contenido
- Qué compara un collator que una ordenación por unidades de código no
- Cómo numeric y sensitivity cambian el resultado
- Dónde entran el caso, la puntuación, la equivalencia y el casing local en el orden
- Dónde la equivalencia canónica y el casing local sorprenden a una ordenación
- Qué reporta resolvedOptions y a qué se recurre por defecto
- Por qué el collator no puede pasarse directamente a sort
- Registrar una lectura de collation
Qué compara un collator que una ordenación por unidades de código no
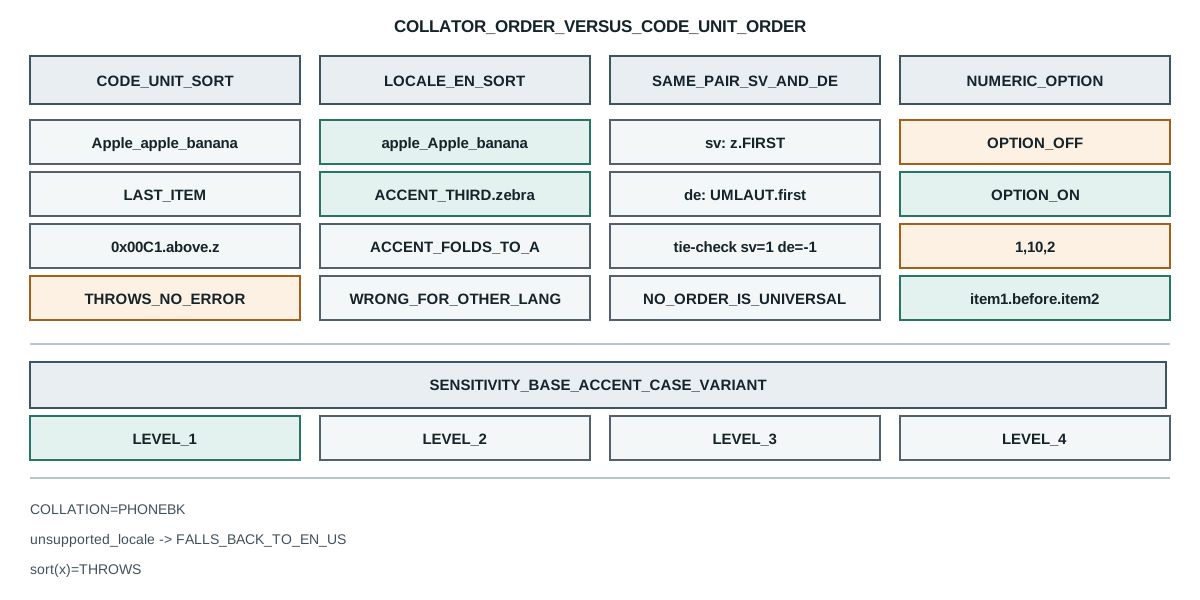
Un Array.prototype.sort() por defecto compara unidades de código UTF-16. Un collator compara el texto del modo en que lo ordena un idioma: los acentos se pliegan en su letra base, el caso es una diferencia secundaria y cada local decide dónde se ubica una letra. La sonda ordena las mismas cinco palabras de ambas formas:
node=v26.9.0
icu=78.3 unicode=17.0
code-unit -> Apple,apple,banana,zebra,Ápple
locale-en -> apple,Apple,Ápple,banana,zebra
pair-sv -> z,ä
pair-de -> ä,z
pair-en -> ä,z
numeric-off -> item1,item10,item2
numeric-on -> item1,item2,item10
sensitivity-base -> a-vs-A=0 a-vs-á=0 a-vs-b=-1
sensitivity-accent -> a-vs-A=0 a-vs-á=-1 a-vs-b=-1
sensitivity-case -> a-vs-A=-1 a-vs-á=0 a-vs-b=-1
sensitivity-variant -> a-vs-A=-1 a-vs-á=-1 a-vs-b=-1
punct-kept -> 1
punct-ignored -> 0
caseFirst-upper -> AaBb
caseFirst-lower -> aAbB
caseFirst-upper-base -> Aa vs aA
resolved -> locale=de-u-co-phonebk numeric=true sensitivity=accent collation=phonebk
fallback-locale -> en-US
passthrough -> sort(collator)=TypeError sort(collator.compare)=ab
tie-check -> sv(ä vs z)=1 de(ä vs z)=-1
La diferencia con una ordenación simple es la misma que Orden de array y comparadores traza para el propio comparador. Las dos primeras líneas son el punto entero en miniatura. Ápple tiene una unidad de código superior a z, así que la ordenación por unidades de código la empuja al final; un idioma ve Á como una A con acento, así que la ordenación local la coloca con las otras palabras con a. Ningún orden está mal, y una página que compara una lista entre dos runtimes sin nombrar el segundo ha registrado un resultado que depende de qué ordenación usó.
El segundo par es el caso más difícil. ä no es en el sueco meramente una a acentuada; es su propia letra y se ordena después de z. El alemán la mantiene cerca de a. La sonda imprime los dos órdenes lado a lado, y una página que fija a mano cualquiera de los dos como "el" orden se rompe en el otro idioma. La línea tie-check muestra lo mismo como resultado de comparación en lugar de como lista ordenada: el mismo par devuelve 1 en sueco y -1 en alemán.
Cómo numeric y sensitivity cambian el resultado
numeric: true cambia una secuencia de dígitos de una comparación de texto a una numérica, y la sonda muestra la diferencia en tres entradas de la lista:
numeric-off -> item1,item10,item2
numeric-on -> item1,item2,item10
El valor por defecto lee item10 como los caracteres "1", "0", así que aparece antes de item2 como "2". Con numeric, el runtime lee la secuencia de dígitos como el número diez, así que item2 aparece primero. Una página que ordena nombres de archivo o filas de una tabla con un collator por defecto y espera el orden natural obtiene la primera línea, no la segunda.
sensitivity decide qué diferencias reporta la comparación, y la sonda compara tres pares bajo cada uno de los cuatro niveles:
sensitivity-base -> a-vs-A=0 a-vs-á=0 a-vs-b=-1
sensitivity-accent -> a-vs-A=0 a-vs-á=-1 a-vs-b=-1
sensitivity-case -> a-vs-A=-1 a-vs-á=0 a-vs-b=-1
sensitivity-variant -> a-vs-A=-1 a-vs-á=-1 a-vs-b=-1
base reporta 0 tanto para el par de caso como para el par de acento, así que a, A y á son todos iguales y solo b se ordena aparte. accent empieza a separar la forma acentuada pero todavía trata a y A como iguales. case hace lo contrario: separa la mayúscula y vuelve a plegar el acento. variant separa todo. Una tabla de búsqueda indexada por una cadena en minúsculas y sin acentos hace a mano lo que sensitivity: 'base' hace en una sola opción, y una tabla que quiere que A y a coincidan pero que á se ordene aparte quiere accent.
La distinción importa para una cuestión de fingerprinting tanto como para una ordenación. Una página que agrupa cadenas por sensitivity: 'base' y una página que agrupa por variant producen recuentos de grupos distintos a partir de la misma entrada, así que una lectura de "número de valores distintos" tiene que nombrar la sensitivity o no es comparable entre dos páginas.
Hay una trampa de segundo orden en la misma tabla. sensitivity: 'base' reporta 0 para a frente a á, y una página que trata ese 0 como "estas cadenas son el mismo valor" fusionará dos entradas que un usuario considera distintas. Las comparaciones reportan un orden, no una igualdad: 0 significa que el collator no tiene opinión sobre cuál va primero, y un Map indexado por las cadenas originales todavía conserva ambas. Una deduplicación tiene que decidir por separado si un empate significa "conservar la primera", "conservar ambas" o "fusionar", y el collator no responde esa pregunta.
Los cuatro niveles además anidan en un orden fijo, y conocer el orden predice cada fila. base ignora acentos y caso; accent añade la distinción de acento; case en cambio añade la distinción de caso y mantiene el acento plegado; variant añade ambas. Por eso accent y case discrepan en pares distintos en lugar de que uno sea una versión más estricta del otro, y por eso una página que quiere "la misma palabra, cualquier caso, cualquier acento" quiere base en lugar de una cadena de normalizaciones manuales.
Dónde entran el caso, la puntuación, la equivalencia y el casing local en el orden
ignorePunctuation hace que el collator omita la puntuación cuando compara, y la sonda muestra el efecto en un par:
punct-kept -> 1
punct-ignored -> 0
ab y a-b difieren cuando la puntuación cuenta, y son iguales cuando no. Una página que ordena una lista de nombres con guiones y espera que ab y a-b sigan separados depende del valor por defecto, y una página que deduplica con un collator con la puntuación ignorada los fusionará. La opción es una decisión de política, no un detalle.
La misma opción cambia lo que un cuadro de búsqueda considera una coincidencia. Un filtro que pasa la consulta a minúsculas y compara con un collator por defecto mantiene a-b y ab separados, así que escribir ab no encuentra nada en una lista que solo contiene a-b. Desactivar la puntuación hace que la consulta coincida, y desactivarla también hace que a.b y a-b coincidan entre sí, que suele ser lo que un lector espera de un campo de búsqueda y rara vez lo que un filtro de coincidencia exacta quiere. Una opción, dos productos, valores por defecto opuestos.
caseFirst fija qué caso va primero una vez que el caso es una diferencia, y la sonda muestra tanto el efecto como su límite:
caseFirst-upper -> AaBb
caseFirst-lower -> aAbB
caseFirst-upper-base -> Aa vs aA
Con la sensitivity por defecto, upper coloca la mayúscula antes de la minúscula en cada par y lower lo invierte. La tercera línea es el límite: bajo sensitivity: 'base' los dos casos son iguales, así que caseFirst no tiene qué ordenar, y el resultado impreso es simplemente el orden de entrada en cada caso. Una opción que no tiene efecto salvo que otra opción esté activada se lee fácilmente como rota, y la sonda es la forma más barata de ver que no lo está.
Esa dependencia merece enunciarse como regla: caseFirst es un desempate dentro de una comparación que ya distingue el caso, y no hace nada por encima de ese nivel. Una página que fija caseFirst: 'upper' y sensitivity: 'base' y espera las mayúsculas primero ha fijado dos opciones que se cancelan, y la corrección es quitar la anulación de sensitivity en lugar de añadir una comparación manual. La última línea de la sonda muestra ambos órdenes de entrada sobreviviendo intactos, que es la forma visible de la cancelación.
Dónde la equivalencia canónica y el casing local sorprenden a una ordenación
Dos de los comportamientos más confusos no tienen que ver con las banderas de opción en absoluto; vienen de cómo el collator trata el texto que parece igual y el texto cuyo caso depende de un idioma. Una segunda sonda registra ambos.
El primero es la equivalencia canónica. La letra é puede almacenarse como un solo punto de código o como e seguida de un acento combinado, y las dos cadenas no son iguales:
normalization-text -> nfc.length=1 nfd.length=2 equal=false
normalization-collate -> base=0 variant=0
Las longitudes difieren y una comparación de cadenas dice que son distintas, pero el collator reporta 0 tanto en base como incluso en sensitivity variant, porque las dos grafías son canónicamente equivalentes y los datos de collation las pliegan juntas. Una página que compara con un collator, por tanto, trata dos cadenas con bytes distintos como la misma palabra, mientras que una página que compara con === o un Map no. Esa división es la fuente más común de "ordena bien pero la búsqueda falla": la ordenación usó el collator, la búsqueda usó la cadena cruda.
El primero es también la razón por la que una comparación por colación y una comparación de texto discrepan, algo que Normalización Unicode cubre desde el lado de la cadena. El segundo es el casing local. En turco, I pasa a minúscula como una ı sin punto, y i pasa a mayúscula como una İ con punto, que es una letra distinta de la I inglesa:
dotted-i-tr -> i-vs-I=1 i-vs-İ=-1
dotted-i-en -> i-vs-I=-1 i-vs-İ=-1
turkish-lower -> tr=ı en=i
Bajo el turco el collator coloca i después de I y antes de İ, así que i e I ya no son la misma letra ni en caso ni en orden; bajo el inglés coloca i antes de ambas. La última línea muestra la misma división a nivel de cadena: 'I'.toLocaleLowerCase('tr') es ı mientras que la llamada inglesa devuelve i. Una página que pasa a minúsculas sin local y luego compara obtiene el orden inglés en ambos locales, por lo que una comparación consciente del local y un plegado de caso consciente del local tienen que elegirse juntos en lugar de uno a la vez.
Hay una tercera forma que merece registrarse porque rompe la suposición de que una ordenación por unidades de código es "suficientemente cercana". Los caracteres astrales, que ocupan dos unidades de código, se ordenan por su primera unidad de código bajo una ordenación simple y por su peso de collation bajo un collator:
astral-codeunit -> 61,7a,1f600
astral-collator -> 1f600,61,7a
La ordenación simple pone el emoji al final porque su unidad inicial es superior a z; el collator lo pone primero porque su peso de collation viene antes que las letras. Una página que mezcla caracteres astrales en una lista de nombres y ordena por defecto obtiene un orden que ningún lector espera, y la corrección es el collator, no una reordenación manual.
Por último, el prólogo de todo esto es que localeCompare y un collator coinciden, que es la forma más barata de confirmar una hipótesis antes de construir un collator:
localeCompare-vs-collator -> ä-z:-1/-1 a-b:-1/-1
hoisted-vs-per-call -> same=true order=Alpha,bravo,charlie,delta
La primera línea muestra que 'ä'.localeCompare('z', 'de') y un collator alemán devuelven el mismo -1, así que una sonda puede empezar con la línea única y solo recurrir a un collator cuando necesita opciones. La segunda línea muestra que un collator elevado fuera del bucle y uno construido por comparación producen el mismo orden, lo que confirma la afirmación anterior de que elevarlo cambia el costo y no el resultado.
Qué reporta resolvedOptions y a qué se recurre por defecto
resolvedOptions() devuelve lo que el runtime concedió realmente, una vez aplicados tanto la etiqueta de local como las opciones:
resolved -> locale=de-u-co-phonebk numeric=true sensitivity=accent collation=phonebk
Se pidió al collator de-u-co-phonebk con dos opciones, y el local resuelto conserva la extensión -u-co-phonebk y reporta collation=phonebk por separado. Esa división importa porque una página puede leer cualquiera de los dos campos y obtener una cadena distinta, y un registro que solo guarda locale y descarta collation ha perdido la parte que decidió el orden. La collation de guía telefónica ordena ä con ae en alemán, que es un tercer orden a su vez, distinto tanto del alemán simple como del sueco que imprimió la sección anterior.
Un local no admitido no lanza una excepción. La sonda pide zz-ZZ:
fallback-locale -> en-US
El runtime recurrió a en-US y lo dijo. Una página que lee el local de un encabezado o de un parámetro de consulta y lo pasa directamente a un collator, por tanto, siempre obtiene un collator, y solo resolvedOptions().locale revela que la solicitud no se respetó. Un registro que guarda el local solicitado en lugar del resuelto ha registrado una intención, no una medición.
Por qué el collator no puede pasarse directamente a sort
Un collator es un objeto con un método compare, y Array.prototype.sort() acepta una función, no un objeto con un método compatible. La sonda pasa el collator mismo:
passthrough -> sort(collator)=TypeError sort(collator.compare)=ab
La primera mitad lanza un TypeError porque el argumento no es invocable; la segunda mitad ordena correctamente porque collator.compare es una función ligada. Eso es un error de una palabra en una revisión de código y una excepción en tiempo de ejecución en producción, y vale la pena nombrarlo porque el mensaje de sort no menciona collators en absoluto.
La misma forma explica un error más sutil. Un collator creado una vez y reutilizado es más que una fábrica de compare; guarda el local y las opciones, y su compare está ligado a ellas. Una página que crea un nuevo collator por comparación dentro de un callback de ordenación reconstruye el estado de ICU miles de veces, lo cual es correcto y lento, y una página que eleva un collator fuera del bucle obtiene el mismo orden más rápido. La sonda no puede mostrar la diferencia de tiempo en una lista de cinco elementos, y el orden es idéntico en ambos casos, así que la elección es puramente de costo.
Registrar una lectura de collation
Una lectura de collation respalda una afirmación acotada: este runtime, esta versión de ICU, este local y estas opciones produjeron estos órdenes. Cinco campos la mantienen comprobable:
- El runtime y su versión de ICU, porque la sonda imprime
icu=78.3 unicode=17.0y un ICU distinto aporta datos de collation distintos. - El local solicitado y el local resuelto, porque una etiqueta no admitida recurre en silencio.
- La collation resuelta, porque una extensión
-u-co-cambia el orden y se reporta por separado del local. - Las cuatro opciones que cambian el resultado,
numeric,sensitivity,caseFirsteignorePunctuation, porque dos collators con el mismo local y opciones distintas discrepan. - La comparación usada,
sort()ocollator.compare, porque pasar el objeto lanza una excepción.
Fuentes públicas
- MDN: Intl.Collator
- MDN: Intl.Collator.prototype.compare
- MDN: Intl.Collator.prototype.resolvedOptions
- ECMA-402: Collator Objects
- Unicode TR35: Collation
- BotBrowser: automation consistency reference
Conclusión práctica
Nombra el collator siempre que un orden salga de una página: el local, la collation resuelta y las cuatro opciones, porque cada una de ellas cambia el resultado con la misma entrada. Prefiere sensitivity al plegado manual de caso y acentos, y trata ignorePunctuation como una decisión de política en lugar de un detalle. Pasa collator.compare a sort, nunca el collator, y eleva un collator fuera del bucle. Para la comparación numérica que una ordenación por defecto hace mal, lee Ordenación de arrays y comparadores; para los datos de local detrás del orden, lee Datos de local de la API Intl.
Este artículo forma parte de la guía: ¿Qué es la huella digital del navegador?
Artículos Relacionados
Unicode: cuatro identidades de texto que lee una página
Huella digitalOrden de array y comparadores: una función fácil de errar
Huella digitalICU: alias de zona horaria y la TZ que informas
Huella digitalOrden de claves: enteros ordenan, cadenas se quedan
Huella digitalCombinadores Promise: qué falla y qué nunca se asienta
Huella digitalAnálisis de URL y search params: qué cambia el viaje
Lleva BotBrowser de la investigación a producción
Usa estas guías para entender el modelo y después avanzar hacia validación multiplataforma, contextos aislados y despliegue de navegador preparado para escalar.