原生函数被改写与 toString 白名单能看见什么
一支探针看被改写的 API:toString 白名单能抓到哪些改写、哪些描述符仍会露馅,以及为什么 Proxy 包装和 bind 出来的函数能当作原生通过。
BotBrowser Team
BotBrowser 支持在已声明 profile 下回放授权的同源夹具,并保存一份有界的记录,说明页面读过哪些 API,但它不能在 JavaScript 层改写面前让改写检测器看不到,不能让 Proxy 包装打印被包函数的源码,也不能改变 Function.prototype.toString 对引擎仍视作原生的函数所报告的内容。本评测复现一个开源指纹库所使用的检查集,把它套在十个固定用例上,记录白名单抓到哪些改写、哪些描述符仍会暴露改写,以及两种包装虽然被页面改了调用方拿到的值却仍然全绿。
摘要
- 未被动过的原生函数通过全部检查,所以探针打印
control:Math.random -> clean,Array.prototype.map与Function.prototype.toString也一样。 - 用一个普通函数替换
Math.random只留下一条标记:naive:replaced Math.random -> failed toString,因为源码文本已经不是原生那种形状。 - 给那个函数加一个假
toString并不能修好:探针打印failed toString | failed toString toString | extra own keys: toString,改写现在从一处露馅变成三处。 - 一个返回
0.42的函数,在检测器通过绑定引用调用真正的toString时仍会显示自己的函数体,所以clone:fnToString-call打印的是页面自己的源码,克隆用例照样被标记。 - 一个拦截
apply的Proxy通过整套检查,所以proxy:Math.random -> clean,尽管页面拿到的值是陷阱返回的。 - 绑定函数同样通过,因为探针打印
bind:fnToString -> function () { [native code] }和bind:checks -> clean。 - 干净原生和被改写的函数在便宜那条路上只差一条标记,所以
separation -> cleanFlags=0 patchedFlags=1就是这套检测全部的安全余量。 - 宿主自己也能产生一条不是页面改写的标记:探针打印
getter:checks -> failed toString hostShape=true,那个原生 getter 的源码是内部实现体。
目录
白名单接受哪些形状
指纹领域里最便宜的完整性检查,是读取每个 API 函数的源码文本,再拿它去比一组固定的、引擎可能产出的形状。一个开源指纹库就在它的改写检测模块里公开了这份列表,而这些形状短到可以照抄:
// 白名单接受的三种形状,NAME 代表该 API 自己的名字
`function ${name}() { [native code] }``function get ${name}() { [native code] }`;
('function () { [native code] }');
只读源码的检查看不到包装算出来的值,crypto-js 随机来源与库熵 记录了库函数被读输出而不是读代码时的同一个边界。这三种各还有一种断行写法:加换行、并在 [native code] 前放四个空格,某些引擎就这么打印。凡是落在这组之外的,都会以该 API 的名字记成一条改写,报告按所属的 API 把记录分组。
检查对函数跑真正的 Function.prototype.toString,然后再对值自己的 toString 跑一次。第二次调用才是关键:一个改了函数 toString 的页面,必须把替换物的 toString 也一并改掉,整条链都得对得上。只补外层的页面会被里层那次抓住。
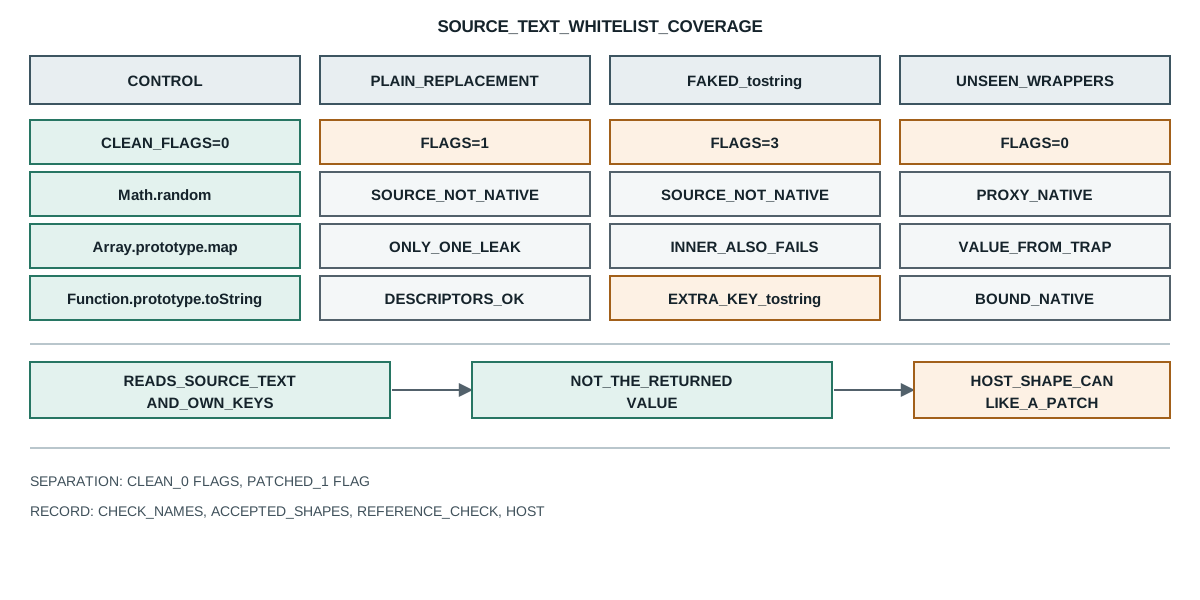
探针的对照用例确认白名单不会对未动过的原生函数误报。control:Math.random -> clean、control:Array.prototype.map -> clean、control:Function.prototype.toString -> clean 全部零标记。这对读结果很要紧:一个连对照都报的检测器毫无用处,所以这三行对照正是其余标记有意义的凭据。
对照也定下了白名单到底在测什么。它不测函数行为对不对,也不拿行为去比参考值。它对每个函数只读一个字符串,拿这个字符串比一组固定形状。一个改写后的函数即使返回值与原生完全一致,也照样通不过,因为源码文本不同;反过来,一个返回值完全不同的包装,只要它是引擎自己会打印的形状,就可能通过,最后一节正是讲这个。
一次普通改写留下什么
页面写下的第一个补丁往往最朴素:往属性上赋一个新函数。探针对 Math.random 就这么做,然后跑整套检查:
naive:replaced Math.random -> failed toString
separation -> cleanFlags=0 patchedFlags=1
一条标记,就是源码那条。替换物的源码是 function random() { return 0.42; },六种可接受形状一个都不匹配,于是被记下。其余检查全过,因为替换物就是个普通函数,有着惯常的 length、name,也没有多余键。整套检测就架在那一次字符串比较上,探针最后一行也直说了:干净原生零标记,改写一标记。
这「只差一条」的余量,对读报告的人有实际后果。一条写着 random: failed toString 的记录只说明一件很具体的事,就是源码文本不是引擎那副样子。它没说函数现在做什么、什么时候被改的、改动有没有改变任何值。一份只印「改写条数」的报告,恰好把是哪条检查触发藏了起来,而证据正在那一条检查里。
这份余量也让检查顺序对读者变得重要。假如源码检查是唯一一条,页面只要改掉函数的 toString 就能洗白,那就是下一个用例。可检测器还会读描述符集合和自有键,于是那个「补丁」让页面付出的标记比省下的更多。整套检查就是照着「最便宜的修法会让报告变大」设计的。
有一个合法情形会被这条简单源码检查读错,探针在宿主自身里就撞上了,而不是在页面里。有一行读一个原生 getter,打印 getter:checks -> failed toString hostShape=true,因为该访问器的源码是带私有字段的实现体,而不是浏览器那种 get native() { [native code] }。这条标记描述的是探针所在的宿主,不是页面的改写。一个把每条标记都当成篡改证据的检测器,会把一个什么都没改的宿主判为有问题,所以报告必须说清这些标记出自哪个环境。
假 toString 还会漏什么
对源码检查最直觉的回应,是给替换物配一个返回可接受形状的 toString。探针这么做了,结果拿到三条标记而不是一条:
fake-tostring:Math.random -> failed toString | failed toString toString | extra own keys: toString
fake-tostring:inner -> failed toString
第一条仍是 failed toString,原因值得追一下。检测器对函数调用的是 Function.prototype.toString,不是函数自己的 toString,所以它读到的永远是真实源码,与那个属性上写了什么无关。页面在函数上定义 toString,只改变 fn.toString() 的返回,不改变 Function.prototype.toString.call(fn) 的返回,而检测器用的是后一种。
第二条是里层检查。检测器还会读函数自己那个 toString 的源码,而页面为它准备的假货又是一个页面函数,源码同样没有可接受形状。于是本想去掉第一条标记的补丁,在它装上去的值上又生出一条标记。
第三条是自有键检查。真正的原生函数恰好只把 length 和 name 作为自有键,有时外加 prototype。加上一个 toString 属性就多出第三个自有键,探针为它打印 extra own keys: toString。所以即使在从不看源码文本的人眼里,这个补丁也能从属性清单上看见。
三条标记合在一起,正好说明为什么便宜修法是笔坏买卖。页面从一条标记起步,改 toString 想把它去掉,最后变成三条。一个公开自己检查名字的检测器,会让页面看到「修法让报告变差」;页面下一步就会停止修补、改用别的方式动这个属性,下一节就是从这里开始的。
探针的克隆用例试的是同一思路里更用心的版本:把真正的 Function.prototype.toString 绑定到真正的函数上,再把这条绑定引用装成克隆的 toString。clone:fnToString-call 打印的是克隆自己的函数体 function random() { return 0.42; },说明绑定并没有把目标的源码文本带进调用。克隆仍然在 failed toString 和 extra own keys: toString 上各被标一次,跟朴素补丁是同一对,多做的功一点没换来什么。
白名单看不见的两种包装
有两种形状能通过整套检查,却仍然改变页面拿到的值,探针把两种都记了下来。
第一种是拦截 apply 的 Proxy。探针把真正的 Math.random 包进一个陷阱返回 0.42 的代理,赋上去,然后跑检查:
proxy:Math.random -> clean
一条标记都没有。代理的 Function.prototype.toString 调用转发给目标,也就是未动过的原生函数,所以源码文本是可接受形状。代理自己没有 toString,里层检查读到的同样是原生形状。代理目标的自有键就是原生的那一组,所以自有键检查也过。整套检查读到的每个信号都在描述目标,而页面拿到的值来自陷阱。
页面重新定义属性时真正会变的描述符,正是对象键顺序讨论的那一组。注意这是包在可调用原生函数上的代理,前面那篇讲代理陷阱与不变量的文章说过引擎对这种形状强制什么。不变量约束的是代理能就目标的属性报告什么,没有一条约束 apply 陷阱返回什么值。这就是代理对源码加描述符检查完全隐形的原因:没有可抓的不一致,因为这个代理是围绕原生的一层合法且自洽的包装。
第二种是绑定函数。探针不带参数地把 Math.random 绑一次,再跑检查:
bind:fnToString -> function () { [native code] }
bind:checks -> clean
绑定函数是引擎自己造的,所以它的源码文本就是可接受的 function () { [native code] } 形状,它带的也是原生那组自有键。于是页面可以拿任意原生函数绑一下,就得到一个能通过「只读源码和描述符」的完整性检查的值。绑定会不会改变行为取决于目标:把 Math.random 绑到某个 this 上毫无影响,但把一个读 this 的方法绑到代理或构造过的接收者上,就会改变调用方看到的东西。
绑定的行为取决于被绑函数读什么,而代理陷阱与不变量说明当接收者是代理时引擎会检查什么。这两处盲区有同一个成因:整套检查读的是函数对象上的静态事实,而页面控制的是调用方实际拿到什么。想同时堵住这两处的检查,得把返回值跟一个页面够不着的参考值作比较,而不只是读函数的文本。这正是静态完整性检查与行为检查的分界;只跑静态那一半的报告,只有在写明自己跑了哪条检查时才算说了实话。
记录一次改写检测读数
一条改写检测读数支撑的是一个窄结论:这个检测器、这些检查、这个环境,产生了这些标记。四个字段让它保持可核对:
- 触发的检查名字,而不只是条数,因为
failed toString和extra own keys描述的是不同的改动,只有名字说得出是哪一种。 - 被接受的源码形状,因为白名单是一组固定形状,没有它的读数在另一个打印了列表外形状的引擎上无法重跑。
- 值有没有跟参考值比较过,因为静态检查会放过
Proxy和绑定函数,而行为检查未必。 - 产生这些标记的宿主,因为原生访问器可能打印出看起来就像页面补丁的实现体,而没有宿主的读数分不清这两者。
公开来源
- MDN:Function.prototype.toString()
- ECMAScript:Function.prototype.toString
- ECMAScript:OwnPropertyKeys
- MDN:Proxy
- MDN:Function.prototype.bind()
- BotBrowser:自动化一致性参考
实践结论
按检查名字读改写报告,因为只看条数分不清是普通替换、假 toString,还是多出一个自有键。要预期 Proxy 和绑定函数能通过源码加描述符检查,因为两者都是引擎围绕未动过的原生函数造出来的形状;把那种检查的干净结果读成「源码文本看起来像原生」,而不是「值就是原生的值」。前面两篇讲代理陷阱与不变量和对象键顺序的文章,说明了自有键检查依赖的机制;而记录必须始终写明跑了哪几条检查、标记出自哪个宿主,因为一个原生访问器完全可能打印出看起来就跟补丁一模一样的东西。
本文属于指南: 什么是浏览器指纹?原理、风险、信号与隐私边界