稀疏数组的空洞与各方法的处理差异
一支探针看一个空洞:哪些方法跳过它、哪些访问它、它会被变成什么,以及 indexOf 与 includes 为什么给出相反答案。
BotBrowser Team
BotBrowser 支持在已声明 profile 下回放授权的同源夹具,并保存一份有界的记录,说明页面实际发送了什么、数组里哪些下标真正存在,但它不能让稀疏数组像密集数组那样工作,不能阻止 JSON 把空洞变成 null,也不能让 indexOf 与 includes 在缺失下标上取得一致。本评测用一支探针跑一个三元素、带一个空洞的数组,记录哪些迭代方法会访问空洞、哪些会跳过它、空洞在被复制、填充、排序或序列化之后变成什么,以及为什么同一个数组上的两次成员测试会给出相反答案。
摘要
- 空洞是缺失的下标,不是存下来的
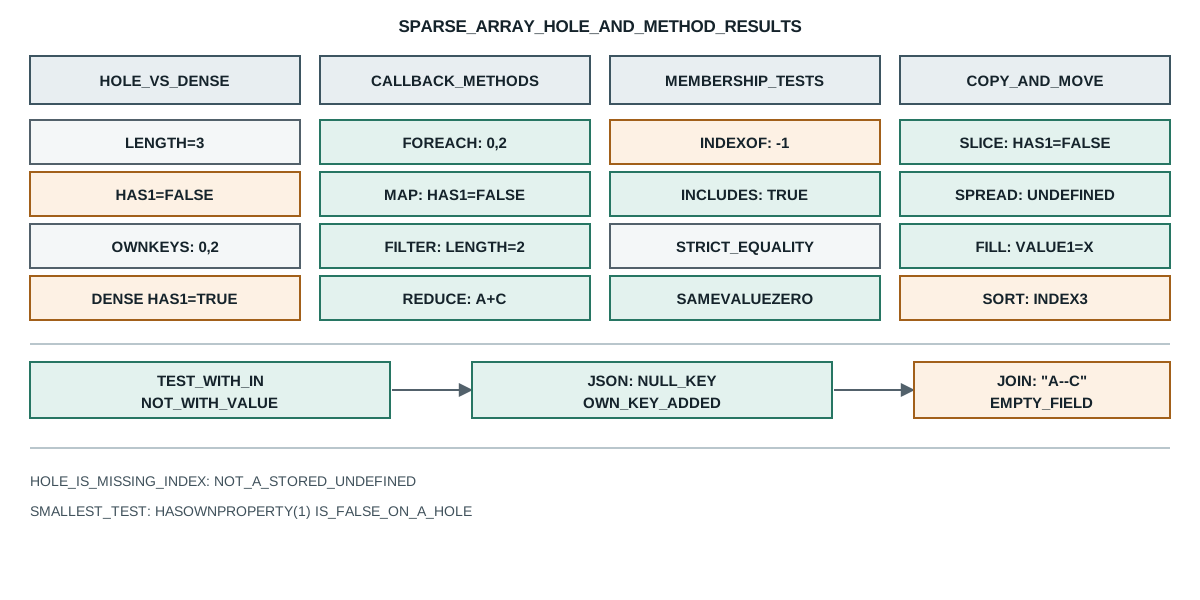
undefined:对['a', , 'c']探针打印length=3 has1=false ownKeys=0,2,而密集的['a', undefined, 'c']打印has1=true ownKeys=0,1,2。 forEach、map、filter、some、every会完全跳过空洞,所以map结果里空洞还是空洞,filter会返回一个更短的密集数组。reduce不带初值时从第一个存在的元素开始,因此把两个存在的值相加得到a+c,而同样调用带初值0时只计两次访问。- 展开运算符和
Array.from会把空洞填成undefined,所以副本报告has1=true value1=undefined,但entries()把空洞显示为1:undefined,因为迭代器访问每个下标。 indexOf(undefined)在空洞上返回-1,而includes(undefined)返回true,因为两者用的比较不同,其中一个会跳过空洞。join和String()把空洞当成空字段,所以['a', , 'c'].join('-')是"a--c",而slice和reverse保留空洞、sort把空洞挪到最后一个下标。- 一次
JSON.parse(JSON.stringify(...))往返把空洞变成null并让它成为自有键,数组回来时比出去时更密。
目录
空洞与存下来的 undefined 有什么区别
Array 允许只给长度而不要求每个下标都有元素,留下的那段间隙就是空洞。探针用赋值而不是字面量来构造它,这正是空洞在真实代码里出现的方式:程序算出下标,而不是把每个位置写出来。
node=v26.9.0
shape -> length=3 has1=false ownKeys=0,2 json=["a",null,"c"]
dense -> length=3 has1=true ownKeys=0,1,2 json=["a",null,"c"]
forEach -> visits=0:"a"|2:"c"
map -> result=["0:\"a\"",null,"2:\"c\""] has1=false length=3
filter -> result=["a","c"] length=2
some -> indexesSeen=0,2
reduce-no-init -> a+c
reduce-with-init -> count=2
spread -> length=3 has1=true value1=undefined
from -> length=3 has1=true value1=undefined
entries -> 0:"a"|1:undefined|2:"c"
indexOf -> -1 includes -> true
indexOf-c -> 2
join -> "a--c"
toString -> "a,,c"
reverse -> length=3 has1=false keys=0,2
sort -> length=4 has1=true has3=false keys=0,1,2
fill -> has1=true value1="x"
slice -> length=3 has1=false
copyWithin -> has1=true value1="c"
json-roundtrip -> has1=true value1=null
头两行就是整篇文章的缩影。两个数组都是 length=3,也都序列化成 ["a",null,"c"],所以 JSON.stringify 分不出它们。差别在 1 in a 和 Object.keys:带空洞的那个报告 has1=false,只列出键 0,2;密集的那个报告 has1=true,列出 0,1,2。空洞不是一个值为 undefined 的属性,而是那个属性根本不存在,于是每个读取数组的方法都得决定拿这份「不存在」怎么办。
这就是为什么写成 if (arr[i] === undefined) 的检查会把两种情况都判错。在带空洞的数组上,读 a[1] 得到 undefined,和在密集数组上完全一样,因为按语言规则缺失下标就读作 undefined。唯一能把它们分开的是存在性检查 1 in a,或它的等价形式 Object.prototype.hasOwnProperty.call(a, 1);当天数组可能从被污染的 prototype 继承了一个数字属性时,要用后面这种。
这个区别在请求体积的工作里有代价。一个靠给算出的下标赋值来拼结果的页面,会在某个分支没跑的位置留下空洞,序列化后的形式就在这些位置放上 null。读这份 JSON 的消费方分不清「故意记下的 null」和「从没填过的空洞」,所以一个在意这个区别的 schema 需要一个旁边的字段或一个显式的存在标记,因为数组本身带不过 JSON.stringify。
空洞还能经受住一次看起来无损的传递。把数组传给函数、存进对象字段、再返回,拿到的还是同一个对象、同样的空洞,因为这条路径上没有任何一步复制它。空洞只会在某一步把它物化时消失,而哪些步骤会物化它,就是下面两节的主题。
有三种形态能造出空洞而没有人写下逗号,每一种在评审里都很容易被漏掉。第一种是探针用的那种计算赋值:一个只给通过过滤的下标写 result[index] = value 的循环,会让其余位置缺失。第二种是先 new Array(n) 再部分写入,因为构造器只设 length、别的什么都不设,所以每个下标一开始都是空洞。第三种是 delete arr[i],它移除了自有属性、length 不变,所以一次看起来像稀疏删除的操作恰恰就是一个空洞,并且在探针测过的每个方法里都按空洞行事。
第四条路径更隐蔽,来自越过数组末端的赋值。写 arr[arr.length + 2] = 'x' 会把 length 设成新下标加一,并让中间两个下标保持为空洞,因为语言只扩展数组、不补间隙。因此一个用计算偏移而不是 push 来追加的页面会悄悄造出空洞,存在元素的个数不再等于 length。
跨边界的检测是这件事变得可操作的地方。一份保存页面数组的记录可以带上 length 和序列化后的 JSON,而这两样在「带 null 的密集数组」和「带空洞的稀疏数组」上是一致的。探针头两行正是这种情况:两者都是 ["a",null,"c"]。所以想保住这个区别的记录必须补上存在映射,比如 Object.keys(arr);只读序列化形式的消费方还没开始就已经丢了这份信息。
这个区别对相等判断也重要。两个都序列化成 ["a",null,"c"] 的数组,在遍历自有键的深比较函数下是不相等的,因为一个有下标 1、另一个没有;在先把两者都序列化成 JSON 的函数下是相等的。因此把页面输出和夹具比较的测试取决于它用哪种比较风格,而手工搭的夹具会在页面产出稀疏数组时悄悄和密集数组对上。
哪些迭代方法会跳过空洞
数组迭代方法分成两组,而这个分法并不直观。接收回调的五个(forEach、map、filter、some、every)都把空洞当成下标不存在一样跳过。探针的 forEach 打印 visits=0:"a"|2:"c",列表里没有下标 1;some 打印 indexesSeen=0,2,因为它从不为空洞调用回调。
map 是让人意外的那一个,因为它的结果保留了空洞。探针打印 result=["0:\"a\"",null,"2:\"c\""] has1=false,所以映射后的数组长度不变,下标 0 和 2 是真实值,下标 1 仍然什么都没有。一个从每个元素构造字符串的 map 会产生一个空洞依然是空洞的结果,之后再对这个结果做 join,会把空洞显示成空字段,而不是字符串 undefined。
filter 正相反,因为它没法保留空洞:结果只包含被谓词接受的元素,而空洞从不交给谓词。探针传一个恒真的谓词,得到 result=["a","c"] length=2,比源数组短一位的密集数组。于是 filter(() => true) 成了一个去空洞工具,而一个拿它当复制数组手段的页面,其实是在顺手把副本密化。
reduce 夹在两组之间,行为取决于有没有初值。不带初值时,探针的 reduce 从第一个存在的元素开始,返回 a+c,空洞从不到达回调,加法次数是一、不是二。带初值 0 时,探针打印 count=2,因为累加器从一开始就存在,回调对每个存在的元素各跑一次。不带初值的这种写法在一个没有存在元素的数组上还会抛错,那是空数组情形的稀疏等价。
some 和 every 会短路,空洞对两者都不算一次访问。这在一个期待 every 已经看过每个下标的校验循环里要紧:一个带空洞的数组可以通过一段回调从没看见过的范围的 every 检查。本该拒绝那个缺失值的谓词根本不跑,所以对一个部分填充数组的 every 比它看起来的要弱,需要拒绝空洞的页面必须单独查存在性。
迭代协议本身不跳过空洞。探针的 entries() 打印 0:"a"|1:undefined|2:"c",所以 for...of 循环或在 entries() 上做展开会看到每个下标,并把空洞报告成 undefined。for...of 给出的序列正是比较器要排序的那个序列,数组排序与比较器 从排序那一侧讲了这件事。这是走遍整个数组的另一条路:回调方法跳过空洞,而迭代器协议把空洞填上,所以一个页面用不同循环会从同一个数组得到两个不同的元素计数。
空洞在复制数组时变成什么
复制数组没有唯一答案。有的操作保住空洞,有的用 undefined 替换它,有的把它挪走。探针做了其中五个,从同一个源得到三种不同结果。
展开运算符和 Array.from 都填上空洞。探针打印 spread -> length=3 has1=true value1=undefined,from 也一样,所以副本是密集的,空洞处是一个显式的 undefined。这是一个空洞最常见的「无声消失」方式:重构里一次 [...arr] 复制把稀疏数组变成了密集数组,任何原本指望 filter 甩掉空洞的代码,现在多了一个 undefined 要处理。
slice 保留空洞。探针打印 slice -> length=3 has1=false,所以切整个数组会复现同样的形态,因为 slice 复制自有键、不凭空补上缺失的那个。slice 复制的键就是遍历自有键时报告的那些键,对象键顺序 解释了它们为什么按顺序回来、而不是插入顺序。这是把存储而不是值做浅拷贝的那类复制,空洞有意义时就该用它。
fill 会写进它覆盖的每个下标,包括空洞。探针填下标 1,打印 fill -> has1=true value1="x",所以覆盖到空洞的 fill 会把它变成真元素。copyWithin 靠移动做同样的事:copyWithin -> has1=true value1="c" 显示值被复制到空洞上面。reverse 保留空洞。探针打印 reverse -> length=3 has1=false keys=0,2,所以把这个三元素数组反转之后,空洞仍是唯一的缺失下标;这说得通,因为反转把下标 1 映到它自己,并让两个存在的值彼此交换位置。
sort 的结果值得读两遍。探针先用 concat 追加 b,再对四元素结果排序;排序那一步打印 sort -> length=4 has1=true has3=false keys=0,1,2,所以排序把空洞从下标 1 挪到了最后一位,并把下标 1 填成真实值。一个排完部分填充数组再查 length 的页面仍然得到 4,但空洞现在在末尾而不是中间,所以一个在第一个 undefined 停下的循环读到的元素和排序前不同。形态没有变,变的只是位置:下标 1 的存在性从 false 翻成 true,下标 3 的则翻向另一边。
join 和 String() 彼此一致、与别人都不一致。探针打印 join -> "a--c" 和 toString -> "a,,c",两者都把空洞渲染成空字段,而不是 undefined 这个词。这和一个含真正空字符串的密集数组的输出一样,也就是说一条拼接好的字符串,不去数原来有几个空洞,就没法拆回原数组。因此经 join 和 split 的一次往返,会丢掉 in 原本携带的存在信息。
为什么两次成员测试给出相反答案
空洞最锋利的后果是同一数组上的两次成员测试给出相反答案。探针在带空洞的数组上搜索 undefined,打印 indexOf -> -1 includes -> true,它还打印 indexOf-c -> 2,表明搜索一个存在的值是正常的。
原因是 indexOf 用严格相等并跳过空洞,而 includes 用 SameValueZero 比较并把空洞当成 undefined。空洞读作 undefined,SameValueZero 认为 undefined 和 undefined 匹配,于是 includes 返回 true。indexOf 从不访问空洞,所以返回 -1。因此一个用 if (arr.indexOf(x) === -1) 保护值的页面,和一个用 if (!arr.includes(x)) 保护值的页面,在 x 是 undefined 且数组有空洞时必然分歧,而且分歧是静默的。
这个差别不是哪个方法有缺陷,而是有据可查的分工,它存在是因为 includes 是后来带着 NaN 的情形加进来的,所以必须用 SameValueZero 才能让 [NaN].includes(NaN) 为真。同一套比较让空洞和 undefined 匹配,这是语言保留下来的副作用,因为去掉它会让 includes 跟自相矛盾。一个既要判断「值在不在」又要判断「下标填没填」的页面,因此需要两个测试,一个查值、一个查存在,而这两个问题在稀疏数组上答案不同。
JSON 往返用一种掩盖问题的方式把缺口补上。探针打印 json-roundtrip -> has1=true value1=null,所以 JSON.parse(JSON.stringify(holey)) 返回的数组里下标 1 是存在的、值是 null。空洞变成了一个值为 null 的自有键,这说明基于 JSON 的克隆会悄悄把数组密化,并把「不存在」换成一个 schema 可能并不期待的值。这跟展开复制是同一个风险,但更难察觉,因为做这件事的代码看上去常常像是保住了数据。
记录一次稀疏数组读数
一条稀疏数组读数支撑的是一个窄结论:这个运行时、这个形态、这些方法,产生了这些结果。四个字段让它保持可核对:
- 存在映射,因为
length和序列化形式分不出空洞和存下来的undefined。 - 操作本身,以及它访问、跳过还是物化空洞,因为每个操作的答案都不同。
- 结果的自有键,因为
map留住空洞、filter丢掉它、排序把它挪到末尾。 - 值有没有经过
JSON,因为一次往返会把每个空洞变成null并让它成为自有键。
公开来源
- MDN:Array
- MDN:Array.prototype.forEach()
- MDN:Array.prototype.filter()
- MDN:Array.prototype.includes()
- MDN:Array.prototype.sort()
- ECMAScript:Array 对象
- BotBrowser:自动化一致性参考
实践结论
把稀疏数组当成与密集数组不同的类型:用 in 或 hasOwnProperty 查存在性,而不是读值;预期回调方法会跳过空洞,而展开运算符和 Array.from 会把它填上;还要记住排序会把空洞停到最后一位,它原本在中间。当一个值必须经受一次复制时,按复制对空洞做了什么来选:slice 保住它,展开运算符把它密化,JSON 往返把它变成 null。至于填充值一旦存在之后按什么顺序落位,读数组排序与比较器;至于 JSON 复制对结构其余部分做了什么,读structuredClone 与 JSON。
本文属于指南: 什么是浏览器指纹?原理、风险、信号与隐私边界