迭代器助手:惰性、一次性与 take 和 drop 的推进
一支探针看迭代器助手:什么时候才取第一个值、为什么结果不能走两遍,以及 take 停下而 drop 走完的差别。
BotBrowser Team
BotBrowser 支持在已声明 profile 下回放授权的同源夹具,并保存一份有界的记录,说明页面实际从一条流里取了什么,但它不能让已经耗尽的迭代器再产出一次值,不能把 take 变成抽干,也不能让 drop 不走它跳过的那些值。本评测用一支探针跑十四个固定用例,记录每个助手何时取第一个值、为什么助手的结果不能走两遍而源数组可以、take 与 drop 分别把源推进多远、取到一半的助手留下什么,以及源里的一次抛出如何穿过整条链。
摘要
- 助手是惰性的:
source().map(...)之后探针打印lazy-before -> pulled=0,只有第一次next()才取一个值(lazy-after-one -> first=10 pulled=1)。 - 助手返回的是迭代器而不是数组:探针打印
type -> isArray=false isIterator=true。 - 助手是一次性的:展开它两次打印
consume-twice -> first=2,4,6 second=,而它来自的数组打印array-reiterable -> a=1,2,3 b=1,2,3。 take(2)会提前停下源,所以探针打印take -> values=1,2 pulled=1,2,第三到第五个值根本没被取。drop(3)不会提前抽干源,但它的第一次next()会走完三个被跳过的值:drop-after-one -> value=4 pulled=1,2,3,4。flatMap要求结果可迭代;返回一个数字会抛出TypeError。find和some一旦知道答案就停止提取,而reduce会抽干整个源。- 源里的一次抛出会在已经产出的值之后到达消费方,链就在这里结束。
目录
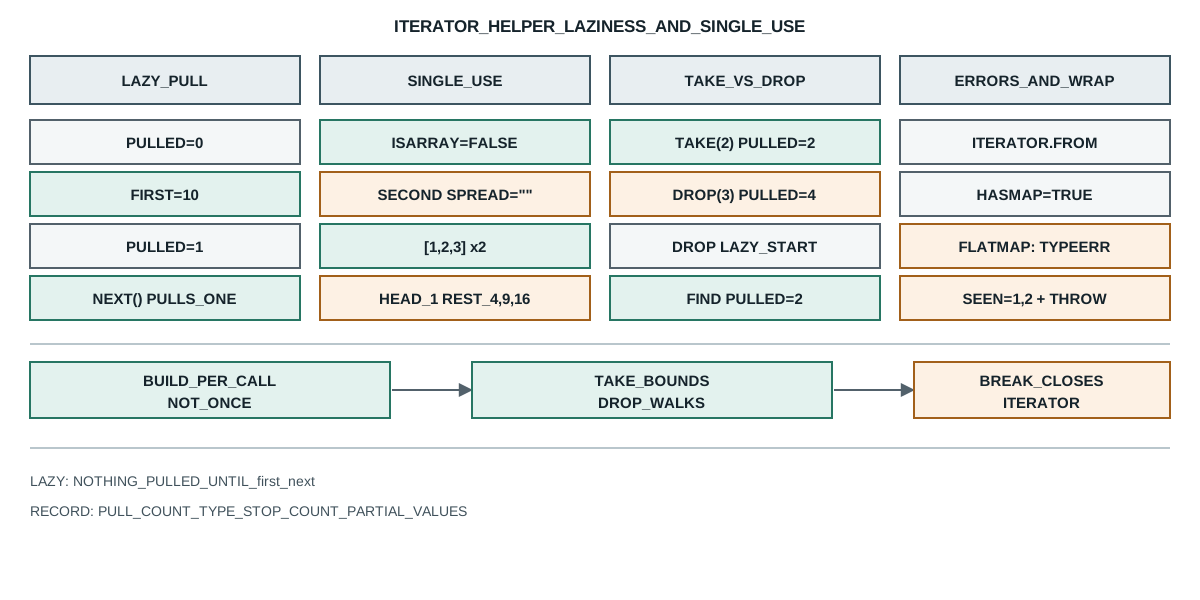
助手什么时候取第一个值
迭代器助手是一个按需产值的包装器,全部意义在于消费方不开口就什么都不跑。探针建一个记录每个产出值的生成器,用 map 包住它,然后在还没有人取值之前检查计数器:
node=v26.9.0
lazy-before -> pulled=0
lazy-after-one -> first=10 pulled=1
type -> isArray=false isIterator=true
consume-twice -> first=2,4,6 second=
array-reiterable -> a=1,2,3 b=1,2,3
helper-reiterable -> a=2,3,4 b=
take -> values=1,2 pulled=1,2
take-stopped -> pulledCount=2
drop -> values=4,5 pulled=1,2,3,4,5
drop-before-next -> pulled=0
drop-after-one -> value=4 pulled=1,2,3,4
partial -> head=1 rest=4,9,16
flatMap -> 1,10,2,20
flatMap-non-iterable -> TypeError
find -> value=2 pulled=1,2
some -> result=true pulled=1,2,3
reduce -> total=6 pulled=1,2,3
exhausted-source -> length=0
thrown -> seen=2 error=Error:source failed
from-before -> pulled=0 hasMap=true
from-take -> values=1,2,3 pulled=1,2,3
toArray -> 3,6,9 thenNext=true
break -> seen=1,2 nextDone=true
头两行就是这套设计的定义。lazy-before -> pulled=0 说明 map 调用本身没做事:它把一个回调绑到一个源上就返回了。lazy-after-one -> first=10 pulled=1 说明第一次 next() 只从生成器取了一个值、对它跑了回调、返回了映射结果。助手连成链也是这样保持惰性的,因为每一环只在消费方从链上取值时才从上一环取值。
还有第二个入口值得一提,因为它改变助手能包住什么。Iterator.from 接受任何可迭代对象或迭代器,返回一个带着这些助手的迭代器,也就是说一个只实现 Symbol.iterator 的对象也能拿到原生迭代器同样的助手。探针的用例全都从生成器或数组开始,这两者本来就带助手,所以 Iterator.from 的价值在自己写的可迭代对象上体现,比如遍历数据库结果的游标。把游标包进 Iterator.from 的页面就能用 take 限住它而不必手写循环,同样的惰性也成立:第一次取值之前不从游标读任何东西。探针打印 from-before -> pulled=0 hasMap=true,然后把一个五值的自定义可迭代对象包进 take(3),打印 from-take -> values=1,2,3 pulled=1,2,3,也就是游标正好推进了三次。
这对从大或不限长的源读取的页面很要紧。对一个要跑几分钟的生成器做 map,构建本身不花钱,而链后面一个 take(10) 让整个源只产出十个值。反过来,先建一个中间数组,就得等整个源跑完才有第一个值,这正是「一个在一瞬间就开始交付的流」和「一个一直阻塞到结束的流」的区别。
惰性是按每次取值算的,不是按一批元素算的。每次 next() 都让源跑到多一个值,所以第 n 个值的回调只在消费方要第 n 个值时才跑。一个在两次取值之间插入自己工作的页面,比如读网络流或写文件,就把源的开销摊到消费方的多个回合上,而不是一次阻塞调用里付完。这种插入就是微任务与定时器描述的同一个回合边界:以微任务入队的回调会在下一个任务到来之前执行。
代价是助手对源已经产出了多少值毫无控制。没有窥视、没有回退、也没有计数,需要这些的消费方必须自己搭,通常是用一个计数器把生成器本身包起来。助手只加映射这一步,而且它刻意是最薄的包装,因为任何更重的东西都会破坏让它胜过数组方法的那个惰性。
为什么结果是一次性的
这套设计的另一半是助手返回迭代器而不是集合,探针给出了确切后果。它打印 type -> isArray=false isIterator=true,然后展开同一个助手两次,得到 consume-twice -> first=2,4,6 second=。
第一次展开把迭代器走到了尽头,第二次发现它已耗尽、什么都没产出,也不报错。这是语言里每个迭代器的行为,助手之所以继承它,是因为它建立在迭代协议上而不是一份副本上。对比下一行的源数组:array-reiterable -> a=1,2,3 b=1,2,3,因为每次调用 array.values() 都会返回一个全新迭代器。
再下一行是同一条规则最锋利的一端。helper-reiterable -> a=2,3,4 b= 说明助手本身不可重复:它保留着构造时的那个唯一迭代器,第一次展开把它耗尽了,第二次什么也没看到。这就是把一条惰性管线变成静默空结果的错误。一个返回助手、却被调用两次的函数,第二次拿到的是死掉的迭代器,而且失败形态是空序列而不是异常。
修法是返回一个每次调用都重建助手的函数,或者返回源、在调用点建管线。一个打算被复用的助手必须每次从它的源重新派生,因为语言不给迭代器任何重置。这和生成器对象不能走两遍是同一个原因,一个混用两种风格的页面,只要假设反了,就会拿到空的第二次结果。
一批取到一半的已取值,和稀疏数组有相同的形态问题:缺失下标和存下来的 undefined 读起来一样,迭代起来却不同。助手部分消费是同一条规则的温和版。探针取一个值、再展开剩下的,对一个求平方的 map 打印 partial -> head=1 rest=4,9,16。那一次 next() 返回了 1(1 的平方),之后的展开从取停止的地方继续,对输入 2、3、4 返回 4、9、16。什么都没丢、也没重复,因为迭代器记得自己的位置;再来一次展开就会返回空。终结型助手和展开一样会把迭代器用尽:探针打印 toArray -> 3,6,9 thenNext=true,也就是 toArray 收齐所有值之后,下一次 next() 报告已完成。
源在构造助手之前就已经耗尽,是最安静的一种情况。探针先抽干一个数组迭代器,再对同一个对象建一个 map 并展开,打印 exhausted-source -> length=0。既没错误也没警告:助手建在一个已经报告完成的迭代器上,所以之后每次取值都立刻返回完成。一个缓存了迭代器、过一会再在它上面建助手的页面,只要期间有别的东西消费了这个迭代器,就会拿到空结果;修法和双重展开一样,从一个能每次产出新迭代器的源来建。
提前停下的循环,表现和「位置」模型暗示的正好相反。探针在一个助手上跑 for...of,在值 2 处 break,然后再向助手要一个值:它打印 break -> seen=1,2 nextDone=true。所以 break 不是把迭代器停在那里等以后读;离开循环会把它关掉,break 之后的值就没了。一个想读表头、停下、再从正文继续的消费方,因此不能在单个迭代器上用 for...of 加 break;它得改用 next() 逐个取,让迭代器不被关掉,或者从源重建一个新迭代器。
这对整套设计存在的理由最要紧:限制开销。break 是唯一会丢掉剩余部分的提前退出,所以一个读到某个条件就离开的消费方只为读到的部分付费,但从那个迭代器再也拿不到东西了。拉取式的写法把这个选择留着,而 take 的写法根本不需要 break 就能限住读取,所以组合了 take 的管线才是既干净停下、又不留半截工作的那一版。
take 与 drop 把源推进多远
take 和 drop 都决定消费方看到源的多大一块,而探针显示它们推进源的方式相反:take 提前停下,drop 走完它跳过的值。
take 那个用例打印 take -> values=1,2 pulled=1,2,随后 take-stopped -> pulledCount=2。源一共产出五个值,取走两个之后,记录的提取正好是头两个。take(2) 没有为了丢弃而读剩下三个;它要了两个就停了,这正是它能限住无限源的原因。一个从不限长流里取固定条数的页面,因此只按那几条付费,流其余部分根本不被碰。
drop 那个用例是镜像。迫不及待的展开打印 drop -> values=4,5 pulled=1,2,3,4,5,因为展开到底把一切都取了,被丢掉的值也得生成出来才能跳过。更能说明问题的是惰性那行:drop-before-next -> pulled=0 说明一个新建的 drop(3) 在构造时什么都没取,而 drop-after-one -> value=4 pulled=1,2,3,4 说明它的第一次 next() 走了四个值才返回第四个。所以 drop 和任何助手一样在构造时是惰性的,但它推迟的正是「跳过」这项活儿,一个在 drop(3) 之后要一个值的消费方,已经引发了四次提取。
这个不对称决定了怎么给流设上限。take 是安全的上限,因为它从不多读。drop 是按位置过滤,一个在慢源上用大计数的 drop,会在第一个值到达消费方之前先把慢活做完,所以一个把大 drop 和 take 组合起来的页面还是得为 drop 付费。想跳过表头再读正文的消费方,因此在要第一个正文值时就要为表头付费,不是开始之前付,但也不是白付。
和 flatMap 的交互值得用同一份读数里的一行讲清。探针对一个每个输入返回两个值的 flatMap 打印 flatMap -> 1,10,2,20,也就是源的每次提取变成消费方的两次提取,而且展平只有一层、不是递归。返回嵌套数组的 flatMap 会把一个数组当作值交给消费方,而不是它的元素,这和同名数组方法是一样的单层规则。
flatMap 也拒绝展平一个不可迭代的值。探针尝试返回一个数字,打印 flatMap-non-iterable -> TypeError,所以一个有时返回标量、有时返回列表的回调,会在标量上失败而不是把它跳过。一个用可能返回 undefined 的回调搭 flatMap 的页面,因此必须在助手看到之前把结果归一化成空数组或单元素数组,因为助手不会把不可迭代当成「没有东西可展平」。
源里的一次抛出会发生什么
一个半路出错的迭代器,得对已经产出的那些值有个交代,探针把行为钉住了。它的源先产出 1,然后抛出 Error('source failed'),而一个建在它上面的 map 用 for...of 消费:
thrown -> seen=2 error=Error:source failed
消费方收到了第一个映射后的值 2、把它记下来,然后下一次提取让源走到抛出,那个错误就以原始形态从循环里冒出来。抛出之前的值不会撤回,抛出之后的值根本不存在。这就是一个边到边处理元素的消费方所依赖的契约:已经处理过的保持处理过,失败出现在源失败的那一点,而不是在开头。
错误不被包装。探针打印 Error:source failed,和源抛出的是同一个构造器与消息,所以一串助手原样把抛出的值往下传。一个想加背景的页面必须在处理元素的那一点把错误包起来,因为助手不会再加一层来指出链上哪一步失败了。
抛出之后迭代器就结束了,所以在同一个对象上重试不会产出任何东西,而不是重跑源。这和展开那次用例是同一条一次性规则,只是用在了失败上:位置已经在抛出之后,没法回到那里。需要重试的页面必须从一个新源建一个新迭代器,这通常意味着用一个构建生成器的函数,而不是存下来的生成器对象。
对同一个源做 reduce 是急切的,这改变了抛出相对调用方发生的时机。探针对一个三值源打印 reduce -> total=6 pulled=1,2,3,中途没有部分结果,所以遇到抛出的 reduce 会丢掉它已经建好的累加器。非归约的助手让消费方一次看一个值、对每个动手;reduce 在最后把它们坍成一个值,失败则意味着这个值永远不会到。两者之间怎么选,因此就是选消费方需要留住多少部分进度。
记录一次迭代器助手读数
一条迭代器助手读数支撑的是一个窄结论:这个运行时、这个源、这些助手,产生了这些提取。四个字段让它保持可核对:
- 第一次
next()之前的提取计数,因为惰性就是全部意义,一个构造时已经取了东西的助手并不惰性。 - 消费方手里拿的是数组还是迭代器,因为对迭代器第二次迭代返回空,对数组则再次返回值。
- 每次停下时的提取计数,因为
take和drop推进源的距离不同,只有计数能说明是哪一个。 - 失败发生在已经产出的值之后,因为一个保留部分结果的消费方,依赖更早的值能扛过抛出。
公开来源
- MDN:Iterator
- MDN:Iterator.prototype.map()
- MDN:Iterator.prototype.take()
- MDN:Iterator.prototype.drop()
- MDN:Iterator.prototype.flatMap()
- ECMAScript:Iterator Helpers
- BotBrowser:自动化一致性参考
实践结论
把助手连成链、只为真正取到的值付费:建好链,源不限长时用 take 封顶,并记住 drop 是在第一次取值时走它跳过的部分,而不是提前走。调用方可能迭代两次时,返回一个构建管线的函数而不是存下来的迭代器,因为助手是一次性的,第二次展开会静默为空。把 flatMap 回调的结果归一化成数组,好让标量不至于抛出;并想清楚消费方是否需要保留已经处理过的值,因为一次抛出会结束迭代器,而 reduce 会丢掉累加器。基于微任务的流按什么顺序交付,读微任务与定时器;一个填了一半的批次留下什么缺口,读稀疏数组的空洞。
本文属于指南: 什么是浏览器指纹?原理、风险、信号与隐私边界