Как работает веб-сканер: пять этапов обхода
Путь веб-сканера от начальных URL до следующего запроса: область обхода, загрузка, разбор, поиск ссылок и решения очереди с явными причинами отказа.
BotBrowser Team
Нужна структурированная документация по теме Начало работы?
Эта статья относится к редакционной библиотеке. Для пошаговой настройки, справки и постоянных обновлений переходите сразу в соответствующий раздел docs.
Веб-сканер, или краулер, представляет собой программу, которая находит веб-адреса и загружает страницы по заданным правилам. Он начинает с известных URL, получает допустимые страницы, читает содержимое, обнаруживает новые ссылки и выбирает следующий адрес. Сам цикл прост; основная инженерная работа заключается в решении, какие URL должны в него попасть.
BotBrowser может предоставить браузер Chromium для разрешённой автоматизации, когда странице нужен браузерный рендеринг. Он не предоставляет начальный список, очередь URL, правила устранения дубликатов или разрешение собирать данные сайта. Сканер может использовать обычный HTTP-клиент, браузер или оба компонента. Браузер является лишь одним средством получения документов внутри более широкого процесса.
Кратко
- Начальный URL запускает поиск, но не описывает все страницы сайта или проекта.
- Для загрузки нужны допустимый URL, решение по правилам сайта и свободный момент отправки запроса. Обнаружение адреса само по себе не разрешает запрос.
- Разбор ответа и извлечение ссылок являются разными операциями: пригодный HTML может не содержать ни одного следующего допустимого URL.
- Разрешайте каждую ссылку относительно базы документа до проверки области и дубликатов. Храните итоговый URL и причину приёма либо отклонения.
- Очередь содержит незавершённую работу. Её пустота означает лишь отсутствие допустимой работы по записанным правилам, а не обнаружение всех возможных страниц.
Содержание
- Цикл из пяти этапов
- Выбрать начальные URL и определить границы
- Загрузить один допустимый URL
- Разобрать полученное представление
- Разрешить ссылки и отклонить дубликаты
- Выбрать следующий запрос и объяснить остановку
- Практический вывод
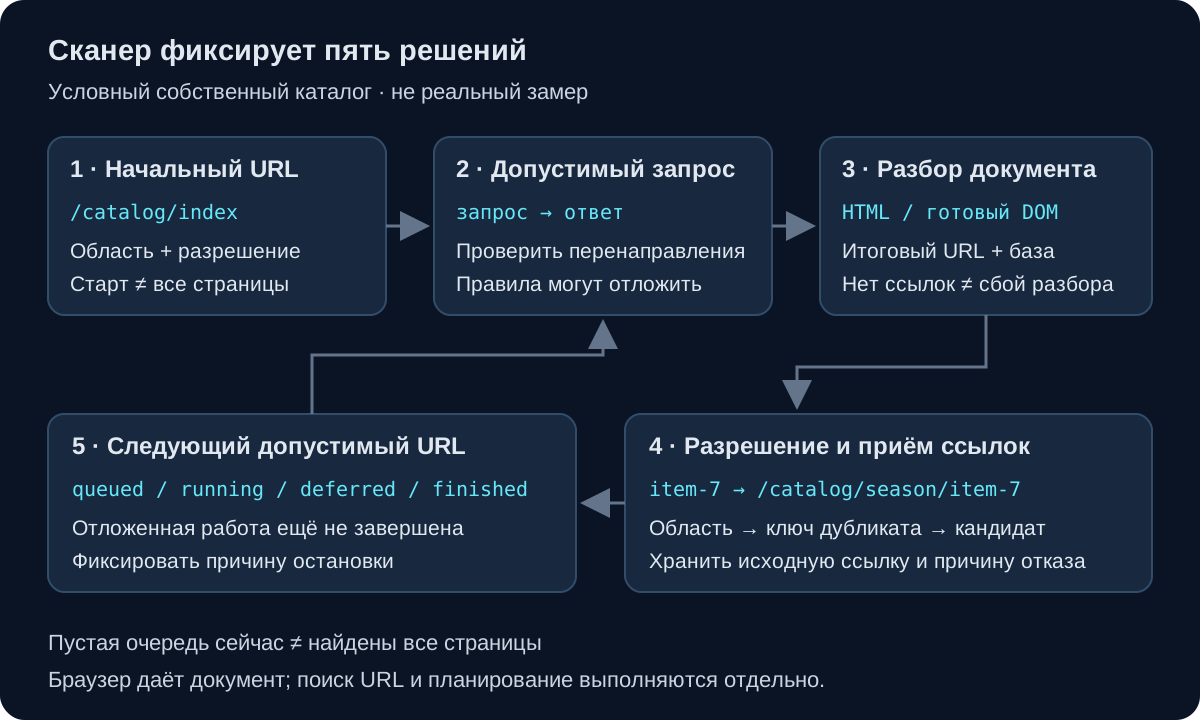
Цикл из пяти этапов
Рассмотрим явно условный каталог на https://catalog.example/. Его владелец хочет проверить общедоступные HTML-страницы внутри /catalog/, начиная с /catalog/index. Из обхода исключены страницы входа, другие источники и загружаемые файлы. Это выбранные правила проекта, а не обязательное определение любого сканера. Следующие примеры являются предлагаемой трассировкой, а не выводом выполненного обхода.
| Этап | Вход | Решение | Зафиксированный результат |
|---|---|---|---|
| Старт | /catalog/index | Входит ли начальная точка в заявленную область? | Допустимый начальный URL |
| Загрузка | Допустимый абсолютный URL | Можно ли отправить запрос сейчас и перейти по его перенаправлению? | Ответ либо отложенная или неудачная попытка |
| Разбор | Тело и метаданные ответа | Какое представление документа и какой анализатор подходят? | Разобранный документ либо конкретная ошибка разбора |
| Поиск | Ссылки в документе | Какие абсолютные URL обозначают ссылки и какие из них новые и допустимые? | Принятые кандидаты и причины отказа |
| Планирование | Кандидаты и незавершённая работа | Какой допустимый элемент выполнить следующим и что ещё осталось? | Следующий запрос, отложенный элемент или записанная остановка |
Это учебная модель, а не обязательная архитектура программы. Фреймворк может объединять операции или выполнять несколько запросов параллельно. В документации архитектуры Scrapy разделены планировщик, загрузчик и пауки: ответ поступает пауку, а сформированные им запросы возвращаются планировщику. Такое разделение позволяет выяснить, какой компонент потерял или отклонил URL.
В описании работы Поиска Google Search Central также разделяет обнаружение, сканирование и индексирование. Это документированные этапы поиска Google, а не обещание загрузить или проиндексировать каждый обнаруженный URL. Сканеру, который составляет перечень собственного каталога, поисковый индекс может вообще не требоваться.
В сравнении краулера и скрапера покрытие загрузки отделено от извлечения полей. Здесь полезным артефактом служит последовательность решений по URL. Страница может успешно загрузиться и пройти разбор, хотя отдельный обработчик товарных записей отклонит её из-за отсутствующей цены. И наоборот, сканер не может заявлять об ошибке извлечения записи со страницы, которую он никогда не получал.
Выбрать начальные URL и определить границы
Начальный URL представляет собой исходный адрес, переданный сканеру. Он может поступить из конфигурации, списка владельца или sitemap. Условный запуск начинается с https://catalog.example/catalog/index. Этот выбор показывает, откуда начинается поиск. Он не доказывает, что оттуда достижима каждая разрешённая страница каталога.
Храните начальный список отдельно от правила области. Ещё один адрес, например /catalog/archive, может открыть несвязанную часть того же разрешённого каталога. Начальная страница /account/ не соответствует ограничению /catalog/, даже если хост совпадает. Сканер должен отклонить такой ввод до сетевой операции и сохранить причину, например outside_path_scope.
Задайте проверяемую границу вместо расплывчатого требования «оставаться на сайте». В этом примере допустимые URL используют https:, имеют точный источник https://catalog.example и путь внутри /catalog/. Владелец дополнительно исключает /catalog/private/. Источник включает схему, хост и порт; общее название бренда или суффикс не делает другой источник частью согласованной цели.
| Кандидат | Решение для этого примера | Причина |
|---|---|---|
https://catalog.example/catalog/index | Принять | Начальная страница каталога |
https://catalog.example/catalog/archive | Принять | Дополнительная входная точка, согласованная владельцем |
https://catalog.example/account/ | Отклонить | Путь вне заявленного каталога |
https://cdn.example/catalog/index | Отклонить | Другой источник |
https://catalog.example/catalog/private/item | Отклонить | Явное исключение закрытого пути |
Проверяйте путь в разобранном URL, а не по сырой подстроке. Текст catalog.example может встретиться в пути, параметре запроса или другом имени хоста. Вместе с владельцем определите обработку кодированных путей и перенаправлений: безусловное декодирование или переписывание компонентов может изменить смысл адреса. Проверка области не заменяет систему авторизации произвольного ввода.
На этом этапе предотвращается недостоверное утверждение о покрытии. Допустим, владелец отдельно передаёт конечный список ожидаемых URL каталога. Сравнение загруженных результатов с этим списком позволяет найти пропущенные страницы. Без независимого знаменателя «найдены все страницы» означает лишь все страницы, обнаруженные выбранным методом. Ни широкий начальный адрес, ни большое число запросов не создают отсутствующий знаменатель.
Записывайте вместе набор начальных адресов, версию области и идентификатор запуска. Если /catalog/archive добавлен в середине обхода, последующие результаты относятся к изменённому вводу. Явная запись изменения позволяет объяснить новый URL, не приписывая его исправлению анализатора или смене браузера.
Загрузить один допустимый URL
Загрузка превращает принятый URL в попытку запроса. Перед отправкой проверьте правила сайта и разрешение проекта, затем допустимость запроса в текущий момент. Это разные решения. URL может входить в каталог, но быть запрещён применимыми правилами robots, находиться за пределами разрешения владельца или ожидать в планировщике своего источника.
В разборе политики robots.txt объясняются именованная группа агента и толкование правил. RFC 9309 прямо отделяет эти правила от разрешения доступа. Разрешающее правило robots не заменяет условия использования, согласие или решение контроля доступа; отсутствие файла не делает закрытый ресурс разрешённой целью.
Используйте политику запросов, фиксирующую причину выполнения операции. Для условной страницы /catalog/index запись попытки может содержать request_url, requested_at, policy_version, attempt_number и результат загрузки. Это предлагаемые поля приложения. Они не являются предоставленным браузером доказательством разрешения, и примеры значений не претендуют на реальные сетевые измерения.
Перенаправления требуют повторной проверки границы. Запрос /catalog/old может привести к /account/login или другому источнику. Сканер, который проверяет только начальный URL, а затем автоматически следует перенаправлениям, способен выйти за заявленную область. Проверяйте назначение до перехода, сохраняйте цепочку для диагностики и останавливайтесь при недопустимом следующем адресе. Число перенаправлений тоже должно иметь конечный предел.
Полученный ответ ещё необходимо классифицировать. HTML-страница каталога, форма входа со статусом HTTP 200, ответ 404 и временная ошибка сервиса имеют разные значения. Храните статус, итоговый URL и соответствующий тип содержимого рядом с решением о теле. Не считайте любой HTTP 200 успешной страницей каталога: приложение могло получить не то представление.
Планировщику также нужна политика запросов для каждого источника. Параллелизм ограничивает одновременную работу; интервал определяет время начала нового запроса. Одно не равнозначно другому. При сигнале перегрузки сохраняйте отложенный результат и применимую политику повторов вместо немедленного цикла запросов. Подробный расчёт пропускной способности относится к планированию ресурсов; здесь достаточно более узкого правила: найденную страницу не всегда можно загрузить прямо сейчас. Расчёт ёмкости обхода показывает, как паузы и резерв повторов уменьшают конечный бюджет запусков запросов.
Отделяйте результаты попыток от результата URL. Для /catalog/item-7 первая попытка может завершиться по тайм-ауту, а следующая получить корректный ответ. Журнал должен сохранять историю и одновременно давать URL одно текущее состояние планирования. Подсчёт двух попыток как двух охваченных страниц завышает покрытие; удаление первой уничтожает данные, объясняющие повтор.
Разобрать полученное представление
Разбор интерпретирует ответ как документ. Сначала сканер должен понимать, что именно он обрабатывает. Анализаторы HTML и JSON и обработчик PDF выполняют разные задачи. Если запуск допускает только общедоступные HTML-страницы каталога, неожиданный тип содержимого должен давать конкретный результат, а не безусловно передаваться обработчику HTML-ссылок.
URL ответа важен, поскольку дальнейшим ссылкам нужна база. Если /catalog/index перенаправляет на /catalog/season/, полученный документ относится к конечному расположению. Относительная ссылка item-7 разрешается от этих двух адресов по-разному. Сохраняйте итоговый URL этапа загрузки, а не восстанавливайте его из начального адреса.
Разбор полученного HTML и рендеринг страницы тоже являются разными операциями. HTTP-клиент может обработать ссылки, уже находящиеся в ответе. Браузер может выполнить скрипты, которые создадут дополнительные узлы и ссылки DOM. Google описывает эти пути в основах JavaScript SEO. Это описание собственного конвейера Google, а не подтверждение того, что любой сканер исполняет JavaScript.
Выбирайте представление осознанно. На собственной тестовой странице сравните ссылки исходного ответа со ссылками, которые приложение создаёт после документированного состояния готовности. Если нужные ссылки каталога уже есть в полученном HTML, рендеринг для этого шага поиска не нужен. Если они появляются только после инициализации, требуется соответствующий браузерный этап или другой согласованный владельцем источник URL.
BotBrowser может выполнять этот браузерный этап при разрешённой автоматизации, как описано в его документации по началу работы. Он не выбирает условие готовности и не решает, что DOM уже полон. Контракт приложения должен назвать событие, состояние или элемент, после которого сбор ссылок имеет смысл. Произвольная задержка может закончиться до поступления данных либо ожидать бесконечно, если страница поддерживает фоновую активность.
Храните ошибки разбора отдельной ветвью. Если ответ получен, но выбранный анализатор отклонил его содержимое, URL был загружен, однако не был успешно интерпретирован. Успешно разобранная страница может не иметь подходящих ссылок. Этим случаям нужны разные записи, например parse_failed и parsed_no_candidates, со значениями, определёнными приложением.
Различие предотвращает дорогую, но неверную коррекцию. Дополнительные ресурсы браузера не превращают форму входа в разрешённую страницу каталога. Повторная HTTP-загрузка не обнаружит созданные скриптом ссылки, если представление не изменится. Сначала определите класс ответа и цель разбора, а уже потом меняйте компонент получения данных.
Разрешить ссылки и отклонить дубликаты
Поиск начинается со ссылочных значений, которые не обязательно являются абсолютными URL. Якорь каталога может содержать item-7, ../archive/ или #details. В справочнике конструктора URL объясняется разрешение относительных ссылок от базы. В разобранном HTML базовый URI документа также может зависеть от применимого элемента base.
Таблица предполагает записанную базу https://catalog.example/catalog/season/. Это предлагаемые решения для данной политики, а не результаты работающего сканера. Внешняя база изменила бы разрешение; к итоговому адресу всё равно применяется та же проверка источника.
| Ссылка | Разрешённый относительно базы URL | Решение |
|---|---|---|
item-7 | https://catalog.example/catalog/season/item-7 | Новый допустимый кандидат |
./item-7 | https://catalog.example/catalog/season/item-7 | Дубликат кандидата |
item-7#details | https://catalog.example/catalog/season/item-7#details | Тот же ключ загрузки по политике фрагментов этого запуска |
../archive/ | https://catalog.example/catalog/archive/ | Допустимый кандидат |
/account/login | https://catalog.example/account/login | Вне области путей |
https://other.example/catalog/item-7 | https://other.example/catalog/item-7 | Вне области источников |
Проверяйте допустимость после разрешения ссылки. Безобидное на вид относительное значение может привести к исключённому адресу при другой базе документа. Принимайте только подходящие схемы: mailto: и javascript: не являются HTTP-запросами к каталогу. Универсальному сервису, принимающему произвольные целевые URL, нужны дополнительные меры проверки сетевых назначений помимо правил этого примера.
Для устранения дубликатов нужен явный ключ. Этот запуск удаляет фрагмент при определении сетевой загрузки, поэтому три ссылки товара имеют один ключ. Это политика каталога, а не доказательство того, что фрагменты никогда не влияют на приложение. Маршрут с клиентским рендерингом может использовать фрагмент для выбора другого представления. Если такая версия страницы входит в задачу, ключ браузерной навигации может отличаться от ключа HTTP-загрузки.
Не удаляйте параметры запроса только из-за внешнего сходства. /catalog/search?page=1 и /catalog/search?page=2 могут показывать разные товары. И наоборот, подтверждённый владельцем параметр отслеживания иногда можно исключить из ключа планирования. Записывайте разрешённое преобразование и его причину. Сортировка, перевод в нижний регистр или декодирование целого URL способны объединить адреса, которые сервер различает.
Сохраняйте исходное значение и страницу-источник рядом с разрешённым кандидатом. Запись отказа с полями source_url, raw_reference, resolved_url, candidate_key и decision_reason объясняет принятое решение. Она также выявляет обработчик, который обрезает адрес или игнорирует базу. Один лишь итоговый список посещений теряет эти сведения о поиске.
Дубликаты URL и дубликаты документов являются разными вопросами. Два адреса могут возвращать одинаковые тела, а один адрес может менять содержимое со временем. Хеш содержимого помогает принять решение о хранении или обнаружении изменений, но не доказывает возможность объединить две идентичности URL для любой цели. Очередь должна следовать заявленному правилу идентичности адреса, а сравнение содержимого при необходимости хранится отдельно.
Выбрать следующий запрос и объяснить остановку
Фронт обхода объединяет ожидающие URL и состояние, необходимое для их планирования. Он не обязательно является единственной очередью в памяти. Маленький скрипт может использовать очередь и множество; крупный сервис может сохранять задания между работниками. В обоих случаях нужно различать обнаруженное, поставленное в очередь, выполняемое, отложенное и завершённое.
В условном каталоге /catalog/archive/ может стоять в очереди, пока /catalog/season/item-7 ждёт разрешённого времени. Следующий запрос выбирается из допустимой незавершённой работы. Обход в ширину обычно раньше посещает ссылки, близкие к начальным адресам; приоритетная политика может предпочитать раздел, определённый владельцем. Ни один порядок не гарантирует полноту при недостижимых страницах или растущем пространстве URL.
| Состояние элемента | Что известно запуску | Что осталось сделать |
|---|---|---|
queued | Кандидат прошёл текущие проверки приёма | Передать на допустимую загрузку |
running | Работник владеет попыткой | Завершить или восстановить её |
deferred | Работа остаётся, но пока не может выполняться | Повторно проверить в записанное время или при нужном условии |
finished | URL достиг заявленного терминального результата | Сохранить ответ и результат обработки |
rejected | Записанная политика исключила кандидата | Сохранить причину и не считать URL загруженным |
Это предлагаемые состояния журнала, а не стандарт фреймворка. Сбой работника не должен незаметно превращать running в finished. Постоянный планировщик может применять аренду задания или другой явный механизм владения, чтобы прерванную работу можно было восстановить. Восстановление тоже требует защиты от дубликатов: повтор брошенной попытки не должен создавать двух одновременных владельцев одного ключа загрузки.
Избегайте общего множества «увиден, значит завершён». Если URL отмечен увиденным при обнаружении, а запись в очередь затем не удалась, он может исчезнуть из последующего поиска, так и не будучи загружен. Приём должен оставлять устойчивую запись ожидающей или отклонённой работы. Неудачный запрос также не становится завершённым только потому, что адрес уже встречался. Журнал должен отличать повторное обнаружение от текущего состояния задания.
Для остановки недостаточно пустоты ближайшей очереди. Отложенные элементы, активные попытки и необработанные ответы ещё могут породить работу. Ограниченный запуск должен указать причину: вся принятая работа достигла терминальных состояний, исчерпан лимит времени или страниц, поступила команда оператора либо ошибка политики запретила продолжение. Эти исходы обосновывают разные утверждения о покрытии.
Например, если /catalog/archive/ завершён, но item-7 всё ещё отложен, корректный вывод: «сейчас нет допустимых запросов; остаётся один принятый URL». Нельзя говорить «каталог обойдён полностью». Когда все принятые URL достигнут терминальных состояний, сообщите область, начальные адреса и числа по терминальным исходам. Отдельный список владельца затем позволяет сравнить покрытие; сама очередь не покажет страницы, которых она никогда не обнаруживала.
Вопросы и ответы
Каждому веб-сканеру нужен браузер?
Нет. HTTP-клиент и анализатор могут найти ссылки в полученном HTML. Браузер полезен, когда задача зависит от состояния отрисованного документа; внешние правила поиска и планирования всё равно необходимы.
Достаточно ли посетить главную страницу для завершения?
Только если этот единственный URL составляет всю заявленную задачу. При поиске страниц каталога начальный ответ обычно создаёт новых кандидатов, для которых нужны записанные решения приёма и терминальные результаты.
Предписывает ли canonical удалить другой URL?
Декларация canonical не заменяет правило идентичности загрузки проекта. Сохраните наблюдаемую декларацию и определите её влияние на задачу. Не считайте её автоматически разрешением, HTTP-перенаправлением или доказательством одинаковых ответов.
Источники
- Google Search Central: работа Поиска
- Проект Scrapy: архитектура
- RFC 9309: протокол исключения роботов
- Google Search Central: основы JavaScript SEO
- MDN: конструктор URL()
- MDN: Node.baseURI
- BotBrowser: начало работы
- BotBrowser: ответственное использование
Практический вывод
Для одного разрешённого обхода каталога задайте начальный список, правило области и конечное условие остановки. Для каждой найденной ссылки храните источник, разрешённый URL и причину приёма; для каждого принятого URL сохраняйте результаты загрузки, разбора и планирования. Эти данные делают пять этапов объяснимым циклом, включая отклонённые и отложенные адреса. При необходимости браузер предоставляет отрисованный документ, но разрешение, политика поиска и критерий завершения остаются ответственностью оператора сканера.
Эта статья входит в руководство: Начало работы с автоматизацией браузера: карта
Похожие статьи
Web crawler vs web scraper: результаты и ошибки
Начало работыОбход сайтов: бюджет и бережная нагрузка
РазвертываниеПарсинг robots.txt: правила, запреты и ошибки загрузки
Начало работыСбор данных Instagram: сначала условия API
Начало работыОтпечаток браузера в Scrapy: границы настроек
Начало работыНастройка browser-use с управляемым браузером
Выполните ту же проверку в BotBrowser
Загрузите профиль, сохраните внутри браузера те сигналы, о которых только что прочитали, и подтвердите результат на своей машине до раскатки.