Web crawler vs web scraper: результаты и ошибки
Отделите обнаружение URL от извлечения полей, задайте контракт передачи и различайте пропущенные страницы и неполные записи до выбора браузера.
BotBrowser Team
Нужна структурированная документация по теме Начало работы?
Эта статья относится к редакционной библиотеке. Для пошаговой настройки, справки и постоянных обновлений переходите сразу в соответствующий раздел docs.
Web crawler vs web scraper: это различие двух результатов: ограниченного набора загрузок и записей, извлечённых из полученного содержимого. Страница может успешно загрузиться, но не содержать цену. BotBrowser предоставляет браузер Chromium для разрешённого этапа рендеринга; он не обнаруживает URL сайта, не планирует очередь обхода и не определяет поля, которые должен вернуть сборщик данных.
TL;DR
- Обход определяет, какие URL посетить, и управляет загрузкой; извлечение получает выбранные сведения из содержимого.
- Одна программа может выполнять обе задачи. Название фреймворка не показывает, какой результат оказался неверным.
- Фронтир обхода содержит ожидающую работу. Пустая очередь не доказывает, что найдены все нужные страницы.
- Рендеринг в браузере выбирают отдельно: ни одна задача не всегда требует выполнения JavaScript.
- Связывайте результаты загрузки и проверки записей, прежде чем объявлять сбор завершённым.
Содержание
- Результаты двух задач
- Один конвейер может выполнять обе задачи
- Число запросов не описывает всю стоимость
- Передача данных с двумя критериями приёмки
- Идентичность URL и идентичность записи
- Совпадения селектора недостаточно
- Определите этап ошибки до замены инструмента
- Завершение и повторная обработка
- Границы сбора до первой загрузки
- Практический вывод
Результаты двух задач
Краулер выбирает URL, планирует запросы и записывает исход каждой загрузки. Начальные адреса могут поступать из явного списка, sitemap или ссылок в уже полученных страницах. Google определяет crawler как программу для автоматического обнаружения и сканирования сайтов. Полезный результат обхода: журнал с source_url, источником обнаружения, статусом и временем загрузки. Хранить тела ответов необязательно: проверке доступности могут быть нужны только статусы и ссылки. Пошаговый разбор работы сканера прослеживает начальный URL через загрузку, разбор, разрешение ссылок и планирование и показывает, почему обнаруженная ссылка может остаться незагруженной.
Скрапер выбирает сведения из ответа или отрисованного документа и преобразует их в запись. Контракт может требовать sku, price и currency. Входом бывает одна сохранённая страница или тысячи документов; переходы по ссылкам для извлечения полей не обязательны. Ответ HTTP 200 всё ещё может содержать пустую цену, неожиданную разметку или значение, не прошедшее проверку.
| Решение | Ответственность обхода | Ответственность извлечения |
|---|---|---|
| Вход | Разрешённые начальные адреса и область URL | Полученное содержимое и схема полей |
| Рабочее состояние | Очередь URL и результаты загрузок | Результаты разбора и записи-кандидаты |
| Проверка выхода | Что посещено, исключено или осталось нерешённым | Какие обязательные поля и ключи корректны |
| Типичный дефект | Разрешённая страница не попала в очередь | На загруженной странице нет корректного price |
Фронтир: очередь ещё рассматриваемых задач, а не полный список страниц сайта. Она может опустеть после пропуска ссылки пагинации. Для оценки охвата нужны объявленная область и независимое условие завершения, например сверка со списком URL от владельца.
Один конвейер может выполнять обе задачи
Архитектура Scrapy опровергает жёсткое разделение инструментов. Spider может возвращать одновременно извлечённые элементы и новые запросы. Движок передаёт запросы планировщику, а элементы: конвейерам данных, где возможны проверка и сохранение. Две обязанности используют один фреймворк, но не превращаются в один критерий приёмки.
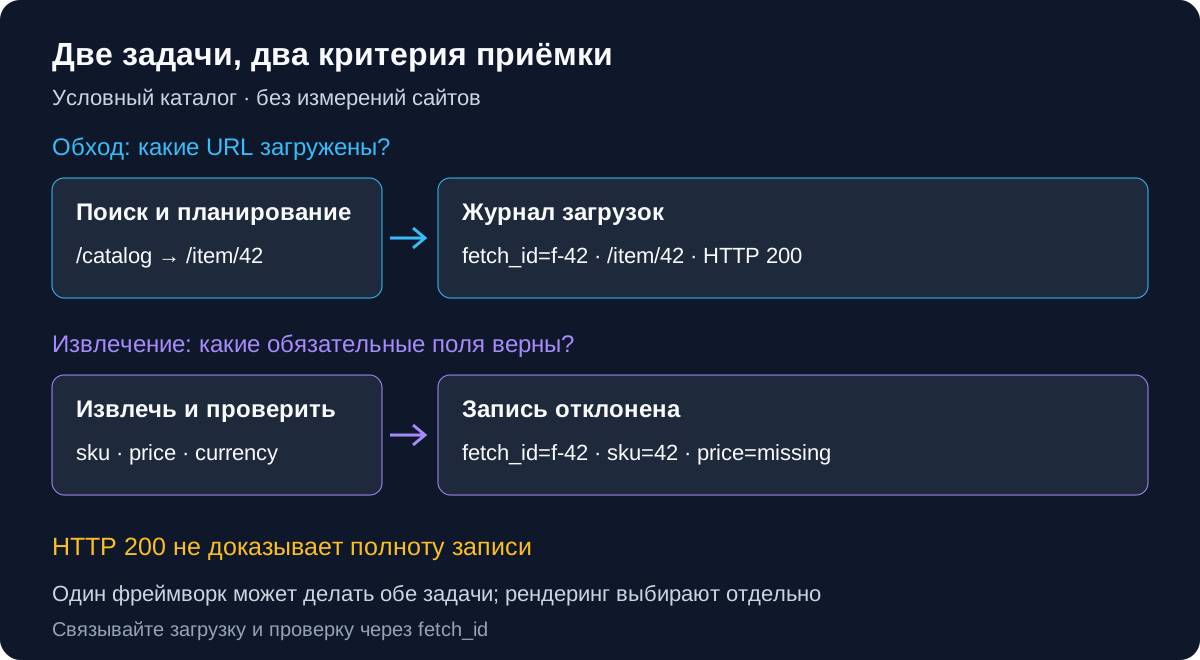
В разрешённом каталоге компонент может обнаружить /item/42 на /catalog, загрузить документ и передать его экстрактору. Тот создаёт запись с ценой. Если он также возвращает следующий адрес каталога, то участвует и в обнаружении. Важно установить, кто принимает решение об URL, а кто отвечает за поля.
Рендеринг располагается между загрузкой и интерпретацией, когда нужное содержимое зависит от JavaScript. Краулер может отрисовать страницу для поиска навигационных ссылок, скрапер: для получения цены. Оба могут работать и с HTML, доставленным сервером. BotBrowser обеспечивает браузерный этап, но фронтир, правила извлечения и сохранённые записи остаются ответственностью приложения. Настройка браузера через Playwright описывает подключение этого этапа, когда входные данные подтверждают его необходимость.
Число запросов не описывает всю стоимость
Обход навигации может отправлять запросы, не создавая бизнес-записей. Извлечение из сохранённых документов может создавать записи без нового обращения к источнику. Если оба этапа независимо загружают /item/42, источник получает двойную работу, хотя команда видит одну итоговую строку.
Считайте отдельно запросы к источнику, попытки разбора и работу браузера. Полезны fetch_attempts, render_attempts, parse_attempts и принятые ключи записей. Повтор относится к этапу, который его инициировал: исправление парсера на сохранённом теле не должно автоматически вызывать новый сетевой запрос. Хранение требует политики данных и места; сохранять каждый ответ не обязательно для того, чтобы процесс был краулером.
В диагностике частоты и параллелизма разделены частота запросов и одновременная работа. Это относится ко всему конвейеру: два модуля с одной origin создают совокупную нагрузку на источник. Браузер добавляет рендеринг и может загружать ресурсы страницы, поэтому «одна страница» не обязательно означает один HTTP-запрос.
Передача данных с двумя критериями приёмки
Свяжите журнал загрузок и результат извлечения устойчивым идентификатором. Сохраняйте исходный запрошенный URL вместе с конечным после перенаправлений: редирект не должен незаметно менять представление команды о собранном содержимом. Следующие строки: условные примеры контракта каталога, а не результаты теста или измерения сайта.
fetch_id | source_url | Загрузка | Извлечение | Решение |
|---|---|---|---|---|
f-41 | /item/41 | HTTP 200 | sku=41; price=12.90; currency=USD | Принять после проверки схемы |
f-42 | /item/42 | HTTP 200 | sku=42; price=missing | Отклонить запись; проверить извлечение |
f-43 | /item/43 | HTTP 503 | Не выполнялось | Оставить загрузку нерешённой |
В реальном журнале добавьте fetched_at, конечный URL, schema_version и статус разбора. Если тела хранятся, хеш или ссылка на хранилище определяет точный вход повторной обработки. Ключ записи храните отдельно от URL: один документ может содержать несколько записей, а несколько URL: описывать один товар. Считайте уникальные записи после применения объявленных ключа и правил проверки.
Первая приёмка сверяет разрешённую область URL с посещёнными, намеренно исключёнными и нерешёнными адресами. Вторая проверяет обязательные поля во входах, которые должны давать записи. Если загружены 3 URL и принята 1 запись, это ещё не означает ни «готова треть», ни «всё готово» без двух знаменателей. Страница-индекс может намеренно не создавать записей; неудачная загрузка товара может скрывать несколько.
Идентичность URL и идентичность записи
Дедупликация краулера отвечает, запланирована ли загрузка или достаточно ли она свежая. Дедупликация скрапера отвечает, представлена ли уже бизнес-сущность или наблюдение. Эти ключи могут различаться. /item/41 и /offers/41 могут описывать один товар, а документ /catalog: несколько. Дедупликация по URL сохранит дубли в первом случае и отбросит полезные строки во втором.
Определяйте идентичность URL с владельцем источника, а не удаляйте параметры без разбора. page может выбирать другой сегмент каталога. Язык или вариант может менять значения, нужные потребителю. Напротив, согласованный параметр только для отслеживания может не влиять на контракт загрузки. Это решения для конкретного источника; сортировка любой строки запроса или удаление всех параметров не задаёт универсальную эквивалентность.
| Решение об идентичности | Последствие для загрузки | Последствие для записей |
|---|---|---|
Сохранить значимый page | Разные сегменты остаются доступными | Пересекающимся данным всё равно нужны ключи |
| Следовать разрешённому редиректу | Хранить исходный и конечный URL | Привязать значения к реальному документу |
| Различать время наблюдений | Более поздняя загрузка: новое наблюдение | Истории может требоваться sku и время |
| Повторно разобрать сохранённый документ | Новый запрос к источнику не нужен | Другая schema_version может изменить валидацию |
В таблице текущих цен sku может быть ключом внутри объявленного источника и варианта. В истории цен перезапись всех строк с одинаковым sku уничтожит наблюдения. Укажите ключ потребителя в контракте и храните fetch_id как происхождение, а не идентификатор сущности. Тогда оператор отличит случайный дубль от варианта и намеренного более позднего наблюдения.
Совпадения селектора недостаточно
Найденный элемент .price доказывает только совпадение селектора в этом документе. Контракту нужны также числовая интерпретация, единица или валюта и правило отсутствия. Нельзя превращать 0.00 и пустую строку в одно общее ложное значение: ноль бывает допустимой суммой, а отсутствие: признаком пропущенного обязательного поля.
Задайте явные случаи проверки для реального формата. Потребитель условного каталога может требовать непустой sku, десятичный price и распознанную currency. Рекламное сообщение, диапазон или цена для участников не должны незаметно становиться обычной ценой лишь потому, что находятся в том же визуальном блоке. Определите допустимые формы и отклоняйте остальные с доступным оператору статусом разбора.
| Значение-кандидат | Вопрос экстрактора | Сохраняемый результат |
|---|---|---|
price=0.00 | Допустим ли ноль? | Корректный ноль или именованная ошибка |
price=missing | Обязательно ли поле для этого типа? | Отсутствие, а не придуманный ноль |
price=12.90; currency=USD | Допускает ли формат такую трактовку? | Типизированные сумма и валюта с происхождением |
Несколько элементов .price | Какой относится к нужному товару и типу цены? | Однозначное значение или ошибка неоднозначности |
Это проверки извлечения, даже если данные пришли из браузера. Рендеринг делает элемент доступным, но не объясняет его бизнес-смысл. Сохраните версию схемы и ссылку на отклонённый вход, чтобы проверить исправленный парсер на том же документе. Если обязательного поля нет в сохранённом входе, другой селектор его не создаст: расследование возвращается к контракту входа, а не к обещанию, что рендеринг всегда исправляет сбор.
Определите этап ошибки до замены инструмента
Если /item/42 не попал во фронтир, проверьте начальные адреса, обнаружение ссылок и правила области. Селектор цены не восстановит необнаруженную страницу. Если адрес был в очереди, но вернул HTTP 503, исследуйте загрузку и разрешённую источником политику повторов, прежде чем считать это ошибкой извлечения.
Если нужная страница есть в журнале с HTTP 200, но цена отсутствует, изучите содержимое, действительно переданное экстрактору. Это может быть другой документ, страница с необходимым рендерингом или изменившийся макет. Успешная навигация не подтверждает валидную запись. Сигналы fetch_failed и required_field_missing должны различаться: им нужны разные доказательства и нередко разные владельцы.
Возможны и корректные дублирующиеся записи. Повторная загрузка всего или добавление браузера не исправят неправильный ключ. Сначала сравните нормализованный ключ, исходный URL и идентификатор загрузки, затем определяйте, ошибочна ли дедупликация обнаружения или записей.
Завершение и повторная обработка
Пустой фронтир останавливает принятую работу, но не удостоверяет охват. Для конечного списка владельца сопоставьте каждому ожидаемому URL явный итог: загружен, намеренно исключён по согласованной области или не решён с причиной. Категории должны быть видимы. Удалить неудачный адрес из очереди без записи: значит создать видимость завершения, уничтожив свидетельство неполной загрузки.
У открытого обнаружения ссылок может не быть полного знаменателя. Тогда укажите действительные границы: разрешённые origin и пути, начальные адреса и правило обнаружения. Глубина, временное окно или намеренное исключение меняют смысл завершения. Не превращайте ограниченный результат в утверждение «собран весь сайт». Область задаёт владелец; обнаружение новой ссылки автоматически не разрешает её обход.
Отдельно принимайте документы, которые должны давать элементы. Индекс может только создавать запросы; карточка товара: несколько предложений. Потребитель одной текущей цены на sku должен сверять ожидаемые ключи, а не число строк с HTTP-ответами. Оставляйте HTTP 503 нерешённой загрузкой, не смешивая её со страницами, законно не дающими записей.
Повторная обработка: отдельный контракт. Если тело сохранено и меняется только парсер, запускайте извлечение на этом идентифицированном входе и фиксируйте новую schema_version; не называйте результат свежим наблюдением источника. Текущему значению нужна новая разрешённая загрузка со своим временем и fetch_id. Свежесть парсера и свежесть источника: разные свойства.
Передавайте оба журнала и их сверку. Владелец обхода принимает область и нерешённые загрузки, владелец данных: поля, ключи и отклонённые записи. Частичный результат можно использовать, не объявляя полным: потребитель решит, допустимы ли пробелы для его задачи, сохранив доказательства для последующего повтора или исправления парсера.
Границы сбора до первой загрузки
Проверяйте применимые robots-правила до планирования автоматических запросов. RFC 9309 прямо говорит, что эти правила не являются разрешением доступа; разделение политики robots.txt и разрешения отделяет эту проверку от технической доставки. Независимо рассмотрите условия источника и полномочия команды, включая использование данных. Название crawler или scraper не меняет это решение.
До первой загрузки запишите разрешённые origin и пути, условия остановки и обязательные поля. BotBrowser не предоставляет права сбора и не повышает лимит сайта. Завершённая очередь описывает работу, допущенную политикой команды, но не разрешает расширять её и не гарантирует исчерпывающего охвата.
Вопросы и ответы
Любой краулер является скрапером?
Нет. Аудит ссылок или доступности может загружать страницы без бизнес-полей. Конвейер способен делать обе задачи, но журнал загрузок и схема записей отвечают на разные вопросы.
Нужен ли скраперу краулер?
Нет, если он получает известный разрешённый список или сохранённое содержимое. Обнаружение становится отдельным требованием, когда входы надо найти, а не обязательной частью извлечения.
Нужен ли браузер без интерфейса?
Только если этого требует содержимое или взаимодействие. До добавления рендеринга проверьте наличие ссылок и значений в доставленном ответе. Само присутствие JavaScript где-либо на странице не доказывает такую необходимость.
Источники
- Google: обзор crawlers и fetchers
- Scrapy: архитектура и поток данных, исходный документ проекта
- RFC 9309: Robots Exclusion Protocol
- BotBrowser: начало работы
- BotBrowser: ответственное использование
Практический вывод
Объявите область URL и обязательные поля отдельными контрактами. Свяжите их через fetch_id, различайте нерешённые загрузки и невалидные записи и сверяйте оба результата перед приёмкой. Добавляйте браузер там, где входные данные подтверждают необходимость рендеринга; политику обнаружения и валидацию оставляйте именованным владельцам приложения.
Эта статья входит в руководство: Начало работы с автоматизацией браузера: карта
Похожие статьи
Как работает веб-сканер: пять этапов обхода
Начало работыHeadless-скрейпинг: что действительно меняется
Начало работыОбход сайтов: бюджет и бережная нагрузка
Начало работыСбор данных с Playwright: браузер и профиль
СетьСкрапер заблокирован: ошибки DNS, TLS, HTTP и страницы
Начало работыWeb scraping JavaScript: рендер, пагинация, скролл
Выполните ту же проверку в BotBrowser
Загрузите профиль, сохраните внутри браузера те сигналы, о которых только что прочитали, и подтвердите результат на своей машине до раскатки.