Парсинг robots.txt: правила, запреты и ошибки загрузки
Проверьте правила robots.txt перед задачей браузера: выберите группу робота, разрешите конфликты Allow и Disallow и отделите политику от HTTP-доступа.
BotBrowser Team
Нужна структурированная документация по теме Развертывание?
Эта статья относится к редакционной библиотеке. Для пошаговой настройки, справки и постоянных обновлений переходите сразу в соответствующий раздел docs.
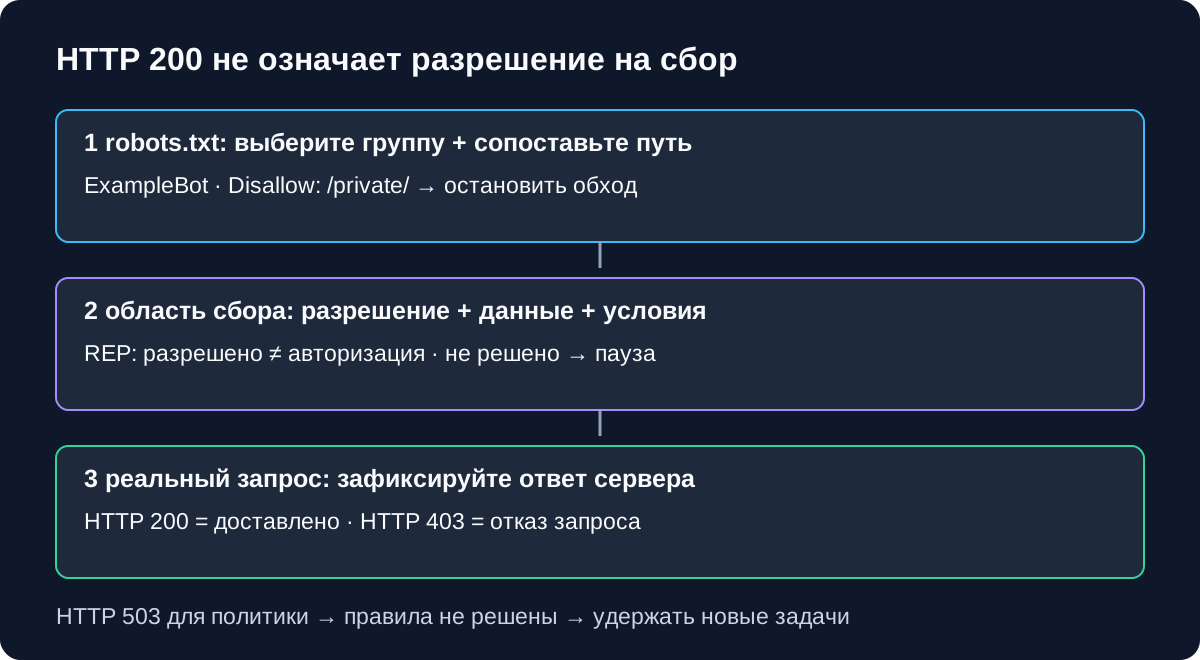
Ответ сервера HTTP 200 не решает вопрос о сборе данных по robots.txt. Сервер может отдать документ, который опубликованные правила для роботов запрещают запрашивать. BotBrowser поддерживает интеграции для автоматизации браузера, но не заменяет оценщик robots.txt в приложении и не дает разрешения собирать страницу.
Кратко
- До отправки целевого запроса оцените правила для объявленного токена продукта робота.
- Объединяйте совпавшие именованные группы; используйте
User-agent: *только если именованная группа не совпала. - Выбирайте среди совпавших правил пути наиболее специфичное, а не первое по порядку.
- Рассматривайте правило robots, разрешение на сбор и фактический HTTP-ответ как отдельные решения.
- При неразрешенном результате загрузки политики остановите новые запросы; ошибка HTTP не дает повода менять идентификатор.
Содержание
- Политика, разрешение и доставка: разные вещи
- Сначала выберите группу робота, затем URL
- Ограниченный пример сопоставления правил
- Сначала загрузите robots, затем страницу
- Закрепите решение в очереди запросов
- Практический вывод
Политика, разрешение и доставка: разные вещи
Протокол исключения роботов, RFC 9309, задает способ публикации правил для роботов владельцами сервисов. Это механизм координации: участвующий робот получает /robots.txt, выбирает применимые правила и использует их, решая, что запрашивать. Серверу не нужно обращаться к этому файлу при каждом запросе. Поэтому браузер все еще может получить HTTP 200 для документа, запрещенного правилами. Это соответствует замыслу протокола, а не доказывает, что правило перестало действовать.
В журнале инцидента нужно разделять три вопроса. Во-первых, разрешает ли применимое правило robots этот URL для объявленного робота? Во-вторых, установила ли команда надлежащие основания для сбора с учетом условий сервиса, авторизации, состава данных и применимых обязательств? В-третьих, что именно вернул сервер? Оценка правила не отвечает на второй вопрос, а успешный ответ не отвечает ни на первый, ни на второй.
| Наблюдение | Что оно подтверждает | Чего оно не подтверждает | Безопасное следующее действие |
|---|---|---|---|
Совпавшее Disallow: /private/ | Применимое правило REP запрещает совпавшие пути | Что сервер отклонит ручной запрос | Удалите эти пути из очереди обхода |
| Совпавшего правила пути нет | REP не запрещает этот URL в выбранной группе | Разрешение, лицензию на сбор или допустимую частоту | Примените отдельно утвержденную политику сбора |
| HTTP 200 для цели | Цель вернула успешный HTTP-ответ | Соблюдение robots, полноту данных или юридическое разрешение | Храните результаты проверки политики и содержимого раздельно |
| HTTP 403 для цели | Сервер отклонил этот запрос | Какое правило robots, сигнал идентичности или средство защиты вызвало отказ | Остановитесь и диагностируйте ситуацию по разрешенным данным |
Последняя строка относится к материалу диагностика блокировки скрапера по слоям: там различаются сбой DNS или соединения, HTTP-ответ и проблема данных страницы. Оценка robots происходит до запроса, а разбор инцидента объясняет результат после него. Если смешать этапы, появляются неверные формулировки вроде «robots заблокировал браузер», хотя известно лишь об HTTP 403.
RFC 9309 также предупреждает: перечисленные пути становятся публично обнаружимыми. Владелец сервиса должен защищать конфиденциальные ресурсы подходящими средствами контроля доступа; Disallow не является аутентификацией. При этом видимость пути не приглашает робота его запрашивать. Для разрешенного процесса работы с магазином границы сбора данных Shopify помогают отличить наблюдаемую страницу от данных и объема доступа, действительно нужных сборщику. Эти границы важны и после успешной проверки правила.
Сначала выберите группу робота, затем URL
Запись User-agent указывает токен продукта робота, а не полный отпечаток и не обязательно весь заголовок браузера User-Agent. RFC 9309 требует сравнивать токен продукта без учета регистра. Токен должен присутствовать в строке идентификации робота, описывающей его назначение. Выберите честный, стабильный токен для приложения сбора; не переключайтесь на именованную группу поисковой системы лишь потому, что у нее другие правила.
Рассмотрим синтетический файл на принадлежащем вам тестовом сервисе:
User-agent: *
Disallow: /catalog/

User-agent: ExampleBot
Disallow: /catalog/private/
Allow: /catalog/private/help/

User-agent: examplebot
Disallow: /exports/
Allow: /exports/public/
Для ExampleBot две именованные группы совпадают независимо от регистра токена, поэтому их правила объединяются. Группа с подстановочным знаком к именованным группам не добавляется. Для другого объявленного робота без совпавшей именованной группы применяются правила User-agent: *. Если не подходит ни именованная, ни общая группа, правила групп не применяются. Ни один из этих результатов не устанавливает разрешение на сбор сверх REP.
Это различие меняет решение для /catalog/item: общая группа запрещает этот путь, а объединенные правила ExampleBot ему не соответствуют. Для того же именованного робота /catalog/private/item совпадает с запрещающим правилом, а /catalog/private/help/start совпадает и с запрещающим, и с более длинным разрешающим. Парсер, который просто объединяет все группы, вынесет другое решение для /catalog/item. Парсер, останавливающийся на первой совпавшей именованной группе, пропустит /exports/.
Не приравнивайте токен продукта к строке браузера, которую случайно отправляет инструмент тестирования. Процесс браузера может загрузить URL, не выступая полноценным планировщиком робота. Приложение, отвечающее за обнаружение URL, загрузку политики, интерпретацию правил и отправку запросов, должно явно разделять эти обязанности. В справочнике автоматизации BotBrowser описан слой интеграции браузера; он не подтверждает, что библиотека реализовала оценку REP за вас.
Сопоставляйте сервис, а не всю организацию
Файл правил находится по пути верхнего уровня сервиса /robots.txt. Записывайте вместе с URL схему и authority: https://example.test/robots.txt не является запросом политики для каждого имени хоста, порта и протокола этой организации. Не переносите разрешающее решение с одного origin в очередь другого. Относительная навигация, поддомены и перенаправления могут менять контекст сервиса, даже если бренд на экране остается тем же.
RFC 9309 говорит, что роботы должны следовать как минимум пяти последовательным перенаправлениям robots, в том числе между authority. Если файл найден в этой цепочке, его правила действуют в контексте исходного authority. Записывайте и запрошенный URL политики, и конечный URL ответа. Иначе кэш, привязанный только к конечному месту размещения, может случайно применить правила одного сайта к очереди целей другого.
Ограниченный пример сопоставления правил
Сопоставление пути начинается с начала целевого пути. RFC 9309 выбирает наиболее специфичное совпавшее правило, измеряемое в октетах; регистр пути должен учитываться. При равенстве эквивалентных правил allow и disallow следует выбрать allow. Поэтому порядок строк не является надежным алгоритмом решения. Протокол также определяет *, завершающий $, комментарии и обработку percent-encoding, которые производственная реализация обязана учитывать.
Следующий пример Node.js изолирует только выбор группы и буквальное сопоставление префиксов ASCII. Группы уже разобраны из синтетического файла выше. Программа намеренно отклоняет подстановочные знаки, маркер конца, закодированные и не-ASCII пути, вместо того чтобы притворяться реализацией остальной части RFC 9309. Она не отправляет сетевые запросы и не проверяет политику действующего сайта. Скопируйте ее в локальный файл .mjs и запустите node для этого файла.
import assert from 'node:assert/strict';

const groups = [
  { agent: '*', rules: [['disallow', '/catalog/']] },
  {
    agent: 'ExampleBot',
    rules: [
      ['disallow', '/catalog/private/'],
      ['allow', '/catalog/private/help/'],
    ],
  },
  {
    agent: 'examplebot',
    rules: [
      ['disallow', '/exports/'],
      ['allow', '/exports/public/'],
    ],
  },
];

function literalDecision(agent, path) {
  const named = groups.filter(g => g.agent.toLowerCase() === agent.toLowerCase());
  const selected = named.length ? named : groups.filter(g => g.agent === '*');
  const rules = selected.flatMap(g => g.rules);
  for (const value of [path, ...rules.map(r => r[1])]) {
    if (!value.startsWith('/') || /[^\x20-\x7e]|[%*$?#]/.test(value)) {
      throw new Error('literal ASCII paths only');
    }
  }
  const matches = rules.filter(([, prefix]) => path.startsWith(prefix));
  matches.sort((a, b) => b[1].length - a[1].length || Number(b[0] === 'allow') - Number(a[0] === 'allow'));
  return !matches.length || matches[0][0] === 'allow';
}

const cases = [
  ['ExampleBot', '/catalog/item', true],
  ['OtherBot', '/catalog/item', false],
  ['ExampleBot', '/catalog/private/item', false],
  ['ExampleBot', '/catalog/private/help/start', true],
  ['ExampleBot', '/exports/file', false],
  ['EXAMPLEBOT', '/exports/public/file', true],
  ['ExampleBot', '/Catalog/private/item', true],
];
for (const [agent, path, allowed] of cases) {
  const actual = literalDecision(agent, path);
  assert.equal(actual, allowed, `${agent} ${path}`);
  console.log(`${agent} ${path} repAllowed=${actual}`);
}
В выводе используется метка repAllowed, чтобы результат нельзя было незаметно переименовать в «разрешено». Первые два случая показывают выбор между именованной и общей группами. Два случая с приватным каталогом показывают выбор самого длинного префикса. Случаи с exports показывают объединение групп и нечувствительность токена к регистру. В последнем случае меняется регистр URL-пути, а не токена робота. Нормализация URL, которая приводит все пути к нижнему регистру, уничтожила бы это различие и могла бы изменить список запрашиваемых ресурсов.
Ограниченный пример не разбирает загруженный текстовый файл, не объединяет несколько записей токена продукта внутри одной группы, не нормализует URI-октеты, не следует перенаправлениям, не проверяет MIME-тип, не управляет сроком кэша и не выбирает политику повторов сети. Это средство рассуждения только для показанных входных данных. Для эксплуатации выберите поддерживаемую реализацию REP, изучите поддерживаемый синтаксис и проверьте эти случаи вместе со случаями percent-encoding и */$. Успех в семи случаях ASCII не доказывает соответствие протоколу.
Пустое значение Disallow представляет еще один случай для производственного парсера, а не общее правило запрета /. В RFC 9309 поле шаблона пути может быть пустым; оно не создает осмысленный запрещенный префикс, охватывающий весь сайт. Не преобразуйте пустую строку в / при нормализации конфигурации. Аналогично неизвестная директива не должна завершать корректную группу или удалять разбираемые записи allow/disallow вокруг нее.
Сначала загрузите robots, затем страницу
Целевой запрос и запрос robots являются разными событиями. Записывайте policyStatus и targetStatus в отдельных полях. Если /robots.txt возвращает HTTP 503, загрузка политики остается неразрешенной, даже если вчера целевая страница вернула HTTP 200. Панель, сохраняющая только последний HTTP-код для имени хоста, может скрыть это различие и возобновить работу по неверной причине.
| Результат загрузки политики | Базовое требование RFC 9309 | Решение приложения для сбора |
|---|---|---|
| robots успешно загружен | Следуйте разбираемым правилам | Оцените объявленный токен и целевой URL |
| HTTP 404, файл недоступен | REP может разрешать доступ к ресурсам | Примените отдельные проверки разрешения и политики сбора |
| HTTP 401 или 403, также в диапазоне 4xx | Категория RFC для недоступного файла не означает авторизацию | Приостановитесь до явного решения о политике; не выводите согласие из ответа |
| HTTP 429 | Не считайте, что каждый робот трактует его как обычное отсутствие файла | Остановите отправку и соблюдайте указания сервиса по ограничению частоты |
| HTTP 5xx или ошибка сети | Пока файл недоступен, считайте все пути запрещенными | Удерживайте новые задачи и используйте ограниченную политику восстановления |
| Некоторые записи испорчены, но файл в целом пригоден | Используйте разбираемые правила | Сохраняйте диагностику парсера, не отбрасывая файл целиком |
Категория RFC для недоступного файла охватывает HTTP 400-499, тогда как недостижимый файл включает HTTP 500-599 и сетевые ошибки. Это различие относится к поведению робота по протоколу. Более строгие решения остановиться при HTTP 401, 403 и 429 в правом столбце являются политикой приложения, а не выдуманными требованиями RFC. Документированная обработка robots в Google также отличает HTTP 429 от большинства других ответов 4xx. Поведение Googlebot является полезной документацией поставщика, но не универсальным алгоритмом повторов для вашего сборщика.
Для кэширования нужна и временная отметка. RFC 9309 говорит, что робот не должен использовать кэшированную копию более 24 часов, за исключением случаев, когда файл недостижим. Рекомендации для недостижимого файла допускают дополнительные варианты по истечении достаточно долгого срока; 30 дней приведены как пример. Эти оговорки не оправдывают бессрочный флаг «последний раз разрешено» без времени загрузки, истории ответов или решения проверки. Если пакет возобновляется после сбоя политики, перед повторным запуском оцените оставшиеся URL по актуальным применимым правилам.
Crawl-delay не входит в определенные RFC 9309 правила allow/disallow. Некоторые реализации интерпретируют дополнительные записи, а некоторые нет. Отсутствие поддерживаемой директивы задержки не задает бюджет запросов. Отделяйте решения приложения о параллелизме и частоте от сопоставления путей; уменьшайте отправку или останавливайте ее, когда сервис сигнализирует об ограничении. Разрешающее правило пути не гарантирует приемлемую частоту нагрузки.
Закрепите решение в очереди запросов
Полезная точка интеграции: компонент, который не допускает URL до браузерной задачи. Оценивать robots после навигации для этого запроса уже поздно. Храните решение вместе с origin, токеном продукта робота, временем загрузки политики, выбранной группой, совпавшим правилом и отдельно утвержденной областью сбора. Если правила хранения это допускают, сохраните текст политики или дайджест содержимого, чтобы при разборе инцидента можно было определить, какая версия привела к решению.
Небольшая запись отправки может содержать origin, productToken, policyFetchedAt, policyStatus, matchedRule, repDecision и collectionDecision. repDecision=allow при collectionDecision=unresolved все равно удерживает задачу. repDecision=disallow удаляет ее из множества допустимых задач, даже если браузер раньше имел доступ. Сбой сети дает repDecision=unresolved, а не выдуманный пустой файл robots. Такие состояния явно задают условие остановки и не смешивают все неудачные загрузки.
При контроле очереди учитывайте и запросы, создаваемые браузером. Открытие разрешенного документа может загружать изображения, скрипты, фреймы или фоновые API-запросы. Проверка только верхнеуровневого URL сама по себе не доказывает соответствие всех автоматических подзапросов политике сбора. До отправки составьте список нужных origin ресурсов и определите разрешенную область; если процесс не может ее соблюдать, остановитесь и выберите одобренный интерфейс или более узкую задачу сбора. Не используйте разрешенную страницу как предлог для запроса запрещенных конечных точек данных.
При сборе несколькими работниками передавайте через планировщик одно решение политики для каждого origin и объявленного токена, а не позволяйте каждому работнику придумывать свой результат. Аннулируйте решения в очереди при изменении соответствующей версии политики. Если текущий файл теперь запрещает ранее поставленный в очередь путь, удалите еще не начатые задачи; не сохраняйте вчерашнее решение лишь потому, что сеанс браузера еще открыт. Это требование согласованности приложения, а не свойство профиля браузера.
Документированные интеграции автоматизации BotBrowser предоставляют браузер для разрешенной задачи. Они не превращают REP в контроль доступа, не выбирают, какое имя робота должно объявить приложение, не устанавливают разрешение на сбор и не гарантируют прием запроса адресатом. Ограничениями также остаются политика ответственного использования и юридическое уведомление. Настройки браузера и успешный запуск не заменяют неразрешенное решение на предыдущем этапе.
Вопросы и ответы
Означает ли правило robots.txt Allow, что можно собирать персональные данные?
Нет. Правило Allow разрешает протокольный выбор пути для применимого робота. Категория данных, цель, допустимый доступ, хранение и применимые обязательства остаются отдельными вопросами для ответственной команды. REP не предоставляет лицензию на использование данных, а это техническое различие не является юридической консультацией.
Не дает ли Disallow URL появиться в результатах поиска?
Не обязательно. Введение Google в robots различает обход и индексирование: запрещенный URL все еще могут обнаружить по ссылкам. Для конфиденциального документа нужна защита доступа. Запрет роботу не является надежной заменой аутентификации или универсальной инструкцией по удалению из индекса.
Можно ли повторно использовать то же решение robots после перенаправления?
Фиксируйте исходный и целевой контексты отдельно. Для перенаправления файла robots действует правило исходного authority из RFC 9309; перенаправление целевой страницы может привести к другому сервису, чья политика и область авторизации все еще требуют оценки. Не считайте, что перенаправление переносит разрешающее решение или разрешение на сбор на посторонний хост.
Почему обычный браузер может открыть запрещенный путь?
REP реализуют участвующие приложения-роботы; протокол не требует автоматически отклонять каждую навигацию браузера. HTTP-сервер все равно может отдать этот путь. Такой ответ доказывает доставку именно этому запросу, а обязанность робота следовать применимым правилам остается отдельным решением.
Источники
- RFC 9309: Robots Exclusion Protocol, особенно разделы 2.2-2.5 и 3
- Google Search Central: введение в robots.txt
- Google Search Central: интерпретация robots.txt и обработка HTTP
- Справочник согласованности автоматизации BotBrowser
- Ответственное использование BotBrowser
- Юридическое уведомление BotBrowser
Практический вывод
Начните следующее решение о сборе по robots.txt с одного объявленного токена робота, одного origin сервиса и одного целевого пути. Разрешите применимые правила отдельно от разрешения на сбор и не допускайте неразрешенные или запрещенные задачи в очередь браузера. Успешный HTTP-ответ подтверждает, что сервер отдал документ; он не заменяет предыдущие решения.
Эта статья входит в руководство: Развёртывание и выпуск браузера: операционная карта
Похожие статьи
Сбор данных Shopify: Storefront API, Ajax или браузер?
СетьСкрапер заблокирован: ошибки DNS, TLS, HTTP и страницы
РазвертываниеСбор вакансий: границы браузера
СетьЗаголовки Fetch Metadata: контекст CSRF и приватность
РазвертываниеМониторинг цен конкурентов: устройство сбора
ПлатформаSpeculation Rules: границы prefetch и prerender
Выполните ту же проверку в BotBrowser
Загрузите профиль, сохраните внутри браузера те сигналы, о которых только что прочитали, и подтвердите результат на своей машине до раскатки.