Отпечаток браузера в Scrapy: границы настроек
Различия между отпечатком запроса Scrapy и сигналами браузера, HTTP-ответом и выполненной страницей, стандартной загрузкой и браузерной интеграцией.
BotBrowser Team
Нужна структурированная документация по теме Начало работы?
Эта статья относится к редакционной библиотеке. Для пошаговой настройки, справки и постоянных обновлений переходите сразу в соответствующий раздел docs.
Стандартный HTTP-загрузчик Scrapy не имеет среды выполнения JavaScript страницы. Его отпечаток запроса, используемый для фильтрации дубликатов и кеширования ответов, отличается от отпечатка браузера, составленного из наблюдений за браузером. BotBrowser документирует поддержку поверхностей движка браузера на основе профилей, но не может добавить процесс рендеринга стандартному HTTP-загрузчику, изменить идентичность запросов планировщика Scrapy, настроить произвольные удалённые движки или гарантировать доступ. Разбор темы «отпечаток браузера в Scrapy» начинается с определения области проблемы: локальная идентичность запроса, сетевая доставка, разбор ответа или явно выбранная среда браузера.
Кратко
- Отпечаток запроса является локальным идентификатором. По умолчанию его входы относятся к методу запроса, URL и телу, а обработка дополнительных метаданных зависит от версии.
- Заголовки по умолчанию не входят в идентичность запроса. Включение выбранных заголовков меняет локальное сравнение, а не поведение API браузера.
- Загруженный HTML и DOM после выполнения страницы браузером могут содержать разные данные. Разбор встроенных данных JavaScript не выполняет страницу.
- Обработчик загрузки с браузером меняет путь выполнения. Прямая работа с браузером внутри функции обратного вызова может обходить компоненты Scrapy.
- Прежде чем менять другой компонент, диагностируйте разрешённый тестовый сценарий на соответствующей границе ответственности. Ни хеш, ни заголовок не доказывают выполнение браузера.
Содержание
- Отпечатки запросов определяют локальную эквивалентность
- Загрузчик является частью более широкого процесса
- HTTP-заголовки не создают API браузера
- Исходный ответ и выполненный DOM являются разными материалами
- Браузерная интеграция меняет ответственность за выполнение
- Классификация четырёх тестовых сбоев по доказательствам
- Практический вывод
Отпечатки запросов определяют локальную эквивалентность
Документация отпечатков запросов Scrapy представляет идентификатор для фильтрации дубликатов и кеширования ответов. Компонентам нужен компактный способ сравнения запросов по предусмотренным проектом правилам эквивалентности. Это внутреннее решение учёта. Отпечаток не становится автоматически заголовком, созданным браузером идентификатором или наблюдением, сообщённым сервером. Одинаковый локальный идентификатор двух запросов не устанавливает идентичность их сетевых обменов или возвращённых документов.
Рассмотренная реализация исходного проекта учитывает метод запроса, канонизированный URL и тело запроса. Канонизация может сделать URL с разным порядком параметров запроса эквивалентными для этой цели. Заголовки запросов по умолчанию игнорируются, а фрагменты URL обычно исключаются. Аргумент include_headers включает выбранные заголовки в вычисление; keep_fragments меняет обработку фрагментов. Ни один параметр не создаёт процесс рендеринга. Включение фрагмента в локальный ключ не выполняет код приложения, интерпретирующий этот фрагмент.
Вход тела представляет собой необработанное тело запроса, записанное в данных отпечатка реализации как шестнадцатеричное представление байтов. Оно не разбирается и не нормализуется как JSON. Поэтому два документа JSON, описывающие один объект, но различающиеся пробелами или порядком свойств, могут давать разные отпечатки запросов. И наоборот, канонизация URL может объединить различия, которые владелец приложения считает значимыми. Идентичность запроса должна соответствовать требованиям нагрузки, а не предположению, что все представления эквивалентных бизнес-данных получают один идентификатор.
Предоставленный разбор использует снимок исходного проекта e63a574c767d7a9438c21db158f605f1c44c6e6a, а не установленный или проверенный при выполнении выпуск. В этой реализации verbatim_url сохраняет URL запроса вместо канонизации, делая keep_fragments несущественным. Значение download_handler, отличающееся от схемы URL, также входит в идентичность; совпадающее со схемой значение исключается. В исходном коде участие обработчика отмечено как изменение в 2.20.0. Эти детали зависят от версии и конфигурации и не утверждают одинакового поведения всех развёрнутых установок Scrapy.
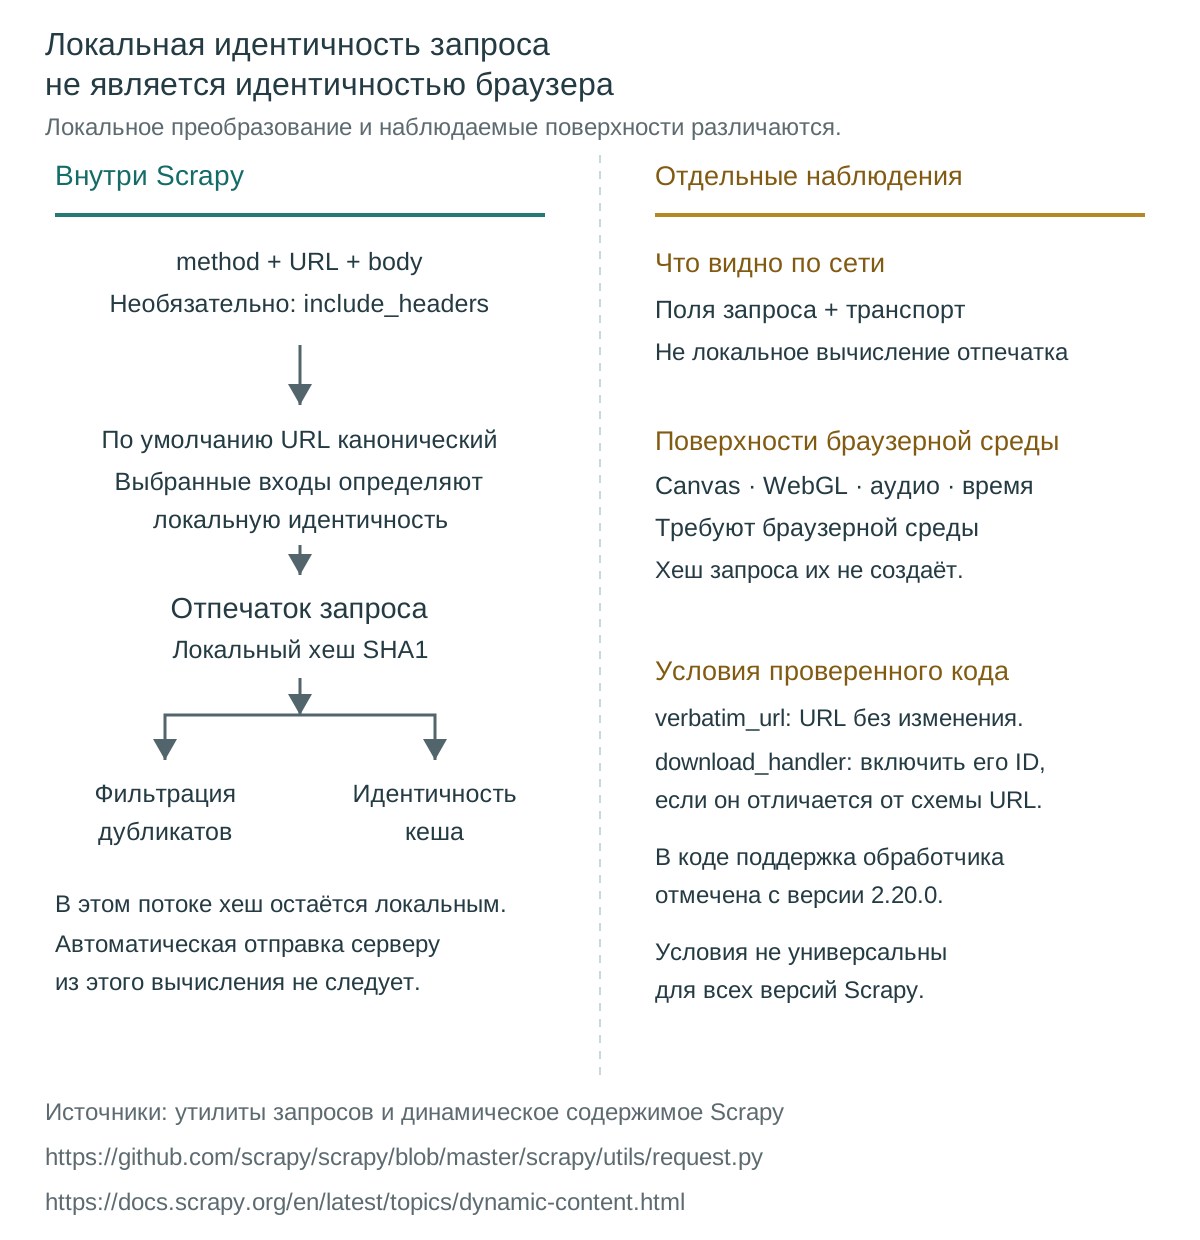
Равенство также не гарантирует семантическую идентичность ответов. Собственный каталог может менять ответ в зависимости от языка или разрешённого состояния приложения даже при совпадении метода, URL и тела. Игнорирование заголовков может быть уместным для одного обхода и неправильным для другого. Scrapy предоставляет REQUEST_FINGERPRINTER_CLASS, поскольку универсального правила сравнения не существует. Решение состоит в том, какие запросы проект намерен различать, а не какой хеш больше похож на браузерный. Ответам, зависящим от аутентификации, также нужна политика кеширования, подходящая их области; один общий ключ запроса не устанавливает безопасность повторного использования.
Загрузчик является частью более широкого процесса
Обзор архитектуры Scrapy распределяет обязанности между планировщиком, загрузчиком, пауком и конвейером элементов. Движок получает запросы от паука и передаёт их через планирование. Загрузчик получает ответы, а промежуточные обработчики загрузчика участвуют вокруг этой границы. Функции обратного вызова паука обрабатывают ответы и возвращают элементы либо дальнейшие запросы. Конвейеры элементов затем выполняют очистку, проверку и сохранение. Пустой вывод может возникнуть на нескольких этапах до сетевого запроса или после него.
Этот порядок объясняет, почему изменение заголовка запроса может не влиять на решение фильтрации дубликатов. Исключённый при планировании запрос может никогда не достичь загрузчика, исходящие поля которого разработчик намеревался изменить. Аналогично загруженный ответ может успешно попасть в функцию обратного вызова, но породить элемент, отклонённый проверкой. «Ничего не сохранилось» не определяет ни сбой загрузки, ни проблему браузера. Полезное доказательство называет последний завершённый этап и ожидаемый вход следующего.
Стандартный HTTP-путь получает содержимое ответа без выполнения скриптов страницы. Руководство Scrapy по динамическому содержимому явно различает изучение загруженного исходного содержимого и доступ к действующему DOM браузера. Эта граница не запрещает выполнение браузера через другой обработчик или интеграцию. Scrapy является фреймворком с настраиваемыми компонентами; «стандартный загрузчик не имеет процесса рендеринга» точнее, чем «Scrapy никогда не может выполнять JavaScript». Выбранный путь выполнения определяет процесс, способный произвести отрисованный документ.
Атрибуция транспорта также требует фактической конфигурации. Документация архитектуры описывает событийную сетевую работу Scrapy и её связь с Twisted, но имеют значение пользовательские обработчики и изменения версий. Нельзя приписывать каждый возможный запрос проекта Scrapy одной транспортной реализации. Прежде чем обсуждать поведение соединений, зафиксируйте установленную версию и выбранный обработчик. Поведение TLS относится к сетевой реализации и конфигурации этого обработчика, а не к названию браузера в HTTP-заголовке.
Граница конвейера остаётся полезной, даже когда ответ предоставляет браузер. Выполнение браузера может сделать поле доступным, но не устанавливает правильный выбор записи функцией обратного вызова или её принятие конвейером. Явно определяйте ожидаемый материал на каждом переходе: запланированный запрос, полученный ответ, разобранный элемент и сохранённый вывод. Это создаёт конкретное место поиска сбоя без сбора каждого документа и без смешения успешного запуска браузера с успешной проверкой данных.
HTTP-заголовки не создают API браузера
Настройка Scrapy DEFAULT_REQUEST_HEADERS предоставляет HTTP-поля через DefaultHeadersMiddleware. Эти поля описывают исходящий запрос. Значение Accept-Language может влиять на ответ собственного сервера, а поле пользовательского агента может содержать выбранную строку, но ни одно не создаёт window.navigator. Справочник Navigator MDN описывает объект, предоставляемый браузерной средой, включая userAgent и hardwareConcurrency. Их существование и значения относятся к этой среде выполнения, а не к словарю запроса Python.
Та же граница действует для графики. MDN описывает HTMLCanvasElement.toDataURL() как возврат кодированного представления изображения холста. Это не встроенный хеш идентичности устройства. Вызывающая сторона может затем обработать вывод, но это другая операция. Результат зависит от растрового изображения и запрошенного кодирования, а изображение, растровые данные которого не удовлетворяют условию чистоты происхождения, может вызвать SecurityError. Заголовок не рисует это изображение и не создаёт необходимые для чтения условия безопасности браузера.
WebGLRenderingContext.getParameter() возвращает значение, связанное с запрошенным именем параметра. Тип и смысл возвращаемого значения зависят от параметра. Название «отпечаток WebGL» скрывает, какое наблюдение фактически запрашивалось и существовал ли соответствующий контекст. Полезный браузерный тестовый сценарий называет проверяемые API и параметр. Он не предполагает одинаковых возможностей каждой среды выполнения или уникальной идентификации физического устройства одним возвращённым значением.
Аудио требует столь же точного описания. OfflineAudioContext в MDN представляет граф обработки звука, выполняющий рендеринг в AudioBuffer, а не напрямую на звуковое оборудование устройства. Поэтому автономная обработка не требует утверждения, что динамик издал звук. Вывод создают граф, запланированные изменения и среда выполнения. Ни одно HTTP-поле не заменяет это вычисление, а отсутствие среды страницы означает, что стандартный загрузчик не имеет такого наблюдения, созданного страницей, для возврата.
Время является ещё одной отдельной поверхностью. performance.now() сообщает прошедшие миллисекунды относительно performance.timeOrigin, используя монотонные часы. MDN также документирует снижение точности, включая разные условия разрешения для контекстов с межсайтовой изоляцией. Длительность запроса загрузчика измеряет другой интервал с другими часами и областью. Сопоставление длительности загрузки с отметкой времени страницы не устанавливает эквивалентное поведение времени браузера, а медленный ответ сам по себе не устанавливает проблему таймера JavaScript.
Эти API являются примерами наблюдений браузера, а не обещанием универсальной доступности или уникальной идентификации. Поддержка браузера, условия документа и политика среды выполнения могут ограничивать их. Между тем сервер всё ещё может наблюдать HTTP и активность соединений без выполнения JavaScript страницы. Обсуждение защиты отпечатка браузера объясняет поверхности конфиденциальности браузера; его область не превращает локальный ключ запроса Scrapy в эти поверхности. Ни отсутствие выполнения JavaScript, ни изменение поля запроса не устанавливают анонимность или разрешение собирать данные.
Исходный ответ и выполненный DOM являются разными материалами
Документация динамического содержимого Scrapy описывает распространённое несоответствие: данные видны в браузере, но отсутствуют для селекторов, работающих с загруженным ответом. Браузер мог выполнить скрипты, отправить дополнительные запросы и обновить документ. Селекторы ответа Scrapy работают с предоставленным им содержимым. Прежде чем менять селекторы, установите наличие нужного поля в этом входе. Селектор не может восстановить узел, которого выбранный ответ никогда не содержал.
Собственная страница также может включать нужные данные в элемент script, не размещая их в видимом HTML. Извлечение сериализованного объекта или разбор исходного JavaScript как данных не равны выполнению страницы. Scrapy документирует разбор встроенных значений отдельно от безголового браузерного выполнения. Это различие важно для происхождения: значение из исходного текста не демонстрирует инициализацию браузера, обработку событий или рендеринг. Оно устанавливает лишь наличие в выбранном тексте значения, понятого парсером.
Внешний ответ JSON является ещё одним возможным материалом. Если собственное приложение предоставляет нужную запись через разрешённую точку доступа, это представление может удовлетворить задачу без выполнения браузера. Оно также может не содержать состояния отображения, действительно нужного задаче. Сравнение отрисованной страницы и точки JSON объясняет выбор через необходимый вывод. Точка записей и снимок экрана отвечают на разные задачи, даже если происходят из одного приложения.
И наоборот, HTTP API может возвращать документ, отрисованный браузером в другой среде. Получение HTML по HTTP не доказывает, что производитель избежал выполнения JavaScript. Потребитель должен различать транспорт и производство: что пересекло соединение и какая система это создала? Контракт ответа сервиса рендеринга может предоставлять материал после выполнения, а обычный ответ исходного сервера может предоставлять исходный HTML. Ни тип содержимого, ни само использование HTTP-клиента не разрешают это различие.
Для приёмки назовите необходимое представление до выбора пути выполнения. «Содержит идентификатор товара тестового приложения в возвращённом исходном тексте», «содержит узел товара после выполнения страницы» и «возвращает корректную запись JSON» являются разными условиями. Каждому нужны собственный производитель и точка проверки. Замена одного другим может молча изменить задачу, особенно когда отображение зависит от взаимодействия или состояния приложения. Успешная загрузка устанавливает доставку материала, а не выполнение всех возможных требований рендеринга.
Браузерная интеграция меняет ответственность за выполнение
Файл README проекта scrapy-playwright описывает обработчик загрузки Scrapy, выполняющий запросы через Playwright для Python с сохранением обычного процесса Scrapy, включая планирование запросов и обработку элементов. Это явно выбранная схема с браузером. Она отличается от добавления похожих на браузерные заголовков стандартному HTTP-загрузчику, поскольку браузерную работу теперь выполняет другая среда. Фреймворк сохраняет обязанности по планированию и выводу; интеграция меняет производителя ответа, а не заменяет каждый компонент.
Рекомендации Scrapy по безголовому браузеру также отличают интеграцию от прямого использования Playwright внутри функции обратного вызова. Они предупреждают, что прямое использование в такой форме обходит большинство компонентов Scrapy, включая промежуточные обработчики и фильтрацию дубликатов, и рекомендуют scrapy-playwright для лучшей интеграции. Это различие потока управления. Нельзя предполагать, что сетевое действие, инициированное непосредственно браузерным кодом, наследует решения планировщика или поведение промежуточных обработчиков запроса, переданного Scrapy.
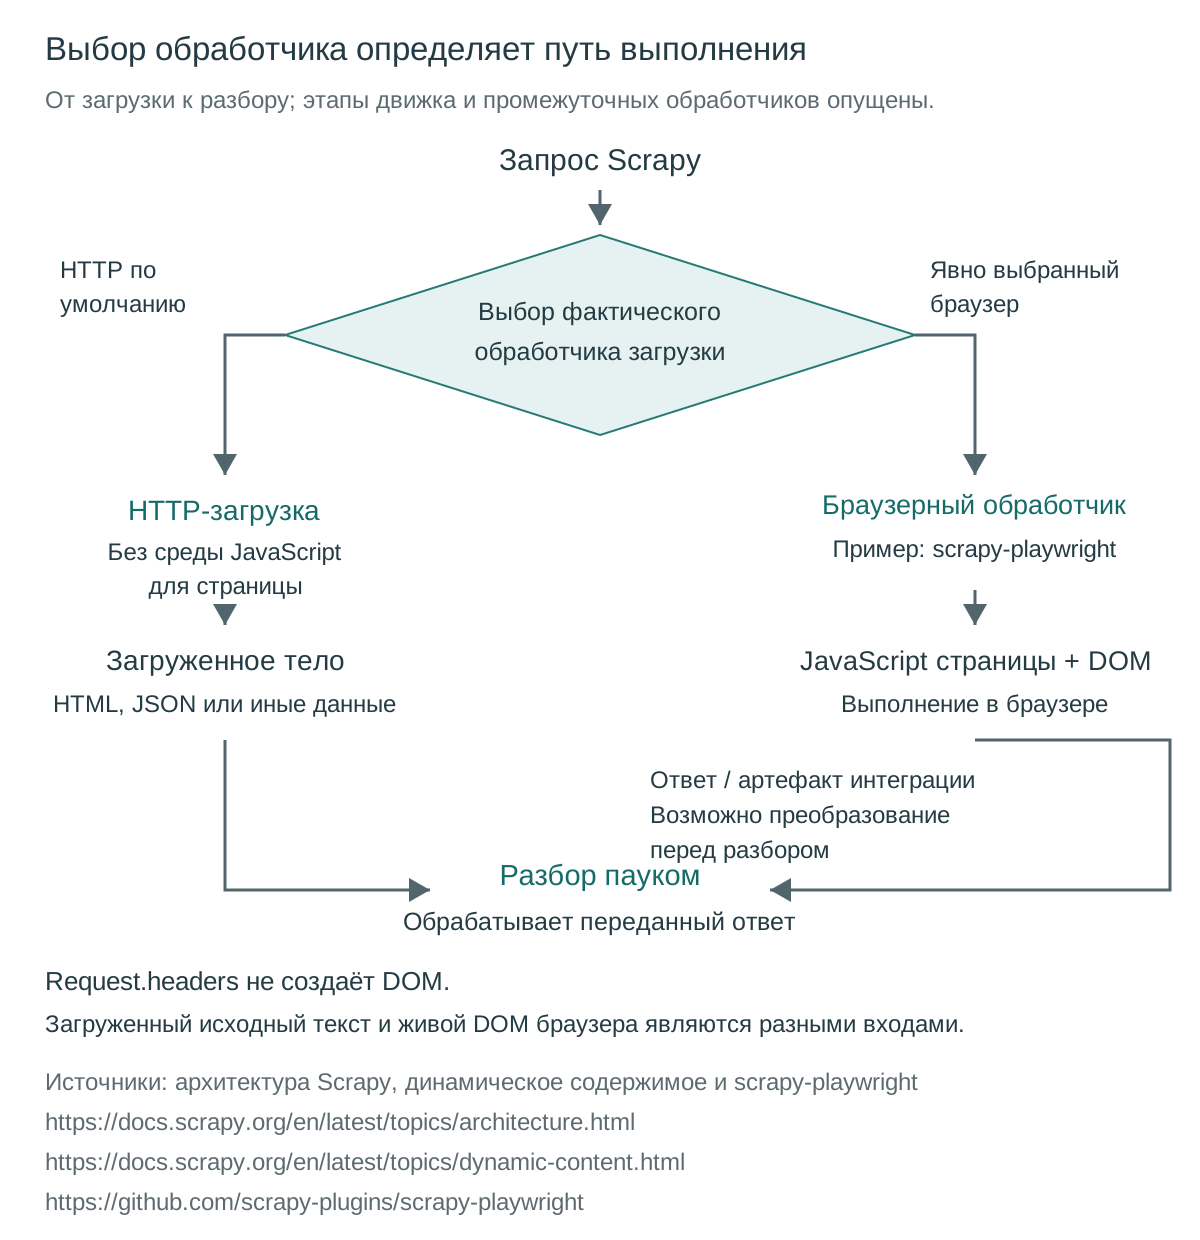
Это происхождение влияет на обоснованный охват настроек. Настройку запроса Scrapy, параметр обработчика и настройку движка браузера потребляют разные компоненты. Некоторые действия браузера могут исходить из страницы или прямой автоматизации, а не быть независимо запланированными запросами Scrapy. Определите владельца действия, прежде чем ожидать наблюдения или изменения через перехватчик фреймворка. Та же осторожность относится к удалённому браузеру: его исполняемый файл и политика провайдера остаются под фактическим контрактом конфигурации среды выполнения.
Обзор браузера BotBrowser документирует управление поверхностями движка браузера на основе профилей, включая Navigator, графику, аудио и время. Эта возможность относится к совместимо выбранной среде BotBrowser; она не может автоматически настраивать каждую интеграцию, заменять произвольный удалённый движок или менять политику отпечатков запросов Scrapy. О тестировании совместимости плагина здесь не сообщается. Выбор среды выполнения требует поддерживаемого интеграцией исполняемого файла или способа подключения, а не предположения о взаимозаменяемости движков во всех инструментах браузерной автоматизации.
Сравнение безголового режима касается режимов выполнения после появления браузерного пути. Оно не устанавливает приобретение браузера HTTP-загрузчиком лишь из-за отсутствия видимого окна. Сначала установите ответственность за браузер и необходимый материал, затем рассматривайте документированный режим и конфигурацию выбранной среды. Авторизация приложения и проверка вывода остаются независимыми требованиями на протяжении выбора.
Классификация четырёх тестовых сбоев по доказательствам
Рассмотрим гипотетическое собственное тестовое приложение каталога с двумя языковыми вариантами, исходным документом и страницей, добавляющей одно безвредное поле отображения после выполнения. Следующая матрица описывает ожидаемую классификацию, а не наблюдавшиеся результаты выполнения. Её назначение состоит в отнесении каждой задачи к компоненту, способному на неё ответить. Справочники Scrapy по идентичности запросов, архитектуре и динамическому содержимому устанавливают эти границы.
| Гипотетический случай | Ожидаемая классификация | Ответственный компонент | Минимальные полезные доказательства |
|---|---|---|---|
| Эквивалентные URL с параметрами дают только одну запланированную загрузку | Локальная эквивалентность запросов и фильтрация дубликатов | Фактический вычислитель отпечатков и фильтр дубликатов планировщика | Метод, сравнение URL без чувствительных данных, политика отпечатков и результат планирования |
| Два запроса различаются лишь заголовком локали, но требуют отдельных записей | Идентичность запроса с учётом заголовков и различия ответов сервера | Политика отпечатков, заголовки загрузчика и проверка записей | Имя выбранного заголовка, безвредное значение локали и ожидаемый язык |
| В исходном ответе нет узла, появляющегося после выполнения браузера | Происхождение материала и требование рендеринга | Парсер ответа или явно выбранный браузерный обработчик | Наличие поля в исходном тексте, выполненном DOM или разрешённом ответе данных |
| Задержку запроса принимают за измерение таймера браузера | Несоответствие области измерения | Измерительные средства загрузчика и Performance API браузера | Источник часов, измеряемый интервал и путь выполнения |
Для случая дублирующихся URL условие приёмки состоит в том, намеренно ли проект считает два запроса одной единицей. Для случая локали оно состоит в различимости обеих языковых записей при действующих политиках идентичности и проверки. Это разные задачи, даже если обе выглядят как отсутствие элемента. Само наличие двух объектов запроса в коде приложения не доказывает прохождение обоих через планирование или получение сервером двух разных запросов.
Для случая отсутствующего узла приёмка требует наличия поля в заявленном материале. Задача только с исходным текстом не должна молча становиться задачей интерактивного браузера, а задачу, требующую выполненного состояния, нельзя оценивать только по исходному тексту. Для задержки приёмка требует правильно названного интервала. Измерение загрузчика может быть полезным, не представляя точность performance.now(), время выполнения страницы или какой-либо результат API браузера. Правильная классификация предотвращает добавление среды выполнения, неспособной ответить на первоначальную задачу.
Сохраняйте только доказательства, необходимые решению: фактическую версию Scrapy, идентичность обработчика, соответствующие параметры отпечатков, характеристики запроса без чувствительных данных, тип материала и исход проверки. Не собирайте секреты, необработанные cookie или несвязанное содержимое страниц для демонстрации границ. Будущий успешный тестовый сценарий установил бы поведение для этой конфигурации и собственного приложения. Он не установил бы отпечаток сетевого рукопожатия, совместимость со всеми браузерными интеграциями или разрешение повторять работу на посторонних сайтах.
Вопросы
Передаётся ли отпечаток запроса Scrapy как идентичность браузера?
Не стандартным вычислением отпечатка. Оно предоставляет локальную идентичность запроса таким компонентам, как фильтрация дубликатов и кеширование. Сетевые наблюдения и наблюдения браузера имеют отдельных производителей.
Создаёт ли заголовок пользовательского агента свойства Navigator?
Нет. Поле запроса не создаёт window.navigator, Canvas, WebGL или граф обработки аудио. Им нужны реальная поддерживающая среда выполнения и применимые условия документа.
Выполняет ли разбор данных внутри элемента script JavaScript?
Нет. Чтение исходного текста и извлечение встроенных значений являются разбором данных. Выполнение браузера может производить дополнительные вычисления и обновления документа, которых разбор исходного текста не выполняет.
Может ли Scrapy использовать браузер, сохраняя обычный процесс?
Файл README scrapy-playwright описывает такую схему обработчика загрузки. Прямая работа Playwright внутри функции обратного вызова имеет другие границы интеграции, поэтому участие компонентов нужно устанавливать для выбранного пути.
Источники
- Scrapy: обзор архитектуры
- Scrapy: отпечатки запросов
- Scrapy: выбор динамически загружаемого содержимого
- Scrapy: настройки
- Scrapy: утилиты запросов в рассмотренном снимке исходного проекта
- scrapy-playwright: README проекта
- MDN: Navigator
- MDN: HTMLCanvasElement.toDataURL()
- MDN: WebGLRenderingContext.getParameter()
- MDN: OfflineAudioContext
- MDN: Performance.now()
- BotBrowser: обзор отпечатков браузера
Практический вывод
Классифицируйте один сбой разрешённого тестового сценария по локальной идентичности запроса, доставке загрузки, разбору ответа или выполнению браузера. Затем выберите компонент, производящий недостающее доказательство. Проверьте его фактическую версию и конфигурацию до изменения другого слоя: хеш запроса, HTTP-заголовок и среда браузера управляют разными частями работы.
Эта статья входит в руководство: Начало работы с автоматизацией браузера: карта
Похожие статьи
Браузер для веб-скрейпинга: какой вариант нужен?
Начало работыВеб-скрейпинг с Browserbase: кто за что отвечает?
Начало работыHeadless-скрейпинг: что действительно меняется
ОтпечаткиAPI веб-скрейпинга: что остаётся за рамками ответа
Начало работыКак работает веб-сканер: пять этапов обхода
ОтпечаткиClient Hints Fingerprinting: HTTP-заголовки и идентичность
Выполните ту же проверку в BotBrowser
Загрузите профиль, сохраните внутри браузера те сигналы, о которых только что прочитали, и подтвердите результат на своей машине до раскатки.