Web scraping JavaScript: рендер, пагинация, скролл
Web scraping сайта на JavaScript без данных: определите, это ошибка селектора, прямой XHR или страница с отрисовкой, затем настройте листание и прокрутку.
BotBrowser Team
Нужна структурированная документация по теме Начало работы?
Эта статья относится к редакционной библиотеке. Для пошаговой настройки, справки и постоянных обновлений переходите сразу в соответствующий раздел docs.
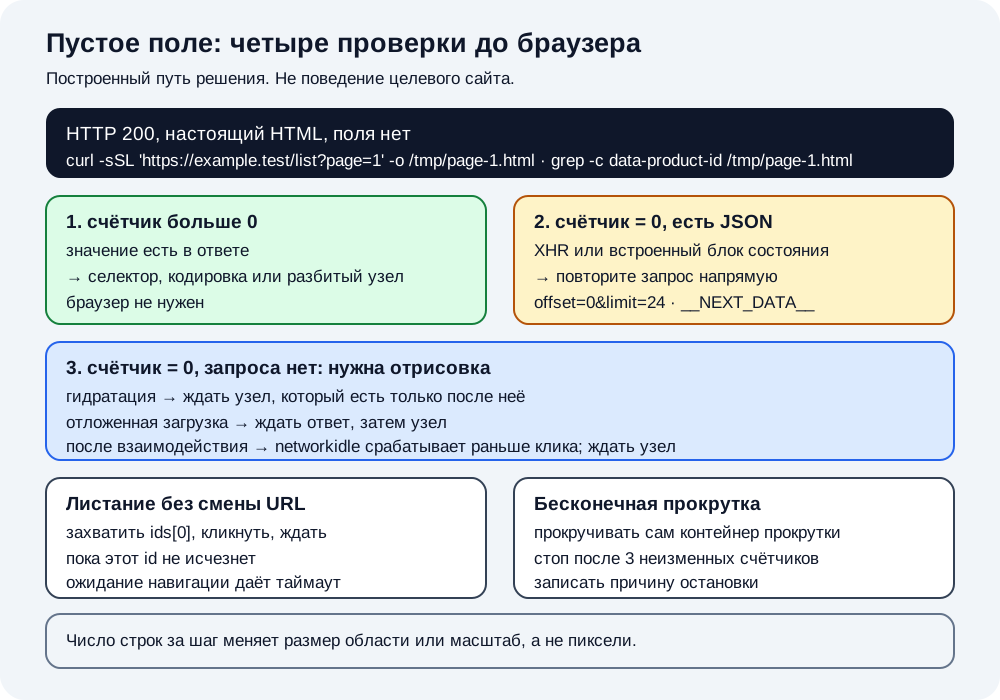
Web scraping страницы, которую рендерит JavaScript, обычно начинается с тех же трёх секунд замешательства: запрос вернул HTTP 200, HTML настоящий, а нужного поля в нём нет. Полезный следующий шаг не в том, чтобы ставить headless-браузер: значительная часть таких случаев закрывается запросом, который можно отправить самостоятельно, а браузер превращает быструю и стабильную задачу в медленную. У диагностики есть порядок, и именно этот порядок определяет ход проверки. BotBrowser предоставляет объявленную среду отрисовки для случаев, которым браузер действительно нужен, поэтому вёрстка, которую вычисляет страница, совпадает с вёрсткой, которую ожидает цель; он не гарантирует, что сторонний сайт вернёт другие данные.
TL;DR
- Читайте исходный ответ до того, как брать браузер. Если значение уже есть в
curl, проблема в селекторе, а не в отрисовке. - Если значения нет, проверьте журнал сети на запрос JSON или HTML, который его несёт; прямой вызов такого запроса обычно быстрее, дешевле и стабильнее отрисовки.
- Браузер нужен только в третьем случае, и он делится на три формы: данные, появляющиеся после гидратации, данные, которые загружает запрос, отправленный страницей после загрузки, и данные, появляющиеся только после взаимодействия. Объект состояния, сериализованный в начальный HTML, к ним не относится, потому что его можно прочитать без браузера.
- Пагинация и бесконечная прокрутка: одна задача в двух формах. Триггером служит не смена URL, поэтому цикл, ожидающий навигации, молча перечитает первую страницу.
- Останавливайтесь по сигналу, который выдаёт страница, а не по счётчику, который вы предположили. «Нет кнопки далее» и «контейнер перестал расти»: разные сигналы, и каждый может ошибаться.
Содержание
- Сначала прочитайте исходный ответ
- Найдите запрос, который несёт данные
- Когда отрисовка действительно нужна
- Пагинация без изменения URL
- Бесконечная прокрутка и правило остановки
- Практический вывод
Сначала прочитайте исходный ответ
Первое измерение стоит одной команды и снимает большую часть спора. Загрузите страницу по тому же URL и с теми же заголовками, которые отправил бы браузер, и поищите в байтах ожидаемое значение.
curl -sSL -H 'accept-language: en-US,en;q=0.9' 'https://example.test/list?page=1' -o /tmp/page-1.html
grep -c 'data-product-id' /tmp/page-1.html
Три исхода, три разные задачи. Ненулевой счётчик означает, что значение есть в ответе и виноват парсер: это ошибка селектора или кодировки, и к отрисовке она отношения не имеет. Ноль означает, что сервер прислал оболочку, и следующий шаг: выяснить, чем она заполняется. Код состояния HTTP, отличный от 200, означает ни то, ни другое, и тело ответа обычно называет причину.
Та же проверка работает в обратную сторону для поля, которое выглядит присутствующим, но разбирается неверно. Значение, пришедшее экранированным, завёрнутым в строку JSON или разбитым по двум соседним узлам, пройдёт наивную проверку подстроки и провалит строгий селектор; поэтому счётчик важнее взгляда.
Найдите запрос, который несёт данные
Когда оболочка пуста, значение обычно приходит в одно из двух мест: сетевой запрос, который страница делает после загрузки, или объект состояния, сериализованный в начальный HTML. И то и другое читается без браузера.
Для сетевого случая откройте страницу один раз в обычном браузере, отфильтруйте панель сети по XHR или fetch и найдите ответ, в теле которого есть поле. Скопируйте этот запрос как curl и сравните с запросом страницы. Различия обычно сводятся к заголовку, cookie или параметру запроса, который страница вычисляет во время выполнения, и каждое различие можно проверить.
import requests

session = requests.Session()
session.headers.update({"accept": "application/json", "accept-language": "en-US,en;q=0.9"})
listing = session.get("https://example.test/api/list?offset=0&limit=24", timeout=30)
listing.raise_for_status()
rows = listing.json()["items"]
print(len(rows), rows[0]["id"])
Для случая с состоянием поищите в исходном HTML тег script, несущий блок JSON, часто с идентификатором вроде __NEXT_DATA__, __NUXT__ или встроенным window.__STATE__. Если поле внутри этого блока, страница уже отдала данные, и парсер может прочитать их напрямую.
Две проверки решают, стоит ли сохранять прямой запрос. Повторите его дважды и сравните размеры в байтах, затем повторите из другого сетевого расположения, если этого требует нагрузка. Ответ, который меняет форму между двумя одинаковыми запросами, не является стабильным источником, и отрисованная страница этого тоже не исправит: она лишь спрячет нестабильность за более медленным конвейером.
Четвёртый исход заслуживает отдельной фразы, потому что он выглядит как отсутствующее значение, хотя им не является. Некоторые страницы отвечают на запрос по-разному в зависимости от того, кто спросил: один и тот же URL возвращает полный документ браузеру, который предъявляет правдоподобный клиент, и заглушку запросу, который не предъявляет ничего. Это не проблема отрисовки и не проблема селектора: это решение сервера, и наблюдаемое различие в том, что тело ответа само меняет форму, а не заполняется позже. Записать размер ответа и короткий хеш тела на нескольких запросах достаточно, чтобы отличить этот случай от оболочки, которая могла бы гидратироваться.
Различие важно для стоимости не меньше, чем для корректности. Задача, которая повторяет один запрос JSON на страницу, может обрабатывать сотни страниц в минуту на небольшой машине; та же задача через браузер тратит большую часть времени на запуск, навигацию и отрисовку. Выбор пути через браузер для случая, который мог закрыть прямой запрос, это самая дорогая ошибка во всём процессе, и она незаметна, потому что медленный вариант тоже работает.
Когда отрисовка действительно нужна
Третий случай реален, и именно для него существует браузер. Он тоже делится на три формы, которым нужны разные стратегии ожидания, и неверный выбор даёт классический отчёт «локально работает, в CI падает».
| Форма | Где появляются данные | Чего ждать |
|---|---|---|
| Гидратация | После запуска фреймворка и замены оболочки | Узел, который есть только в гидратированном дереве |
| Отложенная загрузка | После запроса, который страница делает после загрузки | Ответ на этот запрос, затем узел, который он заполняет |
| По взаимодействию | После клика, переключения вкладки или смены фильтра | Узел, который должно создать взаимодействие |
Ожидание networkidle не различает формы вообще. Playwright определяет его как отсутствие сетевых соединений не менее половины секунды, поэтому оно завершается на любой спокойной странице: страница, зависящая от взаимодействия, спокойна, пока никто не действует, а отложенный запрос, запланированный на более позднее срабатывание, тоже спокоен в начале ожидания. На фикстуре, которая планирует свой запрос с небольшой задержкой, ожидание завершилось раньше, чем запрос появился, и извлечение прочитало ноль строк. Фиксированная задержка покрывает все три на быстрой машине и ни одной под нагрузкой; поэтому фиксированная задержка чаще всего и становится причиной скрейпера, который проходит ревью и падает в продакшене.
from playwright.sync_api import sync_playwright

with sync_playwright() as p:
    browser = p.chromium.launch(executable_path="/path/to/botbrowser/chrome")
    context = browser.new_context(locale="en-US", timezone_id="America/New_York")
    page = context.new_page()
    page.goto("https://example.test/list", wait_until="domcontentloaded")
    page.wait_for_selector("[data-product-id]", state="attached", timeout=30_000)
    rows = page.eval_on_selector_all(
        "[data-product-id]",
        "nodes => nodes.map(n => n.getAttribute('data-product-id'))",
    )
    print(len(rows), rows[:3])
    browser.close()
Селектор в wait_for_selector должен совпадать с тем, который использует извлечение. Ожидание общего контейнера проходит, как только появляется оболочка, и извлечение затем читает ноль строк; ожидание атрибута, несущего значение, падает громко, а это и есть нужный исход.
Отрисованной странице нужно ещё решение о том, что сохранять. DOM после гидратации больше HTML, который его породил, и наивное сохранение page.content() на каждом шаге превращает прогон из 40 страниц в гигабайты почти одинаковой разметки. Сохранения извлечённых строк плюс небольшой записи о происхождении (URL, запрос, который дал данные, отметка времени, режим рендерера) достаточно, чтобы перепроверить результат, и это дёшево хранить для каждой страницы.
Такая запись о происхождении делает регрессию диагностируемой. Когда поле исчезает в следующем месяце, вопрос в том, изменилась ли страница, рендерер или запрос, и ответить может только запись, где названы все три. Прогон, который хранит лишь извлечённые строки, эти три не различает, и обычная реакция: перерисовать всё и надеяться.
Пагинация без изменения URL
Случай с параметром URL простой: увеличивайте параметр, запрашивайте снова, останавливайтесь, когда ответ повторяется или список элементов пуст. Два более сложных случая: курсор API и кнопка, которая меняет DOM на месте.
Для курсора следующий запрос требует значения из предыдущего ответа, поэтому цикл должен нести состояние, а не считать страницы. Цикл, который увеличивает page=2 против эндпоинта с курсором, вернёт либо первую страницу снова, либо ошибку, и в обоих случаях это выглядит как сбой разбора, а не как сбой пагинации.
С кнопкой сбой противоположный. URL не меняется, поэтому цикл, ожидающий события навигации, ждёт вечно или получает таймаут, а цикл, который кликает и сразу читает, получает предыдущую страницу. Надёжный шаблон: захватить значение с текущей страницы, кликнуть, затем ждать, пока это значение исчезнет.
from playwright.sync_api import TimeoutError as PlaywrightTimeoutError

def read_ids(page):
    return page.eval_on_selector_all(
        "[data-product-id]",
        "n => n.map(x => x.getAttribute('data-product-id'))",
    )

def click_and_classify(page, previous_ids, timeout_ms=15_000, poll_ms=100, end_confirm_ms=3_000):
    """Click next, then return "changed" or "end-marker", or raise.

    "end-marker" is returned only when the page's own control reports the end and
    keeps reporting it for end_confirm_ms. A control that is disabled while the
    next page loads is not an end, and an unchanged list is not proof of an end,
    so anything else raises instead of returning a completion the page never gave.
    """
    button = page.query_selector("[data-testid=next-page]")
    if button is None or button.is_disabled():
        return "end-marker"
    button.click()
    budget = timeout_ms
    marker_for = 0
    while budget > 0:
        page.wait_for_timeout(poll_ms)
        budget -= poll_ms
        if read_ids(page) != previous_ids:
            return "changed"
        button = page.query_selector("[data-testid=next-page]")
        if button is None or button.is_disabled():
            marker_for += poll_ms
            if marker_for >= end_confirm_ms:
                return "end-marker"
        else:
            # Re-enabled without repainting: the next page is still loading.
            marker_for = 0
    raise PlaywrightTimeoutError(
        f"no list change and no end marker for {end_confirm_ms} ms within {timeout_ms} ms"
    )

seen = set()
reason = "loop guard"
for _ in range(200):
    ids = read_ids(page)
    new_ids = [i for i in ids if i not in seen]
    if not new_ids:
        reason = "no new ids"
        break
    seen.update(new_ids)
    if click_and_classify(page, ids) == "end-marker":
        reason = "end marker held"
        break
print(len(seen), reason)
Правило остановки как раз и падает молча. «Нет кнопки далее» не то же самое, что «больше нет результатов»: отключённая кнопка и отсутствующая кнопка одинаково проявляются как query_selector, возвращающий None, или как is_disabled(), возвращающий истину, и их не различить, если не записать причину. Контейнер бесконечной прокрутки, который хранит скрытую кнопку далее, будет повторяться бесконечно, поэтому циклу нужен жёсткий предел в дополнение к мягкому сигналу.
Классификация это та часть, которую легко испортить, и ловушка в том, что неактивность выглядит одинаково в трёх разных ситуациях: список закончился, следующая страница ещё загружается, и клик вообще не зарегистрировался. Последняя страница часто отключает собственную кнопку вместо отрисовки нового набора, поэтому отключённый контроль считается маркером конца, а не отсутствием изменений; но страница, которая отключает свой контроль, пока запрашивает следующую страницу, создаёт то же состояние на всё время запроса. Окно подтверждения и разделяет их, и оно должно быть длиннее самого медленного перерисовывания, которое показала задача, а не самого быстрого. Это окно также является пределом метода, а не деталью: загрузка медленнее окна всё равно читается как конец, и исправление в том, чтобы измерить самое медленное перерисовывание на цели перед выбором числа, а не брать значение по умолчанию со чужой страницы. Когда не появляется ни перерисовывание, ни удержанный маркер, вызов выбрасывает исключение, потому что неизменённый список не доказывает, что список закончился, и прогон, который сообщает о завершении на таком основании, ошибается в ту сторону, которую никто не замечает: он выглядит завершённым.
Ещё одна форма постраничного вывода встречается достаточно часто, чтобы её назвать: список, который листается через отправку формы, а не через ссылку. URL может меняться, но страница перерисовывается из ответа на POST, поэтому цикл по ссылкам не находит, за чем идти. Исправление то же по принципу, что и в случае с кнопкой: отправить, затем ждать исчезновения значения из предыдущего набора результатов и записать запрос, который дал новый.
Сортировка взаимодействует со всем этим. Список, отсортированный по полю, которое меняется во время прогона, например по цене или свежести, может переупорядочиваться между страницами, что даёт дубликаты и пропуски даже при верной логике листания. Запись стабильного идентификатора для каждой строки и дедупликация по нему превращают переупорядоченный прогон в корректный набор, а не в правдоподобный с дырами.
Бесконечная прокрутка и правило остановки
Бесконечная прокрутка заменяет кнопку на сторожевой элемент. Её двигают два механизма, и падают они по-разному: слушатель прокрутки, сравнивающий scrollTop с scrollHeight, и IntersectionObserver, который срабатывает, когда сторожевой элемент попадает в видимую область. Версия с наблюдателем всегда сначала выдаёт один начальный обратный вызов, поэтому сторожевой элемент вне экрана сообщает о непересекающейся записи с ratio 0, а затем молчит, пока сторожевой элемент не войдёт в root. Поэтому скрипт, который прокручивает окно на фиксированное число пикселей, может ничего не загрузить на раскладке, где прокручивается сам контейнер, а не окно: наблюдатель продолжает сообщать, что сторожевой элемент так и не вошёл.
Надёжный цикл прокручивает элемент, который действительно владеет прокруткой, ждёт изменения числа элементов и останавливается, когда число не меняется несколько попыток подряд.
stable_rounds = 0
last_count = page.eval_on_selector_all("[data-product-id]", "n => n.length")
while stable_rounds < 3:
    count = page.eval_on_selector_all("[data-product-id]", "n => n.length")
    if count == last_count:
        stable_rounds += 1
    else:
        stable_rounds = 0
        last_count = count
    page.eval_on_selector("[data-scroll-root]", "el => el.scrollBy(0, el.clientHeight * 2)")
    page.wait_for_timeout(600)
print("rows:", last_count, "stopped after", stable_rounds, "unchanged rounds")
Три подряд неизменных раунда: эвристика, а не доказательство, и запись должна это отражать. Медленный бэкенд может дать три неизменных раунда там, где четвёртый загрузил бы ещё, поэтому счётчик должен стоять в выводе рядом с причиной остановки.
Память становится вторым пределом. Список, который вырастает за несколько тысяч строк, замедляет каждый последующий eval_on_selector_all, и страница может начать отбрасывать узлы вне экрана, а значит более позднее чтение вернёт меньше строк, чем есть на странице. Запись каждой порции на диск по мере поступления держит прогон в границах и делает частичный результат проверяемым.
Среда отрисовки меняет то, какое содержимое попадает в видимую область, и это важно ровно для одной из описанных форм. Список с ленивой загрузкой запускает наблюдатель, когда сторожевой элемент попадает в видимую область, поэтому область меньше ожидаемой целью загружает меньше за одну прокрутку, а область больше: больше. Раскладка вычисляется в пикселях CSS, поэтому один device pixel ratio не меняет число строк, помещающихся в фиксированную видимую область; число строк меняют размер видимой области CSS, уровень масштабирования или масштаб эмуляции устройства, который меняет область раскладки, а не только плотность растеризации. BotBrowser документирует и предоставляет размеры экрана и device pixel ratio из профиля среди значений, которые несёт профиль, и именно поэтому эти входные данные можно объявлять, а не считать случайными, и он не решает, нужна ли странице отрисовка, и не заставляет цель вернуть данные, которые она удерживает.
Это единственное место, где «скрейпер сломан» и «среда отрисовки отличается» выглядят снаружи одинаково. Прогон, который рано останавливается на одной машине и завершается на другой при том же коде и той же цели, обычно объясняется различием видимой области CSS, уровня масштабирования или области раскладки, а не ответом системы обнаружения; отличить помогает совместная запись видимой области и числа строк. Если видимая область идентична, а счётчики всё равно различаются, остаётся объяснение, что цель ведёт себя иначе для этой сессии, и это уже другое расследование.
Две рабочие привычки держат отрисованную задачу честной со временем. Первая: падать на извлечении с нулём строк, а не писать пустой файл; прогон, который создаёт файл с заголовками и без строк, выглядит в дашборде успешным, а прогон, который падает с исключением, похож на ошибку. Вторая: хранить одну записанную страницу на прогон, сохранённую вместе с телом ответа и извлечёнными строками, чтобы более поздний читатель мог воспроизвести разницу между тем, что прислал сервер, и тем, что дало извлечение, без повторного запуска всей задачи.
Ни одна из привычек не требует браузера. Обе становятся ценнее, когда в пути есть браузер, потому что разрыв между ответом и DOM это та часть, которая меняется без каких-либо правок кода с вашей стороны. Команда, которая записывает исходный ответ, режим рендерера и число строк для каждой страницы, может ответить на вопрос «изменилась страница или мы» одним поиском, а команда, которая записывает только строки, не может ответить вовсе.
Практический вывод
Диагностируйте до отрисовки: прочитайте исходный ответ, затем журнал сети и только потом открывайте браузер. Когда отрисовка нужна, ждите узел, который несёт значение (wait_for_selector), а не оболочку и не таймер. Для пагинации и прокрутки захватывайте значение с текущей страницы и ждите его изменения или исчезновения, и записывайте причину остановки цикла, чтобы усечённый прогон был виден как усечённый. Критерии выбора браузера описывают, как сравнивать кандидатов на таких нагрузках, а руководство по планированию пропускной способности SERP описывает, что меняется, когда тот же цикл работает в масштабе.
Последнее замечание о параллелизме, потому что он меняет логику листания сильнее, чем ожидают. Два обработчика, листающих один список, каждый увидит движущееся окно, и эндпоинт с курсором выдаст им перекрывающиеся или пропущенные срезы в зависимости от реализации. Листание: обход последовательности с состоянием, а последовательность может меняться под обходом. Безопасные формы: один обходчик на последовательность или разбитый запрос, где каждый обработчик владеет непересекающимся срезом. Запись того, какой обработчик дал какую страницу, превращает перекрытие в наблюдение, а не в загадку.
Источники
Эта статья входит в руководство: Начало работы с автоматизацией браузера: карта
Похожие статьи
Headless-скрейпинг: что действительно меняется
РазвертываниеСбор вакансий: границы браузера
Начало работыСбор данных с Playwright: браузер и профиль
РазвертываниеДанные Indeed: поля, страницы и повторные записи
Начало работыНачало работы с автоматизацией браузера: карта
Начало работыБраузер для веб-скрейпинга: шесть критериев
Выполните ту же проверку в BotBrowser
Загрузите профиль, сохраните внутри браузера те сигналы, о которых только что прочитали, и подтвердите результат на своей машине до раскатки.