Cohérence réseau du navigateur pour protéger la vie privée
La page, la route du proxy, le fuseau horaire, les paramètres régionaux et la langue doivent décrire une seule configuration. Apprenez à le valider et à répartir les cas.
BotBrowser Team
Vous voulez la documentation structurée pour Réseau ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
La vie privée dans le navigateur est souvent présentée comme un problème de JavaScript. Cette description ne couvre qu'une partie d'une session réelle. Avant qu'un script ne s'exécute, le navigateur a déjà ouvert des connexions, envoyé des en-têtes et suivi une route jusqu'à la destination. Un site peut observer le résultat de cette route comme celui de l'environnement de la page, et une équipe qui ne valide que l'un des deux ne peut pas dire si les deux concordent. BotBrowser peut garder cohérents entre eux le profil sélectionné, la route du proxy et les réglages géographiques d'un contexte contrôlé ; il ne peut pas changer ce qu'un serveur de destination ou un réseau décide de faire d'une connexion.
La cohérence réseau signifie que l'identité présentée par le navigateur dans la page et la manière dont il circule sur le réseau décrivent la même configuration. Le profil sélectionné, la route du proxy et les réglages géographiques (fuseau horaire, paramètres régionaux et langue) doivent désigner une seule configuration cohérente. Lorsque ce n'est pas le cas, l'écart est généralement auto-infligé : un profil préparé pour une région sort par une autre, ou la liste des langues suit la machine hôte au lieu de suivre la route.
Les équipes qui exécutent régulièrement les mêmes flux ont besoin d'un modèle défensif et de haut niveau : quelles couches doivent concorder, comment valider cette concordance avant et après les mises à jour, et comment décider qui est responsable d'un problème lorsqu'un cas arrive au support. Les valeurs réseau de bas niveau sont volontairement laissées de côté ici. Une pratique d'exploitation reproductible compte plus qu'une observation isolée, et elle fonctionne de la même manière quelles que soient ces valeurs.
Résumé
- Maintenez l'identité du profil, la route réseau, l'emplacement de sortie et les réglages régionaux signalés par la page en accord.
- Validez ensemble les signaux de la page et les preuves de routage après toute modification du navigateur, du profil, du proxy ou de l'hôte.
- Attribuez chaque cas à la couche qui a changé ; BotBrowser ne contrôle ni la qualité du proxy ni la politique de la destination.
Sommaire
- Pourquoi l'environnement de la page et la route réseau doivent concorder
- Les couches qu'expose une session
- Géographie, langue et heure suivent l'adresse de sortie
- Un flux de validation reproductible
- Répartir les cas de support par responsable
- Ce que BotBrowser prend en charge et où il s'arrête
- Conclusion pratique
Pourquoi l'environnement de la page et la route réseau doivent concorder
L'identité d'un navigateur parvient au site avant l'exécution de la première ligne de JavaScript de la page. La requête initiale, les en-têtes qui l'accompagnent et la route empruntée font partie de la première impression. Ensuite, l'environnement de la page ajoute d'autres informations : préférences de langue, fuseau horaire, mise en forme dépendant de la région et description des capacités. Celui qui examine les deux moitiés peut se poser une question simple : décrivent-elles le même environnement ?
Le désaccord entre les couches vient rarement d'une seule erreur spectaculaire. Il s'accumule à partir de décisions ordinaires prises à différents endroits. L'équipe d'infrastructure fait tourner l'identifiant d'un proxy, l'équipe du navigateur actualise un profil et la personne qui maintient le script d'automatisation modifie une valeur régionale par défaut. Chaque changement est raisonnable pris isolément. Ensemble, ils peuvent produire une session dont la sortie réseau se trouve dans un pays alors que la page signale une liste de langues et un fuseau horaire d'un autre. La cohérence est donc une propriété de l'ensemble de la configuration, et non d'un réglage particulier. Pour l'auditer, comparez au minimum navigator.languages, Intl.DateTimeFormat().resolvedOptions().timeZone, la valeur de locale observée, l'IP de sortie et le profil chargé par --bot-profile dans le même enregistrement.
Le trafic de production ajoute en outre des conditions qu'un test manuel isolé n'atteint jamais :
- Les sessions passent par des proxys authentifiés dont l'équipe ne maîtrise pas le comportement.
- Les profils s'exécutent sur des systèmes d'exploitation hôtes différents de la plateforme qu'ils décrivent.
- Les flux comprennent des redirections, des médias intégrés, des pages de compte et de longues chaînes de navigation.
- Plusieurs contextes d'une même instance du navigateur peuvent porter des réglages d'identité et de routage différents.
- Les mises à jour du navigateur et des profils peuvent modifier le comportement à des endroits qu'une capture d'écran ordinaire ne montre pas.
Chacune de ces conditions est un endroit où les couches peuvent diverger. Une pratique de validation qui parcourt de vrais chemins de navigation et se répète de façon planifiée détecte la dérive lorsqu'elle n'est encore qu'une question de configuration et non un incident de production.
Prenons une équipe qui vérifie périodiquement une boutique régionale. Son profil décrit une plateforme de bureau, sa route sort désormais dans un pays voisin parce que le fournisseur a rééquilibré son parc d'adresses, et le script d'automatisation transmet toujours une liste de langues figée, copiée d'un projet précédent. Toutes les pages se chargent, donc un simple test de fumée réussit. Pourtant, le fuseau horaire suit la nouvelle sortie, la liste des langues suit le script et la page de paiement affiche un contenu destiné à un troisième marché. Seule la comparaison des couches explique pourquoi le résultat a changé, et seule une exécution antérieure conservée montre quand il a changé. Un cas d'usage voisin est présenté dans Protection des empreintes pour la surveillance des prix e-commerce.
Les couches qu'expose une session
Il est utile de nommer explicitement les couches pour que toute l'équipe emploie le même vocabulaire lorsqu'elle discute d'un cas. Le tableau minimal doit conserver le champ observé et le contrôle qui le définit :
- Identité du profil : l'identité de navigateur que décrit le profil sélectionné, y compris la plateforme et la description des capacités.
- Route : le chemin, via un proxy ou direct, qui transporte la connexion, avec les identifiants et le comportement DNS qui lui sont associés.
- Emplacement de sortie : l'adresse que voit la destination, ainsi que le pays, la région et l'opérateur réseau auxquels elle correspond.
- Comportement régional : le fuseau horaire, les paramètres régionaux et les préférences de langue que la page peut lire.
- État de la version : la version du navigateur et celle du profil utilisées lors de la capture des preuves.
| Couche | Champ ou entrée à conserver | Résultat attendu |
|---|---|---|
| Page | navigator.languages, Intl.DateTimeFormat().resolvedOptions().timeZone, locale | Valeurs compatibles avec la région de l'IP de sortie |
| Route | --proxy-server ou BrowserContext({ proxyServer }) | Toutes les requêtes du contexte prennent la route assignée |
| Sortie | IP publique observée et pays GeoIP | IP et pays correspondent au proxy choisi |
| Profil | --bot-profile et version du profil | Profil et plateforme déclarés correspondent au cas testé |
L'aperçu de MDN sur les serveurs proxy et le tunneling fournit le vocabulaire de la couche de route. Un proxy direct se place entre le navigateur et la destination, un proxy inverse se place devant la destination, et un tunnel HTTP transporte une connexion à travers un intermédiaire grâce à la méthode CONNECT. Les proxys peuvent aussi ajouter des en-têtes de transfert, et un script de configuration automatique du proxy peut choisir une route pour chaque requête. Savoir lequel de ces éléments intervient indique à un relecteur quelle partie contrôle quel tronçon du chemin. La résolution DNS et les connexions en temps réel suivent aussi la route, et les documents sur la prévention des fuites DNS et la prévention des fuites WebRTC décrivent les réglages associés. Pour le volet des familles d'adresses de la même question, consultez Cohérence du proxy IPv4 et IPv6 dans un navigateur.
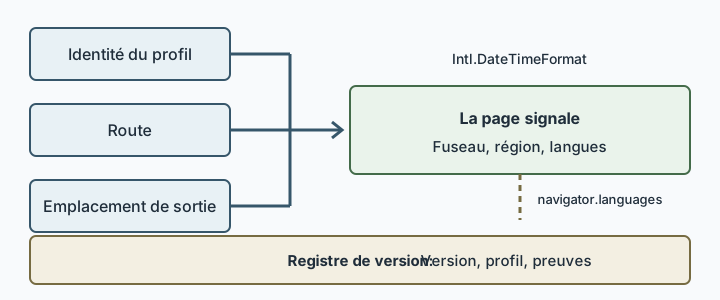
Le schéma résume l'idée. Le profil, la route et l'emplacement de sortie alimentent le comportement régional que signale la page, et un registre de version relie les preuves à une seule version. Toute flèche absente de la liste de contrôle de l'équipe indique un endroit où un écart peut se cacher.
Géographie, langue et heure suivent l'adresse de sortie
Les réglages géographiques sont l'endroit le plus visible où la route et la page se rencontrent. Une page peut lire le fuseau horaire, les paramètres régionaux et la liste ordonnée des langues du navigateur. Si ces valeurs décrivent une région que l'adresse de sortie ne décrit pas, la session contient une contradiction créée par l'équipe elle-même. Le moyen le plus simple de l'éviter consiste à dériver les valeurs de la route plutôt que de les entretenir à la main à côté d'elle.
La documentation de BotBrowser décrit cette dérivation. Au lancement, --proxy-server=... définit la route et BotBrowser peut dériver l'IP de sortie, le fuseau horaire, les paramètres régionaux et les langues avant la première page. Si l'IP est déjà connue, --proxy-ip=203.0.113.1 fournit l'entrée de géolocalisation sans recherche. Pour plusieurs identités dans un processus, browser.createBrowserContext({ proxyServer: "socks5://..." }) définit une route par contexte ; BotBrowser.setBrowserContextFlags peut alors recevoir --bot-profile=..., --proxy-server=... et --proxy-ip=.... Les deux niveaux sont pris en charge ; il faut seulement enregistrer lequel a fourni la route pour chaque contexte. Le guide Proxy et géolocalisation énumère les combinaisons prises en charge.
Chaque réglage est résolu indépendamment. Un fuseau horaire, des paramètres régionaux ou une liste de langues explicites sont prioritaires pour le réglage qu'ils définissent, tandis que les réglages laissés sur auto continuent de suivre la route. Une équipe peut donc figer les paramètres régionaux pour une exigence de reporting et laisser le fuseau horaire et les langues suivre la sortie. La décision de figer une valeur doit être consignée dans les notes de validation, car une valeur figée qui ne correspond plus à une route modifiée est une source fréquente de confusion par la suite.
Le moment compte autant que les valeurs. La dérivation géographique a lieu lorsqu'un contexte est activé ; un flux qui crée une page avant que la route et l'adresse de sortie soient établies peut donc partir d'informations incomplètes. Déclarer une IP de sortie connue supprime une recherche externe de l'activation et rend le démarrage plus prévisible, ce qui aide lorsqu'une exécution de validation crée de nombreux contextes éphémères. Lorsque l'IP de sortie n'est pas connue à l'avance, les notes de validation doivent indiquer que la valeur a été dérivée, et l'exécution doit attendre que le contexte termine sa mise à jour du proxy et de la géographie avant de naviguer.
Le routage par contexte étend la même idée à plusieurs identités dans une même instance du navigateur. Selon la documentation de BotBrowser, chaque contexte disposant de son propre proxy obtient sa propre connexion et sa propre dérivation géographique, et la fonction est indiquée pour la licence ENT Tier3. Un contexte sans route propre hérite de la route de lancement et de son identité géographique. Le guide du proxy par contexte recommande de fournir le proxy et toute déclaration --proxy-ip à la création du contexte, puis d'attendre la fin des mises à jour du proxy et de la géographie avant d'ouvrir des pages dépendantes ou de naviguer.
La dérivation géographique a des limites franches. D'après la documentation de la base GeoIP, la correspondance au niveau du pays est en général solide, celle au niveau de la ville peut être approximative et les coordonnées sont approximatives, sans précision de type GPS. Une équipe dont le flux dépend d'une précision au niveau de la ville doit définir des valeurs explicites pour ces réglages et les valider, au lieu de supposer qu'une recherche d'adresse est exacte. La qualité et les données d'enregistrement d'une adresse de sortie proviennent du fournisseur du proxy et des registres d'adresses, et aucun réglage du navigateur ne les modifie.
Un flux de validation reproductible
Un flux de validation doit être assez petit pour s'exécuter avant chaque version et assez précis pour que deux personnes parviennent à la même réponse. La séquence suivante reste de haut niveau et indépendante de toute valeur réseau de bas niveau :
- Choisissez le profil, la route et le flux qui correspondent à la production. Utilisez le même type de proxy, la même famille de système d'exploitation hôte et la même suite de pages que celles des sessions réelles.
- Consignez l'état de la version : la version du navigateur, celle du profil et les réglages qui ont été figés au lieu d'être dérivés.
- Exécutez le flux une fois et capturez le comportement de la page : si les pages se chargent, si la connexion et les médias fonctionnent, et quels fuseau horaire, paramètres régionaux et langues la page signale.
- Capturez le comportement du routage : quelle route a transporté le trafic, à quel emplacement de sortie elle correspond, et si le DNS et les fonctions en temps réel ont emprunté le chemin prévu.
- Comparez la cohérence générale des signaux. La géographie et la langue signalées par la page doivent concorder avec l'emplacement de sortie, et l'identité du profil doit concorder avec la plateforme hôte documentée. Marquez
PASSseulement sinavigator.languages[0],resolvedOptions().timeZone, la locale, le pays GeoIP et le profil attendu concordent ; sinon marquezFAILet conservez le champ divergent. - Répétez la même exécution après chaque mise à jour du navigateur ou du profil et après tout changement de fournisseur de proxy, puis conservez les deux exécutions ensemble.
La valeur réside dans la comparaison, non dans une exécution isolée. Deux exécutions qui ne diffèrent que par une seule entrée, comme la version du navigateur, indiquent à l'équipe quel changement a causé une différence. Des exécutions qui diffèrent par plusieurs entrées à la fois en apprennent très peu. C'est pourquoi la matrice des routes, des profils et des flux doit grandir lentement, et chaque entrée doit désigner un responsable qui décide quand elle devient obsolète. L'article sur la validation des versions du navigateur traite plus en détail le volet des versions de cette pratique.
Décidez à l'avance quels changements déclenchent une nouvelle exécution. Une nouvelle version du navigateur, une actualisation de profil, un changement de fournisseur de proxy ou de parc de routes, une nouvelle image du système d'exploitation hôte et une modification du script d'automatisation qui définit des options régionales ou de langue remplissent ce critère. Les changements du site de destination n'appartiennent pas à la liste, car l'équipe ne les maîtrise pas ; ils relèvent de la catégorie condition externe et se remarquent lorsqu'un flux qui passait auparavant se met à échouer. Consigner la liste des déclencheurs évite que la validation ne devienne un rituel exécuté seulement après qu'un problème est déjà survenu.
Les preuves doivent être conservées avec le dossier de version ou avec le cas de support afin qu'un lecteur ultérieur puisse répéter la comparaison. Une ligne de registre explicite évite les résumés invérifiables :
| run_id | profil / version | route et IP | signaux de page | résultat attendu |
|---|---|---|---|---|
2026-10-19-r01 | profile.enc / BotBrowser 1xx | --proxy-server=... / 203.0.113.1 | fr-FR, Europe/Paris, fr-FR | PASS si pays GeoIP=FR et les quatre champs concordent |
Parmi les autres éléments utiles :
- Une courte note indiquant le profil, l'étiquette de la route, le flux et les réglages figés.
- Les valeurs de fuseau horaire, de paramètres régionaux et de langue signalées par la page pour chaque contexte.
- L'emplacement de sortie observé pour chaque route, avec la date et la source de la recherche.
- Un résultat fonctionnel pour chaque étape du flux, noté comme réussi, échoué ou modifié.
- La version du navigateur et celle du profil pour l'exécution antérieure et pour la suivante.
Des comptes synthétiques et des destinations de test suffisent pour ce travail. Ne collectez pas plus que ce que la comparaison exige, et supprimez les captures temporaires à la fin de la période de revue. Un dossier de validation court, daté et attribué est plus utile qu'une grande archive que personne ne lit.
Répartir les cas de support par responsable
Lorsqu'une session se comporte de façon inattendue, la première question utile est de savoir qui est responsable de la cause. Examiner séparément la route et l'environnement de la page permet d'y répondre sans longue enquête. Le ticket doit inclure run_id, --bot-profile, l'entrée de proxy utilisée, l'IP de sortie et les trois valeurs de page ; la règle d'attribution devient alors vérifiable :
- Configuration du profil : le profil sélectionné, les réglages figés ou les options par contexte ne décrivent pas la configuration prévue. L'équipe du navigateur corrige la configuration et relance le flux.
- Alignement de la route : la route utilisée n'est pas celle qui était prévue, ou l'emplacement de sortie a changé après la préparation du profil. L'équipe qui gère le routage corrige l'affectation.
- Comportement du navigateur à l'exécution : la configuration et la route sont toutes deux correctes, mais la page signale quelque chose que les autres couches contredisent. C'est le cas à transmettre à l'éditeur du navigateur avec le dossier de preuves.
- Condition externe de la page : la destination a modifié son flux, un script tiers a échoué ou l'origine applique sa propre politique à la session. Ces causes sortent de la configuration du navigateur de l'équipe et doivent être étiquetées comme telles, avec
PASSpour les champs de route et de page si ceux-ci concordent.
La qualité du proxy et l'emplacement de l'IP de sortie méritent une remarque distincte. Le comportement du fournisseur, la réputation de l'adresse et la façon dont une origine traite une adresse donnée ne sont pas contrôlés par le navigateur. Un cas qui se termine par « la route fonctionne et la configuration est cohérente, mais l'origine refuse toujours la session » doit être signalé comme condition externe avec les preuves jointes, et non rouvert comme défaut du navigateur. La gestion des identifiants de la route est un sujet voisin traité dans Authentification proxy du navigateur et hygiène des identifiants.
Le tri est plus rapide lorsque la première réponse à chaque cas demande le même petit ensemble d'informations : le profil et l'état de la version, l'étiquette de la route, la géographie signalée par la page et l'emplacement de sortie observé. Les cas qui arrivent avec ces informations peuvent généralement être attribués en une seule étape. Ceux qui n'en disposent pas doivent être renvoyés pour compléter les informations plutôt qu'investigués à l'aveugle.
Un court exemple illustre le schéma. Un cas de support signale qu'un flux affiche un contenu de la mauvaise région. Le fuseau horaire était figé dans la configuration et correspond toujours à la région prévue, mais l'emplacement de sortie observé ne correspond pas. La configuration du profil est donc correcte, l'environnement de la page suit cette configuration et la couche qui a bougé est la route. Le cas va à l'équipe qui gère le routage, avec les deux exécutions jointes, et l'équipe du navigateur n'a rien à modifier.
Ce que BotBrowser prend en charge et où il s'arrête
BotBrowser prend en charge l'attribution à chaque contexte du navigateur de sa propre route de proxy (une route que l'équipe a approuvée) et dérive le fuseau horaire, les paramètres régionaux et la langue de ce contexte à partir de son IP de sortie, de sorte qu'une équipe peut répéter le même flux de profil et de route avant et après les mises à jour et vérifier si l'identité réseau et l'identité de l'environnement de la page restent alignées. Cela aide surtout lorsque plusieurs identités partagent une instance du navigateur ou lorsque les versions sont validées de façon planifiée. BotBrowser ne peut pas améliorer la qualité du fournisseur de proxy, choisir ni contrôler la réputation d'une IP de sortie, garantir qu'un site acceptera une session, ni remplacer la validation des versions et la revue des preuves de l'équipe elle-même.
La cohérence réduit les écarts qu'une équipe se crée elle-même. Elle ne décide pas de la manière dont une origine traite une session, car l'acceptation reste propre à chaque origine et à ses politiques. Considérez un résultat cohérent comme une base saine pour le diagnostic, et revérifiez les documents sur le proxy par contexte et sur la configuration du proxy, ainsi que les indications actuelles de MDN, avant de modifier les réglages de routage ou de géographie.
Sources publiques
Conclusion pratique
Avant d'exécuter un flux, comparez dans un même enregistrement son profil, sa route, son emplacement de sortie et les réglages régionaux signalés par la page. Répétez cette comparaison après chaque mise à jour pertinente et transmettez tout écart au responsable de la couche qui a changé. Considérez les contrôles de cohérence de BotBrowser comme des éléments probants du contexte du navigateur, et non comme une garantie sur la qualité du proxy ou l'acceptation par la destination.
Cet article fait partie du guide : Vue d’ensemble de la configuration proxy : carte des décisions réseau
Articles Connexes
Cohérence proxy, DNS et WebRTC pour le navigateur
RéseauConfiguration proxy du navigateur : guide SOCKS5, HTTP et HTTPS
RéseauFrontières réseau de l'entreprise : responsabilités
RéseauCohérence du proxy IPv4 et IPv6 dans un navigateur
RéseauChangement dynamique de proxy pour des contextes de navigateur séparés
RéseauProxy par contexte : attribution des routes de travail
Faites passer BotBrowser de la recherche à la production
Utilisez ces guides pour comprendre le modèle, puis passez à la validation multi-plateforme, aux contextes isolés et au déploiement navigateur prêt pour l'échelle.