Noyau axé confidentialité vs navigateur anti-détection
Comparez les noyaux de navigateur axés sur la confidentialité et les navigateurs anti-détection. Découvrez l'effet de l'architecture, des données et de la transparence.
Vous voulez la documentation structurée pour Documentation ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
Deux architectures sous une même étiquette
Si vous avez cherché un « navigateur anti-détection », vous souhaitez probablement garder plusieurs identités en ligne séparées, chacune avec ses propres caractéristiques d'appareil, ses cookies et ses réglages réseau. Le terme couvre désormais tout outil qui propose des profils de navigateur distincts, et les équipes s'en servent pour la gestion de plusieurs comptes, la vérification publicitaire, la veille tarifaire, l'assurance qualité et la recherche en confidentialité.
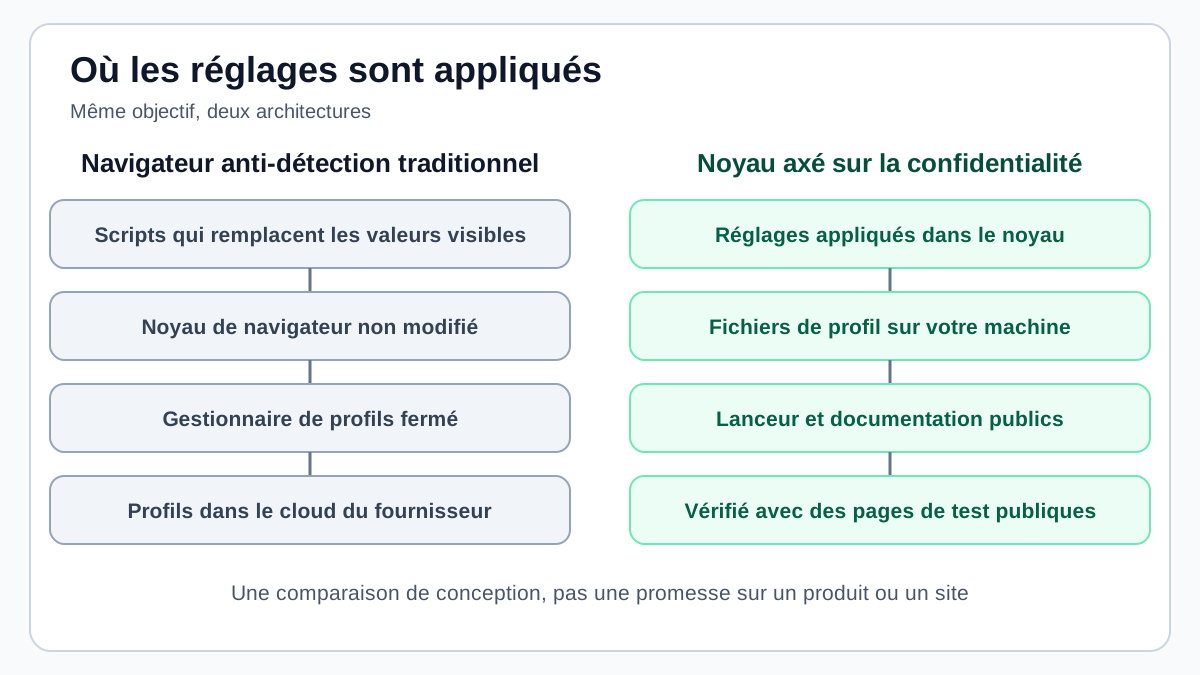
Le besoin est le même dans tous ces usages : chaque session doit être cohérente en elle-même et sans lien avec les autres. Les outils qui y répondent suivent deux architectures différentes. Les navigateurs anti-détection traditionnels enveloppent un navigateur standard et appliquent leurs réglages au-dessus. Un noyau de navigateur axé sur la confidentialité applique les réglages à l'intérieur du navigateur lui-même. Cette différence influe sur la cohérence du résultat, sur l'endroit où vivent vos données, sur ce que vous pouvez vérifier et sur la façon dont le coût augmente.
Les sections suivantes décrivent chaque architecture, les comparent selon les mêmes critères et se terminent par un énoncé clair de ce que BotBrowser couvre pour des identités séparées et de ses limites. La comparaison porte sur des choix de conception. Elle ne prétend pas qu'un produit nommé échoue, et elle ne promet pas la façon dont un site web traitera un navigateur donné.
Comment fonctionnent les navigateurs anti-détection traditionnels
La plupart des navigateurs anti-détection traditionnels partagent une même architecture. Ils enveloppent un navigateur standard, généralement Chromium, et modifient ce que voient les pages grâce à une combinaison des couches décrites ci-dessous.
Surcharges des API JavaScript
La couche la plus courante remplace les API du navigateur au niveau JavaScript. Lorsqu'une page lit une propriété comme navigator.hardwareConcurrency ou screen.width, l'enveloppe répond avec la valeur enregistrée dans le profil au lieu de celle que la machine réelle indiquerait.
Les choix d'implémentation habituels comprennent :
Object.definePropertypour remplacer un getter natif par une fonction JavaScript qui renvoie la valeur du profil- Des méthodes de prototype enveloppées, par exemple autour de
HTMLCanvasElement.prototype.toDataURL - Des scripts injectés avant l'exécution de ceux de la page, afin que les remplacements soient déjà en place
Injection de type extension
Certains outils fonctionnent comme des extensions de navigateur ou utilisent des scripts de contenu semblables. Ils s'exécutent dans le contexte de la page et modifient des propriétés liées à l'empreinte juste avant ou juste après son chargement. Cette approche est simple à distribuer, mais elle hérite des contraintes de timing et de visibilité de tout script exécuté dans la page.
Stockage des profils dans le cloud
Les outils traditionnels conservent généralement les données de profil sur les serveurs du fournisseur, y compris les cookies, les réglages d'empreinte et l'état de session. Cela facilite la collaboration, car les membres de l'équipe peuvent partager des profils et les ouvrir depuis des machines différentes.
Enveloppe à code fermé
Le navigateur sous-jacent est en général une version non modifiée de Chromium. La couche propriétaire qui gère les profils, les surcharges et l'interface est le plus souvent à code fermé, si bien que les utilisateurs ne peuvent pas inspecter la façon dont un réglage donné est appliqué.
Où l'approche traditionnelle atteint ses limites
Ces limites découlent de l'architecture. Ce sont des propriétés de la conception, pas des jugements sur la qualité d'un produit particulier.
Les surcharges laissent des traces structurelles
Lorsqu'une propriété est remplacée avec Object.defineProperty, son descripteur change. Un getter natif affiche [native code] dans la sortie de toString(), alors qu'un remplacement JavaScript affiche son propre code source. N'importe quel script exécuté dans la page peut lire cette différence.
Il en va de même pour les méthodes de prototype enveloppées. Les descripteurs de propriétés, les chaînes de prototypes, la sortie de toString() et la forme de la pile d'appels sont autant d'endroits où un remplacement peut différer de l'original natif. Une surcharge peut correspondre à la valeur que renverrait un appareil cible, mais il est plus difficile de reproduire la manière dont cette valeur est fournie.
Savoir si un site donné vérifie quoi que ce soit de tout cela est une autre question, et rien ici ne garantit un résultat dans un sens ou dans l'autre. Le point est architectural : une couche placée au-dessus du noyau du navigateur ne peut qu'imiter le comportement natif, alors qu'une couche à l'intérieur du noyau n'en a pas besoin.
Le rendu reste lié à la machine réelle
Le rendu du canvas, de WebGL et de l'audio dépend de la chaîne de rendu de la machine qui le produit. Si une enveloppe annonce une plateforme Windows alors que le rendu du canvas reflète encore celui de macOS, les deux signaux ne concordent pas.
Une surcharge peut intercepter la fonction qui lit le résultat, comme toDataURL, mais elle ne change pas ce que la chaîne de rendu a réellement produit. Les pixels sous-jacents, le comportement des shaders et le traitement audio restent liés au matériel et au système d'exploitation réels.
Le stockage dans le cloud concentre les données
Conserver les profils et les cookies de session sur les serveurs d'un fournisseur soulève plusieurs questions :
- Emplacement des données : les cookies d'authentification et l'état de session se trouvent sur une infrastructure tierce
- Continuité : si le fournisseur modifie ses conditions ou arrête le service, l'accès à vos profils peut être affecté
- Concentration : les sessions stockées de nombreux clients forment une seule cible de valeur
- Conformité : les organisations soumises à des règles de protection des données peuvent devoir déclarer le fournisseur comme sous-traitant des sessions de navigateur
Le code fermé limite l'audit
Quand la couche qui applique les réglages est fermée, les utilisateurs ne peuvent pas vérifier :
- Quelles données l'outil collecte et envoie au fournisseur
- Comment chaque réglage est implémenté
- Si les réglages couvrent tous les signaux décrits par le fournisseur
- Si le logiciel contient une collecte de données qui n'a jamais été divulguée
Pour les organisations soucieuses de sécurité, ne pas pouvoir auditer l'outil qui manipule des sessions sensibles est une vraie préoccupation. Cela ne signifie pas que l'outil se comporte mal. Cela signifie que vous vous fiez à la parole du fournisseur.
La tarification par profil augmente avec l'usage
De nombreux outils traditionnels facturent selon le nombre de profils et de postes d'équipe. Une offre peut inclure un nombre fixe de profils et quelques postes, les extras étant facturés à part. Le coût augmente alors au même rythme que l'usage, ce qui pèse surtout pour les grandes opérations.
Ce que change un noyau de navigateur axé sur la confidentialité
Un noyau de navigateur axé sur la confidentialité applique les réglages à l'intérieur du navigateur lui-même au lieu d'envelopper un navigateur non modifié. BotBrowser en est un exemple. Il modifie le code source de Chromium afin que les signaux soient produits dans le navigateur selon un profil chargé, plutôt que corrigés après coup par des scripts.
Des réglages appliqués dans le noyau du navigateur
Quand une page lit une propriété, la valeur provient de l'implémentation native du navigateur, configurée par le profil chargé. Aucun remplacement JavaScript ne s'intercale, de sorte que les descripteurs de propriétés, les chaînes de prototypes et la sortie de toString() suivent le schéma natif.
Le rendu fonctionne de la même façon. Les signaux du canvas, de WebGL et de l'audio sont produits par le navigateur selon le profil chargé au lieu d'être interceptés après coup. Les workers dédiés, partagés et de service créés dans un contexte héritent des réglages de ce contexte, si bien qu'une page et ses workers décrivent le même appareil.
Les profils restent sur votre machine
BotBrowser s'exécute sur votre propre infrastructure et ne requiert pas de service cloud BotBrowser pendant son fonctionnement. Les fichiers de profil sont des fichiers locaux qui vous appartiennent, et les cookies, l'état de session et les réglages restent sur des systèmes que vous contrôlez. La documentation d'installation précise que le navigateur peut utiliser le réseau pour la validation et la mise à jour des profils, l'authentification du proxy et la détection du fuseau horaire ou de la langue régionale, donc vérifiez vos règles de pare-feu au lieu de supposer que le navigateur est hors ligne.
- Emplacement des données : toutes les données du navigateur restent sur l'infrastructure que vous choisissez
- Continuité : les profils sont de simples fichiers locaux, ils ne dépendent donc pas d'un compte chez un fournisseur
- Exposition réduite : il n'existe pas de dépôt central de sessions clients
- Revue de conformité plus simple : aucun service cloud BotBrowser ne traite vos sessions et ne doit être déclaré
Ceci décrit où BotBrowser conserve ses données. Vos propres proxys, vos comptes et les sites que vous visitez sont des flux de données distincts que vous devez toujours gérer.
Des identités séparées dans une seule instance du navigateur
Beaucoup de configurations lancent une instance de navigateur distincte pour chaque identité, ce qui coûte de la mémoire et du temps de démarrage. La fonction d'empreinte par contexte de BotBrowser, documentée comme ENT Tier3, attribue à la place un profil, un proxy, un fuseau horaire et une langue régionale à chaque BrowserContext au sein d'une même instance. Chaque contexte garde son propre stockage, ses cookies et son état de session, et les pages d'un contexte ne peuvent ni lire ni influencer les réglages d'un autre.
L'attribution doit être faite avant la création de la première page d'un contexte, et la documentation sur l'isolation multicompte décrit la séquence exacte. Lorsqu'un proxy est défini pour un contexte, la documentation indique que BotBrowser détecte l'adresse de sortie et règle le fuseau horaire, la langue régionale et la langue de ce contexte, de sorte que ces trois valeurs concordent avec la route.
Lanceur et documentation publics
Le lanceur, les outils de profil et la documentation de BotBrowser sont publiés sur GitHub. Comme le navigateur s'exécute en local, vous pouvez examiner son comportement avec des pages publiques de test d'empreinte et surveiller son activité réseau avec vos propres outils de supervision.
- Résultat vérifiable : testez ce que voient les pages avec des outils publics au lieu de vous fier au résumé d'un fournisseur
- Lanceur inspectable : le code source du lanceur est disponible sur GitHub
- Comportement réseau observable : capturez le trafic vous-même pour confirmer à quoi le navigateur se connecte
- Revue par la communauté : les tickets et les questions passent par le dépôt public
Tarification selon le volume de profils et la capacité
Les offres de BotBrowser sont tarifées selon le volume de profils et le niveau de capacité. Elles ne facturent ni par navigateur, ni par poste, ni par lancement, et l'usage en exécution est illimité sur toutes les offres. Une courte offre de validation existe pour l'évaluation, et les volumes de profils plus importants ainsi que les fonctions de déploiement se trouvent dans les niveaux supérieurs. Consultez la page des tarifs en vigueur avant d'établir un budget, car les niveaux et les limites évoluent.
Choisir entre les deux
Le tableau résume en quoi les deux architectures diffèrent sur les points qui décident le plus souvent d'un achat ou du choix d'un outil interne.
| Dimension | Navigateur anti-détection traditionnel | Noyau axé sur la confidentialité (BotBrowser) |
|---|---|---|
| Où les réglages s'appliquent | Surcharges JavaScript sur un navigateur standard | Code source de Chromium modifié |
| Descripteurs de propriétés | Des fonctions JavaScript remplacent les getters natifs | Des getters natifs lisent les valeurs du profil |
| Canvas, WebGL et audio | Interception des API, rendu réel inchangé | Produits par le navigateur selon le profil |
| Fuseau horaire et langue régionale | Dépend du fournisseur, souvent réglés à la main par profil | Documentés comme déduits de l'adresse de sortie du proxy de chaque contexte, sauf si vous les définissez |
| Workers | Peuvent nécessiter un traitement séparé | Héritent des réglages de leur contexte |
| Stockage des profils | Généralement le cloud du fournisseur | Fichiers locaux qui vous appartiennent |
| Visibilité du code | Généralement une enveloppe fermée | Lanceur et documentation publics sur GitHub |
| Vérification | Surtout des déclarations du fournisseur | Pages de test publiques et votre propre surveillance réseau |
| Tarification | Souvent par profil et par poste | Selon le volume de profils et le niveau de capacité, avec un usage illimité |
| Profils multiplateformes | Variable selon le fournisseur | Documenté : les profils Windows, macOS et Android fonctionnent sur des hôtes Windows, macOS et Linux, les hôtes Linux nécessitant ENT Tier1 |
| Collaboration d'équipe et interface graphique | Généralement un point fort, avec partage cloud et création graphique de profils | Les profils sont des fichiers locaux, le partage relève donc de votre propre processus |
| Isolation par contexte | Variable selon le fournisseur | Profil, proxy, fuseau horaire et langue régionale distincts par BrowserContext, documenté comme ENT Tier3 |
Les outils traditionnels peuvent suffire quand
- La gestion basique de plusieurs comptes est l'objectif et que les plateformes concernées analysent peu les empreintes
- La collaboration d'équipe, comme le partage de profils et l'accès par rôles, est essentielle et que le stockage cloud est acceptable
- La simplicité compte plus que la profondeur, et qu'un créateur de profils graphique convient à votre façon de travailler
- Un faible volume ou un usage de courte durée garde les coûts par profil gérables
Un noyau axé sur la confidentialité convient mieux quand
- La cohérence en profondeur compte, y compris les descripteurs de propriétés, les contextes de workers et le rendu
- L'emplacement des données compte et que les sessions, cookies et réglages doivent rester sur votre propre infrastructure
- La vérification compte et que vous voulez tester les affirmations avec des outils publics
- Le volume est élevé et que la tarification par profil dominerait le coût
- La cohérence multiplateforme est nécessaire, par exemple des sessions avec profil Windows sur des serveurs Linux (voir profils de navigateur multiplateformes)
- L'automatisation avec Playwright ou Puppeteer est un usage principal
- La reproductibilité compte pour les tests, la recherche ou l'intégration continue
Chercheurs en confidentialité et équipes de sécurité
Si votre travail consiste à étudier le fonctionnement de la collecte d'empreintes, à tester les défenses d'une plateforme que vous êtes autorisé à tester ou à analyser le comportement de pistage, un noyau exécuté en local avec un lanceur et une documentation publics vous donne le contrôle et un moyen de vérifier vos propres résultats. Le contexte présenté dans qu'est-ce que l'empreinte de navigateur explique quels signaux sont concernés.
Mener une courte évaluation
Un court pilote en apprend plus qu'un tableau de fonctions. Notez les flux de travail qui comptent pour vous avant de commencer, afin que le résultat ne dépende pas de l'outil qui paraît le meilleur le premier jour.
- Flux de travail : choisissez deux ou trois tâches réelles, comme un test de qualité sur un site de préproduction, une session de recherche en confidentialité ou une revue de comptes autorisée, et exécutez les mêmes tâches dans chaque outil
- Isolation : ouvrez deux identités en même temps et vérifiez que les cookies et le stockage local ne se transmettent pas, puisque Playwright documente les contextes de navigateur comme des environnements isolés avec leur propre stockage
- Cohérence : comparez ce que rapportent les pages de test avec l'appareil que le profil est censé décrire, et vérifiez que la langue, le fuseau horaire et l'emplacement du proxy concordent entre eux
- Emplacement des données : notez où sont écrits les profils, les cookies et les journaux, et quels serveurs l'outil contacte pendant son fonctionnement
- Exploitation : relevez comment les profils sont sauvegardés, comment un collègue en reçoit un et comment l'outil se comporte après une mise à jour du navigateur
- Coût à votre échelle : chiffrez l'offre pour le nombre de profils et de personnes que vous prévoyez dans un an, pas pour l'essai
Conservez les notes de chaque exécution. Après une mise à jour du navigateur ou de l'outil, répéter la même courte exécution montre ce qui a changé, et les notes permettent à un collègue de suivre comment le choix a été fait.
Ce qu'il faut vérifier vous-même
Quel que soit le type d'outil choisi, vérifiez au lieu de vous fier à une liste de fonctions :
- Exécutez des pages publiques de test d'empreinte et comparez les résultats avec l'appareil décrit par le profil, comme expliqué dans comment vérifier l'empreinte d'un navigateur
- Surveillez le trafic réseau pendant une session pour confirmer quels serveurs le navigateur contacte
- Lisez le dépôt public et la documentation pour voir ce qui est documenté et ce qui ne l'est pas
- Répétez les tests après chaque mise à jour du navigateur, car les résultats évoluent avec les navigateurs
Questions courantes
Peut-on distinguer un navigateur anti-détection d'un navigateur standard ? Les surcharges d'API peuvent laisser des traces structurelles, comme des descripteurs de propriétés non natifs, des chaînes de prototypes modifiées et un désaccord entre les valeurs visibles par les scripts et le rendu. Qu'un site donné les recherche ou non échappe au contrôle de tous, il faut donc y voir une propriété de conception et non une prédiction.
Le stockage des profils dans le cloud est-il sûr ? Cela dépend des pratiques de sécurité du fournisseur, que vous ne pouvez généralement pas auditer. Le stockage local supprime la copie chez un tiers, mais vous rend aussi responsable de la sécurité de la machine, de la sauvegarde des profils et de leur partage sûr avec vos collègues.
Puis-je utiliser un noyau axé sur la confidentialité pour du travail multicompte ? Oui, pour des tests autorisés, l'assurance qualité, la recherche et la gestion de comptes autorisée. Le guide sur l'isolation de navigateur multicompte montre comment des contextes séparés gardent les identités distinctes.
Le stockage local remplace-t-il l'hygiène des comptes ? Non. Des profils séparés ne corrigent ni les mots de passe réutilisés, ni les e-mails de récupération partagés, ni un proxy utilisé par beaucoup d'autres personnes.
Ce que BotBrowser couvre pour des identités séparées
BotBrowser permet d'attribuer un profil d'empreinte indépendant, une configuration de proxy, un fuseau horaire et une langue régionale à chaque BrowserContext au sein d'une même instance du navigateur, et les profils restent des fichiers locaux. Pour une équipe qui mène des tests ou des recherches autorisés, cela signifie que des identités séparées peuvent fonctionner côte à côte sans qu'un cloud de fournisseur détienne les données de session. BotBrowser ne peut pas garantir qu'une plateforme acceptera un compte, lui fera confiance ou s'abstiendra de le réviser, il ne remplace ni la qualité de vos propres proxys, ni l'hygiène de vos identifiants, ni vos obligations de conformité, et l'isolation par contexte n'est pas disponible en dehors de la licence ENT Tier3 documentée.
Utilisez-le pour un travail que vous êtes autorisé à faire, comme l'assurance qualité, la recherche en confidentialité et les opérations multicomptes autorisées. Il ne sert pas à s'affranchir des conditions d'une plateforme ni de ses politiques de comptes.
Sources publiques
Articles Connexes
Faites passer BotBrowser de la recherche à la production
Utilisez ces guides pour comprendre le modèle, puis passez à la validation multi-plateforme, aux contextes isolés et au déploiement navigateur prêt pour l'échelle.