Por qué una señal rara no condena a un navegador
Una sonda sobre un conjunto público de reglas: una señal de entorno con peso 0.7 no condena, mientras una contradicción entre capas basta por sí sola.
BotBrowser Team
Quieres la documentación estructurada de Huella digital?
Este artículo forma parte de la biblioteca editorial. Para pasos de configuración, material de referencia y actualizaciones continuas, entra en la sección de docs.
BotBrowser permite reproducir un fixture del mismo origen autorizado bajo un perfil declarado y guardar un registro acotado de qué señales expuso una página, pero no puede hacer que una señal de entorno pese más de lo que el conjunto de reglas permite, no puede convertir una señal corroborante en una condenatoria, ni puede impedir que una contradicción del lado de la red decida el veredicto antes de que la página termine de cargar. Esta revisión lee un conjunto público de reglas como datos, reproduce su aritmética de puntuación y registra qué categorías pueden condenar, por qué una señal con peso 0.7 se queda por debajo del veredicto por sí sola, qué hace una regla de artefacto más a esas mismas señales, y cómo una sola contradicción entre capas cruza la línea de condena por sí misma.
Resumen
- El conjunto tiene 126 reglas en siete categorías, y solo tres pueden condenar:
coherence,automationyartifact. Las otras cuatro solo corroboran. - Una página puede activar 95 de las 126 reglas, lo que significa que las 31 reglas de red y reputación nunca se ejecutan en una comprobación del lado del navegador.
- Una señal de entorno con peso 0.7 puntúa 0.7 y queda en
suspicious, porque una regla de entorno no puede condenar por muy pesada que sea. - Dos señales de entorno juntas puntúan 0.865 y siguen en
suspicious, lo que muestra que quien sostiene la línea es la compuerta de categoría y no la aritmética. - Añadir una regla de artefacto a esas dos señales produce 0.96 y
bot, con los pesos de entorno intactos. - Una señal de automatización con peso 0.9 condena por sí sola, así que una página que filtra
navigator.webdriverno tiene margen alguno. - Solo 14 de las 126 reglas abarcan más de una capa, y son las que ven su peso amplificado: 0.7 pasa a 1.0.
- La puntuación no depende del orden en que se listen las reglas, así que un registro debe nombrar cuáles se activaron en lugar de cuántas.
Contenido
- Qué categorías pueden condenar
- Por qué una señal de entorno pesada se queda a medio camino
- Dónde está realmente la línea de condena
- Cuánto vale una contradicción entre capas
- Registrar una lectura de veredicto
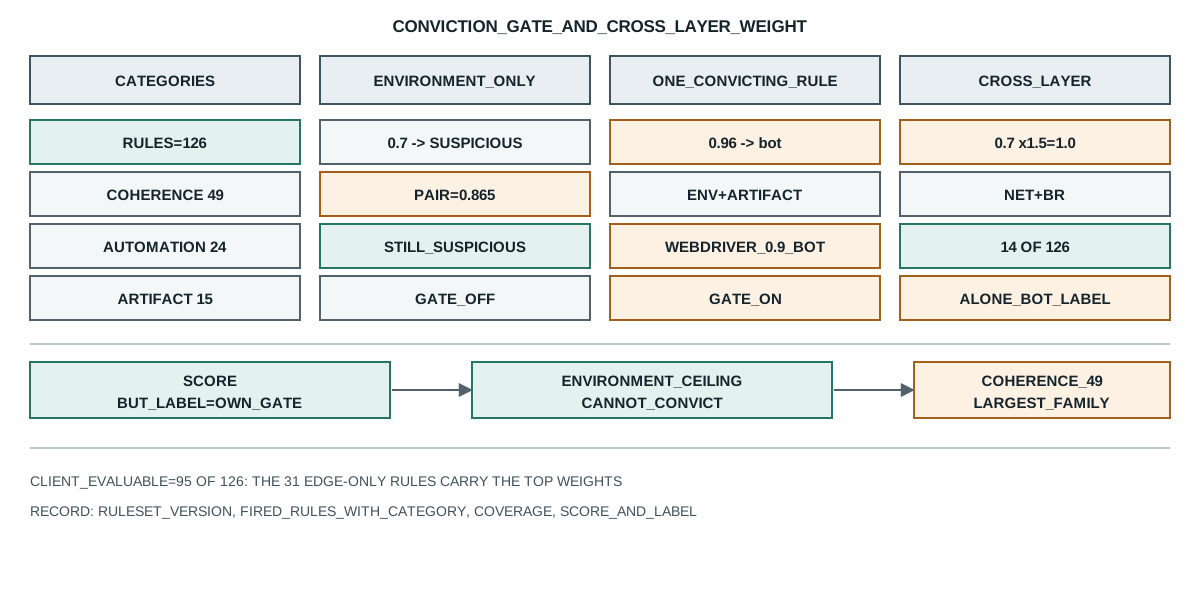
Qué categorías pueden condenar
Un detector basado en reglas es una lista de afirmaciones sobre un visitante, y cada una lleva un peso y una categoría, y la categoría decide qué puede hacer una regla activada. El conjunto que lee la sonda tiene 126 reglas en siete categorías:
categories -> coherence=49 automation=24 artifact=15 behavioral=7 reputation=4 environment=26 prevalence=1
convicting -> coherence,automation,artifact (others corroborate only)
Tres categorías pueden condenar y las otras cuatro solo suman a la puntuación. Ese reparto es todo el diseño. Una regla environment describe una superficie que parece delgada, como una lista de plugins corta, una lista de voces ausente o una concurrencia de hardware muy por debajo de la capacidad de la máquina. Esas superficies son realmente delgadas en muchos visitantes legítimos: una imagen de estación de trabajo recortada, una compilación empresarial bloqueada, un navegador sin dispositivo de audio. Tratar una como prueba etiquetaría mal a esos visitantes, así que el conjunto las deja subir la puntuación y se detiene ahí. Una biblioteca de detección que nombra sus propios componentes hace la misma distinción: registro de detectores y estados de componentes de BotD registra cómo un detector con nombre informa lo observado en lugar de una sola puntuación.
La categoría behavioral funciona igual. Una página estática que un lector solo mira producen poca entrada o ninguna, así que una regla sobre entropía de pulsaciones o trayectoria del puntero no distingue a una persona que lee de un controlador que no inyectó nada. El conjunto marca esas señales como corroborantes por la misma razón.
Una regla de automation es distinta en naturaleza. Que navigator.webdriver sea verdadero, que el estado Runtime.enable de CDP sea visible o que el user agent lleve un testigo de modo sin cabeza describe algo que una sesión normal de navegación no hace. No son superficies delgadas que los visitantes legítimos a veces tengan; son estados a los que un navegador solo llega cuando un controlador lo maneja. Por eso el conjunto puede dejarlas condenar.
artifact cubre el caso en que la página se contradice a sí misma: una función nativa cuyo texto fuente no es el del motor, un Worker que informa valores distintos a los de la página principal, un lienzo que incumple su propia invariante. Cada uno es una inconsistencia interna y no una superficie delgada, y por eso puede condenar.
coherence es la categoría de dos capas en desacuerdo, y es la mayor con 49 reglas. Un saludo TLS que implica un sistema operativo mientras el user agent afirma otro es una contradicción entre lo que dice la conexión y lo que dice la página. Ningún visitante legítimo produce eso, porque ambas capas las genera el mismo cliente.
Por qué una señal de entorno pesada se queda a medio camino
Lo interesante es qué hace la compuerta con una regla de entorno pesada. La sonda toma cuatro señales de entorno y puntúa cada una por separado:
alone:br.webgl_not_angle -> weight=0.55 category=environment score=0.55 verdict=suspicious
alone:br.font_linux_leak -> weight=0.7 category=environment score=0.7 verdict=suspicious
alone:br.screen_zero -> weight=0.7 category=environment score=0.7 verdict=suspicious
alone:br.voices_empty -> weight=0.5 category=environment score=0.5 verdict=suspicious
Las reglas de peso 0.7 cruzan la línea de sospecha en 0.35 y se detienen en 0.7, solo por debajo de la línea de condena en 0.65 porque la compuerta se niega. Leídos solos, los números parecen un hallazgo fuerte; leída la categoría, es una superficie que puede ser simplemente delgada.
Esa distinción importa cuando un equipo lee un informe que dice «sospechoso». Una etiqueta de sospecha por una señal de entorno está diciendo que la página pareció inusual de una forma concreta y nombrada. No está diciendo que la página fuera automatizada, y un informe que imprime la puntuación sin la categoría invita justo a esa mala lectura. Un 0.7 no es «70% del camino a una condena»; es una observación corroborante que llegó al techo que su categoría permite.
La misma sonda muestra que apilar señales de entorno no lo arregla:
environment-pair -> weights=0.55+0.7 score=0.865 verdict=suspicious convicting=false
Dos reglas de entorno se combinan en 0.865 por la fórmula de noisy-or, muy por encima de 0.65, y el veredicto sigue siendo suspicious. El convicting=false impreso es la razón: ninguna regla activada está en una categoría condenatoria, así que la puntuación puede subir y la etiqueta no puede cambiar. Es una decisión de diseño deliberada, y la que los equipos suelen malinterpretar cuando suponen que un número mayor implica una conclusión más fuerte.
La consecuencia práctica es sobre dónde gastar esfuerzo. Si un despliegue solo lo marcan señales de entorno, endurecer las superficies que esas reglas describen es una batalla perdida, porque las reglas están hechas para aceptar entornos delgados como normales. El esfuerzo corresponde a las categorías condenatorias: mantener limpios navigator.webdriver y el estado de CDP, y hacer que cada realm informe los mismos valores.
Dónde está realmente la línea de condena
La sonda añade una regla de una categoría condenatoria a esas dos señales de entorno y el veredicto se invierte:
plus-artifact -> score=0.96 verdict=bot convicting=true categories=environment,environment,artifact
Nada de las señales de entorno cambió. Las dos reglas que puntuaban 0.865 siguen puntuando igual, y añadir una tercera lleva el total a 0.96 y la etiqueta a bot, porque convicting ahora es verdadero. Los pesos de entorno nunca fueron el factor decisivo; lo fue la presencia de una regla de una categoría condenatoria.
Los casos de una sola señal dicen lo mismo desde el otro lado:
alone:br.webdriver_present -> weight=0.9 category=automation score=0.9 verdict=bot
alone:br.cdp_runtime_enabled -> weight=0.85 category=automation score=0.85 verdict=bot
alone:br.ch_he_headless -> weight=0.85 category=automation score=0.85 verdict=bot
Cada una condena por sí sola, con un peso cercano a 1 pero por debajo. No hay margen: una página que filtra navigator.webdriver queda condenada por una señal, y el único camino de vuelta es no filtrarlo. Esa asimetría es intencional, porque el conjunto trata un estado de automatización como un hecho categórico y no como una pista probabilística.
Apilar más señales corroborantes encima sube la puntuación sin cambiar la etiqueta:
stack -> one=0.9 two=0.955 three=0.987
Tres señales llevan la puntuación a 0.987, y el veredicto ya era bot con una. Un informe que muestra 0.99 para una página con tres hallazgos y 0.9 para una con uno sugiere una diferencia de confianza que el conjunto no hace: ambas están condenadas, y las señales extra casi no aportan a la decisión. La puntuación resume cuántas reglas se activaron, y la etiqueta es una compuerta aparte.
Cuánto vale una contradicción entre capas
La última pieza es la amplificación aplicada a las reglas que abarcan capas:
cross-layer rules -> 14 of 126
amplify:net.tls_vs_ua_browser -> layers=network+browser weight=0.7 effective=1
amplify:net.h2_vs_ua_browser -> layers=network+browser weight=0.6 effective=0.9
amplify:net.datacenter_origin_proxied -> layers=network+browser+reputation weight=0.8 effective=1
Catorce de las 126 reglas nombran más de una capa, y cada una tiene su peso multiplicado por 1.5, con techo en 1. Una regla de 0.7 pasa a 1.0 y una de 0.6 pasa a 0.9. La amplificación es el conjunto enunciando su tesis en aritmética: una contradicción entre dos capas generadas de forma independiente vale más que una lectura fuerte de una sola capa, porque un mismo cliente genera ambas y no puede hacerlas discrepar a propósito con facilidad.
Una regla entre capas condena por sí sola:
amplify-alone:net.tls_vs_ua_browser -> score=1 verdict=bot
Una regla, una puntuación de 1, un veredicto bot. No hace falta apilar, porque la categoría de la regla es coherence y su peso amplificado ya alcanza el tope de la escala. Es la forma que un equipo debería temer más: una sola configuración errónea, en la que la ruta de red implica un sistema operativo y el perfil afirma otro, produce una condena a partir de una observación.
Eso también explica por qué importa la cifra de cobertura del lado del navegador:
coverage -> clientEvaluable=95 of 126, edge-only=31
layer:network -> rules=28 clientEvaluable=0
layer:reputation -> rules=4 clientEvaluable=0
Toda regla de red es de solo borde, así que una página que carga un script detector en un navegador nunca puede ejercitar las reglas entre capas que llevan los pesos efectivos más altos. Un equipo que valida un perfil cargando el detector en el navegador comprobó 95 reglas y dejó intactas las 31 que pueden condenar desde una observación. Las dos mitades responden preguntas distintas, y una ejecución limpia del lado del navegador no es evidencia sobre el borde. Cuando el encabezado y el valor que informa la página discrepan, el contraste usa dos fuentes que produce el mismo cliente, y client hints y el límite de 500 caracteres describe ese contraste. La superficie de cabeceras que lee un analizador es uno de los valores del lado del navegador que compara una regla de coherencia, y client hints y el límite de 500 caracteres lo registra en detalle.
La última línea descarta un atajo:
order-free -> forward=0.887 reverse=0.887 same=true
Las mismas tres reglas puntúan igual en cualquier orden, porque la combinación es un producto sobre pesos y no una secuencia. Un informe no puede decirte qué regla importó mostrando solo la puntuación, y la única forma de saberlo es nombrar las reglas activadas, sus categorías y sus capas. Un recuento de hallazgos es la forma menos informativa de esos mismos datos.
Registrar una lectura de veredicto
Una lectura de veredicto sostiene una afirmación acotada: esta versión del conjunto, estas reglas activadas, produjeron esta puntuación y esta etiqueta. Cuatro campos la mantienen verificable:
- La versión del conjunto y su resumen, porque una actualización puede cambiar un peso, una categoría o el conjunto condenatorio, y las mismas señales puntuarían distinto.
- Las reglas activadas con su categoría y sus capas, porque la etiqueta depende de si alguna puede condenar, y la puntuación lo esconde.
- El límite de cobertura, porque una ejecución del lado del navegador nunca ve las reglas de solo borde que llevan los pesos efectivos más altos.
- La puntuación y la etiqueta juntas, porque un 0.99 con señales corroborantes y un 0.9 con una señal condenatoria son el mismo veredicto, y un informe que imprime solo la puntuación insinúa una certeza que la compuerta nunca concedió.
Fuentes públicas
- MDN: Navigator.webdriver
- MDN: WebGLRenderingContext.getParameter()
- RFC 8446: TLS 1.3
- RFC 9113: HTTP/2
- BotBrowser: referencia de consistencia de automatización
Conclusión
Lee el veredicto de un detector por regla y categoría, no por puntuación: el 0.7 de una regla de entorno y el 0.7 de una regla de automatización son el mismo número y hallazgos completamente distintos. Trata una etiqueta de sospecha construida solo con señales de entorno como la descripción de una superficie delgada, y dedica el endurecimiento a las categorías condenatorias, donde una sola filtración decide el veredicto. Recuerda que una ejecución del lado del navegador cubre las reglas que una página puede evaluar y deja las reglas entre capas, cuyo peso se amplifica hasta el tope de la escala, enteramente fuera de la vista, así que un resultado limpio dentro de la página no dice nada sobre la conexión que usó el cliente. La mecánica de puntuación de este análisis se lee junto a la lectura señal por señal de funciones nativas sustituidas y qué ve una lista de toString, y la consistencia entre realms que evita que una regla coherence se dispare está en integridad de API entre realms.
Este artículo forma parte de la guía: ¿Qué es la huella digital del navegador?
Artículos Relacionados
BotD: qué detectores se ejecutan de verdad
Huella digitalua-parser-js: Client Hints, bots y un tope de 500
Huella digital¿Qué es la huella de fuentes? Coherencia de texto entre plataformas
Huella digitalCombinadores Promise: qué falla y qué nunca se asienta
Huella digitalDevice Memory API y rendimiento web: pistas de memoria seguras
Huella digital¿Qué es la huella digital del navegador?
Lleva BotBrowser de la investigación a producción
Usa estas guías para entender el modelo y después avanzar hacia validación multiplataforma, contextos aislados y despliegue de navegador preparado para escalar.