Funciones nativas sustituidas y qué ve una lista de toString
Una sonda sobre APIs sustituidas: qué atrapa una lista de formas nativas, qué descriptores siguen delatando el parche y por qué un Proxy o una función enlazada pasan como nativas.
BotBrowser Team
Quieres la documentación estructurada de Huella digital?
Este artículo forma parte de la biblioteca editorial. Para pasos de configuración, material de referencia y actualizaciones continuas, entra en la sección de docs.
BotBrowser permite reproducir un fixture del mismo origen autorizado bajo un perfil declarado y guardar un registro acotado de qué APIs leyó una página, pero no puede esconder una sustitución hecha en JavaScript de un detector de mentiras, no puede hacer que un envoltorio Proxy imprima el código de la función envuelta, ni puede cambiar lo que Function.prototype.toString reporta para una función que el motor sigue considerando nativa. Esta revisión reproduce el conjunto de comprobaciones que corre una biblioteca de huellas de código abierto, lo aplica a diez casos fijos y registra qué sustituciones atrapa la lista blanca, qué descriptores siguen delatando el parche, y los dos envoltorios que salen limpios aunque la página sí cambió el valor que recibe el lector.
Resumen
- Una nativa intacta pasa todas las comprobaciones, así que la sonda imprime
control:Math.random -> cleany lo mismo paraArray.prototype.mapyFunction.prototype.toString. - Sustituir
Math.randompor una función normal deja una sola marca:naive:replaced Math.random -> failed toString, porque el texto fuente ya no tiene la forma de código nativo. - Ponerle un
toStringfalso a esa función no lo arregla: la sonda imprimefailed toString | failed toString toString | extra own keys: toString, así que el parche ahora se delata de tres formas en lugar de una. - Una función que devuelve
0.42sigue mostrando su cuerpo cuando el detector llama altoStringreal a través de una referencia enlazada, así queclone:fnToString-callimprime el código de la página y el caso del clon sigue marcado. - Un
Proxyque interceptaapplypasa toda la batería, así queproxy:Math.random -> cleanmientras el valor que recibe la página es el de la trampa. - Una función enlazada también pasa, porque la sonda imprime
bind:fnToString -> function () { [native code] }ybind:checks -> clean. - Una nativa limpia y una sustituida difieren en exactamente una marca en el camino barato, así que
separation -> cleanFlags=0 patchedFlags=1es todo el margen que tiene la detección. - El propio host puede producir una marca que no es una sustitución de la página: la sonda imprime
getter:checks -> failed toString hostShape=truepara un getter nativo cuyo código es un cuerpo de implementación.
Contenido
- Qué acepta la lista blanca
- Qué deja atrás una sustitución simple
- Qué sigue filtrando un toString falso
- Los dos envoltorios que la lista no ve
- Registrar una lectura de detección de mentiras
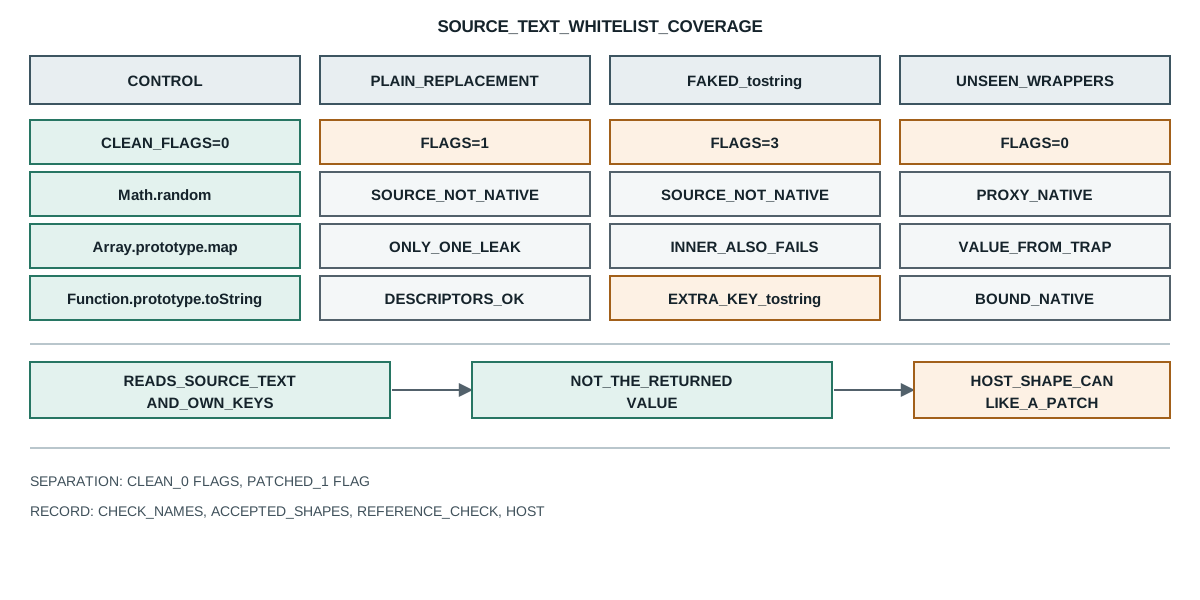
Qué acepta la lista blanca
La comprobación de integridad más barata del mundo del fingerprinting lee el texto fuente de cada función de API y lo compara contra un conjunto fijo de formas que el motor puede producir. Una biblioteca de huellas de código abierto publica exactamente esa lista en su módulo de detección de mentiras, y las formas son lo bastante cortas para escribirlas tal cual:
// las tres formas que acepta la lista, con NAME como el nombre del API
`function ${name}() { [native code] }``function get ${name}() { [native code] }`;
('function () { [native code] }');
Una comprobación que lee el texto fuente no puede ver un valor que calcula un envoltorio, y origen aleatorio de crypto-js y entropía de la biblioteca registra el mismo límite para una función de biblioteca cuya salida se lee en lugar de su código. Cada una de esas tres aparece también en una forma partida en líneas, con saltos de línea y cuatro espacios antes de [native code], que es lo que emiten algunos motores. Cualquier cosa fuera de ese conjunto se registra como una mentira contra el nombre del API, y el informe agrupa las mentiras por el API al que pertenecen.
La comprobación corre el Function.prototype.toString real sobre la función, y después lo corre otra vez sobre el toString del propio valor. Esa segunda llamada es la parte que importa, porque una página que reemplaza el toString de una función tiene que reemplazarlo también en el toString del reemplazo, y toda la cadena tiene que concordar. Una página que solo parchea el nivel externo la atrapa la comprobación interna.
Los casos de control de la sonda confirman que la lista blanca no se dispara con nativas intactas. control:Math.random -> clean, control:Array.prototype.map -> clean y control:Function.prototype.toString -> clean salen sin marcas. Eso importa para la lectura: un detector que se disparara con el control sería inútil, así que las tres líneas de control son la prueba de que el resto de las marcas significan algo.
El control también fija qué está midiendo la lista blanca. No está midiendo si la función se comporta bien, y no está comparando el comportamiento contra una referencia. Lee una cadena por función y compara esa cadena contra un conjunto fijo. Una página cuya función sustituida devolviera exactamente lo que la nativa habría devuelto igual falla la comprobación, porque el texto fuente es distinto; una página cuyo envoltorio devuelve algo completamente distinto puede pasar, como muestra la última sección, siempre que el envoltorio sea una forma que el propio motor imprime.
Qué deja atrás una sustitución simple
El primer parche que escribe una página es el más llano: asignar una función nueva sobre la propiedad. La sonda hace exactamente eso con Math.random y corre la batería:
naive:replaced Math.random -> failed toString
separation -> cleanFlags=0 patchedFlags=1
Una marca, y es la del código fuente. El código de la sustitución es function random() { return 0.42; }, que no coincide con ninguna de las seis formas aceptadas, así que se registra. Todas las demás comprobaciones pasan, porque la sustitución es una función normal con el length y el name habituales y sin claves extra. Toda la detección descansa en esa única comparación de cadenas, y la última línea de la sonda lo dice directamente: una nativa limpia produce cero marcas y una sustituida produce una.
Ese margen de una marca tiene una consecuencia práctica para quien lee un informe. Una lista que dice random: failed toString está diciendo una cosa concreta, que el texto fuente no tenía la forma del motor. No está diciendo qué hace ahora la función, cuándo se parcheó, ni si el parche cambió algún valor. Un informe que solo imprime la cuenta de mentiras esconde qué comprobación se disparó, y la comprobación es donde vive la evidencia.
El margen también hace que el orden de las comprobaciones importe para el lector. Si la comprobación de código fuente fuera la única, una página podría limpiarla parcheando el toString de la función, que es el caso siguiente. Como el detector también lee el conjunto de descriptores y las claves propias, ese segundo parche le cuesta a la página más marcas de las que ahorra. La batería está diseñada para que el arreglo más barato agrande el informe, no lo reduzca.
Hay un caso legítimo que la comprobación simple de código fuente malinterpreta, y la sonda lo encuentra en el propio host y no en una página. Una línea lee un getter nativo e imprime getter:checks -> failed toString hostShape=true, porque el código del accesor es un cuerpo de implementación con campos privados en lugar de la forma get native() { [native code] } del navegador. Esa marca describe el host donde corrió la sonda, no una sustitución de la página. Un detector que tratara cada marca como prueba de manipulación condenaría un host que nunca parcheó nada, y por eso un informe tiene que decir qué entorno produjo las marcas.
Qué sigue filtrando un toString falso
La respuesta obvia a la comprobación de código fuente es darle a la sustitución un toString que devuelva la forma aceptada. La sonda hace eso y obtiene tres marcas en lugar de una:
fake-tostring:Math.random -> failed toString | failed toString toString | extra own keys: toString
fake-tostring:inner -> failed toString
La primera marca sigue siendo failed toString, y vale la pena seguir la razón. El detector llama a Function.prototype.toString sobre la función, no al toString propio de la función, así que lee el texto fuente real sin importar lo que diga la propiedad. Una página que define toString sobre la función cambia lo que devuelve fn.toString() pero no lo que devuelve Function.prototype.toString.call(fn), y el detector usa la segunda forma.
La segunda marca es la comprobación interna. El detector lee también el código del toString propio de la función, y el falso de la página para eso es otra función de la página cuyo código tampoco tiene la forma aceptada. Así que el parche que iba a silenciar la primera marca crea una segunda marca en el valor que instaló.
La tercera marca es la comprobación de claves propias. Una función nativa real expone exactamente length y name como claves propias, y a veces prototype. Añadir una propiedad toString hace aparecer una tercera clave propia, y la sonda imprime extra own keys: toString por ella. Así que el parche es visible desde la lista de propiedades incluso para un lector que nunca mire texto fuente.
Las tres marcas juntas son la razón por la que el arreglo barato es un mal negocio. Una página empieza con una marca, parchea toString para quitarla y termina con tres. Un detector que publique los nombres de sus comprobaciones dejaría a la página ver que el arreglo empeora el informe, y el siguiente movimiento de la página sería dejar de parchear y cambiar la propiedad de otra forma, que es donde empieza la sección siguiente.
El caso del clon de la sonda prueba una versión más cuidadosa de la misma idea, enlazando el Function.prototype.toString real a la función real e instalando la referencia enlazada como el toString del clon. La línea clone:fnToString-call imprime el cuerpo del clon, function random() { return 0.42; }, así que el enlace no lleva el texto fuente del objetivo a la llamada. El clon sigue marcado en failed toString y otra vez en extra own keys: toString, que es el mismo par que produjo un parche simple, con el trabajo extra sin comprar nada.
Los dos envoltorios que la lista no ve
Dos formas pasan toda la batería mientras siguen cambiando el valor que recibe una página, y la sonda registra ambas.
La primera es un Proxy que intercepta apply. La sonda envuelve el Math.random real en un proxy cuya trampa devuelve 0.42, asigna el proxy y corre las comprobaciones:
proxy:Math.random -> clean
Ninguna marca. La llamada a Function.prototype.toString del proxy se reenvía al objetivo, que es la nativa intacta, así que el texto fuente tiene la forma aceptada. El proxy no tiene un toString propio, así que la comprobación interna lee también la forma nativa. Y las claves propias del objetivo del proxy son las de la nativa, así que la comprobación de claves propias pasa. Cada señal que lee la batería describe el objetivo, mientras el valor que recibe la página viene de la trampa.
Los descriptores que sí cambian cuando una página redefine una propiedad son los mismos que discute orden de claves de objeto. Fíjate en que esto es un proxy sobre una nativa invocable, y el artículo anterior sobre trampas de proxy e invariantes cubre lo que el motor exige para esa forma. Las invariantes limitan lo que un proxy puede reportar sobre las propiedades de un objetivo, y ninguna limita el valor que devuelve una trampa apply. Por eso el proxy es invisible a una comprobación de código y descriptores: no hay nada incoherente que atrapar, porque el proxy es un envoltorio legal y coherente alrededor de la nativa.
La segunda forma es una función enlazada. La sonda enlaza Math.random sin argumentos y corre las comprobaciones:
bind:fnToString -> function () { [native code] }
bind:checks -> clean
Una función enlazada la crea el propio motor, así que su texto fuente tiene la forma aceptada function () { [native code] }, y lleva el conjunto de claves propias de la nativa. Una página puede por tanto tomar cualquier nativa, enlazarla, y obtener un valor que pasa una comprobación de integridad que solo lea código y descriptores. Que el enlace cambie el comportamiento depende del objetivo: enlazar Math.random a un this no hace nada, pero enlazar un método que lee this a un proxy o a un receptor construido sí cambia lo que ve quien llama.
El comportamiento de un enlace depende de qué lee la función enlazada, y trampas de proxy e invariantes muestra qué comprueba el motor cuando el receptor es un proxy. Los dos puntos ciegos comparten causa, que es que la batería lee hechos estáticos sobre un objeto función y la página controla lo que de verdad recibe quien llama. Una comprobación que quiera cerrar ambos tiene que comparar un valor devuelto contra una referencia que la página no pueda alcanzar, no solo leer el texto de la función. Esa es la diferencia entre una comprobación de integridad estática y una de comportamiento, y un informe que solo corre la mitad estática lo dice solo si nombra la comprobación que corrió.
Registrar una lectura de detección de mentiras
Una lectura de detección de mentiras sostiene una afirmación acotada: este detector, estas comprobaciones, este entorno, produjeron estas marcas. Cuatro campos la mantienen verificable:
- Los nombres de las comprobaciones que se dispararon, no solo una cuenta, porque
failed toStringyextra own keysdescriben ediciones distintas y solo el nombre dice cuál. - Las formas de código aceptadas, porque la lista blanca es un conjunto fijo y un informe sin él no se puede volver a correr en otro motor que imprima una forma que el conjunto omite.
- Si el valor se comparó contra una referencia, porque una comprobación estática deja pasar un
Proxyy una función enlazada mientras una de comportamiento puede no hacerlo. - El host que produjo las marcas, porque un accesor nativo puede imprimir un cuerpo de implementación que parece un parche de la página, y una lectura sin el host no distingue los dos.
Fuentes públicas
- MDN: Function.prototype.toString()
- ECMAScript: Function.prototype.toString
- ECMAScript: OwnPropertyKeys
- MDN: Proxy
- MDN: Function.prototype.bind()
- BotBrowser: referencia de consistencia de automatización
Conclusión
Lee un informe de mentiras por nombre de comprobación, porque la cuenta sola no distingue una sustitución simple de un toString falso o de una tercera clave propia. Espera que un Proxy y una función enlazada pasen una comprobación de código y descriptores, ya que ambos son formas creadas por el motor alrededor de una nativa intacta, y trata un resultado limpio de esa comprobación como «el texto fuente parece nativo» y no como «el valor es el de la nativa». Los dos artículos anteriores sobre trampas de proxy e invariantes y sobre orden de claves de objeto cubren la mecánica de la que depende la comprobación de claves, y el registro debe nombrar siempre las comprobaciones que corrieron y el host que produjo las marcas, porque un accesor nativo puede imprimir un cuerpo que parece exactamente un parche.
Este artículo forma parte de la guía: ¿Qué es la huella digital del navegador?
Artículos Relacionados
Fuente aleatoria de crypto-js: qué rama usa tu build
Huella digitalObservabilidad de aleatoriedad criptográfica y huellas del navegador
Huella digitalBotD: qué detectores se ejecutan de verdad
Huella digitalFingerprinting de la Network Information API: revisión de política
Huella digitalWeakMap y WeakSet: qué guardan y qué sueltan
Huella digitalClient Hints Fingerprinting: encabezados HTTP e identidad
Lleva BotBrowser de la investigación a producción
Usa estas guías para entender el modelo y después avanzar hacia validación multiplataforma, contextos aislados y despliegue de navegador preparado para escalar.