Iteradores perezosos y de un solo uso: take y drop
Una sonda sobre los ayudantes de iterador: cuándo se extrae el primer valor, por qué el resultado no se puede recorrer dos veces y cómo take para la fuente que drop recorre.
BotBrowser Team
Quieres la documentación estructurada de Huella digital?
Este artículo forma parte de la biblioteca editorial. Para pasos de configuración, material de referencia y actualizaciones continuas, entra en la sección de docs.
BotBrowser permite reproducir un fixture del mismo origen autorizado bajo un perfil declarado y guardar un registro acotado de qué extrajo realmente una página de un flujo, pero no puede hacer que un iterador ya consumido vuelva a dar valores, no puede convertir take en un vaciado, ni puede impedir que drop recorra los valores que salta. Esta revisión ejecuta una sonda sobre catorce casos fijos y registra cuándo extrae cada ayudante su primer valor, por qué el resultado de un ayudante no se puede recorrer dos veces mientras que el array de origen sí, cuánto avanza take y cuánto drop la fuente, qué deja un ayudante consumido a medias, y cómo un lanzamiento dentro de la fuente atraviesa la cadena.
Resumen
- Un ayudante es perezoso: tras
source().map(...)la sonda imprimelazy-before -> pulled=0, y solo el primernext()extrae un valor (lazy-after-one -> first=10 pulled=1). - Un ayudante devuelve un iterador, no un array: la sonda imprime
type -> isArray=false isIterator=true. - Un ayudante es de un solo uso: expandirlo dos veces imprime
consume-twice -> first=2,4,6 second=mientras que el array del que salió imprimearray-reiterable -> a=1,2,3 b=1,2,3. take(2)para la fuente pronto, así que la sonda imprimetake -> values=1,2 pulled=1,2y nunca extrae los valores tres a cinco.drop(3)no vacía la fuente por adelantado, pero su primernext()recorre los tres valores saltados:drop-after-one -> value=4 pulled=1,2,3,4.flatMapnecesita un resultado iterable; devolver un número lanza unTypeError.findysomedejan de extraer en cuanto conocen la respuesta, mientras quereducevacía toda la fuente.- Un lanzamiento dentro de la fuente llega al consumidor después de los valores ya emitidos, y la cadena termina ahí.
Contenido
- Cuándo extrae un ayudante su primer valor
- Por qué el resultado es de un solo uso
- Cuánto avanzan take y drop la fuente
- Qué hace un lanzamiento dentro de la fuente
- Registrar una lectura de ayudantes de iterador
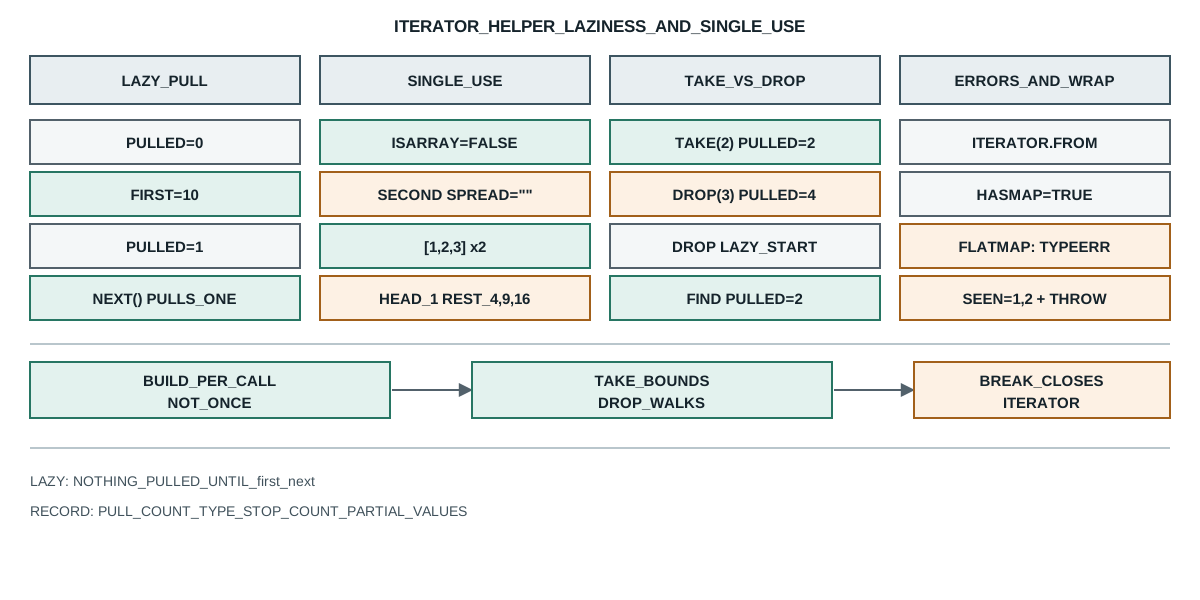
Cuándo extrae un ayudante su primer valor
Un ayudante de iterador es un envoltorio que produce valores a demanda, y todo el sentido es que nada se ejecuta hasta que un consumidor pide. La sonda construye un generador que registra cada valor que emite, lo envuelve en map y comprueba el contador antes de que nada pida un valor:
node=v26.9.0
lazy-before -> pulled=0
lazy-after-one -> first=10 pulled=1
type -> isArray=false isIterator=true
consume-twice -> first=2,4,6 second=
array-reiterable -> a=1,2,3 b=1,2,3
helper-reiterable -> a=2,3,4 b=
take -> values=1,2 pulled=1,2
take-stopped -> pulledCount=2
drop -> values=4,5 pulled=1,2,3,4,5
drop-before-next -> pulled=0
drop-after-one -> value=4 pulled=1,2,3,4
partial -> head=1 rest=4,9,16
flatMap -> 1,10,2,20
flatMap-non-iterable -> TypeError
find -> value=2 pulled=1,2
some -> result=true pulled=1,2,3
reduce -> total=6 pulled=1,2,3
exhausted-source -> length=0
thrown -> seen=2 error=Error:source failed
from-before -> pulled=0 hasMap=true
from-take -> values=1,2,3 pulled=1,2,3
toArray -> 3,6,9 thenNext=true
break -> seen=1,2 nextDone=true
Las dos primeras líneas son la definición del diseño. lazy-before -> pulled=0 significa que la llamada a map no hizo trabajo: enlazó una retrollamada a una fuente y devolvió. lazy-after-one -> first=10 pulled=1 muestra que el primer next() extrajo exactamente un valor del generador, corrió la retrollamada sobre él y devolvió el resultado mapeado. Una cadena de ayudantes sigue siendo perezosa igual, porque cada eslabón extrae del anterior solo cuando el consumidor extrae de la cadena.
Un segundo punto de entrada merece mención porque cambia qué puede envolver un ayudante. Iterator.from toma cualquier iterable o iterador y devuelve un iterador que lleva los ayudantes, lo que significa que un objeto que solo implementa Symbol.iterator puede recibir los mismos ayudantes que un iterador nativo. Los casos de la sonda parten todos de un generador o de un array, y ambos ya llevan los ayudantes, así que el valor de Iterator.from aparece con un iterable propio como un cursor sobre un resultado de base de datos. Una página que envuelve su propio cursor en Iterator.from puede entonces acotarlo con take sin escribir un bucle manual, y la misma pereza se aplica: no se lee nada del cursor hasta la primera extracción. La sonda imprime from-before -> pulled=0 hasMap=true, luego envuelve un iterable propio de cinco valores en take(3) e imprime from-take -> values=1,2,3 pulled=1,2,3, así que el cursor avanzó exactamente tres veces.
Eso importa para una página que lee de una fuente grande o ilimitada. Un map sobre un generador que tardaría minutos en terminar no cuesta nada de construir, y un take(10) más adelante en la cadena hace que solo se produzcan diez valores. La alternativa, construir un array intermedio, obliga a que toda la fuente corra antes de que el primer valor esté disponible, que es la diferencia entre un flujo que empieza a entregar en una fracción de segundo y uno que bloquea hasta el final.
La pereza es por extracción, no por lote de elementos. Cada next() corre la fuente hasta tener un valor más, así que la retrollamada del valor n corre solo cuando el consumidor pide el valor n. Una página que intercala su propio trabajo entre extracciones, como leer de un flujo de red o escribir un archivo, reparte por tanto el coste de la fuente entre los turnos del consumidor en lugar de pagarlo en una llamada bloqueante. Ese intercalado es la misma frontera de turno que describe microtareas y temporizadores, donde una retrollamada encolada como microtarea corre antes de que llegue la siguiente tarea.
El coste es que un ayudante no lleva control sobre cuántos valores ha producido ya la fuente. No hay vistazo, ni rebobinado, ni cuenta, así que un consumidor que los necesite tiene que construirlos, normalmente envolviendo el propio generador con un contador. El ayudante solo añade el paso de mapeo, y es deliberadamente el envoltorio más delgado posible porque cualquier cosa más pesada rompería la pereza que hace que valga la pena usarlo sobre un método de array.
Por qué el resultado es de un solo uso
La otra mitad del diseño es que un ayudante devuelve un iterador en lugar de una colección, y la sonda muestra la consecuencia exacta. Imprime type -> isArray=false isIterator=true, luego expande el mismo ayudante dos veces y obtiene consume-twice -> first=2,4,6 second=.
El primer spread recorrió el iterador hasta su final, y el segundo lo encontró agotado y no produjo nada, sin error. Es el comportamiento de todo iterador del lenguaje, y un ayudante lo hereda porque está construido sobre el protocolo de iteración y no sobre una copia. Contrástese con el array de origen en la línea siguiente: array-reiterable -> a=1,2,3 b=1,2,3, porque array.values() devuelve un iterador nuevo cada vez que se llama.
La línea siguiente es el extremo afilado de la misma regla. helper-reiterable -> a=2,3,4 b= muestra que el ayudante mismo no es re-iterable: conserva el único iterador con el que se construyó, el primer spread lo consumió y el segundo no vio nada. Este es el error que convierte una cadena perezosa en un resultado vacío silencioso. Una función que devuelve un ayudante y se llama dos veces recibe un iterador muerto en la segunda llamada, y el fallo es una secuencia vacía en lugar de una excepción.
La corrección es devolver una función que construya un ayudante en cada llamada, o devolver la fuente y construir la cadena en el lugar de llamada. Un ayudante pensado para reutilizarse tiene que derivarse de su fuente cada vez, porque el lenguaje no da al iterador ningún reinicio. Es la misma razón por la que un objeto generador no se puede recorrer dos veces, y una página que mezcla los dos estilos obtiene el segundo resultado vacío siempre que asume lo contrario.
Un lote de valores extraídos a medio llenar tiene el mismo problema de forma que un array disperso, donde un índice ausente y un undefined guardado se leen igual pero se iteran distinto. El consumo parcial de un ayudante es la versión suave de la misma regla. La sonda extrae un valor y luego expande el resto, e imprime partial -> head=1 rest=4,9,16 para un map que eleva al cuadrado su entrada. El único next() devolvió 1 (el cuadrado de 1), y el spread posterior siguió desde donde paró la extracción, devolviendo 4, 9, 16 para las entradas 2, 3, 4. No se perdió nada ni se repitió nada, porque el iterador recuerda su posición; un segundo spread habría devuelto nada. Un ayudante terminal termina el iterador igual que un spread: la sonda imprime toArray -> 3,6,9 thenNext=true, así que tras toArray recoger todos los valores el siguiente next() informó terminado.
Una fuente ya agotada antes de construir el ayudante es el caso silencioso. La sonda vacía un iterador de array, luego construye un map sobre el mismo objeto y lo expande, imprimiendo exhausted-source -> length=0. No hay error ni aviso: el ayudante se construyó sobre un iterador que ya había informado terminado, así que toda extracción posterior devuelve terminado de inmediato. Una página que cachea un iterador y construye un ayudante sobre él más tarde obtiene un resultado vacío siempre que otra cosa consumió el iterador entre medias, y la corrección es la misma que para el doble spread: construir el ayudante desde una fuente que pueda producir un iterador nuevo cada vez.
Un bucle que para pronto se comporta al revés de lo que sugiere el modelo de posición. La sonda corre un for...of sobre un ayudante, rompe en el valor 2 y luego le pide un valor más: imprime break -> seen=1,2 nextDone=true. Así que un break no aparca el iterador para una lectura posterior; salir del bucle lo cierra, y los valores después del break se pierden. Un consumidor que quiere leer una cabecera, parar y continuar desde el cuerpo no puede usar un break dentro de for...of sobre un solo iterador; tiene que extraer con next() para que el iterador no se cierre, o construir un iterador nuevo sobre la fuente.
Eso importa sobre todo por la razón por la que existe todo este diseño: acotar el coste. Un break es la única salida temprana que descarta el resto, así que un consumidor que lee hasta una condición y luego se va paga solo por lo que leyó pero no gana nada más de ese iterador. La forma basada en extracción deja la opción abierta, y la forma con take acota la lectura sin necesitar nunca un break, así que una cadena que compone take es la versión que para limpio y no deja trabajo a medias.
Cuánto avanzan take y drop la fuente
take y drop deciden cuánto ve un consumidor de una fuente, y la sonda muestra que la avanzan de formas opuestas. take para pronto, y drop recorre los valores que salta.
El caso de take imprime take -> values=1,2 pulled=1,2 y luego take-stopped -> pulledCount=2. La fuente generaba cinco valores en total, y tras tomar dos, las extracciones registradas son exactamente las dos primeras. take(2) no leyó los tres restantes para descartarlos; pidió dos y luego paró, que es lo que deja acotar una fuente infinita. Una página que toma un número fijo de elementos de un flujo ilimitado paga por tanto exactamente esos, y el resto del flujo no se toca.
El caso de drop es la imagen especular. El spread ansioso imprime drop -> values=4,5 pulled=1,2,3,4,5, porque expandir hasta el final lo extrajo todo, y los valores descartados hubo que generarlos para saltarlos. La línea más reveladora es la perezosa: drop-before-next -> pulled=0 muestra que un drop(3) recién creado no ha extraído nada al construirse, y drop-after-one -> value=4 pulled=1,2,3,4 muestra que su primer next() recorrió cuatro valores para devolver el cuarto. Así que drop es perezoso al construirse como cualquier ayudante, pero el trabajo que difiere es el de saltar, y un consumidor que pide un valor tras un drop(3) ya ha causado cuatro extracciones.
Esa asimetría decide cómo acotar un flujo. take es el tope seguro porque nunca lee de más. drop es un filtro sobre posición, y un drop con un conteo grande sobre una fuente lenta hace el trabajo lento antes de que el primer valor llegue al consumidor, así que una página que compone un drop grande con un take sigue pagando el drop. Un consumidor que quiere saltar una cabecera y luego leer un cuerpo paga por tanto la cabecera en cuanto pide el primer valor del cuerpo, no antes de empezar, pero tampoco gratis.
La interacción con flatMap merece una línea de la misma lectura. La sonda imprime flatMap -> 1,10,2,20 para un flatMap que devuelve dos valores por entrada, así que cada extracción de la fuente se convirtió en dos extracciones para el consumidor, y el aplanado es de un nivel en lugar de recursivo. Un flatMap que devolviera un array anidado entregaría al consumidor un array como valor, no sus elementos, que es la misma regla de un nivel que el método de array del mismo nombre.
flatMap también se niega a aplanar un valor que no es iterable. El intento de la sonda de devolver un número imprime flatMap-non-iterable -> TypeError, así que una retrollamada que a veces devuelve un escalar y a veces una lista falla en el escalar en lugar de saltarlo. Una página que construye un flatMap desde una retrollamada que puede devolver undefined necesita por tanto normalizar el resultado a un array vacío o de un elemento antes de que el ayudante lo vea, porque el ayudante no tratará un no iterable como «nada que aplanar».
Qué hace un lanzamiento dentro de la fuente
Un iterador que falla a mitad tiene que hacer algo con los valores que ya produjo, y la sonda fija el comportamiento. Su fuente emite 1 y luego lanza un Error('source failed'), y un map sobre ella se consume con un bucle for...of:
thrown -> seen=2 error=Error:source failed
El consumidor recibió el primer valor mapeado, 2, lo registró, y luego la siguiente extracción corrió la fuente hacia el lanzamiento, que se propagó fuera del bucle como el error original. Los valores anteriores al lanzamiento no se retiran, y los posteriores nunca existieron. Es el contrato en el que se apoya un consumidor que procesa elementos según llegan: todo lo que ya manejó sigue manejado, y el fallo aparece en el punto donde falló la fuente y no al principio.
El error no se envuelve. La sonda imprime Error:source failed, que es el mismo constructor y mensaje que lanzó la fuente, así que una cadena de ayudantes pasa el valor lanzado sin cambios. Una página que quiere añadir contexto tiene que envolver el error en el punto donde procesa elementos, porque el ayudante no añadirá una capa que nombre qué paso de la cadena falló.
El iterador queda terminado tras el lanzamiento, así que un reintento sobre el mismo objeto no produce nada en lugar de re-ejecutar la fuente. Es la misma regla de un solo uso que el caso del spread, aplicada a un fallo: la posición está más allá del lanzamiento, y no hay forma de rebobinar hasta él. Una página que necesita reintentar tiene que construir un iterador nuevo desde una fuente nueva, lo que normalmente significa una función que construya el generador en lugar de un objeto generador guardado.
Un reduce sobre la misma fuente es ansioso, y eso cambia cuándo ocurre el lanzamiento respecto al llamador. La sonda imprime reduce -> total=6 pulled=1,2,3 para una fuente de tres valores, sin resultado parcial disponible a medias, así que un reduce que encuentra un lanzamiento pierde el acumulador que había construido. Los ayudantes no reductores dejan que un consumidor vea los valores uno a uno y actúe sobre cada uno; un reduce los colapsa en un solo valor al final, y un fallo significa que ese valor nunca llega. Elegir entre los dos es por tanto una elección sobre cuánto avance parcial necesita conservar el consumidor.
Registrar una lectura de ayudantes de iterador
Una lectura de ayudantes de iterador sostiene una afirmación acotada: este tiempo de ejecución, esta fuente, estos ayudantes, produjeron estas extracciones. Cuatro campos la mantienen verificable:
- La cuenta de extracciones antes del primer
next(), porque la pereza es todo el sentido y un ayudante construido que ya extrajo algo no es perezoso. - Si el consumidor tenía un array o un iterador, porque una segunda iteración sobre un iterador devuelve nada y sobre un array devuelve los valores otra vez.
- La cuenta de extracciones en cada parada, porque
takeydropavanzan la fuente cantidades distintas y solo la cuenta muestra cuál. - Si un fallo llegó después de los valores ya emitidos, porque un consumidor que conserva sus resultados parciales depende de que los valores anteriores sobrevivan al lanzamiento.
Fuentes públicas
- MDN: Iterator
- MDN: Iterator.prototype.map()
- MDN: Iterator.prototype.take()
- MDN: Iterator.prototype.drop()
- MDN: Iterator.prototype.flatMap()
- ECMAScript: Iterator Helpers
- BotBrowser: referencia de consistencia de automatización
Conclusión
Construye una cadena de ayudantes y paga solo por los valores que extraes: construye la cadena, acótala con take cuando la fuente sea ilimitada, y recuerda que drop recorre lo que salta en la primera extracción y no por adelantado. Devuelve una función que construya la cadena en lugar de un iterador guardado cuando un llamador pueda iterar dos veces, porque un ayudante es de un solo uso y un segundo spread es silenciosamente vacío. Normaliza el resultado de la retrollamada de flatMap a un array para que un escalar no pueda lanzar, y decide si un consumidor necesita conservar los valores que ya manejó, porque un lanzamiento termina el iterador y un reduce pierde su acumulador. Para el orden en que entrega un flujo basado en microtareas, lee microtareas y temporizadores; para el hueco que deja un lote a medio llenar, lee huecos en arrays dispersos.
Este artículo forma parte de la guía: ¿Qué es la huella digital del navegador?
Artículos Relacionados
FingerprintJS OSS: recopilación y origen del resumen
Huella digitalWeakMap y WeakSet: qué guardan y qué sueltan
Huella digitalHuecos en arrays dispersos y qué hace cada método
Huella digitalIntl.NumberFormat: modo de redondeo y signo
Huella digitalCombinadores Promise: qué falla y qué nunca se asienta
Huella digitalRazón de aborto, composición y oyentes tardíos
Lleva BotBrowser de la investigación a producción
Usa estas guías para entender el modelo y después avanzar hacia validación multiplataforma, contextos aislados y despliegue de navegador preparado para escalar.