Huecos en arrays dispersos y qué hace cada método
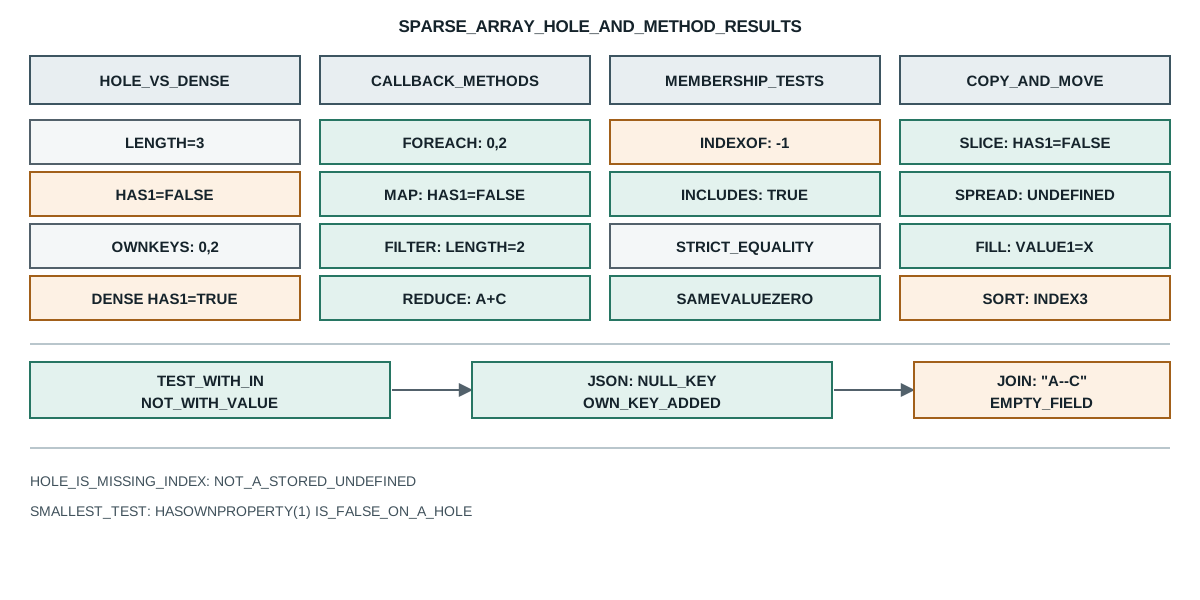
Una sonda sobre un solo hueco: qué métodos lo saltan, cuáles lo visitan, en qué se convierte y por qué indexOf e includes no coinciden.
BotBrowser Team
Quieres la documentación estructurada de Huella digital?
Este artículo forma parte de la biblioteca editorial. Para pasos de configuración, material de referencia y actualizaciones continuas, entra en la sección de docs.
BotBrowser permite reproducir un fixture del mismo origen autorizado bajo un perfil declarado y guardar un registro acotado de lo que una página envió realmente, pero no puede hacer que un array disperso se comporte como uno denso, no puede impedir que JSON convierta un hueco en null, ni puede hacer que indexOf e includes coincidan sobre un índice ausente. Esta revisión ejecuta una sonda sobre un array de tres elementos con un solo hueco y registra qué métodos de iteración visitan el hueco, cuáles lo saltan, en qué se convierte el hueco cuando el array se copia, se rellena, se ordena o se serializa, y por qué dos pruebas de pertenencia sobre el mismo array dan respuestas opuestas.
Resumen
- Un hueco es un índice ausente, no un
undefinedguardado: en['a', , 'c']la sonda imprimelength=3 has1=false ownKeys=0,2, mientras que un['a', undefined, 'c']denso imprimehas1=true ownKeys=0,1,2. forEach,map,filter,someyeverysaltan los huecos por completo, así quemapsobre un hueco deja un hueco en el resultado yfilterdevuelve un array denso más corto.reducesin valor inicial empieza en el primer elemento presente, así que sumar los dos valores presentes daa+c, mientras que la misma llamada con un0inicial cuenta solo las dos visitas.- Spread y
Array.fromrellenan el hueco conundefined, así que la copia informahas1=true value1=undefined, peroentries()muestra el hueco como1:undefinedporque el iterador visita todos los índices. indexOf(undefined)devuelve-1en un hueco mientras queincludes(undefined)devuelvetrue, porque las dos usan comparaciones distintas y una salta el hueco.joinyString()muestran el hueco como un campo vacío, así que['a', , 'c'].join('-')es"a--c", mientras quesliceyreverseconservan el hueco ysortlo mueve al último índice.- Un ida y vuelta con
JSON.parse(JSON.stringify(...))convierte el hueco ennully lo vuelve clave propia, así que el array vuelve más denso de lo que salió.
Contenido
- En qué se diferencia un hueco de un undefined guardado
- Qué métodos de iteración saltan un hueco
- En qué se convierte un hueco al copiar el array
- Por qué dos pruebas de pertenencia no coinciden
- Registrar una lectura de array disperso
En qué se diferencia un hueco de un undefined guardado
Array acepta una longitud sin exigir un elemento en cada índice, y el espacio que eso deja es un hueco. La sonda construye uno por asignación en lugar de con un literal, que es la forma en que un hueco aparece en código real cuando un programa calcula índices en lugar de escribirlos:
node=v26.9.0
shape -> length=3 has1=false ownKeys=0,2 json=["a",null,"c"]
dense -> length=3 has1=true ownKeys=0,1,2 json=["a",null,"c"]
forEach -> visits=0:"a"|2:"c"
map -> result=["0:\"a\"",null,"2:\"c\""] has1=false length=3
filter -> result=["a","c"] length=2
some -> indexesSeen=0,2
reduce-no-init -> a+c
reduce-with-init -> count=2
spread -> length=3 has1=true value1=undefined
from -> length=3 has1=true value1=undefined
entries -> 0:"a"|1:undefined|2:"c"
indexOf -> -1 includes -> true
indexOf-c -> 2
join -> "a--c"
toString -> "a,,c"
reverse -> length=3 has1=false keys=0,2
sort -> length=4 has1=true has3=false keys=0,1,2
fill -> has1=true value1="x"
slice -> length=3 has1=false
copyWithin -> has1=true value1="c"
json-roundtrip -> has1=true value1=null
Las dos primeras líneas son el artículo entero en miniatura. Los dos arrays tienen length=3 y los dos serializan a ["a",null,"c"], así que JSON.stringify no puede distinguirlos. La diferencia está en 1 in a y en Object.keys. El array con hueco informa has1=false y lista solo las claves 0,2; el array denso informa has1=true y lista 0,1,2. Un hueco no es una propiedad cuyo valor es undefined; es la ausencia de la propiedad, y cada método que lee el array tiene que decidir qué hacer con esa ausencia.
Por eso una comprobación escrita como if (arr[i] === undefined) clasifica mal los dos casos. Sobre el array con hueco, leer a[1] da undefined, exactamente como en el array denso, porque un índice ausente se lee como undefined según las reglas del lenguaje. La única prueba que los separa es la de presencia, 1 in a, o su equivalente Object.prototype.hasOwnProperty.call(a, 1), y la segunda forma es la que quieres cuando un array podría haber heredado una propiedad numérica de un prototipo contaminado.
La distinción tiene un coste que aparece en trabajo de tamaño de petición. Una página que construye un resultado asignando a índices calculados puede dejar huecos donde una rama no se ejecutó, y la forma serializada contiene entonces null en cada una de esas posiciones. Un consumidor que lee ese JSON no puede distinguir un null registrado a propósito de un hueco que nunca se rellenó, así que un esquema que se preocupa por la diferencia necesita un campo hermano o una bandera de presencia explícita, porque el array por sí solo no lleva la distinción a través de JSON.stringify.
Un hueco también sobrevive a un traspaso que parece sin pérdida. Pasar el array a una función, guardarlo en un campo de un objeto y devolverlo conserva el mismo objeto con los mismos huecos, porque nada en ese camino lo copia. El hueco desaparece solo cuando un paso lo materializa, y qué pasos lo materializan es el tema de las dos secciones siguientes.
Tres formas producen un hueco sin que nadie escriba una coma, y cada una es fácil de pasar por alto en una revisión. La primera es la asignación calculada que usa la sonda: un bucle que escribe result[index] = value solo para los índices que pasaron un filtro deja ausentes los demás. La segunda es new Array(n) seguido de escrituras parciales, porque el constructor fija length y nada más, así que cada índice empieza como hueco. La tercera es delete arr[i], que quita la propiedad propia y deja length igual, así que un borrado que parece una eliminación dispersa es exactamente un hueco y se comporta como uno en todos los métodos que midió la sonda.
Una cuarta vía es más sutil y viene de una asignación más allá del final de un array. Escribir arr[arr.length + 2] = 'x' fija length al nuevo índice más uno y deja los dos índices intermedios como huecos, porque el lenguaje extiende el array y no rellena el salto. Una página que añade con un desplazamiento calculado en lugar de push crea huecos en silencio, y el número de elementos presentes deja de coincidir con length.
La detección a través de una frontera es donde esto se vuelve operativo. Un registro que guarda un array de una página puede llevar length y el JSON serializado, y los dos coinciden en un array denso con null y en un array disperso con un hueco. Las dos primeras líneas de la sonda son exactamente ese caso: ["a",null,"c"] para ambos. Así que un registro que quiera conservar la distinción tiene que añadir el mapa de presencia, por ejemplo Object.keys(arr), y un consumidor que solo lee la forma serializada ya perdió la información antes de empezar.
La diferencia también importa para las comprobaciones de igualdad. Dos arrays que serializan ambos a ["a",null,"c"] comparan desiguales bajo una función de igualdad profunda que recorre claves propias, porque uno tiene el índice 1 y el otro no, e iguales bajo una función que primero serializa los dos a JSON. Una prueba que compara la salida de una página contra un fixture depende por tanto de cuál de los dos estilos de comparación usa, y un fixture construido a mano coincidirá en silencio con un array denso mientras la página produjo uno disperso.
Qué métodos de iteración saltan un hueco
Los métodos de iteración de array caen en dos grupos, y la división no es intuitiva. Los cinco que reciben una retrollamada, forEach, map, filter, some y every, saltan un hueco como si el índice no existiera. El forEach de la sonda imprime visits=0:"a"|2:"c", con el índice 1 ausente de la lista, y some imprime indexesSeen=0,2 porque nunca llama a la retrollamada para el hueco.
map es el que sorprende, porque su resultado conserva el hueco. La sonda imprime result=["0:\"a\"",null,"2:\"c\""] has1=false, así que el array mapeado tiene la misma longitud, un valor real en los índices 0 y 2, y sigue sin nada en el índice 1. Un map que construye cadenas a partir de cada elemento produce un resultado donde el hueco sigue siendo un hueco, y un join posterior sobre ese resultado lo mostrará como un campo vacío en lugar de la cadena undefined.
filter es lo contrario, porque no puede conservar el hueco: su resultado solo contiene los elementos que el predicado aceptó, y un hueco nunca se ofrece al predicado. La sonda pasa un predicado siempre verdadero y obtiene result=["a","c"] length=2, un array denso una posición más corto que la fuente. Eso convierte filter(() => true) en una herramienta para quitar huecos, y una página que lo usa como forma de copiar un array en realidad está densificando la copia como efecto secundario.
reduce está entre los dos grupos y su comportamiento depende de si se da un valor inicial. Sin valor inicial, el reduce de la sonda empieza en el primer elemento presente y devuelve a+c, así que el hueco nunca llega a la retrollamada y el número de sumas es uno, no dos. Con un 0 inicial, la sonda imprime count=2, porque el acumulador existe desde el principio y la retrollamada corre una vez por cada elemento presente. La variante sin valor inicial también lanza en un array sin elementos presentes, que es el equivalente disperso del caso de array vacío.
some y every cortocircuitan, y un hueco no cuenta como visita para ninguno. Eso importa para un bucle de validación que espera que every haya inspeccionado cada índice: un array con hueco puede pasar una comprobación de every sobre un rango que la retrollamada nunca vio. Un predicado que habría rechazado el valor ausente nunca corre, así que un every sobre un array parcialmente lleno es más débil de lo que parece, y una página que necesite rechazar un hueco tiene que comprobar la presencia por separado.
El propio protocolo de iteración no salta huecos. El entries() de la sonda imprime 0:"a"|1:undefined|2:"c", así que un bucle for...of o un spread sobre entries() ve cada índice y reporta el hueco como undefined. La secuencia que produce un for...of es la misma que ordena un comparador, algo que orden de array y comparadores cubre desde el lado del orden. Es la otra forma de visitar el array completo: los métodos con retrollamada saltan huecos, mientras que el protocolo de iterador los rellena, y por eso una página puede obtener dos recuentos de elementos distintos del mismo array según qué bucle use.
En qué se convierte un hueco al copiar el array
Copiar un array no tiene una sola respuesta. Algunas operaciones conservan el hueco, algunas lo reemplazan por undefined y algunas lo mueven. La sonda ejercita cinco y obtiene tres resultados distintos de la misma fuente.
Spread y Array.from rellenan el hueco. La sonda imprime spread -> length=3 has1=true value1=undefined y lo mismo para from, así que la copia es densa con un undefined explícito en el hueco. Es la forma más común en que un hueco desaparece sin aviso: una copia [...arr] en una refactorización convierte un array disperso en uno denso, y cualquier código posterior que contaba con que filter se deshiciera del hueco ahora tiene un undefined que manejar.
slice conserva el hueco. La sonda imprime slice -> length=3 has1=false, así que cortar el array completo reproduce la misma forma, porque slice copia claves propias y no inventa la que falta. Las claves que copia un slice son las que reporta un recorrido de claves propias, y orden de claves de objeto explica por qué vuelven ordenadas en lugar de en orden de inserción. Esta es la copia que se comporta como un clon superficial del almacenamiento y no de los valores, y es la que conviene usar cuando el hueco es significativo.
fill escribe en cada índice que cubre, incluido un hueco. La sonda rellena el índice 1 e imprime fill -> has1=true value1="x", así que un fill sobre un rango que incluye el hueco lo convierte en un elemento real. copyWithin hace lo mismo mediante un movimiento: copyWithin -> has1=true value1="c" muestra el valor copiado encima del hueco. reverse conserva el hueco. La sonda imprime reverse -> length=3 has1=false keys=0,2, así que tras invertir el array de tres elementos el hueco sigue siendo el único índice ausente, lo que tiene sentido porque invertir lleva el índice 1 sobre sí mismo y hace pasar los dos valores presentes uno junto al otro.
El resultado de sort merece leerse dos veces. La sonda añade b con concat y luego ordena el resultado de cuatro elementos; el paso de ordenación imprime sort -> length=4 has1=true has3=false keys=0,1,2, así que ordenar movió el hueco del índice 1 al último índice y llenó el índice 1 con un valor real. Una página que ordena un array parcialmente lleno y luego comprueba length sigue obteniendo 4, pero el hueco está ahora al final en lugar del medio, así que un bucle que se detiene en el primer undefined lee un elemento distinto que antes de ordenar. La forma no cambió; solo su posición, y la comprobación de presencia en el índice 1 pasó de false a true mientras que la del índice 3 pasó al revés.
join y String() coinciden entre sí y discrepan de todo lo demás. La sonda imprime join -> "a--c" y toString -> "a,,c", así que ambos muestran el hueco como un campo vacío en lugar de la palabra undefined. Es la misma salida que produciría un array denso con una cadena vacía real, lo que significa que una cadena unida no puede volver a separarse en el array original sin saber cuántos huecos había. Un ida y vuelta por join y split pierde por tanto la información de presencia que llevaba in.
Por qué dos pruebas de pertenencia no coinciden
La consecuencia más afilada de un hueco es que dos pruebas de pertenencia sobre el mismo array dan respuestas opuestas. La sonda imprime indexOf -> -1 includes -> true para una búsqueda de undefined en el array con hueco, y también imprime indexOf-c -> 2 para mostrar que una búsqueda de un valor presente es normal.
La razón es que indexOf usa igualdad estricta y salta huecos, mientras que includes usa la comparación SameValueZero y trata un hueco como undefined. Un hueco se lee como undefined, SameValueZero dice que undefined coincide con undefined, y includes devuelve true. indexOf nunca visita el hueco, así que devuelve -1. Una página que protege un valor con if (arr.indexOf(x) === -1) y otra que lo protege con if (!arr.includes(x)) discrepan por tanto siempre que x sea undefined y el array tenga un hueco, y la discrepancia es silenciosa.
Esa diferencia no es un fallo de ninguno de los dos métodos; es la división documentada, y existe porque includes se añadió después pensando en el caso NaN, así que tuvo que usar SameValueZero para hacer verdadero [NaN].includes(NaN). La misma comparación hace que un hueco coincida con undefined, que es un efecto secundario que el lenguaje conservó porque quitarlo habría hecho a includes inconsistente consigo mismo. Una página que necesite saber si un valor está presente y si un índice está lleno necesita por tanto las dos pruebas, una para el valor y otra para la presencia, y las dos preguntas tienen respuestas distintas en un array disperso.
El ida y vuelta JSON cierra la brecha de una forma que esconde el problema. La sonda imprime json-roundtrip -> has1=true value1=null, así que JSON.parse(JSON.stringify(holey)) devuelve un array donde el índice 1 está presente y su valor es null. El hueco se volvió una clave propia con valor null, lo que significa que un clon basado en JSON densifica el array en silencio y reemplaza la ausencia con un valor que el esquema puede no esperar. Es el mismo riesgo que una copia por spread, pero más difícil de notar, porque el código que lo hace a menudo parece que preservó los datos.
Registrar una lectura de array disperso
Una lectura de array disperso sostiene una afirmación acotada: este tiempo de ejecución, esta forma, estos métodos, produjeron estos resultados. Cuatro campos la mantienen verificable:
- El mapa de presencia, porque
lengthy la forma serializada no distinguen un hueco de unundefinedguardado. - La operación y si visita, salta o materializa el hueco, porque la respuesta es distinta para cada una.
- Las claves propias del resultado, porque un
mapconserva un hueco, unfilterlo descarta y un sort lo mueve al final. - Si el valor pasó por
JSON, porque un ida y vuelta convierte cada hueco ennully lo vuelve clave propia.
Fuentes públicas
- MDN: Array
- MDN: Array.prototype.forEach()
- MDN: Array.prototype.filter()
- MDN: Array.prototype.includes()
- MDN: Array.prototype.sort()
- ECMAScript: objetos Array
- BotBrowser: referencia de consistencia de automatización
Conclusión
Trata un array disperso como un tipo distinto de uno denso: comprueba la presencia con in o hasOwnProperty en lugar de leer el valor, espera que los métodos con retrollamada salten un hueco mientras spread y Array.from lo rellenan, y recuerda que un sort aparca el hueco en el último índice donde antes estaba en el medio. Cuando un valor tenga que sobrevivir a una copia, elige la copia por lo que hace al hueco: slice lo conserva, spread lo densifica y un ida y vuelta JSON lo convierte en null. Para el orden que toma un valor de relleno una vez que existe, lee orden de array y comparadores; para lo que una copia JSON hace al resto de la estructura, lee structuredClone frente a JSON.
Este artículo forma parte de la guía: ¿Qué es la huella digital del navegador?
Artículos Relacionados
Orden de array y comparadores: una función fácil de errar
Huella digitalWeakMap y WeakSet: qué guardan y qué sueltan
Huella digitalOrden de claves: enteros ordenan, cadenas se quedan
Huella digitalTrampas de proxy y las invariantes que impone el motor
Huella digitalstructuredClone frente a JSON: qué conserva una copia profunda
Huella digitalDataView: orden de bytes, alineación y límites
Lleva BotBrowser de la investigación a producción
Usa estas guías para entender el modelo y después avanzar hacia validación multiplataforma, contextos aislados y despliegue de navegador preparado para escalar.