Playwright iframe 未加载?先检查目标框架
区分 Playwright iframe 未加载、旧 Frame 已分离和嵌套框架选错。对照三个真实本地场景,核对目标文档与订单回执。
BotBrowser Team
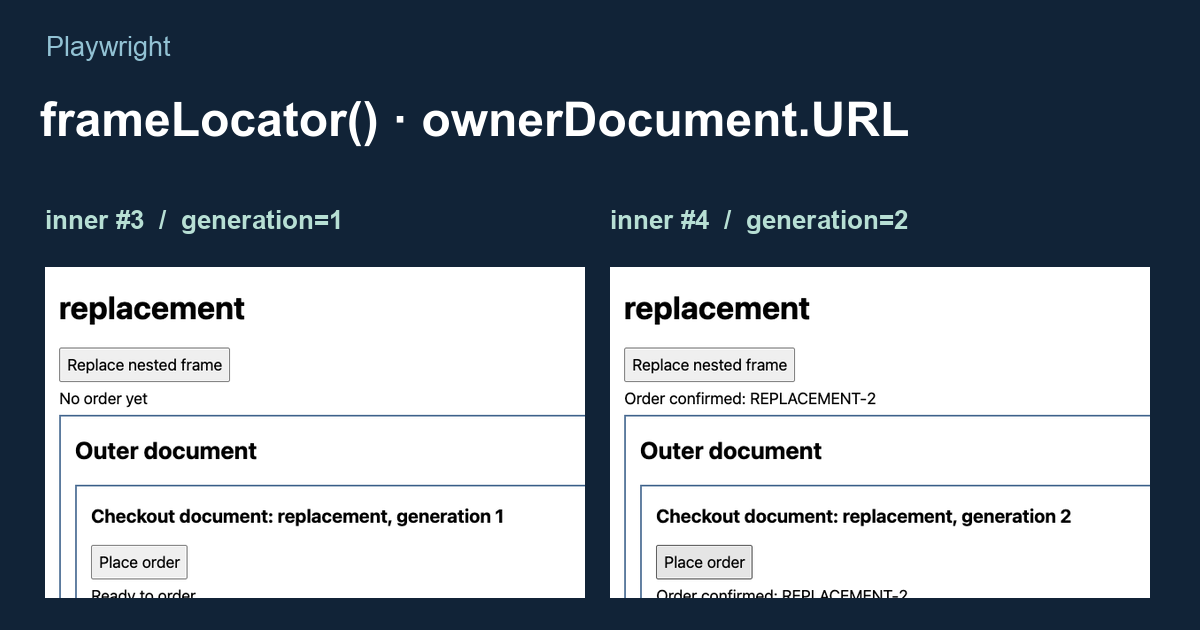
Playwright iframe 未加载可能意味着嵌套 iframe 元素始终没有出现,也可能是先前选中的 Frame 已被分离,或者测试进入了一个已加载、却没有目标控件的兄弟文档。先检查框架树,确定控件属于哪个文档,再考虑延长超时。BotBrowser 通过浏览器可执行文件和 profile 配置支持 Playwright 集成;它不能创建应用缺失的 iframe,也不能替测试决定操作应指向哪个嵌入文档。
摘要
- 分别检查每一层文档边界:外层 iframe 元素、其中的子 iframe 元素,以及子文档内的控件。
- 应用会替换 iframe 时,可以保留基于选择器路径的
FrameLocator。从旧的、已分离Frame创建的定位器仍绑定在旧框架上。 - 已加载的框架没有匹配按钮,可能是选错了兄弟框架。应比较父子关系和文档 URL,而不是按数组位置选择框架。
- 三个自有本地场景通过了 3/3 项场景检查,包括各自故意触发的失败。只有两个场景提交了订单;缺少子框架的场景正确地没有提交。
- 核对目标文档和应用响应。点击完成本身不能证明预期的嵌入工作流已经成功。
目录
区分 iframe 元素及其文档
iframe 有两个需要区分的部分。<iframe> 元素属于父文档,嵌入页面则拥有自己的文档和控件。在页面上找到 #outer,只能确认这个 iframe 元素存在,不能确认外层文档内存在预期的 #inner 元素,也不能确认其中任何一个文档包含名为 Place order 的按钮。
Playwright 框架文档介绍了限定在框架内的交互。面对嵌套内容,定位器链必须沿着相应的文档边界逐层进入。在下方自有示例中,page.frameLocator('#outer').frameLocator('#inner') 先进入外层文档,再进入内层文档。单独的 page.getByRole('button') 搜索的是主文档;普通 CSS 后代选择器不会跨入 iframe 的文档。
FrameLocator API表示检索 iframe 并在其中定位元素的逻辑。通过 page.frame() 等 API 获得的 Frame 对象则代表一个具体框架。当应用移除一个 iframe 元素,并插入另一个属性相同的元素时,这个区别就会显现。稳定的选择器路径可以描述替换后的元素,而旧框架对象不会变成新挂载的框架。
| 失败操作的症状 | 需要收集的证据 | 首先检查的修复方向 |
|---|---|---|
| 外层框架存在,嵌套 iframe 数量为零 | 在外层文档内查询子 iframe 元素 | 检查应用的插入条件和选择器 |
Frame was detached | 旧框架身份和 framedetached 事件 | 沿预期路径解析当前框架 |
| 已加载的兄弟框架中目标匹配数为零 | 父子关系、文档 URL 和目标数量 | 选择实际承载工作流的兄弟框架 |
| 多个 iframe 元素匹配 | 出现歧义的边界处的匹配数量 | 为框架提供唯一的应用身份 |
| 框架正确且目标只有一个,但点击仍在等待 | 定位器的可操作性详情 | 检查控件状态和事件接收情况 |
歧义这一行针对的是框架选择本身。Playwright 严格模式冲突解释了重复元素匹配和组件作用域;进入框架前同样需要明确身份。即使按钮名称唯一,如果选择框架时已经匹配到两个无法区分的 iframe,按钮定位器也无法修正这个问题。只有当位置本身就是应用约定时,按位置选择才合适。
2026-11-18,三个自有 localhost 场景在 Playwright 1.58.0、原版 Chrome 157.0.8103.79 和 macOS arm64 上运行。三个无头浏览器并发执行,各使用 1150 × 850 视口。完整运行耗时 3846 毫秒,报告 pass: 3、fail: 0。这是原版 Chrome 的测试夹具运行,没有使用 BotBrowser profile、远程嵌入服务或生产结账系统。
每个场景都故意包含一次失败或一个缺失目标。通过表示预期失败和后续状态断言符合夹具设计,并不表示三个初始点击全部成功,也不表示缺失文档的场景演示了修复。下方分别列出这些结果。
场景一:嵌套 iframe 元素不存在
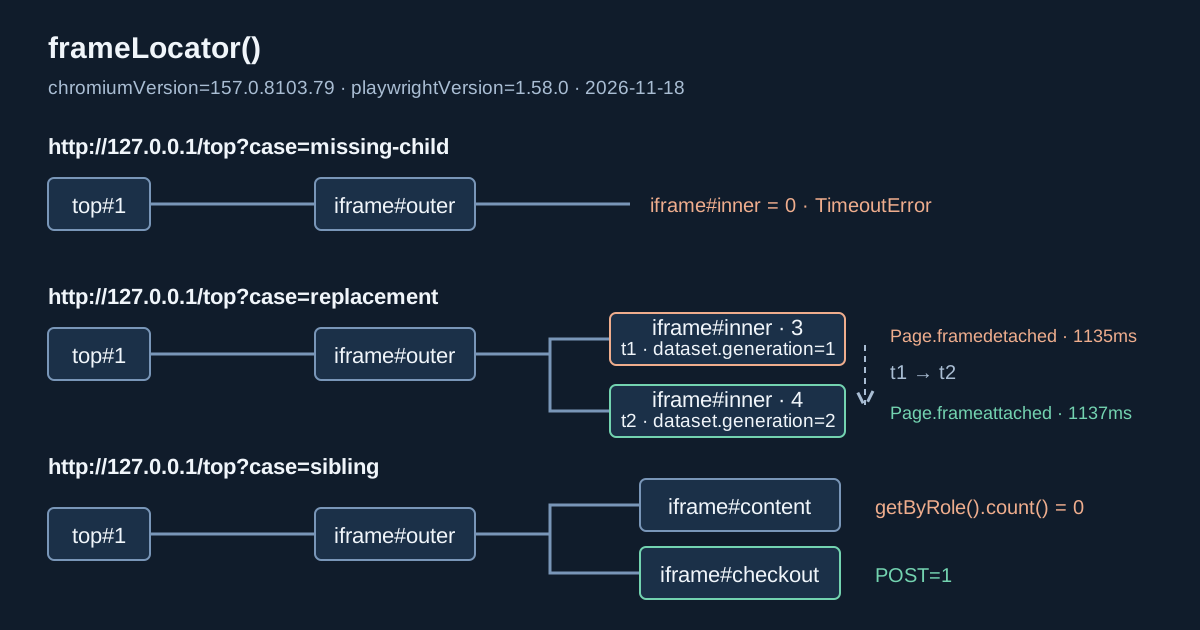
第一个页面渲染了一个外层 iframe,其文档明确说明嵌套 iframe 元素不存在。这里没有可供进入的 #inner 节点。导航使用 waitUntil: 'load',而且可以查询外层文档,因此记录到的失败比笼统地说页面没有加载更具体。
框架树中只有两个仍连接的框架。下方根据记录中的名称、父子关系和 URL 路径作紧凑展示,省略了本地服务器的临时端口:
top #1       /top?case=missing-child
└─ outer #2  /outer?case=missing-child

targetDocument: null
businessOrders: 0
visibleTopStatus: No order yet
运行器先断言主文档中有一个外层 iframe 元素,再断言其内部的 #inner 元素数量为零。随后,它在刻意设置的短诊断时限内尝试嵌套点击,并捕获到 locator.click 预期抛出的 TimeoutError。
这个 650 毫秒时限只属于确定性的本地负例,并不是生产嵌入应用的推荐超时值。真正有诊断价值的是缺失的 iframe 元素和捕获的框架树,而不是操作失败前经过了多少毫秒。
const outer = page.frameLocator('#outer');
await expect(page.locator('#outer')).toHaveCount(1);
await expect(outer.locator('#inner')).toHaveCount(0);

const target = outer.frameLocator('#inner').getByRole('button', {
  name: 'Place order',
});
await expect(target.click({ timeout: 650 })).rejects.toThrow(/Timeout/);
await expect(page.getByRole('status')).toHaveText('No order yet');
这些 Playwright Test 语句用于已经加载的夹具,expect 从 @playwright/test 导入。零数量断言适用于这个故意省略子元素的夹具。如果应用约定在某次状态转换后插入子框架,就应先触发转换,再断言所需的正数量。立即调用的 count() 有助于捕获诊断快照,但它不会不断重试,直到延迟元素出现。
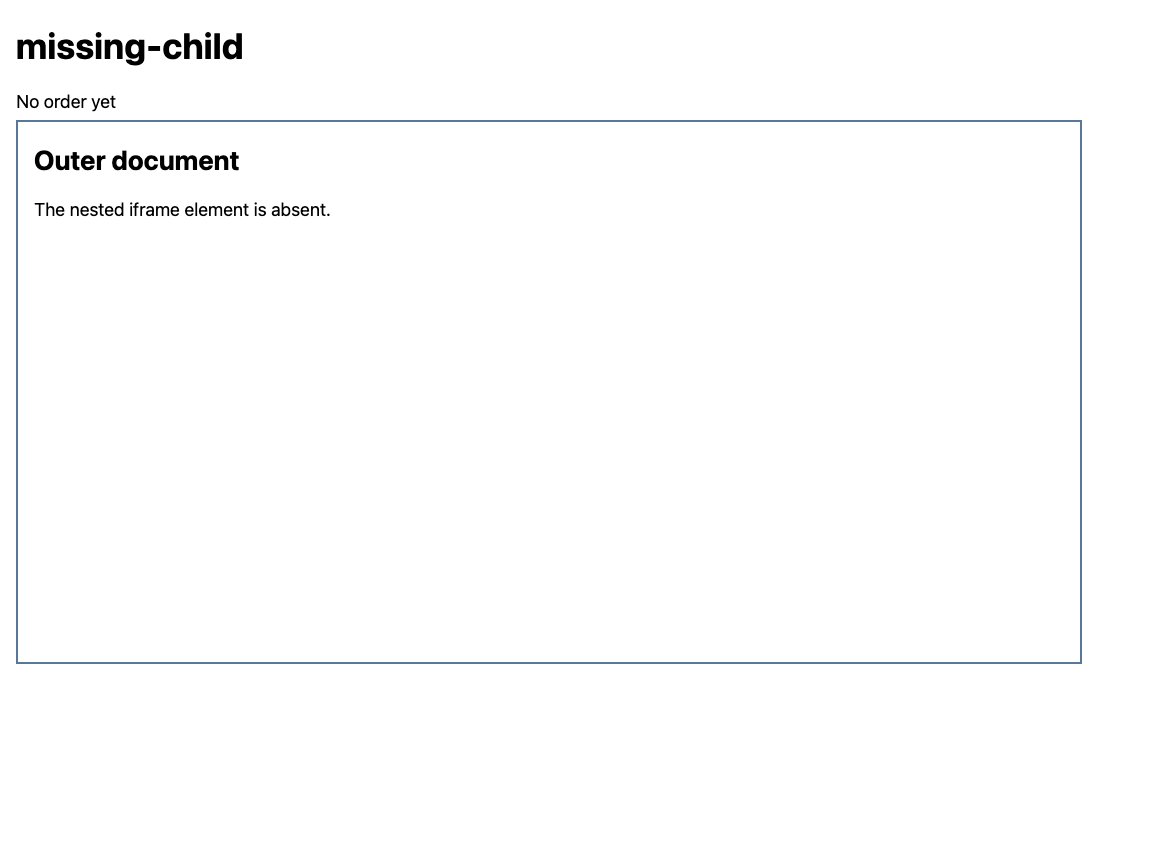
截图显示外层文档中没有嵌入的结账页面。服务器记录还独立确认该场景订单数为零。这些观测支持目标缺失、工作流未改变的判断;单凭图片无法确认没有隐藏请求被提交。
在自有应用中,应检查负责创建 #inner 的条件,例如选中的标签页、已完成的前置步骤、功能状态或正确路由。这里没有测试这些可能的生产原因。延长点击超时只会让插入有更多时间发生,不能让某个应用分支渲染它本来就不打算渲染的内容。同样,在按钮的文档尚不存在时,更改按钮名称也无济于事。
场景二:替换使旧 Frame 分离
替换夹具最初在 #outer 内包含 #inner,其中结账文档的按钮带有 data-generation="1"。主页面提供一个 Replace nested frame 控件。它的消息处理器让外层文档创建新 iframe,并对旧元素调用 replaceWith()。新元素仍保留 id="inner" 和 name="inner",但其 URL 选择第 2 代文档。
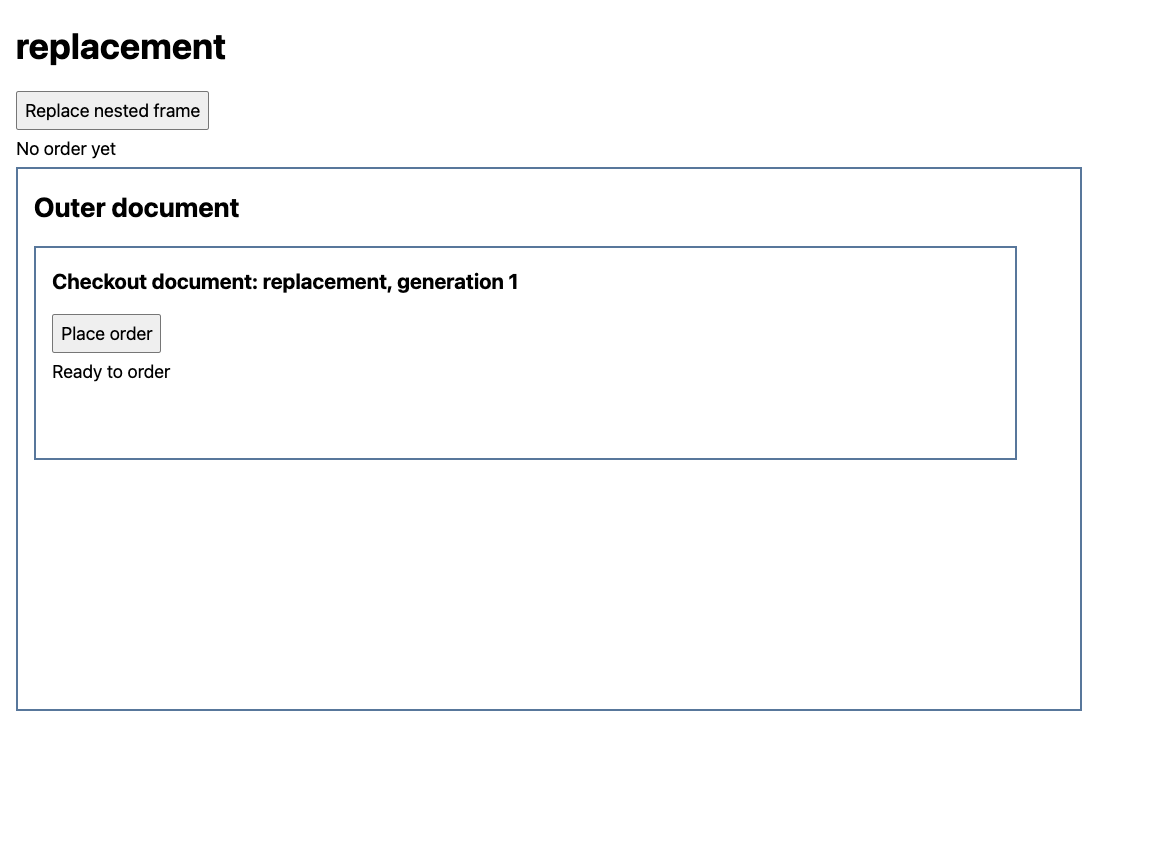
触发替换前,运行器保留了两条不同的目标路径。一条是基于嵌套 FrameLocator 的按钮定位器,另一条是从当前选中 Frame 对象创建的按钮定位器。因此,比较的重点是框架归属,而不是 JavaScript 变量在转换之前还是之后声明。
const outer = page.frameLocator('#outer');
const target = outer.frameLocator('#inner').getByRole('button', {
  name: 'Place order',
});
await expect(target).toHaveAttribute('data-generation', '1');

const oldFrame = page.frame({ name: 'inner' });
if (!oldFrame) throw new Error('Initial inner frame is absent');
const oldTarget = oldFrame.getByRole('button', { name: 'Place order' });

const detached = page.waitForEvent('framedetached', {
  predicate: frame => frame === oldFrame,
  timeout: 3000,
});
await page.getByRole('button', { name: 'Replace nested frame' }).click();
await detached;

expect(oldFrame.isDetached()).toBe(true);
await expect(target).toHaveAttribute('data-generation', '2');
初次选择时,夹具中恰好只有一个名为 inner 的框架。实际应用也需要相应的唯一身份;任意页面中的框架名称并不天然保证全局唯一。事件等待在触发点击之前注册,并匹配原始对象,因此无关分析框架的分离事件不能使这个等待完成。
观测到的框架树发生了以下变化。数字 ID 由运行器分配,用于区分当前场景中的框架对象,并不是浏览器提供的永久标识:
before:
top #1       /top?case=replacement
└─ outer #2  /outer?case=replacement
   └─ inner #3  /leaf?case=replacement&generation=1

after:
top #1       /top?case=replacement
└─ outer #2  /outer?case=replacement
   └─ inner #4  /leaf?case=replacement&generation=2
运行器记录到旧框架 #3 在 1135 毫秒时分离,随后新框架 #4 在 1137 毫秒时挂载。这些时间戳以该场景开始为起点。它们的顺序支持本次运行发生了移除和替换;两毫秒间隔既不是浏览器延迟保证,也不是可以复制到测试中的等待时间。
分离后调用 oldTarget.click({ timeout: 650 }) 得到:
locator.click: Frame was detached
保留的 target 定位器则解析到了新按钮,其所属文档 URL 以 /leaf?case=replacement&generation=2 结尾。它点击了第 2 代按钮,产生一次 POST /order?case=replacement&generation=2。随后,子文档和主文档都包含 Order confirmed: REPLACEMENT-2。
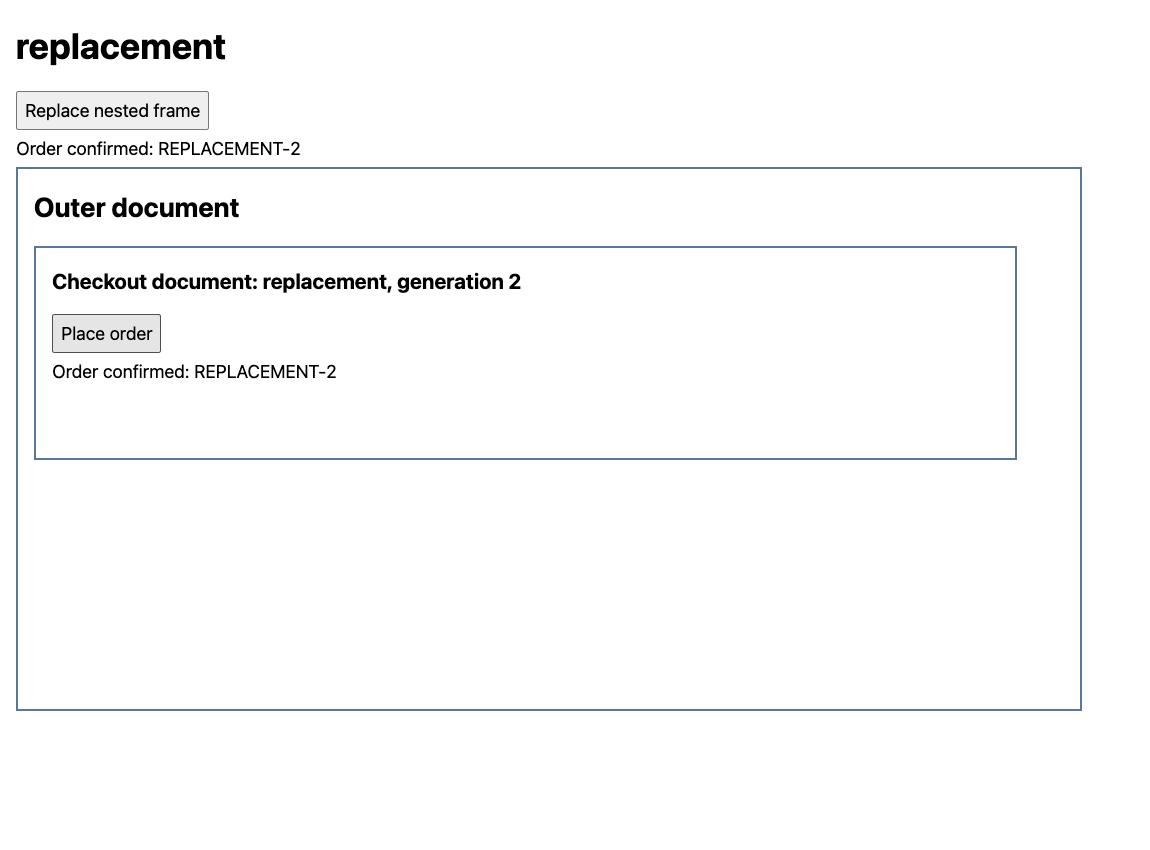
这演示的是 iframe 元素被替换。现有 iframe 内部的导航是另一种转换,不应直接称为框架分离问题。Frame API区分了挂载、导航和分离。判断具体框架究竟消失了,还是仅发生导航时,应依据实际生命周期事件。
FrameLocator 也不保证在持续替换期间始终成功。其选择器仍须识别预期 iframe,替换后的文档须提供所需控件,并且控件在操作执行时须满足可操作性要求。如果应用不断丢弃结账页面,应保留这个生命周期故障,而不是把它藏进无限重试循环。
场景三:目标属于兄弟框架
兄弟框架夹具在外层文档中提供两个子框架:content 和 checkout。两者都成功加载。内容文档明确没有结账按钮,而结账文档包含所需的 Place order 控件。因此,进入 #content 的测试可能一直等待无果,尽管目标控件在页面其他位置可见。
top #1       /top?case=sibling
└─ outer #2  /outer?case=sibling
   ├─ content #3   /leaf?case=sibling&role=content
   │  buttons: []
   └─ checkout #4  /leaf?case=sibling&role=checkout
      buttons: [Place order]
运行器检查了两个子 iframe 元素都存在,然后断言 content 内的匹配按钮数量为零。通过错误兄弟框架尝试点击时,locator.click 抛出 TimeoutError,采用的仍是与缺少子框架场景相同的 650 毫秒时限。因此,仅看错误标题无法区分这两种失败:一条定位器链缺少嵌套框架元素,另一条则进入了真实文档,但该文档中没有按钮。
const outer = page.frameLocator('#outer');
const content = outer.frameLocator('#content');
const checkout = outer.frameLocator('#checkout');

await expect(outer.locator('#content')).toHaveCount(1);
await expect(outer.locator('#checkout')).toHaveCount(1);
await expect(content.getByRole('button', { name: 'Place order' })).toHaveCount(0);

const target = checkout.getByRole('button', { name: 'Place order' });
await expect(target).toHaveCount(1);
await target.click();
await expect(checkout.getByRole('status')).toHaveText('Order confirmed: SIBLING-1');
这里的修复是把框架边界从 #content 改成 #checkout,而不是放宽按钮名称匹配或关闭可操作性检查。记录中的目标所属文档为 /leaf?case=sibling&role=checkout,服务器恰好收到该场景的一笔订单。返回的回执同时到达结账文档和主文档。
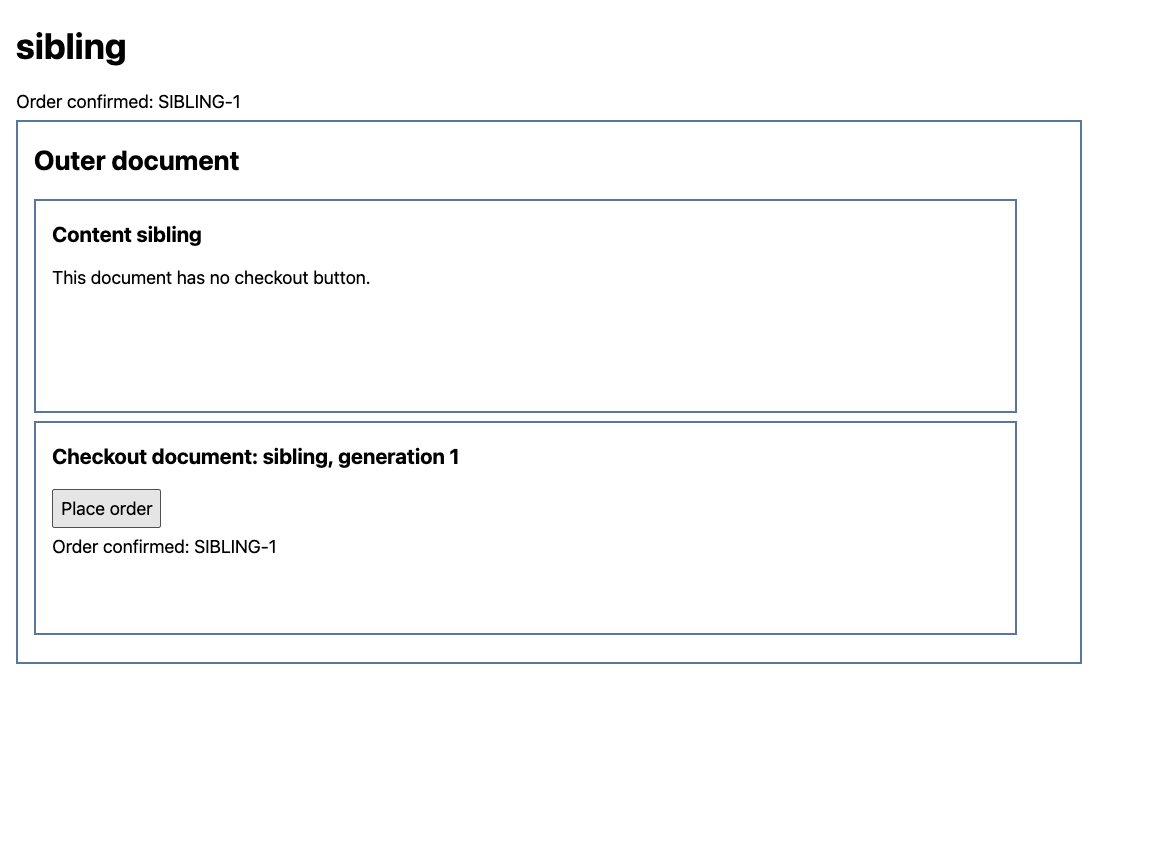
不要由此推出“第二个 iframe 就是结账页面”的规则。在这个夹具中,明确的 ID 定义了文档角色。广告、嵌入式预览或应用更新都可能改变枚举顺序,而不改变结账页面的身份。应使用由应用定义的 title、name、测试 ID 或其他稳定选择器,使其含义在这些变化后仍然成立。
URL 可以辅助核对,但也有局限。两个框架可能共用 URL,正常的结账页面也可能依次导航至多个 URL。在这个受控框架树中,role 查询参数可以方便地区分文档,是因为夹具本身定义了它。在生产集成中,应匹配约定的框架身份和状态,而不是假定 payment 这样的子串总能识别正确文档。
核对文档与业务结果
替换场景和兄弟框架场景不只是等待按钮。点击前,运行器会对匹配按钮求值,获取其 ownerDocument.URL、代数和文字。这个快照把选中的控件与检查时点上的具体文档关联起来。它补充了框架树的信息:框架树描述所有仍连接的文档,目标求值则描述定位器实际匹配到的元素。
const selected = await target.evaluate(button => ({
  url: button.ownerDocument.URL,
  generation: button.dataset.generation,
  text: button.textContent,
}));
console.log(selected);
这次求值并不是对元素的原子预留。后续操作会再次解析定位器,应用也可能在快照和点击之间发生变化。因此,替换夹具会检查第 2 代状态,并验证回执本身也包含第 2 代。其服务器端订单数组还提供了独立检查,确认旧代文档没有提交订单。
| 场景 | 目标文档 | 记录的订单 | 主文档最终文本 |
|---|---|---|---|
| 缺少子框架 | 无 | 0 | No order yet |
| 替换 | /leaf?case=replacement&generation=2 | 1,第 2 代 | Order confirmed: REPLACEMENT-2 |
| 先选错兄弟框架,再选择正确框架 | /leaf?case=sibling&role=checkout | 1,第 1 代 | Order confirmed: SIBLING-1 |
每次成功点击都会执行真实的本地 HTTP POST。叶文档的处理器读取 JSON 回执,更新自身状态,再通过父级消息转发回执。外层文档继续把它中继给主页面。因此,主页面出现确认信息,既依赖嵌入交互,也依赖夹具的消息路径。中继故障可能导致子操作已成功,但主状态仍未改变;这两项观测应分别诊断。
记录中的运行器使用 toHaveText() 断言回执。它检查的是文本条件,而不是可见性。最终截图另外展示了渲染出的确认信息。如果测试要求包含可见反馈,就应在同一状态元素上显式断言这个条件:
const childStatus = checkout.getByRole('status');
const topStatus = page.getByRole('status');
await expect(childStatus).toHaveText('Order confirmed: SIBLING-1');
await expect(childStatus).toBeVisible();
await expect(topStatus).toHaveText('Order confirmed: SIBLING-1');
await expect(topStatus).toBeVisible();
这些额外的可见性断言是一种可复用测试写法,并不是事后追加到已记录运行中的断言。Playwright 定位器断言会重试指定条件。先检查文本、再检查可见性,观察的仍是两个检查时点,并不保证状态会永久保持可见。
夹具服务器把订单记录保存在内存中,没有实现数据库。POST 和匹配回执只能建立所演示的请求与响应工作流,不能证明购买结果持久化。如果应用要求订单已保存,应使用其支持的后续读取或服务器断言。回执缺失后不要自动再次点击:第一次提交可能已经成功。
调整等待前先捕获框架树
对于获得授权的页面,可以用一个小型独立探针记录父子关系和生命周期事件,而不发起业务操作。在 Node 项目中安装 playwright,通过 npx playwright install chromium 安装浏览器,再把下方代码保存为 inspect-frames.mjs。对已在该地址提供服务的自有页面运行 node inspect-frames.mjs http://127.0.0.1:3000/your-page,并把 URL 替换为你有权检查的目标。
import { chromium } from 'playwright';

const targetURL = process.argv[2];
if (!targetURL) throw new Error('Pass an authorized page URL');

const browser = await chromium.launch();
try {
  const page = await browser.newPage();
  const ids = new WeakMap();
  let nextId = 1;
  const id = frame => {
    if (!ids.has(frame)) ids.set(frame, nextId++);
    return ids.get(frame);
  };
  const describe = frame => {
    const parent = frame.parentFrame();
    return {
      id: id(frame),
      parentId: parent ? id(parent) : null,
      name: frame.name(),
      url: frame.url(),
      detached: frame.isDetached(),
    };
  };

  for (const event of ['frameattached', 'framenavigated', 'framedetached']) {
    page.on(event, frame => console.log(event, describe(frame)));
  }
  await page.goto(targetURL, { waitUntil: 'domcontentloaded' });
  console.table(page.frames().map(describe));
} finally {
  await browser.close();
}
探针在导航前订阅,因此能够观察初始框架生命周期。其表格是 DOMContentLoaded 之后的快照,并不保证后续所有框架都已出现。对于应用转换后创建的子框架,应在真实测试对该转换作出明确断言之后,再捕获表格。探针结束后会主动关闭浏览器,不会一直打开并等待任意未来事件。
已挂载的框架在导航事件发生前,最初可能只有空 URL。应把这种中间观测视为事件序列的一部分,不要立即为它赋予最终嵌入文档的身份。另外,不要依靠分离时的 parentFrame() 重建历史父子关系,应保留更早的挂载或框架树记录。页面框架事件和框架关系文档说明了 API 可以提供哪些观测。
对于间歇性替换,应把事件序列与失败操作一起保留。Playwright 测试调试追踪提供操作快照和时间线,可展示失败前后发生的转换。测试失败后再打开当前页面,可能只看到正常的新框架,却丢失了旧框架以及触发错误的确切定位器上下文。分享日志前,应遮盖框架 URL 中的令牌和账号特定值。
只有找到正确文档后,才应把点击超时作为可操作性问题调查。Playwright 可操作性涵盖可见性、稳定性、启用状态和事件接收等检查。force: true 不能插入缺失 iframe、重新挂载旧框架,也不能把按钮移动到所选兄弟文档中。如果目标正确,但等待条件涉及无关网络流量,networkidle 超时与界面就绪区分了网络等待条件与交互所需状态。
这些示例使用同源 localhost 文档,以便控制生命周期、内容和订单记录。它们没有测试跨源认证、沙箱权限、内容安全策略或第三方嵌入限制。Playwright 支持的框架 API 是控制嵌入文档的适当接口;父页面 JavaScript 的访问则另受浏览器同源策略约束。真实嵌入被阻止时,必须先获取其响应和控制台证据,再判断是否适用这些本地夹具中的某种解释。
BotBrowser 的 Playwright 集成介绍了让自动化客户端控制 BotBrowser 所需的可执行文件和 profile 设置。这种配置有助于提供受控浏览器环境,以复现应用问题。它无法根据通用 iframe 索引识别结账页面,不能保证替换后的框架持续挂载,也不能建立订单结果。三个原版 Chrome 场景在浏览器启动配置之外补充了框架树、生命周期和回执对照,但不能证明任何 BotBrowser 特有的框架行为。
常见问题
等待外层 iframe 加载,能覆盖所有嵌套框架吗?
没有哪个单一加载里程碑能够确认所有未来子文档的状态。应用可以在外层文档加载后插入嵌套 iframe。应在实际使用时断言预期子元素及其所需状态,并把断言限定在正确的父文档内。
每次导航都属于框架分离错误吗?
不是。导航和分离是不同的生命周期事件。iframe 可以发生导航,同时保留原框架对象。替换示例明确移除了元素并挂载新框架;诊断其他转换,需要依据其实际事件序列。
iframe 出现之前可以保存 FrameLocator 吗?
可以。创建 FrameLocator 是描述检索路径,并不要求立即成功查到元素。后续操作仍要求匹配的框架和目标在适用的超时时间内可用。仅构造对象不是就绪检查。
为什么不同的框架问题会产生相同超时?
嵌套点击需要等待一连串条件成立。在记录的缺少子框架场景中,缺失的是 iframe 元素;在兄弟框架场景中,所选文档没有按钮。保留完整调用日志,并逐层查询每个边界,才能区分这些未满足的条件。
来源
- Playwright:框架及框架内交互
- Playwright:FrameLocator API 与严格性
- Playwright:框架生命周期与关系
- Playwright:页面框架挂载事件
- Playwright:可操作性
- Playwright:重试断言
- MDN:同源策略
- BotBrowser:Playwright 集成
实践结论
遇到 Playwright iframe 未加载或框架选错导致的超时,应沿失败定位器链逐层检查。先确认子元素是否存在、所选框架是否在应用转换后仍然连接,以及目标是否属于该文档。然后保留预期框架路径,只执行一次操作,并验证工作流特定结果。先在失败操作旁捕获框架树,就能在调整超时掩盖现象之前,把这三种故障区分开来。
本文属于指南: 浏览器自动化入门:首次运行地图