Playwright 点击后等待响应:修复竞态
修复 Playwright 点击 Save 后等待响应超时:点击前注册等待,匹配目标 POST,检查 HTTP 状态,再验证界面结果。
BotBrowser Team
Playwright 点击 Save 后等待响应,即使页面已经显示成功消息,也可能超时。应在点击之前创建响应 Promise,识别目标请求,再分别检查其状态与界面结果。BotBrowser 能以声明的配置文件运行由 Playwright 控制的浏览器;它无法重放测试订阅过晚而错过的响应事件,也无法判断哪个应用请求代表 Save。
TL;DR
- 触发操作前调用
page.waitForResponse(),但先不要 await;点击后再等待保存的 Promise。 - 先匹配请求身份:
/api/save加POST,才能区分写入与同一路径上先发生的GET。 - 单独断言
response.status()。只筛选201,可能将实际的503响应变成超时。 - 分别检查响应体与
role=status的结果。仅有成功横幅不能证明数据已持久化。
目录
Save 流程有三种不同信号
假设一个自有的修订编辑器,其 Save 处理器先读取当前修订,再提交新值。两个请求都使用 /api/save。读取请求 GET /api/save 返回 HTTP 200 和修订 6;写入请求 POST /api/save 返回 HTTP 201 和修订 7。只有读取写入响应后,处理器才将状态元素设为 Saved revision 7。
这些是独立的观察。GET 说明初始读取收到了响应;POST 说明写入端点返回了特定状态和响应体;最终 DOM 说明应用渲染了特定消息。顺序很关键:同一路径出现了两次,而 DOM 更新发生在两个响应事件之后。
Playwright 的网络文档在触发点击前创建响应 Promise,且第一行没有 await。这是事件订阅,不是搜索浏览器已经完成的网络历史。订阅前到达的匹配响应无法满足新建的等待;反过来,订阅后到达的响应可以匹配,不论测试此前是否点击过按钮。
时序图区分了提前注册的 POST 监听器与最终界面断言后才创建的监听器。图中文字描述的是自有测试页面的执行顺序;400 ms 是配置的超时值,不是测得的网络耗时。提前注册的监听器忽略 GET;过晚注册的监听器已没有后续 POST 可观察。
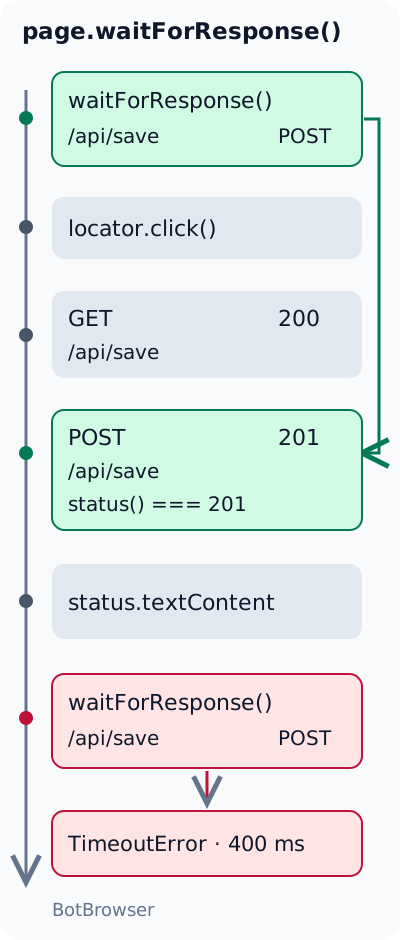
应用不需要拦截请求就能产生这种差异。一个小型 HTTP 服务器和原生 fetch() 处理器已经足够。自有测试的网络模拟指南介绍如何用受控响应替换依赖;这里有用的变量是测试何时订阅、接受哪个响应。让处理器顺序执行,就能稳定复现错误的首次匹配,而不依赖网速。
真实编辑器还可能发送分析请求、预检请求或后台刷新。它们的存在不会改变保存成功的含义。应根据自有 API 契约定义成功,而不是选择恰好在点击附近完成的任意请求。下方示例中的成功写入明确要求返回 201,包含 { revision: 7 },并产生对应状态文本。
复现真正注册过晚的监听器
最小失败条件是:订阅前响应已完成。仅将 waitForResponse() 放在 await button.click() 后一行,并不保证这个顺序,因为点击完成时网络操作可能仍在进行。这种写法存在竞态,但单次运行可能通过。确定性的演示应先等待最终状态,因为该自有页面只有在消费 POST 响应体后才渲染这个状态。
已有 Playwright 的 page 和 Node 断言模块时,下方故意注册过晚的变体明确展示了该顺序。它假设每次使用新加载的自有表单,只有一个名称唯一的 Save 按钮、一个状态元素,且没有自动重复的 POST。400 ms 超时用于限制反向检查的耗时,并不是推荐的生产等待时长。
const assert = require('node:assert/strict');

const savePost = response => new URL(response.url()).pathname === '/api/save' && response.request().method() === 'POST';

await page.getByRole('button', { name: 'Save', exact: true }).click();
await page
  .getByRole('status')
  .filter({ hasText: /^Saved revision 7$/ })
  .waitFor();

await assert.rejects(page.waitForResponse(savePost, { timeout: 400 }), error => error.name === 'TimeoutError');
这个反向断言只属于失败测试页面。应用测试在必需响应缺失时应失败,不能接受所有超时。检查异常名称,是为了避免将页面关闭、谓词格式错误或其他编程错误误判为预期的反向结果。
关键前提在于页面处理器。它执行 await fetch('/api/save'),消费该 JSON,执行 POST,消费该 JSON,然后渲染修订号。如果另一个应用在请求完成前就乐观显示成功消息,等待该消息并不能确定相同顺序。用界面状态证明响应已经发生前,应检查实际处理器或对应的 trace。
这个表单更新后没有轮询或重试。在存在后台 POST 的应用中,注册过晚的等待可能收到后续操作的响应,而不是超时。即使如此,也无法证明它观察到了原始保存。必要时应给并发或重复写入提供应用层身份,并在故意失败与修复后的变体之间重置状态,避免一次运行提供另一次运行所需的事件。
这个反向案例只支持一个有限结论:已完成的响应事件不会为新建的等待器重放。它不证明每次点击后立即设置响应等待都会失败。较慢的后端可能让这种不安全顺序连续数月看似可靠;更快的本地服务器则可能在浏览器毫无变化时暴露同一个竞态。
点击前注册并断言目标 POST
修复方法是将订阅移至操作前,并保留其 Promise。对于已加载表单 URL 的自有页面,下方模式可直接用于独立的 Playwright 脚本。它使用 Node 断言;Playwright Test 项目也可改用自身的 expect 断言检查响应值,并用自动重试的网页断言检查 DOM 状态。如果 Save 本身匹配多个控件,应先解决定位器的 strict mode violation,再将 POST 缺失归因于响应时序。
const assert = require('node:assert/strict');

const responsePromise = page.waitForResponse(
  response => new URL(response.url()).pathname === '/api/save' && response.request().method() === 'POST'
);

const [, response] = await Promise.all([
  page.getByRole('button', { name: 'Save', exact: true }).click(),
  responsePromise,
]);

assert.equal(response.status(), 201);
assert.deepEqual(await response.json(), { revision: 7 });
await page
  .getByRole('status')
  .filter({ hasText: /^Saved revision 7$/ })
  .waitFor();
assert.equal(await page.getByRole('status').innerText(), 'Saved revision 7');
调用 waitForResponse() 会立即创建订阅。保存这个 Promise 不会阻止后续点击。随后 Promise.all() 同时观察两个操作,使点击和响应等待各自的失败路径都得到保留。不要在触发点击前写 await page.waitForResponse(...),否则测试会在产生响应所需的操作之前暂停。
Response API 参考定义了 url()、request()、status() 和 json()。谓词使用解析后的响应 URL pathname,避免 /api/save-preview 之类的子串意外匹配。读取与写入共用端点,因此还要检查原始请求的方法。之后的状态断言回答另一个问题:这次具体写入是否返回了测试页面契约规定的成功状态码?
如果页面访问多个源,且它们存在相同路径,还应将 new URL(response.url()).origin 与预期 API 源比较。如果查询参数标识具体操作,应保留相关参数;只解析 pathname 就是有意忽略它们。示例假设只有一个自有源,每次点击只写入一次,因此增加这些身份规则在这里不会提高区分能力。
如果应用可能并发向 /api/save 发送多个 POST,仅有路径与方法还不够。自有记录标识、请求体字段或应用签发的操作标识都能用于区分。应验证预期字段,而非记录可能包含用户内容的整个请求体。即使请求身份完全准确,服务端结果仍可能失败;这两项判断应保持独立。
DOM 断言放在响应体验证之后,因为界面更新与响应可用是独立的。等待响应不代表应用的 Promise 回调已经渲染结果。因此,可能存在一个短暂窗口:测试已经拿到 POST 响应,状态却仍显示 Saving。等待特定结果可以处理这个转换,不必任意休眠一段时间。
最小自有服务器契约
复现可以使用任意回环地址 HTTP 服务器,提供下方表单,并为两个方法返回 JSON。将 GET /api/save 配置为 200 和 { "revision": 6 },将 POST /api/save 配置为 201 和 { "revision": 7 }。POST 接受 { "revision": 7 };演示响应选择不需要真正持久化数据。每个测试变体运行前都应重新加载表单。
<form>
  <label>Revision <input name="revision" type="number" value="7" /></label>
  <button type="submit">Save</button>
</form>
<p role="status">Not saved</p>
<script>
  document.querySelector('form').addEventListener('submit', async event => {
    event.preventDefault();
    const status = document.querySelector('[role="status"]');
    status.textContent = 'Saving';
    try {
      const current = await fetch('/api/save');
      if (!current.ok) throw new Error('Read failed');
      await current.json();
      const response = await fetch('/api/save', {
        method: 'POST',
        headers: { 'Content-Type': 'application/json' },
        body: JSON.stringify({
          revision: Number(document.querySelector('input').value),
        }),
      });
      if (!response.ok) throw new Error('Save failed');
      const saved = await response.json();
      status.textContent = 'Saved revision ' + saved.revision;
    } catch {
      status.textContent = 'Save failed';
    }
  });
</script>
应通过 HTTP 提供表单,而不是以本地文件打开,因为相对 fetch URL 需要服务器的源。该处理器是原创演示代码,并非生产表单实现。它有意展示读写顺序;验证、授权、存储和重复提交处理都属于实际应用契约。
2026-11-18,自有回环地址测试页面在 macOS arm64 上使用 Playwright 1.58.0 和标准 Chrome 157.0.8103.79 实际执行。三个变体的断言全部通过。故意注册过晚的订阅在配置的 400 ms 限制下抛出 TimeoutError。提前注册时,仅匹配路径的等待选中 GET 200,加入方法的等待选中 POST 201,界面进入 Saved revision 7。在错误变体中,加入方法的等待选中 POST 503,界面进入 Save failed。这些是本地事件选择结果,不是生产持久化或 BotBrowser 能力测量。
只匹配路径会接受错误的首个响应
监听器即使按时启动,也可能观察到错误操作。在顺序执行的 Save 处理器中,下方谓词会在 GET /api/save 返回 200 时完成,因为这是首个匹配响应。之后再等待这个 Promise 更久,也无法将选中的响应变成后续 POST。
const responsePromise = page.waitForResponse(response => new URL(response.url()).pathname === '/api/save');
const [, response] = await Promise.all([
  page.getByRole('button', { name: 'Save', exact: true }).click(),
  responsePromise,
]);
console.log(response.request().method(), response.status());
在这个测试页面中,GET 200 是读取请求的有效响应,不是浏览器偶发出错。只测试 response.ok() 会接受它,因为 200 与 201 都是成功的 HTTP 状态码。该断言只能证明所选 GET 成功,无法说明后续写入。修复方向是改进请求谓词,而不是延长超时。
同样,当写入契约要求 201 时,端点子串加 status() === 200 可能直接误导诊断。谓词应表达测试所需的操作,而不是浏览器开发者工具中某个看起来熟悉的状态码。诊断错误匹配时,应同时记录路径、方法与状态;单独的 URL 会掩盖这里展示的具体差异。
重定向也可能让一次操作关联多个响应。应匹配目标 API 操作及其文档规定的状态,不要将重定向目的地与写入视为可互换。如果产品有意修改 API 契约,应同时更新身份断言与结果断言。除非契约确实允许其他选项,否则不要默默接受所有 2xx 状态码。
保留可见的 HTTP 失败
排查时应先识别 POST,再断言成功。如果服务器为这次写入返回 503,路径加方法的等待仍可完成,而 assert.equal(response.status(), 201) 会报告非预期状态码。请求已被观察到,但应用操作不符合成功契约。带有 HTTP 错误的响应,与监听器从未收到响应,是不同情况。
下方写法只等待成功响应:
const successPromise = page.waitForResponse(
  response =>
    new URL(response.url()).pathname === '/api/save' &&
    response.request().method() === 'POST' &&
    response.status() === 201
);
当需求确实是在多次已知尝试中等待未来的某个 201 时,这个过滤条件可能合适。但它改变了诊断结果:503 不满足谓词,如果之后没有合格响应,Promise 最终会超时。此时超时表示没有响应匹配全部条件,并不一定表示 POST 不存在或监听器启动过晚。
解释响应体前,应先保留失败的响应状态。HTML 错误文档会让 response.json() 失败,从而使更有用的 HTTP 失败被解析异常遮盖。主修复代码先执行状态断言。需要更多错误细节时,应保留简短且已脱敏的诊断,不要将任意服务端页面或已认证的响应体完整输出至测试日志。
页面自身的 fetch 处理器也检查 response.ok,因此 POST 返回非成功状态码时,界面会进入 Save failed。测试已经观察到写入失败后,不应继续无限等待 Saved revision 7。错误路径测试可以有意断言错误响应与失败界面;正常路径测试则应在状态不符合预期时失败。
传输失败需要另一种观察:连接错误可能根本不产生可检查的 HTTP 响应对象。Playwright 为这种诊断提供请求事件。延长响应超时无法为从未收到响应的连接制造 HTTP 状态。读取失败运行记录时,应区分 HTTP 错误处理、网络失败处理与响应选择时序。
诊断缺失的信号
从能区分情况的最小观察开始。先确认等待器是否在操作前注册,再检查它实际选中的响应。匹配到 GET 200 的测试与选中 POST 503 的测试,缺陷不同,即使两者最终都未通过 Save 断言。下列判断适用于这个自有表单的契约。
| 观察结果 | 能证明什么 | 下一步检查 |
|---|---|---|
| 最终界面出现后,新建的 POST 等待超时 | 这个等待器没有观察到已完成的写入 | 将订阅移至点击前 |
仅匹配路径的等待返回 GET 200 | 选中了首个匹配的读取请求 | 增加请求方法身份 |
POST 等待返回 503 | 目标写入收到失败响应 | 检查自有端点的失败 |
POST 返回 201,界面仍为 Saving | 响应成功未证明渲染完成 | 检查响应体处理与界面转换 |
界面显示 Saved revision 7 | 该 DOM 状态已被渲染 | 分别验证响应及任何必需的持久化 |
失败依赖真实应用时序时,应使用 Playwright trace 工作流。比较同一次失败运行中的操作、网络条目和渲染状态。Trace 可以显示某个响应早于测试后续操作,但重新运行成功无法还原先前等待器选中了哪个响应。如果仅靠 trace 无法确定选择结果,应增加范围明确的谓词诊断。如果页面日志也缺失,应检查 console 监听是否在导航前注册,并将这些事件与 Node 脚本输出区分开。
不要在点击与响应等待之间添加 waitForTimeout()。它增加了错过快速响应的机会,却不提供操作身份。等待整个网络大致安静下来,回答的也不是是否观察到某个特定 POST。页面在 Save 完成后仍可能保持无关连接;也可能在应用回调尚未完成时就变得安静。
BotBrowser 的 Playwright 集成说明如何用 Playwright 控制其浏览器可执行文件,并用配置文件设置浏览器环境。在应用测试定义清楚后,这可以支持受控的浏览器比较。它不会修复监听顺序、选择正确的 POST、提供服务端持久化,也不保证端点接受写入。本地 HTTP 示例讨论的是 Playwright 事件处理,不是 BotBrowser 能力测量。
最后,应区分确认收到与持久化。这个测试页面没有数据库,却返回修订 7,因此即使 201 有效且最终界面正确,也无法证明数据在重启后或另一个会话中仍存在。业务要求持久化时,应在写入后增加适合该自有服务的独立回读。明确其一致性与授权要求,不要再次读取同一个乐观更新的 DOM 来代替。
常见问题
点击的自动等待包含 Save API 响应吗?
点击的可操作性检查关注 Playwright 能否对目标执行操作。它不会识别任意应用 API 响应,也不会断言其 JSON 结构。应为测试所需结果对应的操作注册专门的响应等待,同时保留可见结果断言。
谓词应使用 response.ok() 而不是精确状态码吗?
ok() 接受从 200 到 299 的状态码。如果该操作允许整个范围,可以使用它。契约要求 201 时,精确相等可以检测宽泛成功检查会接受的非预期 200 或 202。缺少请求身份时,这两种选择都无法区分 GET 与 POST。
为什么响应等待能在界面变化前完成?
响应事件与应用渲染流程属于不同阶段。响应变得可观察后,响应体读取、应用验证和 DOM 更新仍可能继续。response.json() 检查返回数据;专门的定位器断言检查最终状态元素。两者不能互相替代。
来源
- Playwright:网络
- Playwright:Response API
- Playwright:page.waitForResponse
- Playwright:请求事件
- Playwright:可操作性
- BotBrowser:Playwright 集成
实践结论
Playwright 需要在点击 Save 后等待响应时,应先注册等待,匹配目标写入,再检查 HTTP 结果与界面。可在自有的顺序执行表单上尝试过晚注册和提前注册两个变体:前者故意错过已完成的事件,后者保留目标 POST。只有需求包括持久化时,才增加单独的服务回读。
本文属于指南: 浏览器自动化入门:首次运行地图