API веб-скрейпинга: что остаётся за рамками ответа
Чем отличаются тело HTTP, HTML после рендеринга и извлечённые поля. Какие сведения о выполнении подтверждает ответ API веб-скрейпинга, а какие остаются неизвестными.
BotBrowser Team
Нужна структурированная документация по теме Отпечатки?
Эта статья относится к редакционной библиотеке. Для пошаговой настройки, справки и постоянных обновлений переходите сразу в соответствующий раздел docs.
API веб-скрейпинга может вернуть корректный JSON, оставив запрошенную информацию неподтверждённой. Здесь не хватает разграничения между артефактом, переданным вашему приложению, и выполнением, в результате которого он появился. Тело HTTP, документ после рендеринга и извлечённая цена позволяют делать разные выводы. BotBrowser предоставляет документированные средства управления профилем браузера и прокси, когда вы управляете его средой выполнения; он не может настроить браузер стороннего поставщика API или восстановить свидетельства выполнения, отсутствующие в ответе этого поставщика. При интеграции с возвращаемыми результатами полезно выяснять, какие свидетельства сопровождают каждое поле, а не насколько полным выглядит ответ.
Кратко
- Успешный запрос к API не подтверждает, что целевой сайт вернул нужный документ или что его данные полны.
- Исходные байты ответа и HTML после рендеринга браузером - разные входные данные для парсера, даже без изменений через JavaScript.
- Снимок результата может поступить после прерывания последовательности действий. Проверяйте результаты действий, а не считайте наличие HTML признаком завершения процесса.
- Возвращённые поля, сетевые захваты и снимки экрана сохраняют разные свидетельства. Ни один из них сам по себе не подтверждает всю среду браузера или историю обработки.
- Выбирайте контракт результата исходя из утверждения, которое должно проверить приложение. Разрешение на сбор, чувствительное состояние и последующее хранение рассматривайте отдельно от технического успеха.
Содержание
- У ответа несколько границ успеха
- Исходные байты и HTML после рендеринга - разные входные данные
- Снимок может сохраниться после незавершённой последовательности действий
- У структурированного поля есть история извлечения
- Непрерывность сессии не равна непрерывности браузера
- Возвращённые свидетельства не описывают все раскрываемые сигналы
- Контракт ответа явно обозначает неизвестное
- Практический вывод
У ответа несколько границ успеха
Первая граница - обращение к сервису. Аутентификация, проверка запроса и доставка результата относятся к этому взаимодействию с API. Вторая - ответ, полученный от целевого сайта. Третья - интерпретация доставленного артефакта вашим приложением. Успешный внешний ответ не объединяет эти границы. Сервис может корректно доставить страницу ошибки, а парсер - корректно декодировать её, не найдя ни одной записи. Если называть все три исхода «успехом», теряется информация, необходимая для диагностики пустого набора данных.
В документации Zyte по обработке ошибок явно различаются статус API и статус целевого сайта. Целевой 404 может присутствовать в успешном результате API в поле statusCode. Это документированный контракт ответа, а не независимо измеренное свойство каждого сервиса скрейпинга. Интеграция с другим поставщиком должна определить аналогичное поле и его значение. Иначе принятие внешнего 200 за 200 целевого сайта может превратить отсутствующую страницу в наблюдение, которое кажется достоверным.
Статус целевого сайта всё равно не удостоверяет содержимое. Ваше собственное приложение может обоснованно вернуть экран входа, пустую поисковую выдачу или временное служебное сообщение со статусом 200. Перед извлечением записей приложению нужна проверка типа документа. Это может быть известный заголовок каталога или заданная приложением структура записи в разрешённом тестовом образце. Цель проверки - классифицировать возвращённое представление, а не решить, разрешает ли сторонний сайт автоматизацию. Разрешение определяется применимыми полномочиями и условиями использования независимо от ответа сервера.
Перенаправления добавляют ещё одно различие. Справочник Zyte по HTTP указывает, что HTTP-запросы по умолчанию следуют перенаправлениям, и предоставляет followRedirect для изменения этого поведения. Справочник по браузеру указывает, что браузерные запросы следуют HTTP-перенаправлениям и изменениям URL, вызванным HTML или JavaScript. Поэтому переданный URL не обязательно определяет документ, который в итоге сериализуется. Сохраняйте конечный адрес, если контракт его предоставляет, и отличайте наблюдение перенаправления от вывода, основанного только на исходной строке запроса.
Обзор браузерных интерфейсов разделяет получение готового артефакта и дальнейшее управление браузером. После выбора API, возвращающего артефакты, ближайшей границей становится проверка результата. Команде не нужен рейтинг поставщиков, чтобы установить, получен ли документ ожидаемого типа. Ей нужна спецификация, определяющая статус целевого сайта, представление и обязательные поля приложения, с явно заданным состоянием неизвестности, если ответ не содержит необходимых свидетельств.
Исходные байты и HTML после рендеринга - разные входные данные
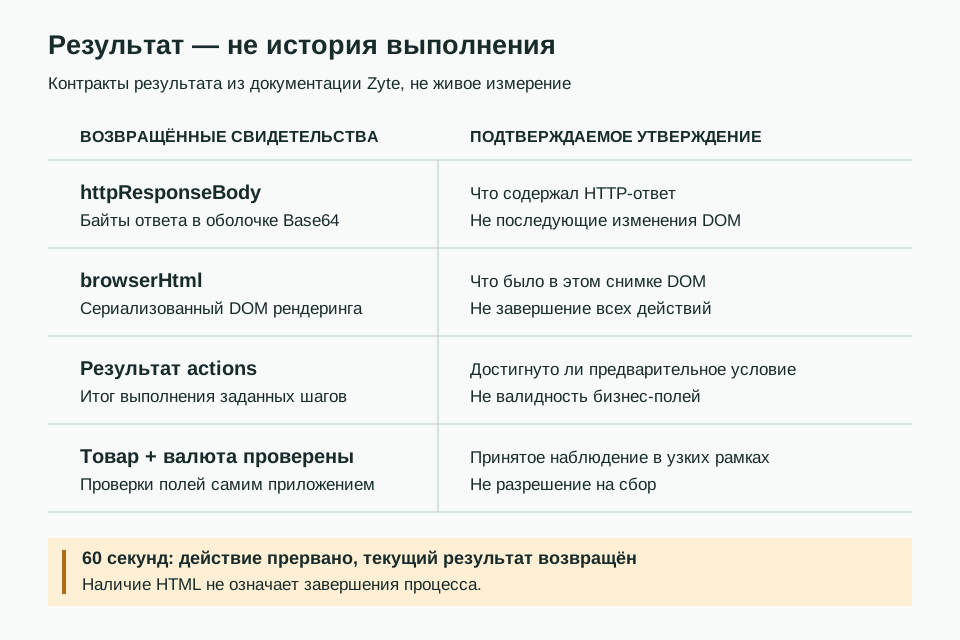
Zyte описывает httpResponseBody как тело HTTP-ответа, закодированное в Base64 и полученное без браузерного рендеринга. Base64 - транспортное представление байтов, а не указание кодировки символов документа. Декодирование оболочки возвращает исходные байты; интерпретация этих байтов как текста - отдельная операция. Документация по HTTP рекомендует использовать правила определения кодировки HTML и, где применимо, заголовки ответа. Поэтому искажённый символ с диакритикой в записи может быть проблемой декодирования текста, а не отсутствующей возможностью браузера.
В отличие от этого, browserHtml представляет DOM после рендеринга браузером. Скрипты могли добавить, удалить или переставить элементы, однако JavaScript - не единственная причина различий. Тот же справочник поясняет, что браузерный HTML включает нормализацию HTML5. Парсер, строящий из исходного ответа другое дерево, может давать иные результаты селекторов даже на странице без обновлений через скрипты. Утверждения «и то и другое - HTML» недостаточно, чтобы считать поведение при разборе взаимозаменяемым. Для миграции нужны репрезентативные тестовые входные данные, а не просто прежние расширения файлов.
Есть и ограничения представления. Zyte документирует предел 10 MB для тела HTTP до кодирования Base64 и предел 10 MB для браузерного HTML; более длинный результат обрезается. HTTP-сжатие не меняет первый предел. Это ограничения конкретного поставщика, а не общие свойства HTML или всех API. Если нужная запись находится за границей обрезанного результата, пустой результат парсера не доказывает, что запись отсутствовала на целевом сайте. Граница результата должна оставаться отдельным возможным объяснением.
В браузерном результате есть и структурные исключения. Zyte указывает, что содержимое iframe в browserHtml по умолчанию пусто, если не включён includeIframes, и ссылается на отдельную обработку содержимого shadow DOM. Поэтому сериализованный внешний документ не гарантирует, что каждый визуально представленный компонент попадёт в возвращённую строку. Снимок экрана может показывать компонент, текст которого отсутствует в этой сериализации. Это разные поверхности наблюдения, а не обязательно противоречащие друг другу результаты. Потребитель должен знать, для какой поверхности предназначен его парсер.
Для гипотетического тестового образца собственного продукта храните исходный ответ и документ после рендеринга как разные типы тестовых данных. Первый позволяет установить, что отправил сервер; второй - каким был сериализованный DOM в выбранный момент. Регрессию селекторов после перехода между ними следует сначала исследовать как изменение контракта входных данных. Разбор скрейпинга в headless-браузере рассматривает требования к выполнению браузера; он не отменяет необходимости точно определить представление, передаваемое последующему парсеру.
Снимок может сохраниться после незавершённой последовательности действий
Сервис артефактов может принять упорядоченную последовательность браузерных действий и вернуть результат после попытки их выполнить. Это не тот же контракт, что предоставление контроллеру неограниченного доступа к живому браузеру. Справочник Zyte по автоматизации браузера документирует общий лимит браузерного выполнения этих действий в 60 seconds. По достижении лимита текущее действие прерывается, последующие действия не выполняются, а запрошенный HTML или снимок экрана возвращается в виде, отрендеренном на тот момент. Поэтому доступный артефакт может сосуществовать с незавершённым процессом.
Это имеет конкретное последствие для последующих записей. Предположим, разрешённый тестовый каталог сначала открывает категорию, затем ожидает индикатор валюты, а потом считывает товар. Если ожидание прерывается, возвращённый документ может содержать валюту по умолчанию вместо запрошенной. Парсер всё ещё способен выдать синтаксически корректную цену. Сбой не обязательно связан с отсутствующим элементом или транспортной ошибкой API; причиной может быть невыполненное до снимка предварительное условие. Результат процесса должен включать и исход действия, и свидетельство о валюте.
Zyte документирует поле ответа actions, содержащее подробности выполнения, включая ошибки и временные характеристики. Его следует интерпретировать согласно документированной схеме, а не сводить к одному логическому значению «HTML присутствует». Действие, не выполненное после истечения срока, отличается от выполненного действия, селектор которого не нашёл элемент. Оба могут оставить похожий документ. Полезная диагностика определяет первое невыполненное предварительное условие приложения и сохраняет возвращённый артефакт для изучения в соответствии с политикой хранения данных.
Тот же справочник по браузеру отличает действия на основе селекторов от других интерфейсов: обычные селекторы действий не могут взаимодействовать с содержимым iframe или shadow DOM так же, как специализированные механизмы. Поэтому отсутствие элемента может отражать поддерживаемую область действия, а не медленную загрузку страницы. Произвольное увеличение ожидания не меняет эту область. Прежде чем объяснять результат длительностью, сопоставьте документированную поверхность действий с расположением нужного компонента. Это проверка контракта интерфейса, а не инструкция по доступу к защищённому содержимому.
Следовательно, момент формирования результата - часть смысла данных. Утверждение «цена наблюдалась» должно требовать соответствующий идентификатор товара, валюту и условие готовности приложения в том артефакте, из которого действительно получена цена. Снимок экрана с другого этапа не может незаметно восполнить недостающий контекст. Если контракт API не раскрывает достаточно свидетельств о действиях, классифицируйте результат как неразрешённый для данного сценария. Более узкое подтверждённое утверждение полезнее внешне полной строки, предварительные условия которой так и не были установлены.
У структурированного поля есть история извлечения
Некоторые сервисы возвращают разобранные записи, не оставляя каждый селектор вызывающей стороне. Документация Zyte по автоматическому извлечению описывает извлечение как ещё одну возможность вывода. Структурированное поле избавляет потребителя от непосредственного разбора, но также вводит границу интерпретации. Потребитель видит значение, выбранное или нормализованное механизмом извлечения. Если ответ не предоставляет соответствующие сведения о происхождении, само значение не позволяет установить исходный текст, положение в документе или связь с другим видимым значением.
Например, гипотетический каталог содержит текущую цену, зачёркнутую прежнюю цену и сумму платежа в рассрочку. Все три могут быть допустимыми числами в одном документе. Возвращаемому price нужно определение поля, поясняющее, какую роль оно представляет. Последующая схема должна сохранять валюту и идентификатор товара рядом со значением, а не предполагать, что их можно восстановить позже. Это пример контракта данных на стороне потребителя, а не утверждение о том, как конкретный сервис внутренне выбирает между конкурирующими значениями.
Выбор источника тоже важен. Различие HTTP-тела и браузерного HTML означает, что механизм извлечения, читающий байты ответа, может получить иной набор значений-кандидатов, чем механизм, читающий HTML после рендеринга. Изменение входного представления или настроек извлечения способно изменить то, что измеряет полученный временной ряд. Нормализованное поле может оставаться корректным по форме при изменившемся контексте выбора. Ведите версии контракта извлечения потребителя, чтобы последующий аналитик отличал кажущееся изменение рынка от изменения способа получения наблюдений.
Отсутствующие, пустые и непроверенные значения не должны сливаться в одно. Отсутствующее поле может означать, что механизм извлечения его не предоставил. Явно пустое значение может описывать возвращённый документ. Непроверенное значение может присутствовать, но не иметь свидетельств, необходимых для решения потребителя. Эти различия определяет бизнес-схема, даже если поставщик использует более простую структуру ответа. Хранение результата проверки рядом с исходным результатом поставщика позволяет не превращать каждое доставленное поле в принятый факт без явного решения.
Снимки экрана и захваченные сетевые ответы помогают разрешить некоторые вопросы, но не заменяют сведения о происхождении поля. Zyte описывает networkCapture как фильтрованный захват ответов во время рендеринга браузером, включая выполнение действий. Фильтр, захвативший один относящийся к делу ответ, не доказывает, что сохранён каждый запрос. Снимок экрана фиксирует видимые пиксели, а не полную историю запросов. Выбирайте дополнительные артефакты для разрешения конкретной неоднозначности и не собирайте постороннее содержимое аккаунта лишь потому, что сервис может вернуть больше данных.
Непрерывность сессии не равна непрерывности браузера
Метка сессии сервиса может означать более узкую гарантию непрерывности, чем постоянный браузер. Документация Zyte по общим возможностям описывает функции сессий; документация по CDP предоставляет отдельный интерфейс живого браузера. Потребители должны читать соответствующие правила сохранения состояния, а не предполагать, что повторные запросы выполняются в том же процессе рендеринга. Общие cookies или условия маршрутизации сами по себе не доказывают, что объекты JavaScript в памяти или ранее открытая страница сохраняются.
Различие становится заметным в многошаговом тестовом образце собственного приложения. Серверная настройка, представленная cookie, может сохраниться, тогда как временное значение только в переменной страницы исчезнет. Это разные места хранения и сроки жизни. Если процесс требует продолжения в той же живой странице, нужна непрерывность страницы, а не просто повторяющийся идентификатор сессии. Зафиксируйте это требование до выбора интерфейса. Иначе интеграция может принять новую страницу с запомненными cookies за тот же продолжающийся браузерный процесс.
Сетевая идентичность - ещё одно отдельное условие. Поставщик может документировать связанную с сессией маршрутизацию, не раскрывая фактический маршрут каждого подресурса. Возвращённая строка user-agent не доказывает свойства TLS-соединения, а параметр региона API не подтверждает независимо выходной адрес, наблюдаемый целевым сайтом. Ответ должен показывать, какие наблюдения предоставлены, а какие параметры лишь запрошены. Если сценарий касается трафика, полученного собственным приложением, его разрешённые серверные записи могут дать свидетельства, отсутствующие в возвращённом артефакте.
Особенности жизненного цикла конкретного поставщика уже рассматриваются в разборе ответственности Browserbase. Его конечные статусы и правила Context нельзя переносить на другой сервис лишь потому, что оба предлагают облачное выполнение. То же предостережение относится к повторным попыткам: документированные повторы библиотеки не доказывают, что произвольный HTTP-клиент или каждый запрос к бэкенду следуют той же политике. Разделяйте поведение поставщика, поведение SDK и решения вашего планировщика, определяя ответственность за повторную работу.
Возвращённые свидетельства не описывают все раскрываемые сигналы
Получение документа не перечисляет всё, что целевой сайт наблюдал при его создании. Браузер может раскрывать свойства, доступные скриптам, а сетевое соединение - предоставлять другую информацию. Ответ API - контракт результата, а не автоматически полный аудит таких раскрытий. Если он содержит HTML и снимок экрана, но не журнал выполнения с атрибуцией источника, он не позволяет установить, какой конкретный скрипт прочитал браузерный API. Обычную активность рендеринга и автоматизации нельзя переименовывать в свидетельства сбора данных поставщиком.
Обзор браузера BotBrowser документирует управление поверхностями браузера на основе профиля, а настройка прокси - маршрутизацию его собственной среды выполнения. Эти средства относятся к развёртыванию браузера, которым вы действительно управляете. Передача параметра локального исполняемого файла в собственный код автоматизации не может изменить исполняемый файл удалённого поставщика API, если тот явно не поддерживает такую настройку. Граница уровней остаётся важной, даже когда обе интеграции используют знакомую терминологию автоматизации.
Проверка конфиденциальности должна следовать фактическому пути данных: URL запроса и переданное состояние поступают в сервис; поставщик получает или рендерит содержимое; выбранные артефакты возвращаются; ваше приложение сохраняет или экспортирует их. Cookies, содержимое страницы, снимки экрана и отладочные артефакты могут нести информацию сверх итоговой бизнес-записи. Соответствующие условия хранения и обработки должны явно охватывать эти артефакты. Удаление одного возвращаемого поля не доказывает, что поставщик никогда не обрабатывал его источник, как и отказ от снимка экрана не устанавливает универсальную политику удаления.
Собственный тестовый образец позволяет уменьшить ненужное раскрытие при оценке контракта. Используйте безвредное содержимое и узко ограниченное состояние, затем проверяйте необходимые артефакты и результаты валидации. Это не подтверждает анонимность, юридическое соответствие или принятие целевым сайтом. Полномочия на сбор и разрешение передать содержимое обработчику остаются отдельными решениями, которые ни успешный парсер, ни согласованный профиль браузера не могут принять за оператора.
Контракт ответа явно обозначает неизвестное
Следующая таблица выбора относится к гипотетическому собственному каталогу. Она сопоставляет каждому предполагаемому утверждению необходимый тип свидетельств. Она не задаёт запрос к поставщику и не сообщает о проведённом эксперименте. Ожидаемый результат - решение проверки: принять узкое утверждение только при наличии соответствующих свидетельств; иначе сохранить неразрешённый исход. Так отсутствие наблюдаемости становится явным, а не превращается в догадку о причине.
| Предполагаемое утверждение | Необходимые свидетельства | Чего не устанавливает более слабый артефакт |
|---|---|---|
| Сервер предоставил эти байты | Исходное тело HTTP и соответствующие заголовки ответа | HTML после рендеринга может содержать нормализацию браузера и более поздние изменения |
| Этот текст существовал в сериализованном DOM | Идентифицированный снимок браузерного HTML и контекст конечного документа | Исходные байты не подтверждают текст, созданный скриптами |
| Шаг выбора валюты завершился | Документированный результат действия и наблюдаемое состояние валюты | Наличие снимка экрана не удостоверяет каждое предыдущее действие |
| Эта цена относится к этому товару | Идентификатор товара, валюта, роль поля и проверка приложением | Одинокое числовое поле не различает платёж в рассрочку и текущую цену |
| Продолжился тот же процесс страницы | Документированный жизненный цикл живой страницы и соответствующие свидетельства процесса | Общие cookies не доказывают сохранение процесса рендеринга или объекта страницы |
| Конкретный скрипт прочитал сигнал | События выполнения с атрибуцией источника из того же выполнения | HTML, число запросов и метка результата не определяют читателя |
Рассмотрим три синтетических случая с одинаковым внешним 200. В случае A statusCode равен 404, поэтому извлечение записей не предпринимается. В случае B браузерный HTML содержит товар, но результат действия указывает на прерывание до готовности валюты; цена остаётся непроверенной. В случае C условие действия и обязательные поля товара подтверждены, поэтому приложение может принять это ограниченное наблюдение. Это предлагаемые правила валидации, а не измерения надёжности поставщика или обещания о поведении целевого сайта.
Сохраняйте только свидетельства, необходимые для объяснения этого решения, связывая принятую запись с её ограниченными сведениями о происхождении. Если предел результата, пропущенный iframe, недоступный исход действия или неподдерживаемое требование сохранения состояния мешают проверке, фиксируйте конкретную неопределённость. Контракты HTTP и браузера дают конкретные различия, которые общее поле «запрос выполнен успешно» передать не может. Тогда потребитель может отклонить или изолировать неразрешённую запись, не выдумывая объяснение удалённого выполнения.
Вопросы и ответы
Означает ли ответ API со статусом 200, что целевая страница загрузилась успешно?
Не обязательно. Транспортный статус API и статус целевого сайта могут быть отдельными полями. Целевому документу также нужна проверка, учитывающая специфику приложения.
Браузерный HTML - это просто исходный HTML после декодирования?
Нет. Он представляет DOM браузера, включая нормализацию HTML и возможные изменения скриптами. Декодирование тела HTTP из Base64 вместо этого возвращает байты.
Доказывает ли возвращённый HTML выполнение всех запрошенных действий?
Нет. Zyte документирует прерванные последовательности действий, которые всё равно возвращают текущий результат. Исходы действий и требуемое состояние страницы нужно проверять отдельно.
Может ли BotBrowser настроить браузер облачного API скрейпинга?
Такую возможность могла бы обеспечить только явно поддерживаемая поставщиком интеграция. Средства управления собственной средой выполнения BotBrowser не настраивают автоматически посторонний удалённый сервис.
Источники
- Zyte: HTTP-запросы
- Zyte: Автоматизация браузера
- Zyte: Автоматическое извлечение
- Zyte: Обработка ошибок
- Zyte: Общие возможности
- Zyte: CDP
- BotBrowser: Обзор браузера
- BotBrowser: Настройка прокси
Практический вывод
Выбирайте результат API веб-скрейпинга исходя из утверждения, которое должно проверить ваше приложение: байты сервера, отрендеренный текст, завершённое действие или проверенная запись. Требуйте соответствующих свидетельств и сохраняйте неразрешённое состояние, если они недоступны. Оценивайте этот контракт на разрешённых безвредных тестовых образцах, прежде чем отправлять чувствительное состояние или опираться на возвращённые поля в рабочих решениях.
Эта статья входит в руководство: Что такое отпечаток браузера?
Похожие статьи
Браузер для веб-скрейпинга: какой вариант нужен?
Начало работыВеб-скрейпинг с Browserbase: кто за что отвечает?
ОтпечаткиRebrowser Patches: что меняется после настройки прокси?
СетьCloudflare и DataDome: ответы при сборе данных
Начало работыWeb scraping JavaScript: рендер, пагинация, скролл
Начало работыСбор данных Selenium: capabilities и записи
Выполните ту же проверку в BotBrowser
Загрузите профиль, сохраните внутри браузера те сигналы, о которых только что прочитали, и подтвердите результат на своей машине до раскатки.