Финансовые данные: требования к браузеру
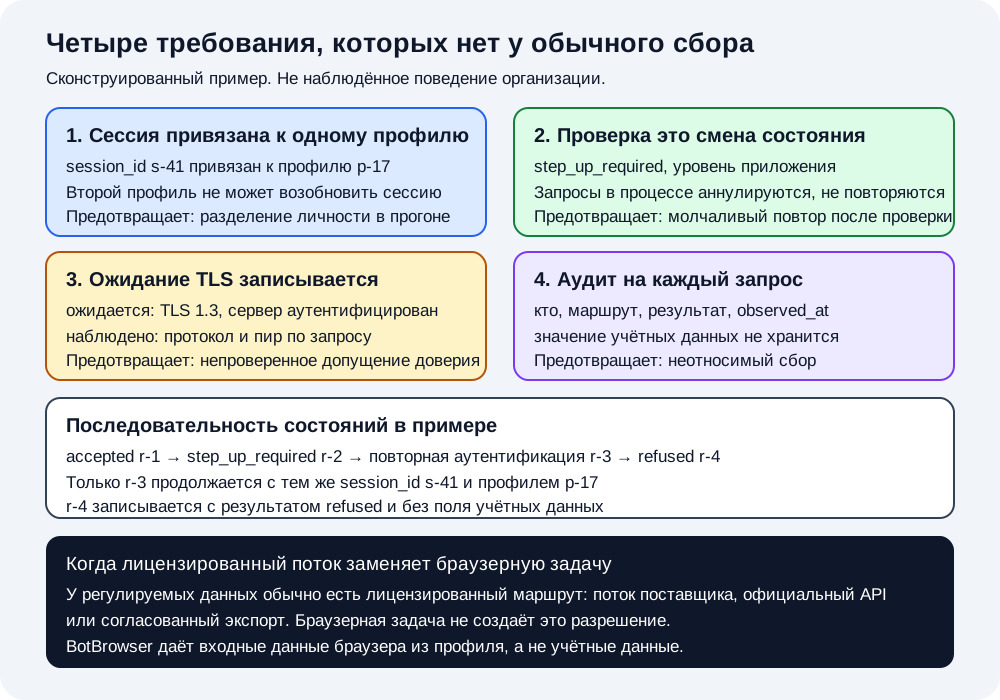
Четыре требования, которые сбор регулируемых данных добавляет к обычному сбору: привязка сессии, повторная проверка как смена состояния, записанный TLS-канал и аудит.
BotBrowser Team
Нужна структурированная документация по теме Идентичность?
Эта статья относится к редакционной библиотеке. Для пошаговой настройки, справки и постоянных обновлений переходите сразу в соответствующий раздел docs.
Сбор финансовых данных не является более сложной версией обычного сбора страниц: это другая задача, поскольку за источником обычно стоят учётная запись, сессия, требование повторной проверки и соглашение о данных. BotBrowser документирует наборы отпечатков на контекст и значения браузера из профиля, поэтому сессия сбора может оставаться привязанной к объявленной личности. Он не аутентифицируется в финансовой организации, не хранит учётные данные, не проходит многофакторную проверку и не заменяет лицензированный поток. Подтвердите разрешённый маршрут ещё до проектирования задачи.
Кратко
- У регулируемых финансовых данных обычно есть лицензированный маршрут. Сначала найдите поток поставщика, официальный API или согласованный экспорт, а браузерную задачу считайте резервным вариантом, требующим собственного обоснования.
- Привязывайте одну аутентифицированную сессию к одному профилю. Прогон, который возобновляет ту же сессию под вторым профилем, уже потерял способность сказать, кем он был.
- Повторная проверка это смена состояния. Запросы, отправленные до неё, аннулируются и не повторяются.
- Записывайте ожидание TLS, на которое опираетесь, и свойства канала, которые действительно наблюдали. «Соединение установлено» не является утверждением аудита.
- Ведите аудит на каждый запрос с маршрутом, результатом и временем, и никогда не храните значение учётных данных.
Содержание
- Четыре требования, которых нет у обычного сбора
- Привязка сессии к профилю
- Повторная проверка как смена состояния
- Запись ожидания TLS и наблюдаемого канала
- Построение аудита на каждый запрос
- Когда ответом является лицензированный поток
- Практический вывод
Четыре требования, которых нет у обычного сбора
Обычный сбор страниц описывается URL, парсером и расписанием. Задача с регулируемыми данными должна ещё ответить, кем она была, что ей было разрешено и что произошло, когда источник её прервал. Эти вопросы не входят в общий контрольный список, и их отсутствие даёт набор данных, который потом никто не сможет защитить.
| Требование | Предотвращаемый сбой | Поле записи |
|---|---|---|
| Сессия привязана к профилю | Сессия незаметно возобновляется под второй личностью | session_id, profile_id |
| Повторная проверка как состояние | Запросы в процессе повторяются после требования проверки | auth_state, voided_at |
| Записанное ожидание TLS | Непроверенное допущение, что канал был аутентифицирован | expected_channel, observed_channel |
| Аудит на каждый запрос | Сбор, который нельзя отнести к разрешённому прогону | request_id, outcome, observed_at |
За каждой строкой стоит конкретный сбой, а не общий принцип. Первая не даёт прогону разделить свою личность на середине. Вторая не даёт клиенту счесть требование проверки временной ошибкой, достойной повтора. Третья не даёт «запрос прошёл» подменить «канал был тем, что я предполагал». Четвёртая не даёт набору данных, происхождение которого существует только в чьей-то памяти о прогоне.
Привязка сессии к профилю
MDN описывает заголовок Authorization как способ для агента пользователя передать учётные данные, аутентифицирующие его на сервере, обычно после того как сервер ответил на первый запрос кодом 401 Unauthorized и заголовком WWW-Authenticate. Это описание одного обмена запросом и ответом. Сессия сбора длиннее: она охватывает много запросов, может быть привязана к cookie или токену, и сервер решает, действительна ли она.
Следствие для браузерной задачи в том, что сессию и личность браузера нужно связывать и записывать вместе. Если прогон начинается под одним профилем, встречает проблему и возобновляется под другим, полученные данные пришли из сессии, объявленная личность которой сменилась на ходу. Даже если каждый отдельный запрос прошёл, прогон больше не может сказать, кем он был.
Анализ непрерывности сессии отделяет сохранение на клиенте от принятия на сервере: хранить cookie не то же самое, что сервер её соблюдает. Здесь это различие важнее, потому что финансовый источник обычно привязывает сессию к большему, чем cookie. Записывайте привязку явно, парой, и отказывайтесь продолжать, когда меняется любая из половин.
Документация BotBrowser по отпечаткам на контекст описывает назначение набора отпечатков объекту BrowserContext, причём каждый контекст несёт свой файл профиля, агент пользователя, часовой пояс, локаль и прокси. Это механизм, с помощью которого задача сбора может держать объявленную личность контекста стабильной всю сессию. Это входные данные браузера: они не делают сессию разрешённой и не сообщают, считает ли сервер её ещё действительной.
Две операционные привычки позволяют привязке пережить реальный прогон. Первая: назначать идентификатор сессии до создания контекста и отказываться создавать второй контекст для той же сессии. Порядок важен, потому что созданный первым контекст спокойно примет сессию, которая уже существует в другом месте, а дубликат обнаружится только когда источник аннулирует одну из них. Назначение сначала превращает позднюю и запутанную инвалидацию в немедленную локальную ошибку.
Запись профиля с ротацией прокси описывает ту же дисциплину назначения при смене маршрута, а путь пользователя с passkey показывает, почему учётные данные и открываемая ими сессия должны оставаться разными объектами. Вторая привычка: записывать привязку в момент её создания, а не восстанавливать потом из журналов. Запись, сделанная при назначении, может включать идентификатор прогона, идентификатор профиля и аргументы запуска контекста, то есть ровно те факты, которые нужны рецензенту и которые труднее всего восстановить. Восстановление из журнала означает сопоставление отметок времени между двумя системами, а это сопоставление ломается именно в интересном случае.
У привязки есть и сторона завершения. Когда прогон заканчивается, контекст нужно закрыть, а сессию отметить закрытой в той же записи. Сессия, оставленная открытой в учёте при исчезнувшем браузере, рано или поздно будет возобновлена более поздним прогоном, который считает, что продолжает нечто, и полученные данные охватят две разные личности без указания на это. Закрывать обе половины вместе это небольшая дисциплина, устраняющая целый класс вопросов о происхождении.
Наконец, отличайте привязку от учётных данных. Привязка утверждает, какой профиль нёс сессию. Учётные данные это материал, доказывающий сессию. Запись прогона может безопасно нести первое и никогда не должна нести второе, потому что первое это идентификатор, а второе секрет. Явная граница в схеме не даёт более поздней функции, например отладочному экспорту, случайно отправить учётные данные в набор данных.
Повторная проверка как смена состояния
Повторная проверка это точка, где источник требует больше доказательств, чем сессия несёт в этот момент. Она обычна в финансовых интерфейсах и часто обрабатывается кодом сбора неправильно, потому что приходит как обычный на вид HTTP-ответ.
RFC 8446 описывает канал TLS и его свойства аутентификации, включая то, что сторона сервера аутентифицируется всегда, а клиент опционально. Повторная проверка находится на другом уровне: это требование приложения снова что-то доказать. Их легко спутать, когда оба проявляются в одном неудачном запросе, и ошибка ведёт к коду, который повторяет запрос вместо смены состояния сессии.
Модель состояний ниже сконструирована, а не наблюдалась в какой-либо организации. Она существует, чтобы сделать переход явным и не дать клиенту продолжить молча.
| Событие | Состояние сессии после события | Что происходит с работой в процессе |
|---|---|---|
| Запрос принят | authenticated | Продолжается |
| Возвращена проверка | step_up_required | Аннулируется; каждый запрос переклассифицируется отдельно |
| Повторная аутентификация пройдена | снова authenticated | Только новая работа; аннулированное не повторяется |
| Запрос отклонён по политике | refused | Записывается как результат, не повторяется |
Третья строка чаще всего обрабатывается неверно. После повторной аутентификации сессия снова пригодна, и это соблазняет повторить всё, что не удалось во время проверки. Эти запросы были сделаны в состоянии, которое источник уже отклонил, поэтому их повтор даёт наблюдения, не относимые к текущему разрешению. Аннулируйте их, зафиксируйте аннулирование и запустите новую работу.
Четвёртая строка охватывает случай, когда источник отказывает по политике, а не требует дополнительных доказательств. Это не технический сбой, и повтор ничего не изменит. Запишите отказ с причиной, остановите прогон и вернитесь к вопросу о разрешённом маршруте вместо того, чтобы считать это временной ошибкой.
У проверки есть и временнáя сторона, которую таблица состояний не охватывает. Запросы, отправленные до проверки, могли быть приняты источником, и их ответы могут ещё быть в пути, когда проверка приходит. Эти ответы не становятся недействительными из-за опоздания; они недействительны как свидетельство о текущем состоянии, потому что состояния, к которым они относятся, больше нет. Клиент должен классифицировать каждый по состоянию, в котором он был отправлен, а не по тому, что действует при завершении.
У этого правила есть практическое следствие для пакетной обработки. Задача, которая отправляет сотню запросов и затем обрабатывает результаты в порядке завершения, перемешает наблюдения из двух состояний без всякой пометки. Задача, которая отправляет ограниченными группами и проверяет состояние между группами, сохраняет границу видимой. Размер группы это решение о пропускной способности, но проверка границы это решение о корректности, и её не следует ослаблять ради экономии одного обмена.
Политика повторов относится к той же модели. Тайм-аут в состоянии authenticated разумно повторить один раз с новым идентификатором запроса, потому что состояние не изменилось. Тайм-аут во время step_up_required повторять нельзя, потому что повтор перенёс бы запрос в состояние, которое источник уже отклонил. Запись этого различия в функцию повтора, а не в окружающий текст, и сохраняет модель верной после следующего рефакторинга.
Запись ожидания TLS и наблюдаемого канала
Ожидания TLS в задаче с регулируемыми данными обычно формулирует контрагент, а не клиент. Роль клиента записать, на что он опирался и что действительно видел, чтобы более поздний рецензент мог сказать, совпали ли они.
Анализ доверия к соединению охватывает проверку сертификатов и сигналы, которые браузер показывает о соединении. Задаче сбора сверх этого нужно гораздо меньше: объявленное ожидание, наблюдаемое значение и правило решения при расхождении. Ожиданием может быть версия протокола, требование аутентификации сервера или конкретная политика контрагента. Наблюдаемое значение это то, что клиент действительно может прочитать для этого запроса.
Два режима отказа стоит назвать, потому что оба выглядят как успех. Первый это молчаливое понижение: соединение устанавливается, данные приходят, и никто не проверяет, был ли согласованный канал тем, что предполагало соглашение. Второй это ошибка охвата: оператор проверяет канал один раз в начале прогона и затем предполагает, что он сохранился для каждого следующего запроса. Записывайте на каждый запрос или как минимум на соединение с явной границей и указывайте, какой из двух вариантов вы выбрали.
// Constructed fixture: four requests in one run, one channel expectation.
const EXPECTED_CHANNEL = { protocol: 'TLSv1.3', serverAuthenticated: true };
const RUN = { runId: 'run-7', sessionId: 's-41', profileId: 'p-17' };
const requests = [
  {
    requestId: 'r-1',
    route: 'positions',
    protocol: 'TLSv1.3',
    serverAuthenticated: true,
    outcome: 'accepted',
    observedAt: '2026-11-10T09:00:00Z',
  },
  {
    requestId: 'r-2',
    route: 'balances',
    protocol: 'TLSv1.3',
    serverAuthenticated: true,
    outcome: 'step_up_required',
    observedAt: '2026-11-10T09:00:04Z',
  },
  {
    requestId: 'r-3',
    route: 'balances',
    protocol: 'TLSv1.3',
    serverAuthenticated: true,
    outcome: 'accepted',
    observedAt: '2026-11-10T09:03:10Z',
  },
  {
    requestId: 'r-4',
    route: 'statements',
    protocol: 'TLSv1.2',
    serverAuthenticated: true,
    outcome: 'refused',
    observedAt: '2026-11-10T09:03:12Z',
  },
];

const rows = requests.map(r => ({
  request_id: r.requestId,
  run_id: RUN.runId,
  session_id: RUN.sessionId,
  profile_id: RUN.profileId,
  route: r.route,
  outcome: r.outcome,
  observed_at: r.observedAt,
  channel_matches:
    r.protocol === EXPECTED_CHANNEL.protocol && r.serverAuthenticated === EXPECTED_CHANNEL.serverAuthenticated,
}));

const lines = rows.map(
  r =>
    `request_id=${r.request_id} run_id=${r.run_id} session_id=${r.session_id} profile_id=${r.profile_id} ` +
    `route=${r.route} outcome=${r.outcome} channel_matches=${r.channel_matches} observed_at=${r.observed_at}`
);
console.log(lines.join('\n'));
Сконструированный вывод фиксирует один принятый запрос, один переход проверки, одно принятое продолжение и один отказ, и показывает, что r-4 расходится по каналу:
request_id=r-1 run_id=run-7 session_id=s-41 profile_id=p-17 route=positions outcome=accepted channel_matches=true observed_at=2026-11-10T09:00:00Z
request_id=r-2 run_id=run-7 session_id=s-41 profile_id=p-17 route=balances outcome=step_up_required channel_matches=true observed_at=2026-11-10T09:00:04Z
request_id=r-3 run_id=run-7 session_id=s-41 profile_id=p-17 route=balances outcome=accepted channel_matches=true observed_at=2026-11-10T09:03:10Z
request_id=r-4 run_id=run-7 session_id=s-41 profile_id=p-17 route=statements outcome=refused channel_matches=false observed_at=2026-11-10T09:03:12Z
Эта строка и есть причина существования записи. Принятый запрос по каналу, которого задача не ожидала, не является чистым наблюдением, и набор данных должен показывать это без повторного чтения журналов.
Решение о том, что делать с расходящейся строкой, это вопрос политики, и ответ на него нужен до первого прогона, а не во время инцидента. Три варианта защитимы: отклонить строку и остановиться, принять её с пометкой, чтобы последующий анализ мог исключить, или принять и записать расхождение как предупреждение. Правильный выбор зависит от того, что говорит соглашение с контрагентом, поэтому решение принадлежит письменной основе прогона, а не коду, который заметил расхождение.
Механизму наблюдения тоже нужна объявленная граница. Скрипт уровня страницы не может прочитать согласованный протокол собственного соединения; значение должно приходить из сетевой инструментации браузера или из клиента, сделавшего запрос. Записывать поле канала, заполненное допущением, хуже, чем оставить его пустым, потому что пустое поле вызывает вопрос, а предположенное его закрывает. Там, где значение действительно недоступно, записывайте, что оно недоступно и почему.
Дрейф версий это последняя часть. Прогон, растянутый на недели, может застать смену поддерживаемых протоколов у контрагента, и ожидание, записанное в начале, постепенно станет неверным. Привяжите ожидание к дате и перепроверяйте его при продлении прогона. Ожидание без даты читается как действующее, и это тот же молчаливый сбой понижения в более медленной форме.
Построение аудита на каждый запрос
Аудит отвечает на четыре вопроса по каждому запросу: какой прогон его сделал, под какой личностью, что вернул источник и когда. Всё остальное это вспомогательные детали. Запись ниже является артефактом приложения и намеренно не несёт значения учётных данных.
| Поле | Содержимое | Зачем оно в записи |
|---|---|---|
request_id | Непрозрачный идентификатор этого запроса | Связывает запись со строкой журнала без раскрытия содержимого |
run_id | Идентификатор разрешённого прогона | Относит запрос к разрешению |
session_id | Идентификатор сессии, никогда не токен | Показывает личность, сделавшую запрос |
profile_id | Профиль, с которым запущен контекст | Показывает объявленную личность браузера |
route | Класс эндпоинта, а не полная строка запроса | Описывает запрос без сохранения параметров |
outcome | accepted, step_up_required, refused | Делает смену состояния явной |
observed_at | Время в UTC | Упорядочивает запросы и ограничивает прогон |
channel | Протокол и результат аутентификации | Записывает, чем разрешилось ожидание TLS |
Два поля заслуживают пояснения. session_id это не токен. Хранение bearer-токена в таблице аудита превращает аудит в хранилище учётных данных, что хуже проблемы, которую запись должна была решить. Записывайте непрозрачный идентификатор и хеш, если нужно сравнить две записи одной сессии. То же рассуждение относится к route: записывайте класс эндпоинта вместо полного URL с параметрами запроса, потому что эти параметры часто несут идентификаторы счёта или инструмента, которые аудиту не нужны.
Жизненный цикл сессии на общих рабочих станциях применяет родственное правило к переиспользованию между пользователями: запись о том, кто держал сессию, важна не меньше самой сессии. Задача сбора с одним профилем на прогон проще, но всё равно нуждается в том же отнесении.
Записи также нужна политика хранения, отдельная от прогона. Аудит, удаляемый вместе с рабочими данными, не может ответить на вопрос через квартал, а хранимый бессрочно накапливает персональные данные, которые задаче никогда не были нужны. Определите срок из соглашения и из вопроса, на который запись должна отвечать, запишите его и сделайте удаление явным плановым действием, а не случайностью уборки.
Доступ к аудиту это второе решение. Он часто содержит идентификаторы счёта и классы эндпоинтов, которые вместе описывают активность клиента подробнее, чем сам набор данных. Ограничьте его теми, кто должен отвечать на вопросы о происхождении, и журналируйте чтение аудита наравне с записью. Система происхождения, не способная сказать, кто её просматривал, имеет тот же недостаток, который должна была устранить. Проверяемость не является разрешением: аудит показывает, что прогон состоялся и не был изменён после, и не доказывает, что прогон был разрешён.
Наконец, сделайте запись проверяемой. Запись с цепочкой хешей или с периодическим дайджестом, записанным вне места записи, может показать, что её не изменяли после факта. Это свойство важнее всего именно в ситуации, для которой запись существует: спор о том, что сделал прогон. Простая таблица лучше, чем ничего, но таблица, которую автор может молча переписать, является более слабым доказательством, чем подсказывает её содержимое.
Когда ответом является лицензированный поток
У большинства регулируемых финансовых данных есть маршрут без браузера. Поставщик рыночных данных, официальный API, агрегированный экспорт или договорный поток дают те же значения с определённой схемой, объявленной частотой обновления и лицензией, где сказано, что с ними можно делать. Когда такой маршрут есть, браузерная задача обычно является неверным инструментом: она даёт менее стабильный набор с большей юридической экспозицией для источника, который уже предлагал поддерживаемый путь.
Честное правило решения поэтому не «может ли браузер добраться», а «есть ли разрешённый маршрут и, если нет, что именно разрешает этот». Если ответ на вторую половину это чьё-то воспоминание о письме, это не разрешение. Запишите маршрут и его основание в запись прогона, чтобы следующий человек унаследовал ответ, а не допущение.
Тип FinancialProduct в schema.org хорошо иллюстрирует границу. Он определяет словарь для описания финансового продукта со свойствами вроде annualPercentageRate и interestRate и отмечает, что годовая процентная ставка отличается от расчётной процентной ставки. Этот словарь говорит, как называть поля; он ничего не говорит о том, публикует ли их источник, актуально ли опубликованное значение и можно ли их собирать.
Вопросы и ответы
Означает ли успешный вход, что сбор разрешён?
Нет. Аутентификация устанавливает, кем является сессия, а не что оператор может делать с данными. Разрешение исходит из условий организации или отдельного соглашения, и работающая сессия не заменяет ни то ни другое.
Может ли та же сессия продолжаться после повторной проверки?
Может, после завершения повторной аутентификации, но работа, выполненная во время проверки, не входит в это продолжение. Аннулируйте эти запросы, запишите аннулирование и начните новую работу в новом состоянии.
Должен ли аудит хранить токен доступа?
Нет. Храните непрозрачный идентификатор сессии и при необходимости хеш. Хранить сам токен там нельзя по той же причине.
Аутентифицируется ли BotBrowser в финансовой организации?
Нет. Он предоставляет документированные входные данные браузера из профиля, включая наборы отпечатков на контекст, чтобы сессия оставалась привязанной к объявленной личности. Учётные данные, проверки и лицензии на данные остаются вне его области.
Источники
- Заголовок Authorization в MDN
- RFC 8446 TLS 1.3
- schema.org FinancialProduct
- Отпечатки на контекст в BotBrowser
- Обзор отпечатков в BotBrowser
Практический вывод
Начинайте с разрешённого маршрута. Если есть лицензированный поток или официальный API, используйте его и держите браузерную задачу вне проекта. Там, где браузерная задача является поддерживаемым путём, привяжите сессию к профилю, смоделируйте повторную проверку как переход, аннулирующий работу в процессе, записывайте ожидание TLS рядом с наблюдаемым каналом для каждого запроса и ведите аудит, называющий прогон, личность, результат и время без хранения учётных данных. Эти четыре требования и делают набор регулируемых данных защитимым после завершения прогона.
Эта статья входит в руководство: Поверхности идентичности браузера: обзор согласованности
Похожие статьи
CAPTCHA при сборе данных: диагностика смены ответа
ИдентичностьPasskeys и WebAuthn: путь входа в браузере
СетьCloudflare и DataDome: ответы при сборе данных
СетьРотация прокси: границы сессии при сборе данных
РазвертываниеСбор данных Amazon: источники и границы браузера
СетьСкрапер заблокирован: ошибки DNS, TLS, HTTP и страницы
Выполните ту же проверку в BotBrowser
Загрузите профиль, сохраните внутри браузера те сигналы, о которых только что прочитали, и подтвердите результат на своей машине до раскатки.