curl-impersonate и curl_cffi: пределы паритета TLS
Три клиента и один слушатель: что повторяет HTTP-клиент с имитацией TLS, почему он отличается одной расшифровкой расширений и какой слой страницы ему недоступен.
BotBrowser Team
Нужна структурированная документация по теме Отпечатки?
Эта статья относится к редакционной библиотеке. Для пошаговой настройки, справки и постоянных обновлений переходите сразу в соответствующий раздел docs.
HTTP-клиент можно настроить так, чтобы он отправлял рукопожатие, очень похожее на браузерное, и сходство заканчивается на первой поверхности, которой нужен документ. BotBrowser предоставляет объявленный профиль, который держит поверхности, читаемые страницей, согласованными между собой, включая доступные из JavaScript, и не заменяет браузер, когда нужен документ. Измерение ставит трёх клиентов против одного локального слушателя: бинарник curl, Python-клиент с имитацией Chrome и сам Chrome. Разница между двумя последними и есть полезная часть, потому что она достаточно мала, чтобы её пропустить.
TL;DR
- Три клиента отправили три разных рукопожатия одному слушателю: curl
t13i4906h2, Nodet13i521000, Chromet13d1517h2. - Клиент, которому задали имитировать Chrome, выдал
t13d1516h2: совпадение по числу шифров и расхождение в одном расширении. - Разница в расширении и есть интересное: почти совпадение, где опущено одно расширение, всё равно остаётся различимым значением.
iпротивdв этих префиксах это флаг доменного имени; подключение по адресу и подключение по имени дают два разных отпечатка.- curl на этой машине связан с SecureTransport, а не с OpenSSL, поэтому наборы шифров и расширений берутся из библиотеки TLS, отличной от той, которую предполагает большинство руководств.
- У HTTP-клиента нет DOM, canvas и WebGL, поэтому любой сигнал с этих поверхностей просто отсутствует, а не рассогласован.
- Установка заголовка user agent меняет то, что читает сервер, и не меняет того, что говорит рукопожатие.
- Совпадение на уровне соединения и совпадение на уровне страницы это две отдельные задачи с двумя отдельными наборами инструментов.
Содержание
- Три клиента против одного слушателя, и что именно повторяет имитация
- Библиотека под капотом определяет значение
- Слой, которого у HTTP-клиента нет
- Чем обходится почти совпадение, и практический вывод
Три клиента против одного слушателя, и что именно повторяет имитация
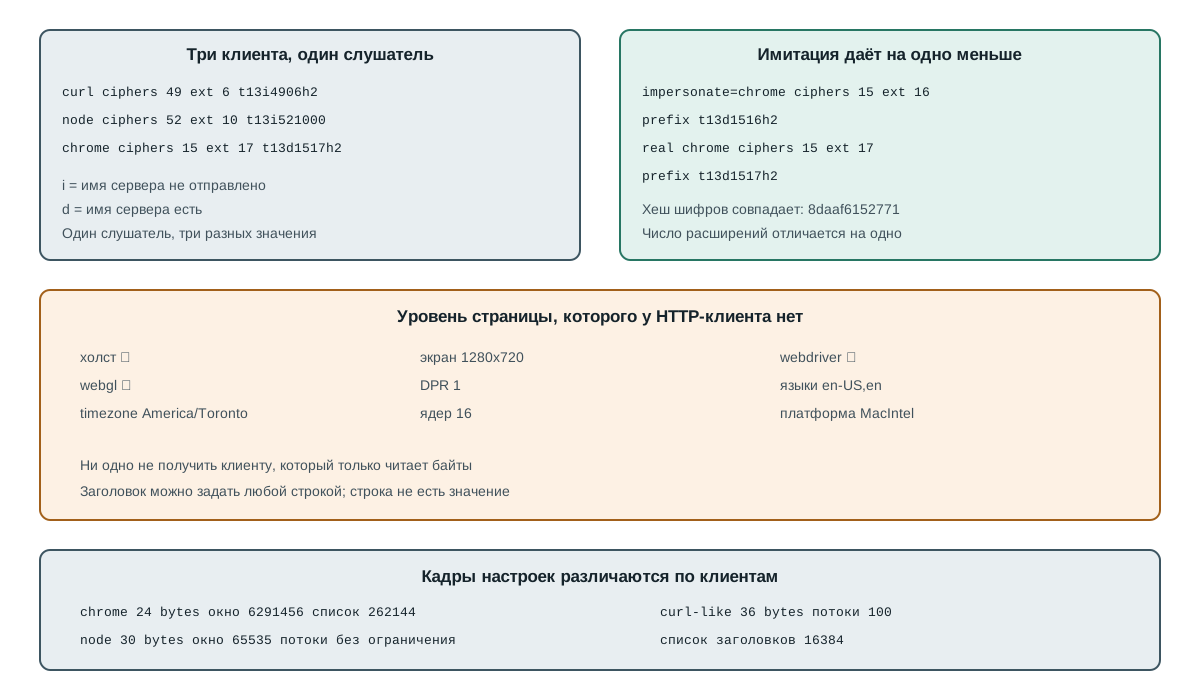
Измерение намеренно небольшое. TCP-слушатель на интерфейсе обратной петли принимает соединение, записывает первую запись и закрывается; рукопожатие так и не завершается, поэтому сертификат сервера не участвует и решение о доверии не вмешивается. Каждый клиент по очереди направляется на этот адрес.
curl:   bytes=301  alpn=h2,http/1.1 ciphers=49 exts=6  versions=0x0304,0x0303,0x0302,0x0301
        ja4=t13i4906h2_0d8feac7bc37_7395dae3b2f3
node:   bytes=1566 alpn=(none)     ciphers=52 exts=10 versions=0x0304,0x0303
        ja4=t13i521000_b262b3658495_8e6e362c5eac
chrome: bytes=1917 alpn=h2,http/1.1 ciphers=15 exts=17 versions=0x0304,0x0303
        ja4=t13d1517h2_8daaf6152771_cb7bf5808d99
Если прочитать три значения рядом, форма проблемы видна сразу. Они различаются в трёх независимых позициях: число шифров, число расширений и метка протокола. Клиент, который исправляет только первые две, всё равно выдаёт себя в третьей, а клиент, который не исправляет ни одной, отделяется без усилий.
Запись Node показывает 521000 в счётчиках, и последние четыре символа это 1000, а не метка протокола. Так происходит потому, что обычное TLS-соединение Node не предлагает никаких протоколов, поэтому метка падает до нулей, пока счётчики продолжаются. HTTP-клиент, который никогда не согласует HTTP/2, тем самым имеет отпечаток, который об этом заявляет, без всякой логики детекции.
i в первых двух значениях против d у Chrome это флаг доменного имени. curl и Node в этом запуске были направлены на голый адрес и не отправили server name; Chrome был направлен на имя. Этот единственный символ это не тонкое суждение о намерении, а утверждение о том, что клиент положил в сообщение. Направление curl и имитирующего клиента на имя хоста, а не на адрес, переключило их флаги на d и подняло счёт расширений на единицу, значит флаг и счётчик это два прочтения одного решения. Node так не сделал: он остался на t13i521000 с десятью расширениями, пока servername не был передан явно, и тогда стал t13d521100 с одиннадцатью. Библиотека решает, уходит ли имя с запросом, а вызывающий код решает, сообщать ли библиотеке это имя.
curl-impersonate и curl_cffi работают, заменяя или перенастраивая слой TLS и HTTP/2 так, чтобы байты походили на выбранный браузер. Утверждение узкое и его стоит проверять, а не принимать на веру, поэтому тот же слушатель использовался с Python-клиентом, которому задали имитировать Chrome:
default: bytes=517  ciphers=28 exts=12 alpn=h2,http/1.1
         ja4=t13d2812h2_257f3020b3a2_cbb9361b6bf9
chrome:  bytes=1815 ciphers=15 exts=16 alpn=h2,http/1.1
         ja4=t13d1516h2_8daaf6152771_d8a2da3f94cd
Вторая строка это результат, который важен. Получив задачу имитировать Chrome, клиент выдал пятнадцать шифров и шестнадцать расширений, и его хешированный набор шифров 8daaf6152771 совпадает с набором настоящего браузера. По оси шифров имитация точна.
По числу расширений нет. Chrome отправил семнадцать, а клиент с имитацией шестнадцать, поэтому префиксы читаются как t13d1516h2 против t13d1517h2. Разница в одну цифру, и эта цифра ровно того рода, для которого значение и хранят.
Это не критика ни одного из проектов. Браузер поставляет расширения, у клиентской библиотеки нет причин отправлять, и воспроизведение полного списка означало бы гонку за движущейся целью без функциональной выгоды. Суть уже: почти совпадение не является совпадением, и сравнение, проверяющее только первую часть хеша, сообщит об успехе там, где префикс уже расходится.
Библиотека под капотом определяет значение
Числа curl в начале измерения выглядят необычно по причине, не связанной с имитацией. Локальная сборка сообщает свой бэкенд TLS:
curl 8.7.1 (x86_64-apple-darwin24.0) libcurl/8.7.1 (SecureTransport) LibreSSL/3.3.6 zlib/1.2.12 nghttp2/1.64.0
curl_has_http2=true
SecureTransport, а не OpenSSL. curl, собранный против SecureTransport, берёт список шифров и набор расширений из этой библиотеки, поэтому его отпечаток это свойство сборки, а не программы curl. Две машины с одной версией curl и разными бэкендами дают разные значения, и ни одно из них не ошибочно.
У этого есть практическое следствие для тех, кто сравнивает отпечатки по парку машин. Записать «curl» как клиент недостаточно, потому что это не называет библиотеку TLS, а значение описывает именно библиотеку. То же рассуждение применимо к клиентам с имитацией: версия нижележащей библиотеки важнее версии обёртки.
Второй кадр показывает то же разделение на уровне HTTP/2. Соединение открывается кадром настроек, и записи этого кадра входят в то, что видит пир до появления любого запроса:
chrome_like: bytes=24 HEADER_TABLE_SIZE=65536 ENABLE_PUSH=0 INITIAL_WINDOW_SIZE=6291456 MAX_HEADER_LIST_SIZE=262144
node_like:   bytes=30 HEADER_TABLE_SIZE=4096 ENABLE_PUSH=0 INITIAL_WINDOW_SIZE=65535 MAX_FRAME_SIZE=16384 MAX_CONCURRENT_STREAMS=4294967295
curl_like:   bytes=36 HEADER_TABLE_SIZE=4096 ENABLE_PUSH=0 MAX_CONCURRENT_STREAMS=100 INITIAL_WINDOW_SIZE=65535 MAX_FRAME_SIZE=16384 MAX_HEADER_LIST_SIZE=16384
Три клиента, три длины кадра, и разница не декоративна. Браузер объявляет большое начальное окно и большой список заголовков; клиент Node вообще не объявляет лимит списка заголовков и оставляет окно значением по умолчанию; клиент формы curl объявляет потолок одновременных потоков, который два других опускают. Пир, читающий кадр, узнаёт, с какой из трёх архитектур говорит, ещё до разбора строки запроса.
Кадр также показывает, почему «повторить браузер» сложнее, чем выровнять список шифров. Порядок шифров это фиксированное свойство сборки библиотеки; кадр настроек это набор параметров, которые клиент выбирает под свою нагрузку. Сделать оба похожими на браузер значит перенять и настройки браузера, включая те части, что существуют ради движка рендеринга, которого у этого клиента нет.
Библиотеки имитации это учитывают, и измерение выше показывает, что они подходят близко. Чего они не могут изменить, так это самого наличия настройки: у клиента, чья единственная задача получать байты, естественные настройки отличаются от клиента, чья задача рендерить страницу, и кадр фиксирует разницу даже после правки кода.
Клиент, переиспользующий одно соединение, делает это заметным во втором месте. Возобновление сессии и повторное использование соединения полезны для пропускной способности, и оба означают, что второй запрос не повторяет рукопожатие. Пир, считающий рукопожатия, видит один отпечаток на десять запросов вместо десяти, тогда как клиент, открывающий новое соединение на каждый запрос, показывает десять. Ни одно из поведений не обман; это два нормальных устройства, и счётчики различаются потому, что различаются устройства.
Слой, которого у HTTP-клиента нет
Всё выше о соединении. Слой страницы это другой набор значений, и у HTTP-клиента нет ни одного из них, в том же смысле, в каком у текстового редактора нет разрешения экрана.
page_layer: ua=header-only  languages=en-US,en  platform=MacIntel
            hardwareConcurrency=16  deviceMemory=null
            canvas=true  webgl=true  timezone=America/Toronto
            screen=1280x720  dpr=1  webdriver=true
Эти значения получены вычислением документа в браузере. Ни одно из них не может выдать клиент, разбирающий байты, потому что каждое вычисляет движок JavaScript или система рендеринга, которую клиент не запускает. Здесь нет частичного зачёта и нет ловкого обхода: заголовку можно задать любую строку, и строка не является значением.
Последнюю запись стоит отделить от остальных. webdriver=true сообщает браузер, потому что он запущен под автоматизацией, а у HTTP-клиента нет эквивалентного поля, о котором сообщать. Сравнение, трактующее «поле отсутствует» как «поле чисто», читает отсутствие наоборот, и поэтому отчёт об отпечатке должен указывать, какие поверхности вычислялись, а не только какие значения найдены.
Если сложить два слоя, цена почти совпадения становится конкретной. Клиент, дошедший до t13d1516h2, потратил реальные усилия на слой соединения и всё ещё отличается от браузера, который имитирует, на одно расширение. На слое страницы он тоже ничего не получил, там он остаётся клиентом без документа.
Такое сочетание хуже обоих положений в одном конкретном смысле: оно приглашает к сравнению, которое не может выиграть. Простой клиент, не пытающийся походить на браузер, очевидно не браузер, и инструменты так к нему и относятся. Клиент, близко похожий на браузер на слое соединения, создаёт ожидание, которое слой страницы затем не оправдывает.
plain_client      -> clearly not a browser on both layers
impersonated      -> close on connection, absent on page
browser           -> both layers present and consistent
Полезный вопрос поэтому не «насколько близко может подойти рукопожатие», а «какой слой действительно нужен этой задаче». Запрос JSON за простой проверкой требует первой строки. Запрос отрисованного списка за входом требует третьей. Выбор второй строки это решение платить за сходство, которое приходит только наполовину.
Есть третья причина, по которой два слоя остаются раздельными на практике, и она о том, в какой форме вообще можно сформулировать сравнение. Утверждение о слое соединения имеет вид «это рукопожатие предложило такие параметры», и его может подтвердить одно записанное сообщение. Утверждение о слое страницы имеет вид «эта среда сообщила такие значения», и ему нужно вычисление внутри документа и запись того, до чего это вычисление могло добраться. У двух утверждений разные требования к доказательствам, поэтому отчёт, сливающий их в одну оценку, вынужден выбросить поле, которое говорит, какое из них он делает.
Это важнее всего, когда появляется расхождение. Если клиент совпадает на слое соединения, а слой страницы отсутствует, отчёт должен говорить «слой страницы не вычислялся», а не «слой страницы чист». Первое утверждение верно и пригодно к действию; второе это заявление об измерении, которого никто не делал. Та же дисциплина работает и в обратную сторону: сессия браузера, чьё рукопожатие не было записано, не может ответить на вопрос о соединении, каким бы подробным ни был её отчёт со стороны страницы.
Цена следует тому же разделению. Совпадение на слое соединения оплачивается один раз, на этапе сборки, выбором библиотеки и версии с их фиксацией. Совпадение на слое страницы оплачивается непрерывно, потому что значения, которые сообщает документ, зависят от рендерера, шрифтов, экрана и используемого профиля, и любое из этого может измениться между запусками. Команды часто закладывают бюджет на первое и бывают удивлены вторым, и поэтому зафиксированная библиотека TLS кажется законченной, а согласованная среда страницы никогда не кажется таковой до конца.
Последняя операционная заметка уместна здесь, а не в руководстве, потому что это часть, которая ломается молча. Когда клиентская библиотека обновляется, список шифров и набор расширений движутся вместе с ней, и записанный отпечаток перестаёт совпадать по причине, не связанной с конфигурацией. Когда браузер обновляется под зафиксированной автоматизацией, значения слоя страницы могут сдвинуться так же. И то и другое события версии, оба видны в diff, если значение хранится рядом с версией, и оба невидимы, если значение хранится одно.
Чем обходится почти совпадение, и практический вывод
Измеряйте до того, как предполагать паритет: запишите ClientHello своего клиента и сравните число расширений, а не только один хеш. Клиент с имитацией из этого измерения точно совпал с набором шифров Chrome и разошёлся на одном расширении, и префикс прямо это указывает. Называйте и библиотеку TLS, а не только программу, потому что сборки SecureTransport и OpenSSL одной версии curl дают разные значения. И держите два слоя раздельно в любом сравнении: слой соединения может приблизить клиент без DOM, а слой страницы не может приблизить ни один. О том, как строится значение слоя соединения, читайте в JA3, JA4 и кадр настроек HTTP/2; о том, каким правилам детекции нужно значение из сети, читайте в правилах граничного слоя, которые скрипт страницы не может вычислить. Отрисованной странице нужен браузер, и настройка браузера для скрапинга покрывает этот путь.
Границу стоит назвать без украшений. Объявленный профиль может держать значения, которые раскрывает страница, согласованными между собой; он не заставляет рукопожатие совпадать с другим клиентом и не даёт HTTP-клиенту документ для рендеринга. Совпадение соединения и совпадение страницы это отдельные результаты, полученные отдельными инструментами, и задаче обычно нужен один из них, а не оба.
Короткая заметка о том, чего эти измерения не говорят, потому что читатель может спросить это по делу. Они не говорят, что почти совпадение бесполезно: для JSON-эндпоинта за простой оценкой слой соединения это почти всё, что проверяется, и клиент с верными шифрами находится в другом положении, чем клиент без них. Они также не говорят, что браузер нужен для каждой отрисованной страницы, поскольку страницу, которая отдаёт данные в объекте начального состояния, может прочитать клиент вообще без рендерера.
Они говорят, что два слоя не образуют градиент. Нет настройки, которая сдвигает клиента на полпути от «нет DOM» к «рендерит страницу», и нет заголовка, который переводит рукопожатие браузера в другое значение. Задаче, которой нужны оба слоя, нужен браузер; задачу, которой нужен слой соединения, часто может обслужить клиент, никогда не загружающий документ. Решить, какая из этих двух задач перед вами, и записать это в журнал и есть вся дисциплина.
Сама установка измерения заслуживает абзаца, потому что читателю, который хочет проверить эти числа, нужны те же условия. Слушатель должен принять соединение и закрыться, не завершая рукопожатие; если он предъявит сертификат, клиент может отправить другое второе сообщение, и сравнение сдвинется. Запись должна вестись на стороне клиента относительно любого прокси, иначе записанные байты принадлежат тому, что завершило TLS, а не изучаемому клиенту. И разбор должен отбрасывать значения grease до подсчёта, потому что клиент, который тянет новый заполнитель на каждом соединении, выглядит так, будто его список шифров растёт и сжимается между запусками. Ни один из этих шагов не сложен, и каждый пропущенный даёт число, которое меняется по причине, не связанной с клиентом.
Источники
Эта статья входит в руководство: Что такое отпечаток браузера?
Похожие статьи
Отпечатки TLS: JA3, JA4 и кадр HTTP/2
ОтпечаткиПравила сетевого уровня, недоступные странице
ОтпечаткиClient Hints Fingerprinting: HTTP-заголовки и идентичность
СетьСкрапер заблокирован: ошибки DNS, TLS, HTTP и страницы
ОтпечаткиЧто на самом деле проверяют публичные наборы тестов
ОтпечаткиИсточник случайности в crypto-js: ветка сборки
Выполните ту же проверку в BotBrowser
Загрузите профиль, сохраните внутри браузера те сигналы, о которых только что прочитали, и подтвердите результат на своей машине до раскатки.