Trous de tableau creux et ce que fait chaque méthode
Une sonde sur un seul trou : quelles méthodes le sautent, lesquelles le visitent, ce qu’il devient et pourquoi indexOf et includes divergent.
BotBrowser Team
Vous voulez la documentation structurée pour Empreinte ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
BotBrowser permet de rejouer un fixture de même origine autorisé sous un profil déclaré et de garder une trace bornée de ce qu’une page a réellement envoyé, mais il ne peut pas faire qu’un tableau creux se comporte comme un tableau dense, ne peut pas empêcher JSON de transformer un trou en null, ni faire concorder indexOf et includes sur un index absent. Cette revue exécute une sonde sur un tableau de trois éléments avec un seul trou et consigne quelles méthodes d’itération visitent le trou, lesquelles le sautent, ce que le trou devient quand le tableau est copié, rempli, trié ou sérialisé, et pourquoi deux tests d’appartenance sur le même tableau donnent des réponses opposées.
Résumé
- Un trou est un index absent, pas un
undefinedstocké : sur['a', , 'c']la sonde imprimelength=3 has1=false ownKeys=0,2, alors qu’un['a', undefined, 'c']dense imprimehas1=true ownKeys=0,1,2. forEach,map,filter,someeteverysautent complètement les trous, doncmapsur un trou laisse un trou dans le résultat etfilterrenvoie un tableau dense plus court.reducesans valeur initiale part du premier élément présent, donc additionner les deux valeurs présentes donnea+c, tandis que le même appel avec un0initial ne compte que les deux visites.- Le spread et
Array.fromremplissent le trou avecundefined, donc la copie rapportehas1=true value1=undefined, maisentries()montre le trou comme1:undefinedparce que l’itérateur visite chaque index. indexOf(undefined)renvoie-1sur un trou alors qu’includes(undefined)renvoietrue, parce que les deux utilisent des comparaisons différentes et que l’une saute le trou.joinetString()affichent le trou comme un champ vide, donc['a', , 'c'].join('-')vaut"a--c", tandis quesliceetreversegardent le trou et quesortle déplace au dernier index.- Un aller-retour
JSON.parse(JSON.stringify(...))transforme le trou ennullet en fait une clé propre, donc le tableau revient plus dense qu’il n’est parti.
Sommaire
- En quoi un trou diffère d’un undefined stocké
- Quelles méthodes d’itération sautent un trou
- Ce qu’un trou devient quand le tableau est copié
- Pourquoi deux tests d’appartenance divergent
- Consigner une lecture de tableau creux
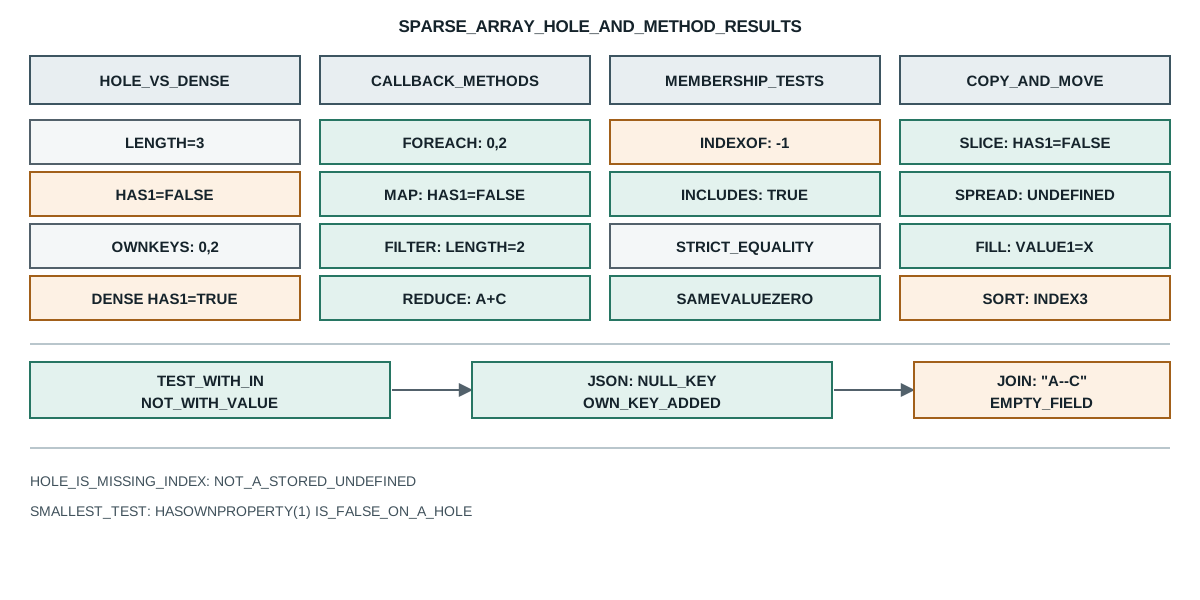
En quoi un trou diffère d’un undefined stocké
Array accepte une longueur sans exiger un élément à chaque index, et l’espace que cela laisse est un trou. La sonde en construit un par affectation plutôt que par un littéral, ce qui est la façon dont un trou apparaît dans du code réel quand un programme calcule des index au lieu de les écrire :
node=v26.9.0
shape -> length=3 has1=false ownKeys=0,2 json=["a",null,"c"]
dense -> length=3 has1=true ownKeys=0,1,2 json=["a",null,"c"]
forEach -> visits=0:"a"|2:"c"
map -> result=["0:\"a\"",null,"2:\"c\""] has1=false length=3
filter -> result=["a","c"] length=2
some -> indexesSeen=0,2
reduce-no-init -> a+c
reduce-with-init -> count=2
spread -> length=3 has1=true value1=undefined
from -> length=3 has1=true value1=undefined
entries -> 0:"a"|1:undefined|2:"c"
indexOf -> -1 includes -> true
indexOf-c -> 2
join -> "a--c"
toString -> "a,,c"
reverse -> length=3 has1=false keys=0,2
sort -> length=4 has1=true has3=false keys=0,1,2
fill -> has1=true value1="x"
slice -> length=3 has1=false
copyWithin -> has1=true value1="c"
json-roundtrip -> has1=true value1=null
Les deux premières lignes sont l’article entier en miniature. Les deux tableaux ont length=3 et les deux se sérialisent en ["a",null,"c"], donc JSON.stringify ne peut pas les distinguer. La différence tient à 1 in a et à Object.keys. Le tableau troué rapporte has1=false et ne liste que les clés 0,2 ; le tableau dense rapporte has1=true et liste 0,1,2. Un trou n’est pas une propriété dont la valeur est undefined ; c’est l’absence de la propriété, et chaque méthode qui lit le tableau doit décider quoi faire de cette absence.
C’est pourquoi un contrôle écrit if (arr[i] === undefined) classe mal les deux cas. Sur le tableau troué, lire a[1] donne undefined, exactement comme sur le tableau dense, parce qu’un index absent se lit comme undefined selon les règles du langage. Le seul test qui les sépare est le test de présence, 1 in a, ou son équivalent Object.prototype.hasOwnProperty.call(a, 1), et la seconde forme est celle que l’on veut quand un tableau pourrait avoir hérité d’une propriété numérique d’un prototype pollué.
La distinction a un coût qui apparaît dans le travail sur la taille des requêtes. Une page qui construit un résultat en affectant à des index calculés peut laisser des trous là où une branche ne s’est pas exécutée, et la forme sérialisée contient alors null à chacune de ces positions. Un consommateur qui lit ce JSON ne peut pas distinguer un null enregistré volontairement d’un trou jamais rempli, donc un schéma qui tient à la différence a besoin d’un champ voisin ou d’un drapeau de présence explicite, parce que le tableau seul ne porte pas la distinction à travers JSON.stringify.
Un trou survit aussi à un passage qui semble sans perte. Passer le tableau à une fonction, le stocker dans un champ d’objet et le renvoyer conserve le même objet avec les mêmes trous, parce que rien dans ce chemin ne le copie. Le trou ne disparaît que lorsqu’une étape le matérialise, et quelles étapes le matérialisent fait l’objet des deux sections suivantes.
Trois formes produisent un trou sans que personne n’écrive une virgule, et chacune est facile à manquer en revue. La première est l’affectation calculée qu’utilise la sonde : une boucle qui écrit result[index] = value seulement pour les index qui ont passé un filtre laisse les autres absents. La deuxième est new Array(n) suivi d’écritures partielles, parce que le constructeur fixe length et rien d’autre, donc chaque index commence comme un trou. La troisième est delete arr[i], qui retire la propriété propre et laisse length inchangé, donc une suppression qui ressemble à un retrait creux est exactement un trou et se comporte comme tel dans chaque méthode que la sonde a mesurée.
Une quatrième voie est plus subtile et vient d’une affectation au-delà de la fin d’un tableau. Écrire arr[arr.length + 2] = 'x' fixe length au nouvel index plus un et laisse les deux index intermédiaires comme trous, parce que le langage étend le tableau et ne remplit pas l’écart. Une page qui ajoute avec un décalage calculé plutôt qu’avec push crée donc des trous en silence, et le nombre d’éléments présents n’égale plus length.
La détection à travers une frontière est là où cela devient opérationnel. Une trace qui stocke un tableau d’une page peut porter length et le JSON sérialisé, et les deux concordent sur un tableau dense avec null et sur un tableau creux avec un trou. Les deux premières lignes de la sonde sont exactement ce cas : ["a",null,"c"] pour les deux. Une trace qui veut préserver la distinction doit donc ajouter la carte de présence, par exemple Object.keys(arr), et un consommateur qui ne lit que la forme sérialisée a déjà perdu l’information avant de commencer.
La différence compte aussi pour les contrôles d’égalité. Deux tableaux qui se sérialisent tous deux en ["a",null,"c"] se comparent inégaux sous une fonction d’égalité profonde qui parcourt les clés propres, parce que l’un a l’index 1 et l’autre non, et égaux sous une fonction qui sérialise d’abord les deux en JSON. Un test qui compare la sortie d’une page à un fixture dépend donc du style de comparaison qu’il utilise, et un fixture construit à la main correspondra en silence à un tableau dense alors que la page en a produit un creux.
Quelles méthodes d’itération sautent un trou
Les méthodes d’itération de tableau se répartissent en deux groupes, et la séparation n’est pas intuitive. Les cinq qui prennent un rappel, forEach, map, filter, some et every, sautent un trou comme si l’index n’existait pas. Le forEach de la sonde imprime visits=0:"a"|2:"c", l’index 1 absent de la liste, et some imprime indexesSeen=0,2 parce qu’il n’appelle jamais le rappel pour le trou.
map est celui qui surprend, parce que son résultat garde le trou. La sonde imprime result=["0:\"a\"",null,"2:\"c\""] has1=false, donc le tableau mappé a la même longueur, une valeur réelle aux index 0 et 2, et toujours rien à l’index 1. Un map qui construit des chaînes à partir de chaque élément produit un résultat où le trou reste un trou, et un join ultérieur sur ce résultat l’affichera comme un champ vide plutôt que comme la chaîne undefined.
filter est l’inverse, parce qu’il ne peut pas garder le trou : son résultat ne contient que les éléments que le prédicat a acceptés, et un trou n’est jamais proposé au prédicat. La sonde passe un prédicat toujours vrai et obtient result=["a","c"] length=2, un tableau dense d’une position plus court que la source. Cela fait de filter(() => true) un outil pour retirer les trous, et une page qui l’utilise comme moyen de copier un tableau densifie en fait la copie comme effet secondaire.
reduce est entre les deux groupes et son comportement dépend de la présence d’une valeur initiale. Sans valeur initiale, le reduce de la sonde part du premier élément présent et renvoie a+c, donc le trou n’atteint jamais le rappel et le nombre d’additions est un, pas deux. Avec un 0 initial, la sonde imprime count=2, parce que l’accumulateur existe dès le départ et que le rappel s’exécute une fois par élément présent. La variante sans valeur initiale lève aussi sur un tableau sans élément présent, ce qui est l’équivalent creux du cas du tableau vide.
some et every court-circuitent, et un trou ne compte comme visite pour aucun des deux. Cela compte pour une boucle de validation qui attend d’every qu’il ait inspecté chaque index : un tableau troué peut passer un contrôle every sur une plage que le rappel n’a jamais vue. Un prédicat qui aurait rejeté la valeur absente ne s’exécute jamais, donc un every sur un tableau partiellement rempli est plus faible qu’il n’y paraît, et une page qui doit rejeter un trou doit contrôler la présence séparément.
Le protocole d’itération lui-même ne saute pas les trous. L’entries() de la sonde imprime 0:"a"|1:undefined|2:"c", donc une boucle for...of ou un spread sur entries() voit chaque index et rapporte le trou comme undefined. La séquence qu’un for...of produit est la même qu’ordonne un comparateur, ce que tri de tableau et comparateurs couvre du côté de l’ordre. C’est l’autre façon de visiter le tableau entier : les méthodes à rappel sautent les trous, tandis que le protocole d’itérateur les remplit, et c’est pourquoi une page peut obtenir deux comptes d’éléments différents du même tableau selon la boucle utilisée.
Ce qu’un trou devient quand le tableau est copié
Copier un tableau n’a pas une seule réponse. Certaines opérations préservent le trou, certaines le remplacent par undefined, et certaines le déplacent. La sonde en exerce cinq et obtient trois résultats différents de la même source.
Le spread et Array.from remplissent le trou. La sonde imprime spread -> length=3 has1=true value1=undefined et de même pour from, donc la copie est dense avec un undefined explicite au trou. C’est la façon la plus courante dont un trou disparaît sans avertissement : une copie [...arr] dans une refactorisation transforme un tableau creux en tableau dense, et tout code ultérieur qui comptait sur filter pour se débarrasser du trou a désormais un undefined à gérer.
slice préserve le trou. La sonde imprime slice -> length=3 has1=false, donc découper le tableau entier reproduit la même forme, parce que slice copie les clés propres et n’invente pas celle qui manque. Les clés qu’un slice copie sont celles qu’un parcours de clés propres rapporte, et ordre des clés d’objet explique pourquoi elles reviennent triées plutôt que dans l’ordre d’insertion. C’est la copie qui se comporte comme un clone superficiel du stockage et non des valeurs, et c’est celle à choisir quand le trou est significatif.
fill écrit à chaque index qu’il couvre, y compris un trou. La sonde remplit l’index 1 et imprime fill -> has1=true value1="x", donc un fill sur une plage qui inclut le trou en fait un élément réel. copyWithin fait de même par un déplacement : copyWithin -> has1=true value1="c" montre la valeur recopiée sur le trou. reverse préserve le trou. La sonde imprime reverse -> length=3 has1=false keys=0,2, donc après avoir inversé le tableau de trois éléments le trou reste le seul index absent, ce qui a du sens parce qu’inverser amène l’index 1 sur lui-même et fait passer les deux valeurs présentes l’une devant l’autre.
Le résultat de sort mérite d’être lu deux fois. La sonde ajoute b avec concat puis trie le résultat de quatre éléments ; l’étape de tri imprime sort -> length=4 has1=true has3=false keys=0,1,2, donc le tri a déplacé le trou de l’index 1 au dernier index et rempli l’index 1 d’une valeur réelle. Une page qui trie un tableau partiellement rempli puis contrôle length obtient toujours 4, mais le trou est maintenant à la fin plutôt qu’au milieu, donc une boucle qui s’arrête au premier undefined lit un élément différent de celui d’avant le tri. La forme n’a pas changé ; seule sa position a changé, et le test de présence à l’index 1 est passé de false à true tandis que celui de l’index 3 a basculé dans l’autre sens.
join et String() s’accordent entre eux et divergent de tout le reste. La sonde imprime join -> "a--c" et toString -> "a,,c", donc les deux rendent le trou comme un champ vide plutôt que le mot undefined. C’est la même sortie qu’un tableau dense avec une chaîne vide réelle produirait, ce qui signifie qu’une chaîne jointe ne peut pas être reséparée en tableau d’origine sans savoir combien de trous il y avait. Un aller-retour par join et split perd donc l’information de présence que portait in.
Pourquoi deux tests d’appartenance divergent
La conséquence la plus tranchante d’un trou est que deux tests d’appartenance sur le même tableau donnent des réponses opposées. La sonde imprime indexOf -> -1 includes -> true pour une recherche de undefined sur le tableau troué, et elle imprime aussi indexOf-c -> 2 pour montrer qu’une recherche d’une valeur présente est normale.
La raison est qu’indexOf utilise l’égalité stricte et saute les trous, tandis qu’includes utilise la comparaison SameValueZero et traite un trou comme undefined. Un trou se lit comme undefined, SameValueZero dit qu’undefined correspond à undefined, et includes renvoie true. indexOf ne visite jamais le trou, donc il renvoie -1. Une page qui protège une valeur avec if (arr.indexOf(x) === -1) et une page qui la protège avec if (!arr.includes(x)) divergent donc chaque fois que x vaut undefined et que le tableau a un trou, et la divergence est silencieuse.
Cette différence n’est un défaut ni de l’un ni de l’autre ; c’est la séparation documentée, et elle existe parce qu’includes a été ajouté plus tard en pensant au cas NaN, donc il a dû utiliser SameValueZero pour rendre vrai [NaN].includes(NaN). La même comparaison fait correspondre un trou à undefined, ce qui est un effet secondaire que le langage a conservé parce que le retirer aurait rendu includes incohérent avec lui-même. Une page qui doit savoir si une valeur est présente et si un index est rempli a donc besoin des deux tests, un pour la valeur et un pour la présence, et les deux questions ont des réponses différentes sur un tableau creux.
L’aller-retour JSON bouche l’écart d’une façon qui cache le problème. La sonde imprime json-roundtrip -> has1=true value1=null, donc JSON.parse(JSON.stringify(holey)) renvoie un tableau où l’index 1 est présent et sa valeur est null. Le trou est devenu une clé propre de valeur null, ce qui signifie qu’un clone basé sur JSON densifie le tableau en silence et remplace l’absence par une valeur que le schéma peut ne pas attendre. C’est le même risque qu’une copie par spread, mais plus difficile à remarquer, parce que le code qui le fait ressemble souvent à une préservation des données.
Consigner une lecture de tableau creux
Une lecture de tableau creux soutient une affirmation bornée : ce moteur, cette forme, ces méthodes ont produit ces résultats. Quatre champs la gardent vérifiable :
- La carte de présence, parce que
lengthet la forme sérialisée ne distinguent pas un trou d’unundefinedstocké. - L’opération et si elle visite, saute ou matérialise le trou, parce que la réponse diffère pour chacune.
- Les clés propres du résultat, parce qu’un
mapgarde un trou, qu’unfilterle retire et qu’un tri le déplace à la fin. - Si la valeur est passée par
JSON, parce qu’un aller-retour transforme chaque trou ennullet en fait une clé propre.
Sources publiques
- MDN : Array
- MDN : Array.prototype.forEach()
- MDN : Array.prototype.filter()
- MDN : Array.prototype.includes()
- MDN : Array.prototype.sort()
- ECMAScript : objets Array
- BotBrowser : référence de cohérence d’automatisation
Conclusion pratique
Traitez un tableau creux comme un type différent d’un tableau dense : testez la présence avec in ou hasOwnProperty plutôt qu’en lisant la valeur, attendez des méthodes à rappel qu’elles sautent un trou tandis que le spread et Array.from le remplissent, et rappelez-vous qu’un tri gare le trou au dernier index là où il était au milieu. Quand une valeur doit survivre à une copie, choisissez la copie selon ce qu’elle fait du trou : slice le préserve, le spread le densifie et un aller-retour JSON le transforme en null. Pour l’ordre qu’une valeur de remplissage prend une fois qu’elle existe, lisez tri de tableau et comparateurs ; pour ce qu’une copie JSON fait au reste de la structure, lisez structuredClone face à JSON.
Cet article fait partie du guide : Qu'est-ce qu'une empreinte de navigateur ?
Articles Connexes
Tri de tableau et comparateurs : un piège subtil
EmpreinteWeakMap et WeakSet : garder et lâcher des clés
EmpreinteOrdre des clés : les entiers trient, les chaînes restent
EmpreinteLes pièges Proxy et les invariants que le moteur impose
EmpreintestructuredClone face à JSON : copies profondes
EmpreinteDataView : ordre des octets, alignement et bornes
Faites passer BotBrowser de la recherche à la production
Utilisez ces guides pour comprendre le modèle, puis passez à la validation multi-plateforme, aux contextes isolés et au déploiement navigateur prêt pour l'échelle.