--bot-performance-timing : signaux temporels du navigateur
Comprenez les modes basique et avancé de --bot-performance-timing, les API Performance Timing observables et les limites des contrôles proxy et anti-bot.
Vous voulez la documentation structurée pour Empreinte ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
--bot-performance-timing agit dans le navigateur afin de garder cohérentes les surfaces temporelles visibles par une page. Il ne garantit pas l'acceptation d'une session et ne masque pas les faits réseau observables par un proxy. L'objectif est plus précis : les valeurs doivent décrire un cycle de navigation et de chargement plausible.
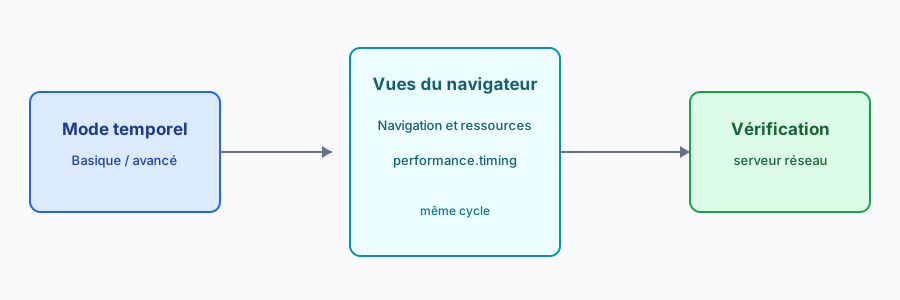
Ce que contrôle l'option
Une page peut lire performance.now(), PerformanceNavigationTiming, PerformanceResourceTiming et l'objet historique performance.timing. Modifier un seul getter créerait une contradiction avec les autres vues. L'option agit sur le modèle du navigateur afin que ces vues décrivent le même cycle.
BotBrowser décrit deux niveaux publics. Le mode basique conserve des valeurs plausibles et cohérentes pour un profil courant. Le mode avancé applique les intervalles documentés, dont les paramètres exacts restent expérimentaux. Le dossier ne définit ni graine globale ni graine de page : la référence reproductible est la requête de temps brute immuable et son résumé stable. Ces noms décrivent une portée, pas un score de détection ni une promesse d'invisibilité.
Définissez la fenêtre d'observation avant de choisir un mode. Une première visite froide, une page restaurée et un changement de route d'une application monopage exposent des événements différents. Garder ce contexte avec le mode évite de prendre une différence attendue pour un défaut.
Mode basique : un cycle cohérent
Le mode basique conserve l'ordre des phases : le début d'une requête précède sa réponse, une navigation réelle possède des étapes non nulles et une même entrée reste stable lorsqu'elle est relue. Les entrées modernes et l'objet historique viennent du même cycle de vie.
Cela ne rend pas toutes les pages identiques. Le cache, le réseau, les redirections, les service workers et l'ordonnancement du processeur modifient toujours une mesure. Les lectures répétées doivent rester stables pour les entrées de ressources finalisées et pour une navigation après responseEnd ; avant responseEnd, une transition unique du basique vers l'avancé est permise pendant la finalisation. Le but est d'éviter une contradiction artificielle due à un patch sélectif. Un temps est un contexte de diagnostic, pas une identité.
Le mode basique sert aussi de référence de compatibilité. Exécutez-le avec la précision de confidentialité habituelle et les états de cache pris en charge. Si une mesure manque, laissez la fonction utiliser un repli documenté plutôt que de fabriquer une valeur.
Mode avancé : intervalles expérimentaux entre les vues
Le mode avancé applique les intervalles documentés tout en gardant la forme d'une navigation valide. Il n'a pas de graine globale ni de page. Les lectures répétées restent stables pour les entrées de ressources finalisées et pour une navigation après responseEnd ; avant responseEnd, une transition unique du basique vers l'avancé est permise pendant la finalisation. Les paramètres d'intervalle restent expérimentaux : comparez des charges bornées plutôt qu'une identité.
Le contrat public couvre getEntries(), les entrées de navigation et de ressources, performance.timing et performance.toJSON(). Il nomme aussi une requête de temps brute immuable et un résumé stable, sans établir de graine globale ou de page. Une vérification compare ces vues : les phases correspondantes doivent rester dans la tolérance documentée et représenter la même séquence d'événements. Le mode avancé est une configuration expérimentale d'intervalles, pas une nouvelle identité avec graine.
La configuration d'intervalles doit être considérée comme une donnée de test expérimentale. Le résumé stable appartient à la requête brute immuable, pas à une graine globale ou de page, et ne rend déterministes ni la charge serveur, ni l'ordonnancement du système, ni un bundle JavaScript qui change. Gardez ces variables visibles entre deux exécutions.
Ce qu'une page peut observer
Performance expose des durées et des entrées, avec la précision et les réductions de confidentialité imposées par le navigateur. Une page peut observer les étapes de navigation, les ressources, ses propres marques et, lorsqu'il existe, l'objet historique. Elle peut comparer l'ordre, les états nuls ou non nuls et les relations entre entrées.
Ces observations concernent le document courant et son chargement ; elles ne mesurent pas fidèlement le processeur ni l'identité. Le cache, les tâches en arrière-plan et les politiques du navigateur changent les échantillons. Le guide des temps de performance replace ce signal dans une analyse de confidentialité plus large.
Cette séparation aide aussi lors d'un incident. Une ressource lente peut venir d'un cache manquant, d'une route ou du travail de l'application après la réponse. Commencez par le cycle de vie et la propriété de la mesure, puis inspectez les autres signaux seulement s'ils répondent à une autre question.
Croisement avec proxy et anti-bot
Le temps n'est qu'une couche. Un service peut comparer les étapes du navigateur avec l'arrivée des requêtes côté serveur, la réutilisation des connexions, les redirections et les en-têtes de cache. Un proxy peut ajouter de la latence ou modifier la route sans toucher aux API locales. Des valeurs locales plausibles ne corrigent pas une route, un profil TLS ou une réputation IP incohérents.
Dans une revue autorisée, comparez les catégories : entrées du navigateur, horodatages serveur et événements de santé du proxy doivent répondre à la même question opérationnelle. Gardez des tolérances propres au chargement et ne publiez pas de seuils de détection. Une ressource manquante doit conserver un parcours de secours. Voir le guide de cohérence réseau.
En cas d'écart, conservez la catégorie et l'horodatage d'origine plutôt que de tout réduire à une étiquette « bot ». Vous pourrez ainsi corriger une route, une politique de cache ou une régression sans modifier inutilement le mode temporel.
Limites et usage responsable
L'option n'étend pas la compatibilité de Performance, n'uniformise pas les systèmes d'exploitation et ne supprime pas toute variation. Elle n'autorise pas un accès et ne prouve pas qu'une session est humaine. Utilisez-la pour des tests reproductibles, la cohérence d'un profil et une revue de confidentialité. Ne liez pas les traces à un compte et ne les conservez pas au-delà du besoin diagnostique.
Avant la mise en production, vérifiez des étapes ordonnées et non nulles, l'accord entre vues modernes et historiques, et un secours lorsqu'une ressource manque. Notez le mode et la configuration d'intervalles comme métadonnées de test, jamais comme identifiant. Réévaluez le contrat après une mise à jour du navigateur.
Rendez le fixture observable sans le rendre identifiant. Un identifiant court d'exécution, la version du navigateur, la révision du profil et le nom de charge suffisent pour relier page, serveur et passerelle. Limitez cette clé à l'exécution, retirez les paramètres avant l'export et gardez les agrégats après la fin du diagnostic. Vous expliquez ainsi un changement temporel sans créer de signal persistant entre sessions.
Une revue de régression conserve la configuration de test, le navigateur et le résultat agrégé. Cette séparation permet de répéter le diagnostic sans transformer une mesure temporelle en identifiant.
Lire une entrée de navigation en sécurité
Les entrées de navigation décrivent une requête de document, mais chaque champ a son propre sens. Une redirection peut ajouter des phases avant la réponse finale. Un service worker peut répondre sans le même chemin réseau qu'un chargement froid. Un succès de cache peut accélérer une ressource sans indiquer un processeur plus rapide. Lisez l'entrée comme un cycle de vie et gardez ces distinctions dans les tableaux et les notes de support.
L'application doit d'abord détecter l'API puis gérer une liste vide. Une page pré-rendue, restaurée depuis le back-forward cache ou n'ayant pas atteint la phase concernée peut ne pas exposer les mêmes champs au même moment. Une mesure facultative absente ne doit pas bloquer la tâche principale. Ce repli protège aussi la confidentialité en évitant de chercher un identifiant de remplacement.
En production, copiez uniquement les champs qui répondent à une question définie et étiquetez l'état de navigation qui les a produits. Redirection, restauration du cache et chargement froid sont des événements différents. Gardez les analyseurs tolérants aux nouveaux champs et traitez un champ non pris en charge comme indisponible, sans en inventer un autre.
Temps des ressources sans surinterprétation
Les entrées de ressources expliquent une feuille de style, une image, un script ou un fetch lent, mais ne forment pas une trace réseau complète. Le navigateur peut appliquer timing-allow-origin, réduire la précision, omettre des entrées ou évincer les plus anciennes. Une ressource peut aussi venir de la mémoire ou d'un service worker. Comparez le rôle et le résultat, pas une seule durée.
Pour les résultats, préférez des agrégats bornés comme « aperçu facultatif terminé » ou « police de secours visible ». Ne téléversez pas par défaut toutes les URL et horodatages. Si le support a besoin d'une trace, rendez la capture explicite, limitez sa durée et retirez les paramètres et identifiants inutiles.
Les tampons sont un état opérationnel. Une application chargée peut les remplir et évincer les anciennes entrées ; une lecture trop précoce peut être incomplète. Fixez le point d'observation, notez si le tampon était plein et ne prenez pas une liste vide pour la preuve qu'aucune requête n'a eu lieu. Expliquez les limites timing-allow-origin pour les ressources inter-origines.
Marques, mesures et travail de l'application
performance.mark() et performance.measure() décrivent le travail nommé par la page. Ils sont utiles aux régressions car l'équipe contrôle les bornes, mais ne sont pas des étapes de navigation. Une mesure longue peut inclure l'ordonnancement, une action utilisateur ou un onglet en arrière-plan.
Gardez les noms stables et documentez le contenu de chaque mesure. Une mesure qui traverse une requête facultative doit signaler séparément annulation et nouvelle tentative. Le changement devient actionnable sans transformer nom, durée ou URL en profil intersessionnel. Comparez toujours le résultat de l'application avec le mode documenté.
Pour une régression, associez chaque mesure à un critère visible : contenu utilisable, interaction terminée ou secours affiché. Placez les marques près de l'opération et notez l'annulation séparément. Une tâche secondaire ne dominera pas la comparaison et les distributions des modes n'ont pas besoin d'être numériquement identiques.
Précision, confidentialité et répétabilité
Les navigateurs réduisent volontairement la précision de certaines horloges. L'isolation inter-origines, la politique de sécurité, la limitation en arrière-plan et les versions changent la résolution. Un test qui attend une fraction exacte est fragile. Vérifiez plutôt l'ordre, des états raisonnablement non nuls et les relations entre entrées.
Le mode avancé convient aux intervalles documentés pour une charge contrôlée. Conservez mode, configuration d'intervalles, version du navigateur, version du profil et nom de la charge dans le test. Le résumé stable décrit la requête brute immuable, pas un utilisateur. Supprimez les traces après la fenêtre de comparaison et gardez seulement le résultat requis.
La répétabilité a des limites : un résumé stable d'une requête brute immuable ne fige ni charge serveur, ni planification, ni congestion, ni bundle JavaScript changeant. Notez ces dimensions et comparez des plages ou l'ordre. Si un fixture change, vérifiez d'abord la charge et la politique du navigateur.
Examiner un chemin proxy
La revue est meilleure lorsque les responsabilités sont explicites. Le navigateur possède les entrées locales ; le serveur, les horodatages de réception, le statut et la fin d'application ; le proxy ou la passerelle, l'état du chemin, les échecs de connexion et les événements de politique. La comparaison peut localiser un segment lent sans accuser une seule couche.
Utilisez un endpoint synthétique ou une charge de staging autorisée. Incluez cache chaud et froid, redirection, échec d'une ressource facultative et nouvelle tentative. Comparez les phases et résultats larges, sans classer un navigateur sur des microsecondes. Un changement de proxy est un changement réseau même si les temps locaux restent cohérents.
Écrivez la carte des responsabilités à côté du fixture : quels temps viennent de la page, du serveur et de la passerelle. Utilisez des identifiants de corrélation qui expirent avec l'exécution, jamais des identifiants de compte. Un désaccord invite à inspecter le segment pertinent ; il ne prouve pas la tromperie d'une couche.
Les signaux anti-bot ne sont pas une API unique
Les systèmes anti-bot peuvent combiner API du navigateur, observations serveur, historique de compte, rythme et métadonnées de transport. L'option traite une cohérence côté navigateur ; elle ne réécrit ni IP, ni TLS, ni cookies, ni actions, ni authentification. Une valeur plausible n'est qu'une entrée parmi d'autres.
Dans une intégration autorisée, documentez ce qui est mesurable et ce qui ne l'est pas. Ne copiez pas la logique privée d'un défi dans un test client. Vérifiez que l'application reste utilisable avec précision réduite, entrée absente ou route lente. Cela fournit un résultat de compatibilité sans exposer de règles privées.
La même discipline vaut pour les fournisseurs. Testez le comportement documenté avec du trafic synthétique et n'inférez pas un score caché de quelques échantillons. Évaluez la configuration sur la compatibilité, des tests prévisibles et des limites de confidentialité claires.
Liste de déploiement bornée
Commencez par le mode basique sur un profil représentatif et confirmez les entrées de navigation et de ressources dans les navigateurs pris en charge. Ajoutez l'avancé seulement lorsqu'un test ou une politique documentée exige ses intervalles expérimentaux. Gardez un fixture comparant les entrées modernes à l'objet historique et un autre avec une ressource facultative absente.
Pendant le déploiement, comparez fin, annulation, nouvelle tentative et récupération. Ne comparez pas les utilisateurs par des traces brutes. Après une mise à jour, vérifiez d'abord API, précision, cache et charge, puis décidez si la configuration doit changer.
Conservez une note courte et reproductible : mode, configuration d'intervalles si nécessaire, version du navigateur, version du fixture et résultat agrégé. Réexaminez-la après une évolution du navigateur, du cache ou du routage. Si la page reste utilisable sans une mesure facultative, conservez ce repli plutôt que d'ajouter une collecte.
Sources
Articles Connexes
Faites passer BotBrowser de la recherche à la production
Utilisez ces guides pour comprendre le modèle, puis passez à la validation multi-plateforme, aux contextes isolés et au déploiement navigateur prêt pour l'échelle.