BrowserContext de Puppeteer: propiedad de páginas y limpieza
Aprende quién controla navegadores, contextos, páginas, ventanas emergentes, tiempos de espera y limpieza de Puppeteer para evitar fugas en pruebas autorizadas.
Quieres la documentación estructurada de Primeros pasos?
Este artículo forma parte de la biblioteca editorial. Para pasos de configuración, material de referencia y actualizaciones continuas, entra en la sección de docs.
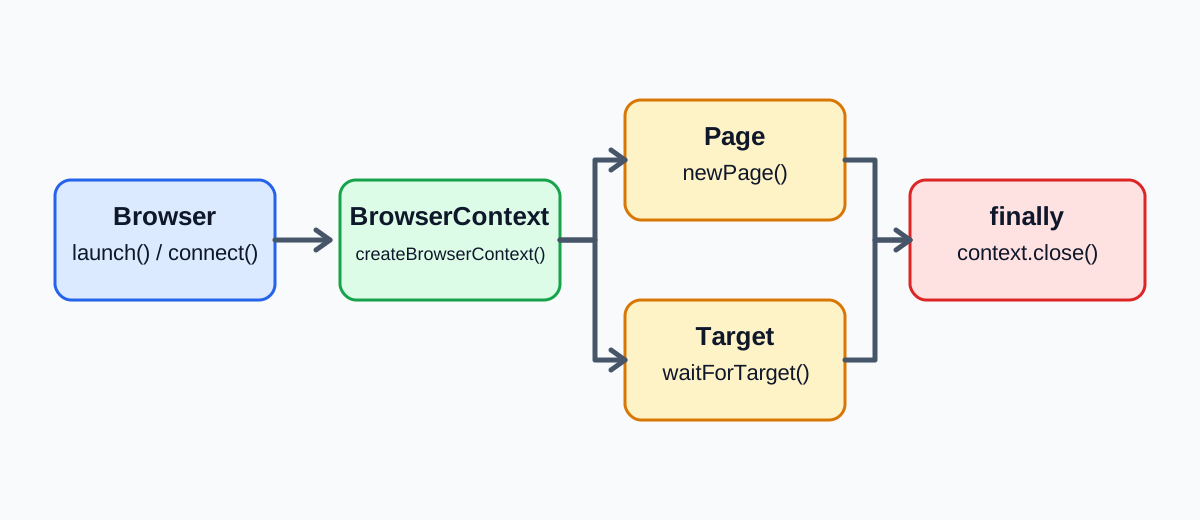
Browser, BrowserContext y Page tienen propietarios diferentes
La respuesta breve es que un Browser de Puppeteer posee la conexión con un proceso de navegador, un BrowserContext posee un grupo aislado de objetivos y datos gestionados por el navegador, y una Page representa una pestaña u objetivo de página dentro de un contexto. El código de prueba es propietario de los manejadores de Puppeteer que crea. Debe cerrarlos en el mismo ámbito en el que los adquirió, salvo que un fixture de nivel superior sea explícitamente responsable de esa limpieza. Este modelo de propiedad permite entender los fallos: el fallo de una página pertenece a un flujo de trabajo, el fallo de un contexto afecta a esa sesión aislada y el fallo de un navegador afecta a todos los contextos que usan el mismo proceso.
Browser.createBrowserContext() de Puppeteer crea un contexto que no comparte cookies ni caché con otros contextos del navegador. context.newPage() crea una página en ese contexto. En cambio, browser.newPage() crea una página en el contexto predeterminado del navegador. Es fácil pasar por alto esta diferencia porque ambas llamadas devuelven una Page, pero solo la primera hace visible en el código al propietario del contexto. Una prueba que requiera aislamiento por escenario debe crear deliberadamente un contexto no predeterminado y crear sus páginas desde ese contexto.
El contexto predeterminado tiene un ciclo de vida especial. browser.defaultBrowserContext() lo devuelve, pero Puppeteer documenta que no se puede cerrar. Termina cuando termina el navegador. Un contexto devuelto por createBrowserContext() se puede cerrar de forma independiente, y al cerrarlo se cierran todas las páginas asociadas. Por eso el contexto predeterminado resulta práctico para un script corto, pero constituye un límite implícito deficiente para un fixture en un proceso de pruebas compartido. Una prueba no puede desmontarlo de forma fiable y permitir a la vez que continúen otras pruebas no relacionadas.
La relación es un árbol de recursos, no solo un grafo de objetos. Un navegador puede contener varios contextos. Un contexto puede contener varias páginas y otros objetivos, incluidos workers. browser.pages() abarca páginas de todos los contextos, mientras que context.pages() limita el inventario a un solo contexto. Por tanto, el descubrimiento amplio a nivel del navegador puede recoger una página creada por otra prueba. Los helpers deben aceptar explícitamente una Page o un BrowserContext, en lugar de buscar en todo el navegador la página que coincida en ese momento con una URL.
El aislamiento también tiene un límite definido. Los contextos separados evitan que se compartan por accidente cookies y caché gestionadas por el navegador, pero no son sandboxes distintos del sistema operativo ni crean cuentas de servicio separadas. Una aplicación todavía puede escribir en una base de datos externa, enviar correo, crear un registro en un proveedor de pagos o mantener una sesión de servidor después de que desaparezca su página. El contexto del navegador posee el entorno de navegación del lado del cliente. La aplicación y el servicio siguen siendo propietarios de sus comportamientos compatibles de cierre de sesión, reversión y retención de datos.
No hace falta inventar un objeto genérico de «estado de almacenamiento» para explicar este ciclo de vida. Puppeteer expone operaciones específicas como cookies del contexto, páginas, permisos y objetivos. Otros almacenes tienen su propio origen y comportamiento de API. Una exportación de cookies no es una captura completa de local storage, IndexedDB, Cache Storage, service workers, JavaScript en memoria ni del estado de una sesión remota. Para conocer esos límites, consulta el modelo de almacenamiento del navegador y mantén explícito al propietario de cada almacén.
Crea un contexto y mantén su limpieza en el mismo ámbito
La forma más fiable de un fixture es adquirir el recurso, abrir inmediatamente después un bloque try y disponer de una ruta de limpieza que se ejecute siempre. No crees el contexto en un módulo, pases solo su página por varias capas y esperes que un hook global de apagado descubra después al propietario que falta. El código que crea el contexto debe conservar su manejador aunque el escenario normalmente solo trabaje con una página.
Este ejemplo asigna un contexto y una página a un escenario autorizado. También conserva tanto un error del flujo de trabajo como un error de limpieza. El primer error sigue siendo el motivo del fallo de la prueba; el segundo permanece visible en lugar de reemplazarlo u ocultarlo en silencio.
import type { Browser } from 'puppeteer';

async function runCheckoutCheck(browser: Browser) {
  const context = await browser.createBrowserContext();
  let workflowFailed = false;
  let workflowError: unknown;

  try {
    const page = await context.newPage();
    page.setDefaultTimeout(10_000);
    page.setDefaultNavigationTimeout(20_000);

    await page.goto('https://example.test/checkout', {
      waitUntil: 'domcontentloaded',
    });
    await page.locator('[data-test="cart-total"]').wait();
  } catch (error) {
    workflowFailed = true;
    workflowError = error;
  }

  let cleanupFailed = false;
  let cleanupError: unknown;
  try {
    await context.close();
  } catch (error) {
    cleanupFailed = true;
    cleanupError = error;
  }

  if (workflowFailed && cleanupFailed) {
    throw new AggregateError([workflowError, cleanupError], 'Workflow and BrowserContext cleanup both failed');
  }
  if (workflowFailed) throw workflowError;
  if (cleanupFailed) throw cleanupError;
}
Crear el contexto antes de entrar en el flujo de trabajo principal es aceptable aquí porque una promesa rechazada de createBrowserContext() significa que no hay ningún manejador de contexto devuelto que cerrar. Si la configuración tiene varios pasos de adquisición, registra cada recurso en cuanto se complete correctamente. Una página, un flujo de descarga, un directorio temporal o una grabación pueden fallar después de que exista el contexto, pero antes de que empiece el escenario. La limpieza debe funcionar con una configuración parcial, sin dar por hecho que todas las variables se inicializaron.
Normalmente no es necesario cerrar cada página antes de cerrar su contexto. BrowserContext.close() cierra el contexto y todas las páginas asociadas. Las llamadas explícitas a page.close() son útiles cuando una página tiene un ciclo de vida más corto que el contexto, cuando una prueba quiere verificar que se cierra una ventana emergente o cuando un escenario largo debe liberar una página antes de terminar. No deben sustituir el cierre del contexto propietario del grupo.
El desmontaje de la aplicación debe realizarse antes que el del navegador cuando el contrato de la aplicación así lo requiera. Por ejemplo, una compra sintética puede necesitar una llamada de cancelación compatible, o una cuenta de prueba puede necesitar la acción normal de cierre de sesión de la aplicación. Realiza esa operación mientras la página y el contexto sigan funcionando y, a continuación, cierra los recursos del navegador. Si falla el desmontaje de la aplicación, intenta de todos modos limpiar el contexto e informa de ambos resultados. Nunca elimines archivos compartidos ni registros de servicio no relacionados solo porque el cierre de un navegador no terminase correctamente.
Mantén la salida del fixture más pequeña que los recursos que administra. Un resultado útil registra el nombre del escenario, la versión del navegador, el resultado de creación del contexto, el resultado de la página y el resultado de la limpieza. No necesita valores de cookies, cabeceras de autorización, el HTML completo ni datos personales. Las capturas de pantalla y las trazas también pueden contener credenciales o contenido de usuario, por lo que solo deben recopilarse para la prueba autorizada y conservarse conforme a la política normal de artefactos del equipo.
Trata las páginas y ventanas emergentes como recursos propiedad del contexto
Una Page siempre pertenece a un contexto del navegador. page.browserContext() permite que el código verifique esa relación, pero es mejor pasar el propietario correcto que descubrirlo después de un fallo. Un helper que abra un informe debe recibir la página o el contexto del escenario. No debe llamar a browser.newPage() salvo que se pretenda colocar la página nueva en el contexto predeterminado. De lo contrario, un helper puede cruzar el límite de aislamiento sin ningún error evidente.
Las ventanas emergentes introducen un segundo problema de propiedad: la página nueva se crea por el comportamiento del navegador, no por una llamada directa a context.newPage(). La ventana emergente sigue perteneciendo a un contexto, pero la prueba debe observarla antes de que la acción del usuario pueda crearla. Esperar después del clic provoca una condición de carrera. Una ventana emergente rápida puede aparecer antes de que existan el listener o el predicado del objetivo, y la prueba se quedará esperando un evento que ya ocurrió.
Puppeteer ofrece un evento popup de página y el descubrimiento de objetivos a nivel de contexto. Una espera de objetivo limitada al contexto resulta útil cuando el navegador es compartido, porque no puede seleccionar por accidente un objetivo de otro contexto. Registra primero la promesa, activa después la acción y, en tercer lugar, espera la promesa ya registrada.
const popupTargetPromise = context.waitForTarget(target => target.opener() === page.target(), { timeout: 10_000 });

const [popupTarget] = await Promise.all([popupTargetPromise, page.locator('[data-test="open-receipt"]').click()]);
const popup = await popupTarget.page();
if (!popup) {
  throw new Error('The opened target was not a page');
}

await popup.locator('[data-test="receipt-number"]').wait();
await popup.close();
El predicado del elemento que abre la ventana es importante. Esperar al siguiente objetivo de tipo page no basta en un contexto con mucha actividad, porque una acción en segundo plano no relacionada puede crear antes otra página. target.opener() === page.target() vincula el resultado a la página que realizó la acción. Si la aplicación reutiliza deliberadamente una pestaña existente en lugar de abrir una ventana emergente, usa la condición de navegación o de contenido correspondiente en vez de imponer al flujo de trabajo la suposición de una ventana emergente.
La navegación tiene la misma regla de orden. Cuando se espera que un clic produzca una navegación, crea la promesa page.waitForNavigation() antes del clic y espera ambas operaciones juntas. Cuando un clic actualiza la página sin navegar, espera una condición visible o de respuesta específica. Un retraso genérico no demuestra que se haya producido la transición prevista, y networkidle no es una señal universal de que la aplicación esté lista en páginas que mantienen abiertas solicitudes de analítica, streaming o segundo plano.
La limpieza de ventanas emergentes sigue el árbol del contexto. Cerrar la ventana emergente libera esa página y conserva la página principal y el contexto. Cerrar el contexto libera ambas. Cerrar solo la página que la abrió no garantiza que todas las páginas abiertas por ella también hayan terminado, por lo que el desmontaje debe apoyarse en el límite del contexto cuando termine el escenario completo. Antes de una aserción a mitad del escenario, context.pages() puede proporcionar un inventario acotado para comprobar el recuento o la propiedad sin buscar en otros contextos.
Los workers y las descargas requieren una disciplina parecida, aunque no todos se representen como objetos Page. Un worker puede continuar la actividad de la aplicación después de una transición de página, y una descarga puede durar más que el clic que la inició. Espera el trabajo propiedad de la prueba que deba completarse, cancélalo mediante una API compatible cuando la cancelación forme parte del escenario y cierra después el contexto propietario. Cerrar el contexto libera recursos del navegador, pero no puede deshacer una mutación remota que un worker ya haya enviado ni un archivo que el ejecutor de pruebas ya haya movido a otra ubicación.
Haz que los tiempos de espera describan una expectativa fallida, no la limpieza
Un tiempo de espera es un límite de observación. Indica cuánto tiempo esperará la prueba una condición concreta; no demuestra que el navegador haya detenido el trabajo subyacente de la aplicación. Cuando waitForSelector, una espera de locator, una navegación o waitForTarget agotan el tiempo, el contexto puede seguir abierto y la página puede seguir ejecutándose. Por tanto, la limpieza debe realizarse después de gestionar el tiempo de espera, igual que después del fallo de una aserción.
Puppeteer separa los valores predeterminados generales y de navegación. page.setDefaultTimeout(ms) establece el máximo predeterminado para los métodos que usan la configuración de tiempo de espera de la página. page.setDefaultNavigationTimeout(ms) controla los métodos de navegación y tiene prioridad en esas operaciones. Una opción explícita del método resulta más clara cuando una acción necesita legítimamente un plazo diferente. Elige los valores según el entorno de pruebas y la transición visible esperada por el usuario, no según la promesa de que todos los sitios terminarán dentro de una cifra universal.
Los tiempos de espera deben identificar la condición que protegen. La espera de un objetivo de ventana emergente debe indicar que no apareció ninguna ventana procedente del origen esperado. La espera de un selector debe nombrar el estado de la aplicación que no llegó a ser visible. Un tiempo de espera de navegación debe distinguir la falta de navegación de una respuesta HTTP que llegó con un estado inesperado. Sustituirlos todos por un único tiempo de espera externo de la prueba genera un solo fallo impreciso y hace que la limpieza compita por el mismo plazo ya agotado.
Reserva un presupuesto separado para el desmontaje a nivel del ejecutor de pruebas. Los métodos context.close() y browser.close() de Puppeteer no aceptan las mismas opciones de tiempo de espera por acción que las esperas de página. Un ejecutor puede imponer un plazo externo, pero Promise.race() solo deja de esperar; no cancela la promesa de cierre perdedora ni demuestra que hayan desaparecido los recursos del navegador. Si un arnés informa de que se agotó el plazo de cierre, debe marcar la limpieza como incompleta y entregar la terminación del proceso al componente que sea realmente propietario del proceso del navegador.
No ocultes un TimeoutError de Puppeteer para continuar en una página cuyo estado se desconoce. Una acción que agotó el tiempo puede haberse completado parcialmente. Reintentar una compra, el envío de un formulario o una operación destructiva del servicio en la misma página puede duplicar el efecto. Primero clasifica si la condición fallida era de solo lectura y admitía reintentos. Para un caso de infraestructura reintentable, cierra el contexto antiguo, crea uno nuevo con las mismas entradas sintéticas autorizadas y ejecuta un intento nuevo. Si existe incertidumbre del lado de la aplicación, usa su contrato compatible de idempotencia o de consulta de estado antes de volver a intentarlo.
Los errores de limpieza también necesitan su propia categoría. Un error al cerrar una página, un error al cerrar un contexto y la desconexión del navegador no equivalen a una aserción de la aplicación. Informa primero del error original del flujo de trabajo y adjunta los errores de limpieza, como hace el ejemplo del fixture con AggregateError. Así se conserva la evidencia de que un selector agotó su tiempo y, a la vez, se muestra que el desmontaje quedó incompleto. Un bloque finally que lanza un nuevo error de cierre sin conservar la excepción original dificulta el diagnóstico de la prueba.
Evita usar un hook de salida del proceso sin límite como mecanismo principal de limpieza. Los hooks de salida son útiles como último límite de diagnóstico, pero el trabajo asíncrono puede no completarse en todos los modos de terminación. El desmontaje por prueba y por fixture proporciona una propiedad determinista mientras el bucle de eventos y la conexión estén operativos. Después, un propietario a nivel de suite debe cerrar el navegador compartido una vez que hayan terminado todos los propietarios de contextos, con su propia política de apagado acotada.
Elige cerrar o desconectar según la propiedad del proceso
page.close(), context.close(), browser.close() y browser.disconnect() tienen efectos intencionadamente diferentes. Elegir entre ellos no es una preferencia de estilo. Es una decisión sobre la propiedad del proceso.
| Operación | Qué termina | Qué permanece |
|---|---|---|
page.close() | Una página | Su contexto, las páginas hermanas y el navegador |
context.close() | Un contexto no predeterminado y todas las páginas asociadas | Los demás contextos y el navegador |
browser.close() | El navegador y todas las páginas asociadas | El proceso de prueba de Node.js y sus recursos ajenos al navegador |
browser.disconnect() | La conexión de Puppeteer con el navegador | El proceso del navegador y sus páginas siguen ejecutándose |
Page.close() no ejecuta de forma predeterminada los hooks beforeunload. Con runBeforeUnload: true, ejecuta esos hooks y Puppeteer no espera a que la página llegue a cerrarse. Usa ese comportamiento solo cuando el handler forme parte del escenario sometido a prueba. El desmontaje no debe depender del handler de descarga de una aplicación para realizar una reversión remota, y que la llamada de cierre se resuelva en ese modo no demuestra que haya terminado la limpieza local o remota.
Browser.close() cierra el navegador y todas las páginas asociadas. Normalmente es la acción final correcta cuando el fixture es propietario de un navegador que inició. Los propietarios de contextos deben cerrar primero sus contextos para poder atribuir un fallo al escenario correcto; después, el propietario del navegador a nivel de suite cierra el recurso de todo el proceso. Llamar solo a browser.close() al final puede liberar recursos, pero oculta qué prueba filtró un contexto o una página durante la ejecución.
Browser.disconnect() desconecta Puppeteer y deja el proceso del navegador en ejecución. Es apropiado cuando otro componente es propietario de un navegador de larga duración y el cliente actual solo posee su conexión. No constituye una limpieza de páginas, contextos, cookies, descargas ni sesiones de servidor. Tras la desconexión, este cliente no puede seguir administrando esos objetos a través del manejador Browser desconectado. El propietario del proceso debe conservar una ruta de control independiente y una política explícita de apagado.
Que el código haya usado puppeteer.launch() o puppeteer.connect() es una pista útil sobre la propiedad, pero el contrato de despliegue es decisivo. Un proceso iniciado por un worker suele pertenecer a ese worker. Un proceso al que se accede mediante un endpoint WebSocket del navegador suele pertenecer a un servicio. El código no debe cerrar un servicio compartido solo porque la API lo permita, ni debe desconectarse de un navegador propio y afirmar después que se liberó el proceso.
El cierre no borra los efectos externos. context.close() elimina ese contexto activo y sus páginas; no revoca un token ya copiado en otro lugar, cancela un pedido, elimina una cuenta de prueba ni borra un archivo descargado por el ejecutor de pruebas. Si un flujo debe borrar datos del sitio y mantener activo el contexto, usa el mecanismo preciso del navegador o de la aplicación y verifica su alcance documentado. La guía de borrado de datos de sitios explica por qué la eliminación de datos del cliente y la limpieza de cuentas son afirmaciones distintas.
Verifica el desmontaje con comprobaciones observables
Ejecuta comprobaciones pequeñas con la versión del navegador y la forma del fixture que realmente utilizas. Las siguientes observaciones proceden de una página local activada en Chrome 154 estándar con Puppeteer 24.40.0; ofrecen condiciones de aceptación para una prueba, no garantías universales de tiempo ni validación de BotBrowser.
| Comprobación | Acción mínima | Observa antes de continuar | No infieras |
|---|---|---|---|
| Cierre de página predeterminada | Añade un handler beforeunload y llama a page.close() sin runBeforeUnload | No se observa diálogo y page.isClosed() es verdadero | Que todas las rutas de cierre mostrarán un diálogo de descarga |
| Cierre con descarga habilitada | Activa la página local, llama a page.close({ runBeforeUnload: true }) y acepta el diálogo | La promesa de cierre puede resolverse mientras page.isClosed() es falso; espera la condición de cierre después de aceptar el diálogo | Que un retraso fijo garantiza el cierre o la limpieza remota |
| Aislamiento de contextos propios | Establece cookies sintéticas y valores de almacenamiento local distintos en dos contextos del mismo origen | Cada contexto lee solo su propio valor | Que los contextos separados aíslan cuentas de servidor o recursos del sistema operativo |
| Cierre de contexto y desconexión | Cierra un contexto propio y luego desconecta un cliente que usa un endpoint de navegador | Su página se cierra mientras el navegador sigue conectado tras cerrar el contexto; después de desconectar, vuelve a conectar mediante el endpoint antes de usar manejadores del navegador | Que disconnect() termina el proceso del navegador o limpia el estado remoto |
Repite estas comprobaciones después de actualizar el navegador o Puppeteer y espera un estado cerrado observable en lugar de un temporizador. Describen un caso local limitado, no un resultado de sitio externo, una prueba de perfil ni una garantía sobre la limpieza de la aplicación.
Aplica el modelo a BotBrowser sin ampliar lo que se afirma
Cuando Puppeteer controla un proceso Chromium de BotBrowser, las API estándar Browser, BrowserContext, Target y Page de Puppeteer siguen definiendo el árbol de recursos de automatización. El encaje específico verificado de BotBrowser es más limitado: su documentación sobre aislamiento multi-cuenta describe almacenamiento y sesiones separados por contexto, además de controles de perfil específicos del contexto para la licencia documentada. Esos controles se asignan antes de crear las páginas, porque un renderer lee la configuración de su contexto al iniciarse. BotBrowser no sustituye a context.close(), la limpieza de páginas, el desmontaje de la aplicación, la invalidación de sesiones del servidor ni la gestión de secretos. No puede hacer que browser.disconnect() termine un proceso, convertir el tiempo de espera de una página en una cancelación, deshacer una solicitud remota ni garantizar que haya terminado un handler de descarga. Puppeteer y el fixture de prueba siguen siendo responsables de la limpieza de la automatización; la aplicación y el servicio siguen siendo propietarios de su limpieza remota compatible.
Ese orden refuerza la regla de propiedad. Crea el contexto, aplica cualquier configuración de contexto documentada y habilitada por la licencia mediante la integración compatible y, solo entonces, crea páginas en ese contexto. Mantén una identidad sintética autorizada por contexto. Un perfil base del navegador no da permiso para reutilizar en silencio la cuenta de otro contexto, y un perfil específico del contexto no es una instantánea serializada de Puppeteer de todos los mecanismos de almacenamiento web.
La disponibilidad también forma parte del contrato. La documentación de BotBrowser enumera los requisitos previos de la compatibilidad completa con fingerprints por contexto, incluida la licencia empresarial aplicable. Un equipo debe verificar la compilación instalada, la compatibilidad del perfil y la licencia antes de depender de controles específicos del contexto. La alternativa segura no consiste en afirmar que se aplicaron flags no compatibles. Haz que la configuración falle antes de crear la página o ejecuta un escenario que use únicamente las capacidades realmente disponibles en ese entorno.
Para una validación acotada, registra solo la versión del navegador, el escenario sintético con nombre, el resultado de creación del contexto, el número de páginas esperado y el resultado de la limpieza. Confirma que dos contextos de prueba no comparten la entrada conocida de cookie o caché utilizada por la prueba. Después, cierra cada contexto mediante el fixture que lo posee y cierra o desconecta el navegador según el contrato del proceso. Esto verifica la configuración elegida; no demuestra que las cuentas remotas no se puedan vincular ni que un servicio haya eliminado sus propios datos.
Sigue esta secuencia de revisión antes de considerar completa una prueba del ciclo de vida:
- Identifica al propietario del proceso del navegador y decide si la acción final es
close()odisconnect(). - Crea un contexto no predeterminado para cada escenario aislado y crea páginas desde ese contexto.
- Registra las esperas de ventana emergente, objetivo o navegación antes de la acción que pueda satisfacerlas.
- Da un significado explícito a las esperas de acciones y conserva el primer fallo mientras se ejecuta la limpieza.
- Verifica por separado la limpieza de la aplicación; después, cierra el contexto e informa de cualquier desmontaje incompleto.
Esta secuencia también facilita la revisión de las actualizaciones del navegador. Las llamadas a la API son visibles, el límite del contexto es explícito y una ventana emergente filtrada no puede ocultarse tras el apagado de todo el proceso. Para el estado específico de los service workers, usa la guía del ciclo de vida de service workers en lugar de tratar el cierre de una página como garantía sobre la caché o los datos remotos.
Fuentes
Artículos Relacionados
Lleva BotBrowser de la investigación a producción
Usa estas guías para entender el modelo y después avanzar hacia validación multiplataforma, contextos aislados y despliegue de navegador preparado para escalar.