未被检测的浏览器:检测器实际读取什么
拆解挑战页采样的表面、同一会话为何在两个供应商处得到相反判定,以及如何按检测器记录版本、通过线与会话配置,替代笼统的未被检测结论。
BotBrowser Team
“未被检测的浏览器”描述的是判定结果,而判定属于执行检查的一方。挑战页不问浏览器是否诚实,它采样一组表面,与自有模型比对,返回一个分数,分数所用的分界与权重由供应商决定。两个检测器可以从同一会话采样不同表面,得出相反结论,而两者都未必出错。BotBrowser 提供可配置的 Chromium 运行时,并说明哪些信号能够保持一致,但不保证任何第三方判定,也不公布通过率,因为通过率是检测器版本、目标站点与会话三者共同的属性,不是浏览器本身的属性。检测器可读取的表面、读数分歧的来源、可复查的记录格式,构成下面的三部分。
TL;DR
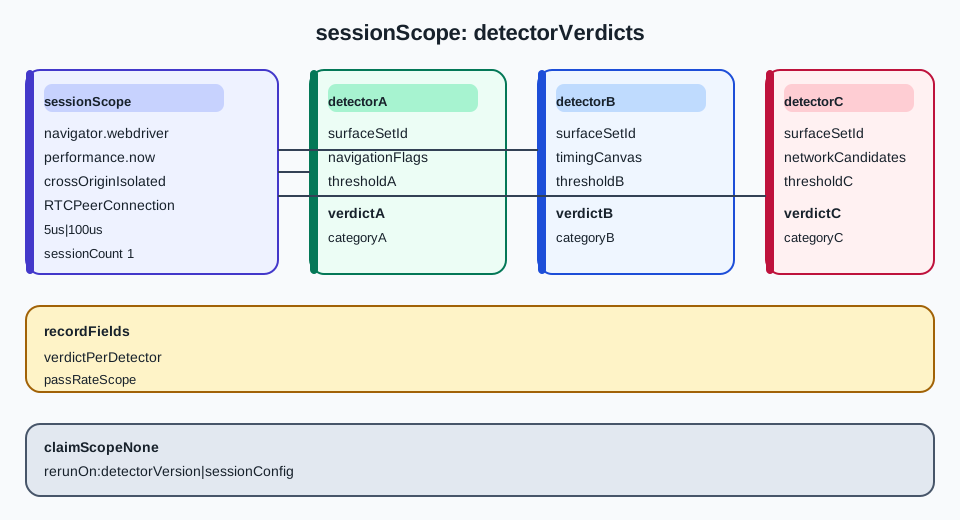
navigator.webdriver是一个布尔值。MDN 记录:Chrome 在使用--enable-automation、--headless或--remote-debugging-port=0时将其置为 true,因此该标志报告浏览器如何启动,不报告页面是否信任它。performance.now()的精度被刻意降低,用于抵御计时攻击与指纹识别:MDN 记录跨源隔离文档中为 5us,其他文档为 100us。在一种精度下运行的计时探针,无法与另一种精度下的同一探针比较。- 判定是检测器自有模型的函数。两家供应商采样不同表面,可能对同一会话给出不同结论,而两者对所测内容都未必判断错误。
- 把主张换成记录:检测器名称与版本、它报告的表面、它应用的通过线、会话配置、时间戳。记录可以比较,主张不能。
- 可交付的诚实结果是一张按检测器分行的结果表,并写明失败模式,而不是产品名里的一个形容词。
目录
挑战页能采样什么
检测器读取的内容,就是页面上任意脚本能读取的内容。整个表面有限且平淡,值得逐项列出。
导航与自动化标志
navigator.webdriver 是这组信号里页面最先看到的一个,单独看只承载一个 bit。MDN 将其定义为只读属性,表示用户代理是否由自动化控制,并记录使 Chrome 返回 true 的具体条件:--enable-automation 标志、--headless 标志,或端口为 0 的 --remote-debugging-port。每一条描述的都是启动配置。读取该布尔值的页面,只学到进程如何启动;只读这一个值的页面,等于决定信任一个比特。
相邻信号从其他角度描述同一次启动。window 对象上存在自动化专用的绑定、回环地址上有调试端口应答、用户代理字符串写明 headless 构建、window.chrome 对象的形状与标准安装不同,都指向同一个问题:这个浏览器是否按真人浏览器的方式启动。它们都不回答会话是否会被信任,因为检测器可以把这些权重设为零。
用户代理字符串与 Client Hints 提供同一项声明的不同切片。navigator.userAgent 返回单个字符串,而 navigator.userAgentData 返回由 { brand, version } 对组成的 brands 数组、一个 mobile 布尔值和一个 platform 字符串。getHighEntropyValues() 方法接受一组字段名,包括 architecture、bitness、model、platformVersion 和 uaFullVersion,并返回携带这些取值的 promise。只读 brands 的检测器,看到的比索取 uaFullVersion 与 bitness 的检测器更少,这是两个不同表面集合的又一个例子。
| 信号 | 描述的内容 | 单独看为何弱 |
|---|---|---|
navigator.webdriver | 是否使用了自动化标志 | 一个布尔值,供应商可以忽略 |
window 上的自动化绑定 | 哪个库注入了脚本 | 直接启动时缺失,部分框架中存在 |
| 调试端口可连接 | 协议端点是否开放 | 真人浏览器关闭该端口属于正常 |
| 用户代理字符串 | 浏览器声称自己是什么 | 可配置,是声明而非测量 |
window.chrome 形状 | 属于哪个 Chromium 构建家族 | 随构建变化,不反映可信程度 |
存储与权限表面
存储是第四组信号,随用户历史变化,而不随浏览器构建变化。Cookie 是否可用、第三方存储是否分区、配额探测两次是否返回同一数值、某个源此前是否被访问过,描述的都是会话的过去,而不是它的配置。读取这些内容的检测器在问:这个 Profile 以前来过这里吗;这与浏览器是否自动化是不同的问题。
配额与用量可通过 navigator.storage.estimate() 取得,它返回带有以字节计的 quota 与 usage 的 promise。用 indexedDB.databases() 枚举数据库会返回名称与版本,caches.keys() 列出缓存名称。这三次调用让检测器在不读取任何内容的情况下获得累积状态的信息:只要存在一个有名称的数据库或一个带版本的缓存,全新 Profile 与使用过的 Profile 就已经区分开。
权限同理。文档可以通过 navigator.permissions.query() 查询的权限集合、每项返回的 granted、denied 或 prompt 状态、请求是否触发提示,都能在没有用户交互的情况下观察到。Notification.permission 的值与 navigator.permissions.query({ name: 'geolocation' }) 的结果就是这类读取的两个例子。页面因此可以勾勒出一个 Profile 先前的授权决定,全新 Profile 与长期 Profile 在浏览器构建相同的情况下回答仍然不同。
因此监控或对比任务应当有意决定使用全新 Profile 还是持久 Profile,并记录该选择。两种选择在这个表面上给出不同答案,谁都不比谁更可信,它们只是不同的会话。
计时与性能表面
计时容易被忽略,因为它看起来测的是机器,而不是浏览器。MDN 记录 performance.now() 的精度被刻意降低:跨源隔离文档中(crossOriginIsolated 为 true)为 5us,其他文档为 100us。最小可观察间隔相差二十倍,而这个差值来自文档的隔离状态,不来自硬件。
对比较的后果很直接。测量两次 performance.now() 调用之间最小非零差值的探针,读到的是精度,不是机器。同一探针在隔离文档与非隔离文档中运行,数值相差二十倍。采样计时行为的检测器因此观察到所在文档的隔离状态,两次运行之间改动该状态,测量结果也随之改变。
crossOriginIsolated 属性以布尔值形式提供给页面,检测器据此无需测量任何间隔,就能把文档归入两种精度之一。会话记录若缺少该字段,就无法确定计时器可能观察到两个取值中的哪一个。
第二个时钟的行为不同。Date.now() 返回整毫秒,因此基于它的探针无法分辨小于一毫秒的间隔,也看不出 performance.now() 的精度降低。requestAnimationFrame 回调按显示器刷新率到达:60 Hz 下约每秒六十次,120 Hz 面板上约每秒一百二十次。把三种时间源混在一起的检测器得到三个不同的精度下限,这也是记录文档配置的又一个理由。
网络与媒体表面
RTCPeerConnection 向创建它的页面暴露本地候选信息,候选收集因此是检查 WebRTC 泄漏的一种方式。同一调用还显示某条连接路径是否支持该协议,页面无需完成通话就能区分被阻断的路径与可用的路径。媒体设备、canvas 渲染、WebGL 参数、字体度量与音频处理属于同类表面:每一项都是合法 API,输出依赖环境,页面无需申请特殊权限即可采样。
navigator.mediaDevices.enumerateDevices() 返回的设备列表内容取决于权限:MDN 说明,除默认设备之外的设备只有在授予权限后才会列出,因此从未申请权限的文档只能看到默认设备且看不到标签。kind 字段仍然有值,检测器因此能在不弹出提示的情况下统计设备类别;在授予捕获权限之前,deviceId、label 与 groupId 都返回空字符串。canvas 输出取决于驱动、抗锯齿设置与已安装字体,WebGLRenderingContext.getParameter() 给出渲染器供应商与型号,AudioContext 报告 sampleRate,而 DynamicsCompressorNode 暴露 ratio、knee、attack 与 release。canvas、WebGL 与 audio 的读数不要求调用 getUserMedia;已填充的设备标识符与标签则要求媒体权限或已授予捕获。
网络指标再补一个独立切片。navigator.connection.effectiveType 取值为 slow-2g、2g、3g 或 4g,rtt 与 downlink 字段估算延迟与吞吐,saveData 报告省流量模式。performance.getEntriesByType('resource') 的条目携带 nextHopProtocol、transferSize、encodedBodySize 与 decodedBodySize,页面因此能在不访问响应内容的情况下区分连接协议与传输体积。
BotD 检测器注册表列出某个开源检测器实际运行哪些检查,公开检测套件实际测试什么比较若干公开套件采样的表面集合。把它们并列的理由是彼此独立。只采样计时、只采样 canvas 或只读导航标志的检测器,看到的是同一会话的不同切片,满足其中一个切片的浏览器改动,可能移动另一个切片。
两个检测器为何对同一会话给出不同结论
分歧是结构性的,不是两家产品各自的缺陷。
每家供应商拥有自己的模型
检测器的输出是分数,权重与通过线由供应商选择并修订。两家供应商对同一会话得出不同判定,原因有三条:采样的表面集合不同,对共有表面的权重不同,把通过线放在不同位置。这三项从浏览器一侧都看不见。
这也是“通过率”不属于浏览器的原因。它属于浏览器、检测器版本、目标站点与会话的组合。只引用其中一个数字,等于引用一份去掉了条件的测量。
| 分歧原因 | 差异所在 | 浏览器能做什么 |
|---|---|---|
| 表面集合不同 | 一家读计时,另一家读 canvas | 直接影响有限,表面由供应商选择 |
| 权重不同 | 同一信号的计分多少不同 | 无法干预,权重是内部实现 |
| 通过线不同 | 通过线落在别的位置 | 无法干预,通过线属于供应商内部 |
| 检测器版本不同 | 版本之间模型发生变化 | 每次发布后重新测试 |
| 目标站点不同 | 不同站点运行不同配置 | 测试实际目标 |
同一浏览器,两种判定
通过一家、失败另一家的会话是常态,并非表面上的矛盾。通过的供应商可能没有采样发生变化的表面;失败的供应商可能只采样那个表面。把这一对读成“浏览器一半未被检测”,等于发明一个没有供应商报告过的指标。
有用的读法更窄。每个判定都是某个检测器模型作用于某个会话的陈述。两个判定放在一起,说明该会话在一个模型中靠近边界,在另一个模型中位于内部,这是关于边界的信息,不是关于浏览器的信息。
“未被检测”不能意味着什么
这个词承诺的结果无法由本地改动交付,因为结果在别处由运营方无法控制的模型产生。配置可以移除某个标志、对齐一组信号、让 Profile 在一次运行中保持一致,却无法决定供应商模型如何处理结果,也无法保证模型下个月不变。
把这个词当成产品主张而非对过去观察的描述,是这类说法容易引出的错误。公布通过率的供应商,公布的是一次在特定条件下的测量,那些条件未必与目标环境相同。
用测量记录替代主张
主张的替代品是可复查的记录,包含五个部分,每一部分成本都低。
五个字段
第一个是检测器:名称,以及产出该判定的模型版本或日期。没有版本,供应商更新后结果无法复现。第二个是检测器报告的表面集合,用检测器自己的措辞,因为供应商的分类名是唯一共用的词汇。第三个是判定落入的通过线或类别,不是换算后的百分比。第四个是会话配置:浏览器构建、Profile 标识、启动标志、线路、locale、时区与文档的隔离状态。第五个是时间戳与目标站点。
| 字段 | 示例形态 | 为何必须记录 |
|---|---|---|
| 检测器身份 | 供应商名加模型日期 | 模型变化会使比较失效 |
| 报告的表面 | 供应商自己的类别标签 | 这些标签是唯一共用的词汇 |
| 判定类别 | 通过、挑战、拦截,或供应商自己的术语 | 换算成百分比会丢掉通过线 |
| 会话配置 | 构建、Profile、标志、线路、locale、隔离状态 | 两种配置不是同一次测量 |
| 目标与时间 | URL 类别加时间戳 | 同一供应商对不同目标给出不同评分 |
记录产出判定的配置
配置字段容易遗漏,却正是让记录有用的部分。浏览器构建标识、Profile 标识、生效的启动标志、线路的出口区域、协商后的 locale 与文档的跨源隔离状态放在一起,足以让第二次运行按同一条件搭建。记录隔离状态的理由来自计时部分:它让计时探针可观察的精度相差二十倍。
记录实际生效的值,而不是请求的值。站点覆盖了请求的 locale,或请求的线路发生故障切换,产生的会话就与记录不符,除非记录抓住真正生效的内容。
用结果表替代形容词
经得起审视的交付物是一张表:每个检测器一行,上面每个字段一列,再加一列观察到的判定,以及检测器拦截时的一列失败模式。读者能看到浏览器通过两个检测器、被第三个挑战,并判断第三个是否影响目标站点。
这张表也是对产品名所暗示问题的诚实回答。它说明测了什么、由谁测、在什么配置下、何时测。它不写“未被检测”,那个词会抹掉表里每一列。
改动后需要重测什么
三种改动使已存结果失效。检测器发布新版本会改变模型,该行必须重新测量,不能重读。浏览器或 Profile 更新会改变会话配置,该行的配置字段不再匹配。目标站点改动,包括同一站点上线新的挑战版本,会改变被测对象。
其余内容可以复用。这是记录的实际收益:把一个开放式问题变成少量行,只在特定条件变化时刷新。
FAQ
把 navigator.webdriver 设为 false 就能让浏览器不被检测吗?
不能。MDN 将该属性记录为报告是否使用自动化标志的信号,检测器可以给它零权重,也可以与其他观察交叉核对。读取该布尔值的页面只读到一个比特;供应商的模型读取许多信号,权重由供应商内部设定。
为什么同一浏览器通过一个检测器、失败另一个?
因为两家供应商采样不同表面、对共有表面赋不同权重、把判定线放在不同位置。在一个模型中靠近边界的会话,可能在另一个模型中深入内部。这一对判定描述的是两个模型,不是同一浏览器的两半。
通过率能作为产品属性公布吗?
比率只能连同条件一起公布:检测器与模型版本、目标站点、会话配置与测量窗口。缺少这些,数字描述的测量无法复现,供应商后续更新就能使其失效,浏览器一侧无需任何改动。
实践结论
从表面清单出发,而不是从形容词出发。读一遍挑战页能采样什么,记住 navigator.webdriver 报告启动标志、performance.now() 的精度取决于文档隔离状态,并接受判定来自运营方无法控制的模型。
下一步是一张表。选定对目标站点重要的检测器,记录名称与模型日期、它报告的表面、返回的类别,以及包含隔离状态的完整会话配置,然后在同一配置下运行两次,看该行是否稳定。两行一致证明测量可重复,不证明判定成立,区别就在这里。
Sources
本文属于指南: 什么是浏览器指纹?原理、风险、信号与隐私边界