CreepJS 字体表:51 个名字与 14 种可能返回值
CreepJS 检查 51 个字体名来推断 Windows 或 macOS 版本。执行它的字体表可以看出每个结论都需要一整套基础字体,而不是一个偶然字体。
BotBrowser Team
BotBrowser 记录了页面自己的字体检查找到了哪些字体族;它不会更改已安装字体,也不能让这些字体描述另一个操作系统。CreepJS 读取一份固定的字体名清单,把页面能检测到的名字转成 Windows 或 macOS 版本。执行它公开的表可以看出,这个查找比表的形状严格得多:它能说出的每一个版本都需要一整套基础字体,一个偶然出现的字体族什么都决定不了。
这份源码中的 3 个 Android 字体名本身不能说明它们来自哪种嵌入上下文。CreepJS 与 Android WebView 信号边界将页面可见值与请求层和可选应用桥接信号分开说明。
观看视频
以下英文视频介绍公开字体表中的查找逻辑。源码列出 13 个有名称的 Windows 与 macOS 版本;第 14 种可能返回值是 undefined,表示没有完整基础桶匹配。音频为英文。可复现记录使用合成的字体名称集合,并未声称测量真实浏览器的字体。
摘要
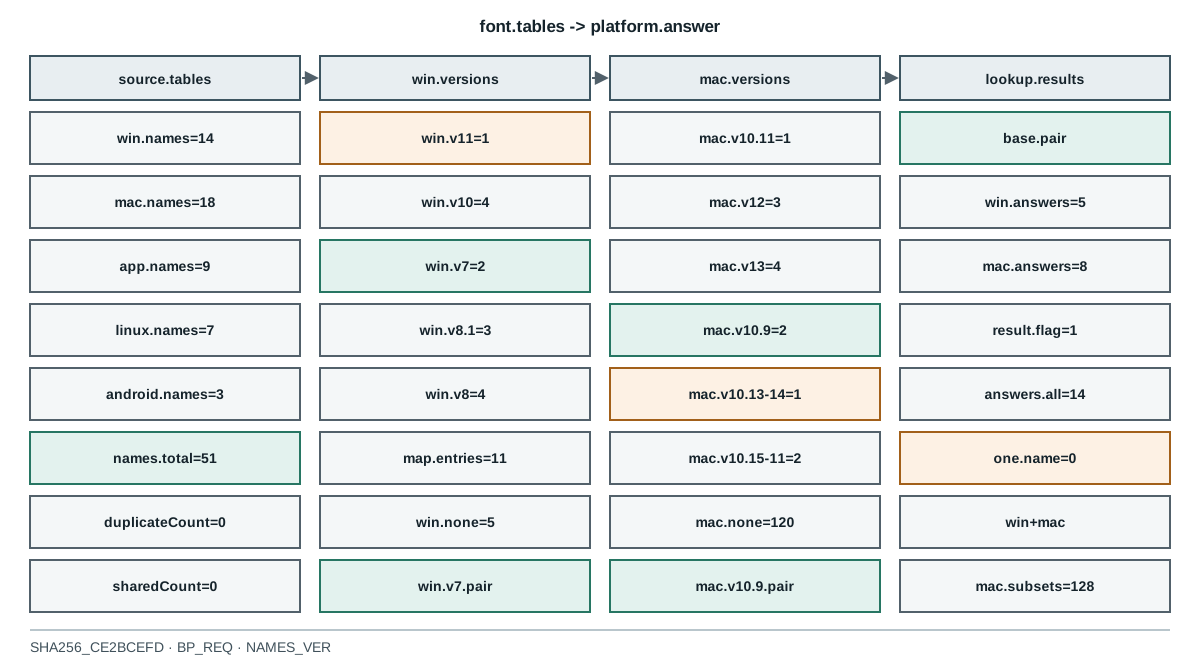
- 公开模块在五张表里声明了 51 个字体名:Windows 14 个、macOS 18 个、桌面应用 9 个、Linux 7 个、Android 3 个。
- 这 51 个名字本身互不重复:没有任何名字同时出现在两张表里,所以检查之前没有东西需要合并。
- Windows 表把 14 个名字分成五个版本分组,最小的分组只有一个名字。
- macOS 表把 18 个名字分成八个分组,其中两个分组只有一个名字。
- 单名分组是必要条件,但从不是充分条件:Windows 映射只为含完整 Windows 7 那一对的键保留条目,所以只有
Segoe Fluent Icons什么都返回不了。 - CreepJS 使用两条检测路径,
document.fonts.check与一次本地字体加载,再把两边答案合并成一份排序清单。 - 执行这个查找会得到 5 个 Windows 结论、8 个 macOS 结论和 1 个「没有结论」,一共可以返回 14 个值。
目录
字体表声明了什么
字体模块是一份数据文件,上面只有少量逻辑。探针把每张表当作数据执行,而不是扫描它的文本,因为版本标签是带引号的键,文本扫描会把它们也当成名字数进去:
source -> https://raw.githubusercontent.com/abrahamjuliot/creepjs/master/src/fonts/index.ts
source_bytes -> 12847 sha256=ce2bcefd13e41cef79bfdf63634ad17ca7f641ee2e88c0ef720c2d38938dbf11
table:WindowsFonts -> names=14 shape=buckets
table:MacOSFonts -> names=18 shape=buckets
table:DesktopAppFonts -> names=9 shape=buckets
table:LINUX_FONTS -> names=7 shape=list
table:ANDROID_FONTS -> names=3 shape=list
fontlist -> length=51 distinct=51 duplicated=0
overlap:windows_macos -> 0
overlap:linux_android -> 0
五十一个名字,没有重复。这就是这个库字体那一半的全部检测面。运行该模块的页面会询问 51 个字体族,模块能得出的每一个平台结论,都来自它在这 51 个名字里找到了哪些。
同一份公开源码也支撑CreepJS 的信号分组与合并方式,字体清单在那里只是若干分组之一;以及CreepJS canvas 种子循环,那篇读的是 canvas 模块里的生成器。
五张表不是同一份清单的不同拼写。Linux 的七个名字是 Ubuntu 或 Chrome OS 镜像会带的字体族,Android 的三个名字是一组移动端字体,和 Chrome OS 有重叠,而不是桌面组合。每张表都贡献别的表没有的名字,模块最后把它们一次性合并成一份按字母排序的清单交给页面检查。
Windows 和 macOS 数量接近:14 对 18。这种接近反而更容易误导,因为两张表被读取的规则不同,而更严格的那条规则决定结论到底出不出现。
为什么一个名字永远不够
这些表不是平铺清单。每个版本是一个分组,查找只问分组里有没有任何一个名字:
bucketsizes:WindowsFonts -> 7=2 8=4 10=4 11=1 8.1=3
bucketsizes:MacOSFonts -> 12=3 13=4 10.9=2 10.10=2 10.11=1 10.12=3 10.13-10.14=1 10.15-11=2
hashkeys:windows -> 11 macos=8
answers:windows -> 5 11,10,8.1,8,7
answers:macos -> 8 Ventura,Monterey,10.15-11,10.13-10.14,Sierra,El Capitan,Yosemite,Mavericks
answers:possible_returns -> 14
Windows 11 分组只有一个名字 Segoe Fluent Icons,macOS 10.11 分组只有一个,10.13-10.14 分组也只有一个。只看分组会以为找到其中一个字体就定了版本,执行查找的结果不是这样。
每个版本键都会被计算出来、拼成一个排序字符串,再去固定映射里查。映射里每个条目都含 Windows 7 那一项,因为 Windows 7 是唯一要求整套字体、而不是任意单个名字的检查。排序拼接把 7 放在它字母序的位置:位置会变,是否存在不会变。一个字体集合如果有 Segoe Fluent Icons 却没有 Windows 7 的两个名字,一个键都对不上:
replay:windows_11_bucket_only -> undefined (input=1)
replay:windows_7_both_names -> Windows 7 (input=2)
replay:windows_7_one_name -> undefined (input=1)
sweep:windows:undefined -> 5 subsets 11 10 11+10 11+8.1 11+8
sweep:windows:Windows 11 -> 1 subsets 11+10+8.1+8
上面这轮遍历,是把四个增量分组的所有子集加到 Windows 7 那一对上。十六种组合里有五种什么都返回不了。唯一返回 Windows 11 的组合,是五个分组全部齐全。整组移除和从组里移除一个字体族是两件不同的事,探针把它们分开:
drop:Segoe Fluent Icons -> Windows 10
drop:Segoe MDL2 Assets -> Windows 11
drop:Segoe UI Emoji -> Windows 11
drop:Cambria Math -> macOS Ventura
单名分组没有余量:丢掉 Segoe Fluent Icons 就失去 Windows 11 的结论。多名分组有余量,只要组里还剩任何一个名字它就仍然为真:Segoe MDL2 Assets 在 Windows 10 的四个名字里,Segoe UI Emoji 在 8.1 的三个名字里,所以丢掉任何一个仍然返回 Windows 11。丢掉 Windows 7 的名字是最锋利的情形:Windows 查找什么都返回不了,由 macOS 兜底接管。在同时装着 macOS 字体族的机器上,结论翻成 macOS Ventura;在只有 Windows 字体的机器上变成 undefined。两种情况里,Windows 结论都因为一个缺失的字体族而消失。
macOS 一侧更严格。八个条目都含 10.9 那一项,映射里没有为「有较新分组、但没有它」的集合准备任何条目:
sweep:macos:macOS Mavericks -> 1 subsets base:10.9
sweep:macos:macOS Ventura -> 1 subsets 13+12+10.15-11+10.13-10.14+10.12+10.11+10.10
sweep:macos:undefined -> 120 subsets
128 个子集里有 120 个什么都返回不了。八个命名结论各自只对应一个子集,结论取的是命中的最新分组。一台只报告 Ventura 时期字体、缺了 Helvetica Neue 和 Geneva 的机器拿不到任何 macOS 结论,尽管已经找到四个 Ventura 分组里的名字。
所以单名分组是真实存在的,但作用很窄。Segoe Fluent Icons 只在 Windows 7 的两个名字和另外三个分组都已经匹配之后,才用来区分 Windows 11 和 Windows 10。真正该记录的不对称,是表的形状和查找的形状之间的差别:表看起来是一组互相独立的 OR 测试,映射却像一把只有在基础集合齐了之后才启动的阶梯。
这把阶梯还有第二个后果,分组计数看不出来。因为每个映射键是所有为真项排序拼接出来的,多出一个作者没预料到的分组,就会拼出一个映射里没有的键字符串。查找不会退回到最接近的匹配,而是直接返回空。公开的表在自己的名字下是封闭的,所以任何带齐 14 个名字的真实 Windows 11 集合,包括四个 Windows 8 字体族,仍然返回 Windows 11;风险在于表更新时加进了分组却没有加进对应的键。
桌面应用表又是另一条规则,这个差别值得直说,因为这是唯一一处故意要求完整匹配的地方。getDesktopApps 把每个应用的字体集与找到的清单比较,只有集合里每个名字都在时才返回这个键。四个应用因此最多产生四个结果,部分匹配一个都不产生。
两条检测路径补充了什么
模块不依赖一种方式判断字体是否存在:
detection_paths -> 2 document.fonts.check and local font load
union -> fontsChecked then fontsLoaded, deduplicated
document.fonts.check 路径直接询问字体集合,报告某个字体族是否对文档可用,模块用它遍历全部 51 个名字。local font load 路径为每个名字构造一个对象并等待加载结果,留下成功的那些。
两条路径都存在,是因为它们可能不一致。浏览器可以让一个字体在一个 API 上可用、在另一个上加载失败,只查一条路径的页面就会漏掉这种分歧。两条回答的并集是模块的最终清单,排序并去重,所以结果对两条路径的返回顺序是稳定的。
把两份路径清单分开保存的报告,还能说明某个 API 在某台机器上是否系统性地更弱。如果查询路径什么都没找到、加载路径却找到了名字,多半是那道保护触发了,这和一台真的没有字体的机器是两种不同的观测。
遍历清单之前,模块会先查一个故意随机的族名。当这个检查报告随机名字可用时,模块跳过逐名查询,改用加载路径。这个保护避免去信任一个声称包含所有名字的字体集合。
读报告时很容易漏掉这道保护,因为跳过查询和查询失败都会让已检查清单为空。只有当报告写明随机名探测是否返回真时,这两种状态才分得开。看到已检查清单为空、已加载清单却是满的,应当判断为保护触发,而不是每个字体族都没通过可用性检查。
被去重合并的名字,和只被找到一次的名字看起来一样,所以报告应当把两份路径清单分开保存。查找与顺序无关另有原因:分组检查用的是成员判断和长度比较,键是对分组标签排序拼出来的,不是对字体清单排序。探针把同样的 32 个名字倒序输入来验证这一点:
reorder:reversed_names -> Windows 11
两条路径的失败方式也不同。一次抛出异常的查询会把整个模块带进捕获分支并返回空清单,而单个加载失败只会把那个名字从已加载清单里去掉。把两份清单分开保存,才能分出一整个模块的故障和一个没加载成功的字体族。
推断在哪里停止
两次平台查找的先后,也决定同时装着两张表字体的机器报出什么。getPlatformVersion 先试 Windows,只有 Windows 返回空时才退到 macOS,所以一台恰好满足所有 Windows 分组的 Mac 会被报成 Windows。探针把这个情形做实了:同时装着全部 14 个 Windows 名字和全部 18 个 macOS 名字的集合返回 Windows 11,不是 macOS Ventura。
WindowsFonts 和 MacOSFonts 两张表也只是作者当时关心的平台快照。新的系统版本如果带的是表里没写名字的字体,在表更新之前对模块是不可见的,所以「没有匹配」不能当成「平台是新的」的证据。
macOS 表是唯一用两位版本标签的,而且标签是区间不是精确值:10.13-10.14 是一个分组,10.15-11 是另一个。所以一次匹配确定的是一个范围,不是一个具体版本,报告应当保留这个范围,而不是把它四舍五入成一个版本号。
查找在字体清单构建之后才运行,所以检测阶段的失败会产生空清单,也就没有平台结论。这一点重要,因为「没有结论」是一个值,不是两个:读到空版本的页面,应先看清单是否为空,再判断机器不被识别,因为空清单和「非空清单但没有匹配键」产生的是同一种沉默。
公开模块还提供少量应用字体集,每个都与找到的清单按组比较:
bucketsizes:DesktopAppFonts -> Microsoft Outlook=1 Adobe Acrobat=1 LibreOffice=4 OpenOffice=3
这张表很小,只有九个名字,每个应用自己的集合更小。拥有某个应用的字体,不等于正在运行该应用,因为字体可以被复制或单独打包。模块把完整的应用字体集当作该应用的证据,报告也应该这样表述,而不是把它当成程序已经安装的证明。
同一个会话里调用两次模块,可能得到两份清单,因为两次调用之间可能有字体加载完成。模块在两次运行之间不缓存任何东西,每次都重建清单,所以第二次读数是新的观测,而不是第一次的刷新视图。
页面真正检查的是合并后的清单,所以只出现在某个平台表里的名字,在每个平台上仍然会被问到。一台 Windows 机器也会被问有没有 macOS 的名字,答案几乎总是没有。两张表就是这样保持独立的:页面问并集,平台查找只读并集里自己关心的那部分。
字体清单也会在没有更换浏览器的情况下变化:给一个用户安装字体会改变那个用户浏览器报出的内容,另一个用户的清单不受影响;一次软件包更新也可能加进原本没有的名字。平台结论跟着清单走,所以它跟着一次安装变化,而不是跟着系统版本变化。
14 个可能返回值也决定了最小可用的报告。单个版本字段能说出结论,却说不出理由,想复核这次推断的读者需要命中的分组集合,而不只是它给出的版本名。报告应当把 source 摘要和字体清单放在同一条记录里,因为只有清单没有版本号无法核对,只有版本号没有清单看不出浏览器到底找到了什么。
14 个返回值也决定了两次机器比较能断言什么。两份都写着 Windows 11 的报告,只有在保存的分组集合一致时才算一致,因为同一个结论可能来自略有差异的发现清单。比对保存下来的清单,才能把安装字体的真实差异和同一批字体被读了两遍区分开。
记录一次字体读数
字体读数支撑一个窄断言:这个源码版本、这套表,产出了这份清单。四个字段让它保持可核对:
- 源码摘要,因为表一变,页面询问的名字就变,版本结论的含义也变。
- 页面找到的名字,而不只是版本,因为结论是整个清单的函数,无法只从版本名重新推出来。
- 每个名字是哪个检测路径找到的,因为两条路径是分开的观测,而排序后的并集把区别藏了起来。
- 分组大小,因为一个名字支撑的版本结论和四个名字支撑的不是同样的证据。
公开来源
实践结论
保存了命中的 Windows 11 分组和两份路径清单的记录,可以用一段短脚本重放;只存版本号的记录离开浏览器就无法核对。把找到的字体名和版本一起记录,因为结论依赖一整套基础字体,无法只从版本名重新推出来。把两条检测路径当作分开的观测,因为排序后的并集看不出是哪个 API 找到了某个名字。把 14 个可能返回值理解成查找的规模而不是准确度,因为单名分组只有在映射里其他每个分组都匹配之后才起区分作用。关于这个库如何把字体信号和 canvas、audio 分组放在一起,读CreepJS 的信号分组与合并方式;关于同一模块里的 canvas 生成器,读CreepJS canvas 种子循环。
本文属于指南: 什么是浏览器指纹?原理、风险、信号与隐私边界