Twitter scraping: окна API и ограничения браузера
Выбор endpoint, периода и авторизации для публикаций, упоминаний, поиска и ленты X. Отличия HTML для встраивания от данных API и ранжированной ленты.
BotBrowser Team
Нужна структурированная документация по теме Начало работы?
Эта статья относится к редакционной библиотеке. Для пошаговой настройки, справки и постоянных обновлений переходите сразу в соответствующий раздел docs.
Задачи twitter scraping часто оказываются невыполнимыми ещё до первого селектора: запрошенная история или порядок не соответствуют выбранному endpoint X. Сначала нужно выбрать продукт данных, контекст авторизации и временной интервал. BotBrowser поддерживает интеграцию Chromium с Playwright и Puppeteer для отдельно разрешённых браузерных проверок; он не предоставляет доступ к API X, не расширяет историю endpoint, не воспроизводит алгоритмическое ранжирование и не снимает ограничения платформы. Настройка браузера следует после выбора данных, когда действительно остаётся разрешённая браузерная задача.
TL;DR
- Публикации автора, упоминания, хронологическая домашняя лента и результаты поиска являются разными наборами с разными документированными пределами.
- Недавний поиск охватывает последние 7 дней; полный архив начинается с марта 2006 года при выполнении условий доступа.
- Endpoint обратной хронологической ленты не воспроизводит алгоритмический порядок. Встраиваемая лента возвращает разметку для отображения, а не экспорт истории публикаций.
- Истечение токена OAuth 2.0, учёт запросов API и срок браузерной сессии являются отдельными вопросами. Дополнительные сессии не создают отсутствующих прав на данные.
Содержание
- Соотнести требование с результатом X
- Проверить три задачи на исторические ограничения
- Связать авторизацию и срок действия с маршрутом
- Разделить лимиты запросов и наблюдения браузера
- Практический вывод
Соотнести требование с результатом X
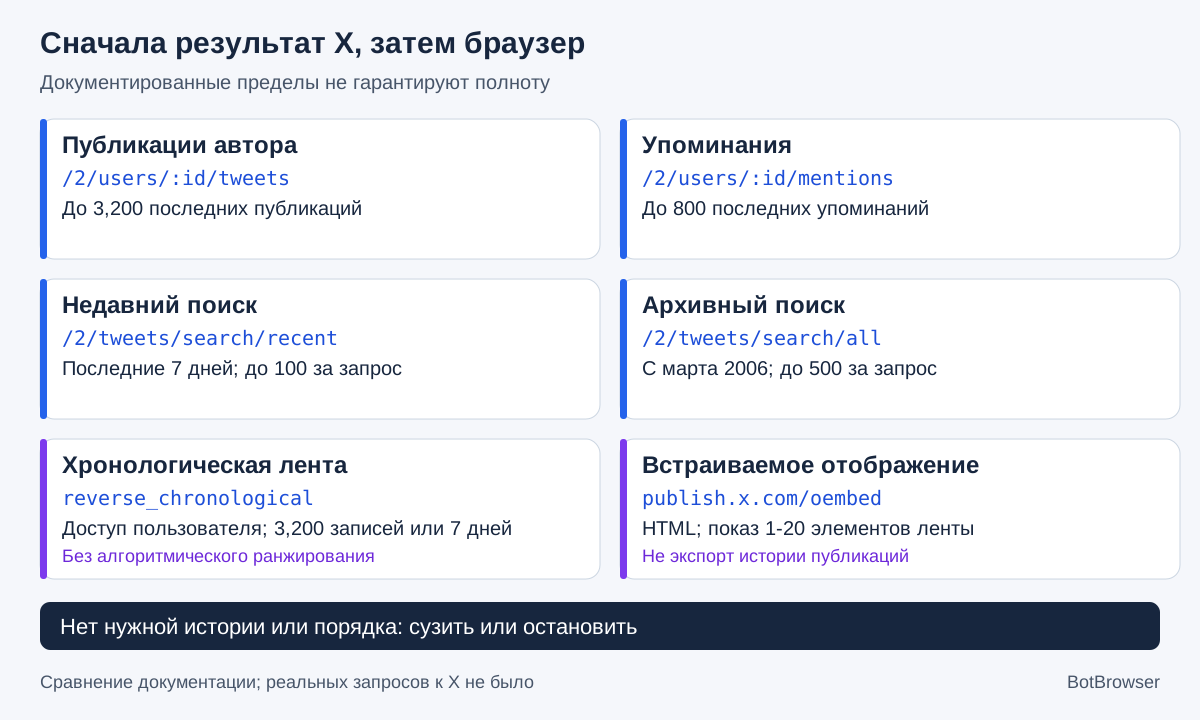
Документация лент X разделяет публикации автора, упоминания и обратную хронологическую домашнюю ленту авторизованного пользователя. Клиенту, которому нужны ответы с упоминанием его аккаунта, требуется не список собственных публикаций. Продукт, которому нужно увиденное человеком в ранжированной ленте, запрашивает иной порядок, чем хронологический endpoint. Это различие должно оставаться в спецификации, а не исчезать за общим названием «твиты».
| Требуемый результат | Возможный официальный маршрут | Документированный предел и правило выбора |
|---|---|---|
| Публикации, написанные аккаунтом | /2/users/:id/tweets | До 3,200 последних; фильтры и временные параметры не создают архив за всё время |
| Публикации с упоминанием аккаунта | /2/users/:id/mentions | До 800 последних упоминаний; не заменять собственными публикациями аккаунта |
| Хронологическая лента авторизованного пользователя | /2/users/:id/timelines/reverse_chronological | Последние 3,200 публикаций или 7 дней; нужна пользовательская авторизация, алгоритмическое ранжирование исключено |
| Совпадения запроса в недавнем периоде | /2/tweets/search/recent | Последние 7 дней, до 100 за запрос; проверить доступ разработчика/приложения и поддержку запроса |
| Совпадения за более ранний период | /2/tweets/search/all | Архив с марта 2006, до 500 за запрос; проверить текущий доступ с оплатой использования или Enterprise |
| Показ публикации либо поддерживаемой ленты пользователя/списка | https://publish.x.com/oembed | JSON с HTML для встраивания; показ 1-20 элементов ленты, а не структурированный экспорт истории |
| Точный алгоритмический порядок домашней ленты | Эквивалент этими источниками не установлен | Остановить или сузить требование; видимость в браузере не устанавливает стабильный контракт извлечения |
Эти числа обозначают документированные максимумы или интервалы, а не обещанное количество записей в каждом ответе. Доступность, фильтры, авторизация и текущий контракт endpoint по-прежнему важны. Обзор поиска называет недавний поиск доступным всем разработчикам, но одновременно требует аккаунт разработчика, приложение и токены. Это не означает публичный доступ без авторизации или готовность произвольного проекта выполнять запросы.
Документацию также нужно читать с учётом даты. Введение в API описывает оплату использования без подписок. Некоторые материалы о лентах и пагинации ещё упоминают «стандартный уровень». Эти названия не оправдывают старое сравнение фиксированных тарифов. Перед оценкой бюджета нужно проверить актуальный продукт и фактический доступ приложения: частотные ограничения и плата за использование отвечают на разные вопросы. Здесь не предполагается конкретная цена или подписка.
У HTML для отображения другой контракт результата
Каноническая справка oEmbed описывает JSON-оболочку, содержимое которой для отображения представляет собой HTML, распознаваемый JavaScript виджетов X. Параметры ленты позволяют показывать от 1 до 20 элементов. Это настройка встраиваемого представления, а не размер страницы для сбора истории аккаунта. Формат JSON сам по себе не превращает endpoint в API структурированных публикаций.
Та же справка предупреждает об изменении разметки и рекомендует кэширование согласно предложенному в ответе сроку. Значение cache_age относится к этому ответу для отображения; сохранённый фрагмент нельзя считать вечной записью текста или доступности публикации. Документированное отсутствие авторизации и частотного ограничения относится только к этому ресурсу встраивания, а не к поиску, лентам, неограниченному повторному использованию или всем будущим запросам. Реальный запрос oEmbed для сравнения не выполнялся.
У отображения содержимого X есть и условия вне схемы ответа. Текущая Политика разработчика охватывает публичный показ, конфиденциальность и распространение; правила отображения затрагивают актуальность и удаление недоступного содержимого. Встраивание не разрешает автоматически последующую аналитику или распространение наборов данных. Запись решения о разрешениях содержит общие вопросы авторизации, тогда как матрица endpoint решает более узкую техническую задачу.
Проверить три задачи на исторические ограничения
Следующие требования сконструированы: это не успешные вызовы API и не наблюдения из аккаунта X. Они показывают разные ошибки: неверный набор данных, запрос старой истории через недавний endpoint и смешение видимого ранжированного представления с доступным порядком API. Полезный результат здесь состоит в выборе маршрута и явном оставшемся условии, а не в вымышленном ответе с нужными данными.
Недавнему поиску нужен ограниченный интервал
Допустим, одобренной интеграции нужны подходящие публичные публикации за определённый интервал целиком внутри последних 7 дней, с текстом, идентификаторами и временем создания. Кандидатом является недавний поиск при поддержке операторов, доступе приложения и разрешённой цели. В требовании указаны начало и конец UTC, точный запрос и поля. Формулировка «вся недавняя социальная активность» не подходит: она смешивает поисковые совпадения с другими поверхностями.
Руководство по полям поясняет, что стандартный запрос публикации возвращает минимальные свойства, включая id, text и edit_history_tweet_ids. Для дополнительных свойств, например created_at, нужен соответствующий параметр полей. Запрос поля не отменяет требования авторизации; свойства связанного объекта могут требовать расширения и параметра полей самого объекта. Схему определяют по выбранному endpoint, а не по снимку карточки публикации.
При переходе по страницам поиска нужно сохранять запрос и интервал. Руководство по пагинации недавнего поиска описывает чтение next_token из ответа и передачу в следующем запросе. Если изменить запрос в середине последовательности, страницы перестанут описывать один поиск. Увеличение размера страницы не отменяет разрешений и не расширяет историческое окно.
Спецификацию приложения можно скопировать, не выдавая её за ответ API:
result_kind = recent_search_matches
interval = explicit UTC start and end within the last 7 days
query = fixed throughout this pagination sequence
requested_fields = id,text,created_at
continuation = response meta.next_token
completion = no next_token within this endpoint and query
excluded_claim = complete lifetime account history
Это обозначения для планирования, не исполняемый синтаксис запроса. Условие завершения намеренно ограничено endpoint и поиском. Страница без продолжения не доказывает доступность всех когда-либо опубликованных подходящих записей, соответствие запроса нужному понятию или возможность восстановить недоступное содержимое. Проверка схемы и выбор endpoint отличаются от доказательства полноты покрытия.
Исторические упоминания не являются лентой автора
Теперь клиент просит все упоминания своего аккаунта за последние 12 месяцев. Документированный максимум /2/users/:id/mentions составляет 800 последних упоминаний. Исчерпание страниц не позволяет назвать результат полным годовым архивом. Лента автора также будет неверной заменой: записи, написанные аккаунтом, и записи с его упоминанием имеют разные правила включения, даже если отдельные публикации совпадают.
Архивный поиск может подойти для корректно выраженного исторического запроса, но требует проверки операторов, доступа, интервала и возвращаемых полей. Глубина архива до марта 2006 описывает диапазон продукта, а не удостоверяет полноту годового набора клиента. Если поддерживаемый запрос и разрешённый доступ не установлены, годовая задача остаётся нерешённой либо сокращается до документированного недавнего периода.
Это относится и к публикациям автора, более старым, чем последние 3,200 записей. Добавление более ранних временных параметров само по себе не снимает установленную границу ленты. Лимит нужно записать рядом с endpoint, чтобы аналитик не спутал «все доступные страницы» со «всей историей аккаунта». Видимое ограничение в описании экспорта полезнее безусловной отметки о полноте.
Ранжированная лента не равна хронологической
Третье требование касается точного алгоритмического порядка, который конкретный аккаунт увидел на домашнем экране. Документированный обратный хронологический маршрут прямо исключает алгоритмическое ранжирование. Он требует пользовательской авторизации и описывает последние 3,200 публикаций или 7 дней от аккаунтов, на которые подписан пользователь. Это полезный официальный набор, но его выбор меняет исходную задачу, а не удовлетворяет её.
Если хронологической ленты достаточно, нужно получить надлежащую авторизацию и зафиксировать этот порядок в контракте потребителя. Если необходимо точное ранжированное представление, стабильный официальный эквивалент этими источниками не установлен. Отдельно разрешённое браузерное наблюдение может описать отображение в конкретный момент, но не воспроизводимую историю ранжирования, полный набор рекомендаций или право повторять внутренние запросы. Сравнение рендеринга и пагинации объясняет общее различие ответа и представления, не превращая DOM в право на API.
Связать авторизацию и срок действия с маршрутом
Обзор аутентификации разделяет доступ приложения к общедоступной информации и пользовательские потоки. Токен приложения не взаимозаменяем с пользовательской авторизацией. Справка домашней ленты прямо требует пользовательского контекста OAuth. Контроль аккаунта или согласие клиента также не означает владение X, возможность получить любое поле либо разрешение на любую последующую обработку.
| Контекст учётных данных | Документированный срок или назначение | Практическое следствие |
|---|---|---|
| OAuth 2.0 Authorization Code с PKCE | Токен доступа по умолчанию на 2 часа; offline.access выдаёт токен обновления | Использовать документированный поток обновления при разрешённом доступе; различать два токена |
| Пользовательский OAuth 1.0a | Руководство описывает получение постоянного токена доступа | Не переносить термин на OAuth 2.0, токены приложения и cookies; авторизация может измениться |
| Токен приложения | Общедоступная информация при поддержке endpoint | Проверить поддержку; обзор не устанавливает универсальный срок действия |
| Авторизованная браузерная сессия | Браузерная сессия, а не класс учётных данных API X | Универсальный срок cookies источниками не установлен; не подменять ею токен API |
Руководство PKCE указывает 2 часа по умолчанию и роль автономного доступа в выдаче токена обновления. Такой токен позволяет предусмотренное обновление, а не делает авторизацию безотзывной. Руководство OAuth 1.0a использует термин постоянного токена для собственного потока. Разделение этих утверждений не даёт длительному сборщику предположить одинаковое поведение токенов разных способов входа.
До оценки непрерывности нужно связать класс учётных данных и разрешения с endpoint. Одобрение пользователем одной операции не превращает запрос приложения в пользовательский. Истёкший токен сам по себе не означает исчерпанную частоту запросов. Поддерживаемое обновление решает вопрос действительности токена, а сброс лимита касается окна учёта. Это разные диагностические поля; секреты не должны попадать в журналы и материалы проверки.
Сохранение состояния браузера является другим уровнем. Работа с несколькими сессиями описывает разделение и хранение разрешённых браузерных сессий, а не права API X или срок cookies. Сохранённое состояние может перестать приниматься, хотя локальный файл существует. Его наличие не доказывает действительность токена API или неизменность разрешений аккаунта.
Разделить лимиты запросов и наблюдения браузера
Справка по лимитам определяет ограничения по endpoint и контексту авторизации. Пользовательские запросы могут учитываться в пользовательской квоте, запросы приложения в квоте приложения. Заголовки x-rate-limit-limit, x-rate-limit-remaining и x-rate-limit-reset показывают применимый предел, остаток и время сброса. Вместе с ними нужно хранить endpoint и контекст: заголовок поискового ответа не задаёт бюджет упоминаний.
Диагностика разделяет четыре факта: запрошенный маршрут, использованный контекст, реально полученные ответ и заголовки, текущие условия оплаты или доступа приложения. Опубликованная таблица частот не является выпиской баланса. Остаток запросов не подтверждает наличие оплаченного кредита, а доступ к одному продукту не устанавливает глубину другого. Проверяют фактический ответ и актуальный аккаунт разработчика, а не закрепляют большую таблицу квот в предположениях программы.
Соглашение разработчика запрещает превышать или обходить ограничения API. Смена аккаунтов, браузерных идентичностей или маршрутов не исправляет исчерпанное либо отсутствующее право доступа. Ожидание, ограниченные повторы и планирование параллелизма рассматриваются в ограничениях запросов и параллелизме; специфическая задача X состоит в предварительном определении применимого контекста учёта.
Здесь не использовались реальный аккаунт X, запрос API, платный баланс, браузерная лента или ответ oEmbed. Документированная матрица может отклонить несовместимый проект, но только минимальный надлежаще разрешённый запрос устанавливает текущий ответ конкретному приложению. Даже он подтверждает один ответ при записанных условиях, а не постоянную доступность, полноту архива или стабильность браузерной разметки. Разрешение, смысл ответа и полноту сбора нужно формулировать отдельно.
Вопросы и ответы
Означает ли «API для twitter scraping» один endpoint?
Нет. Публикации автора, упоминания, домашняя лента, поиск и встраиваемое отображение имеют разные правила включения и результаты. Одинаковая форма записи не делает маршруты взаимозаменяемыми.
Позволяет ли пагинация перейти от недавнего поиска к полному архиву?
Нет. Значение next_token продолжает выбранный запрос внутри продукта. Для старых периодов нужны поддерживаемый архивный маршрут и отдельное решение о доступе, а не дополнительные недавние страницы.
Доказывает ли пустой или короткий ответ отсутствие старых публикаций?
Нет. Запрос описывает маршрут, интервал, фильтр и авторизацию. Исчерпание этого объёма не доказывает глобальное отсутствие и не оправдывает игнорирование границы.
Нужен ли браузер всякий раз, когда API не решает задачу?
Нет. Неподдерживаемая история, поле или ранжирование могут потребовать сокращения задачи либо другого разрешённого источника. Сначала определяют роль браузера; сам он не создаёт разрешения платформы.
Источники
- Введение в X API
- Ленты и документированные пределы
- Недавний и архивный поиск
- Поля и пагинация поиска
- Обзор аутентификации
- OAuth 2.0 PKCE и токены OAuth 1.0a
- API oEmbed
- Лимиты запросов
- Политика и Соглашение разработчика
- Согласованность автоматизации BotBrowser
Практический вывод
До браузера выбирают результат X: публикации автора, упоминания, хронологическую ленту, ограниченный поиск или встраиваемое отображение. Нужные интервал, порядок, поля и контекст авторизации записывают рядом с документированной границей endpoint. Если сочетание не решает задачу, её сужают или останавливают; если решает, выполняют разрешённый минимальный запрос и описывают реальный охват до расширения сбора.
Эта статья входит в руководство: Начало работы с автоматизацией браузера: карта
Похожие статьи
Сбор данных с Playwright: браузер и профиль
Начало работыПравовые вопросы и условия при скрапинге: что решить заранее
Начало работыБраузер для веб-скрейпинга: какой вариант нужен?
Начало работыСбор данных Instagram: сначала условия API
Начало работыWeb scraping JavaScript: рендер, пагинация, скролл
Начало работыПрокси Puppeteer: авторизация, SOCKS5 и сигналы
Выполните ту же проверку в BotBrowser
Загрузите профиль, сохраните внутри браузера те сигналы, о которых только что прочитали, и подтвердите результат на своей машине до раскатки.