Liste des voix de synthèse vocale : guide de dépannage sûr
Gérez les listes de voix vides, les correspondances de langue, la file de synthèse et les erreurs sans traiter les voix comme un signal d'identité.
BotBrowser Team
Vous préférez la doc produit maintenue ?
Cet article a une page équivalente dans le centre de documentation. Utilisez les docs pour le flux canonique, les flags à jour et la référence durable.
Le mode profil de BotBrowser contrôle les métadonnées de voix exposées, mais ne garantit pas que l'hôte puisse produire un son audible.
Si le sélecteur de voix d'un navigateur est vide, ne concluez pas immédiatement que l'API n'est pas prise en charge et ne la sondez pas indéfiniment. Lisez getVoices(), abonnez-vous à voiceschanged pour une actualisation limitée dans le temps, puis conservez le texte lisible et proposez une nouvelle tentative ou une solution de repli selon la langue de l'application si aucune voix adaptée n'apparaît. Démarrez la lecture à la suite d'une action explicite de la personne, recherchez la voix choisie dans la liste actuelle et traitez la fin de la file, l'annulation et les erreurs comme des états ordinaires de l'application. Les métadonnées des voix peuvent varier : elles ne constituent ni une identité stable de l'appareil ni un catalogue commun à tous les systèmes d'exploitation.
TL;DR
getVoices()peut renvoyer un tableau vide à un instant donné. Traitez cela comme un état de chargement ou de disponibilité et actualisez la liste aprèsvoiceschanged; ne supposez ni un nombre fixe d'événements ni un délai constant.name,lang,localService,defaultetvoiceURIrépondent à des questions différentes. Choisissez une voix adaptée à la tâche et à la langue de la personne, pas à une séquence supposée propre au système d'exploitation.speak()ajoute une utterance à la file de synthèse. L'actualisation de la liste ne justifie pas de remettre la même utterance en file : actualisez le choix, puis laissez la personne décider de démarrer ou de relancer la lecture.- Déclenchez la lecture à partir d'une action visible de la personne, sans promettre que tous les navigateurs présentent la même demande d'autorisation ou appliquent la même politique d'activation. Conservez le texte d'origine et un état d'erreur permettant une nouvelle tentative.
- Une liste de voix peut révéler le contexte d'un environnement sans identifier une personne. Ne recueillez que les informations de diagnostic nécessaires et n'envoyez pas l'inventaire complet par défaut.
Sommaire
- Ce que l'API expose
- Règle de sélection, champ par champ
- Arbre de décision d'un sélecteur de voix
- Actualisation et états de la file
- Repli linguistique et action de la personne
- Annulation, erreurs et limites de confidentialité
- Apport au guide de configuration
- Conclusion pratique
Ce que l'API expose
La Web Speech API sépare la découverte des voix de la production vocale. window.speechSynthesis est le contrôleur : il expose la liste de voix actuelle, une file et des méthodes comme speak(), cancel(), pause() et resume(). Une SpeechSynthesisUtterance contient le texte et les réglages facultatifs d'une requête. L'application peut lire les métadonnées d'une voix avant de demander au contrôleur de parler ; énumérer les voix ne lance pas à lui seul la lecture audio. L'API ne prévoit pas de demande d'autorisation distincte de l'utilisateur pour lire la liste avec getVoices() ; les règles de démarrage de la lecture audio sont une question séparée.
La liste dépend du contexte et n'est pas universelle. Un navigateur peut s'intégrer aux services vocaux du système d'exploitation, à un service géré par le navigateur, ou aux deux. Les ressources linguistiques installées et les choix du navigateur peuvent influencer les éléments exposés. Même sur un même hôte, deux produits ou versions du navigateur ne sont pas tenus de renvoyer une collection identique. Une machine peut aussi changer après l'installation d'un pack linguistique ou d'un service. Ne publiez donc pas de tableau prétendant que chaque installation Windows, macOS, Linux ou mobile possède un nombre fixe de voix, une marque, un ordre ou un ensemble de noms déterminé.
Le premier appel n'est pas un indicateur fiable de disponibilité. MDN indique que getVoices() renvoie les voix actuellement disponibles auprès du service de synthèse et documente l'événement voiceschanged en cas de changement de la liste. Dans certains environnements d'application, la liste est initialement vide puis un événement de changement survient ; dans d'autres, des entrées sont déjà disponibles à la première lecture. L'API ne fournit aucun délai universel après lequel la liste serait nécessairement complète. Une page doit gérer à la fois la présence immédiate d'une liste et son actualisation ultérieure, sans transformer un timing particulier en garantie de compatibilité.
Cette surface intéresse la confidentialité, car les noms, les langues prises en charge, les indicateurs de traitement local et le comportement lors des changements peuvent apporter du contexte à d'autres signaux du navigateur. Pour découvrir le concept plus général de combinaison d'attributs du navigateur, consultez l'explication de l'empreinte du navigateur. L'existence d'un ensemble potentiellement distinctif ne prouve ni qu'un site l'utilise, ni qu'il identifie quelqu'un, ni qu'une propriété donnée correspond à un système d'exploitation précis. Un sélecteur de voix destiné aux utilisateurs n'a besoin que des informations utiles au choix ; les mesures analytiques courantes ont rarement besoin de la liste complète.
Règle de sélection, champ par champ
Les propriétés des objets voix ont chacune un rôle. Un sélecteur utile ne les traite pas comme des identifiants interchangeables.
| Champ | Question utile à l'application | Règle de sélection | Ce qu'il ne faut pas en déduire |
|---|---|---|---|
lang | Quelle langue ou locale est représentée ? | Comparez les balises de langue à la locale demandée par l'application ; privilégiez une correspondance exacte avant un repli délibéré au niveau de la langue. | Une balise correspondante ne garantit pas que le texte est traduit ou sera prononcé comme prévu. |
name | Quelle étiquette peut aider une personne à distinguer les choix ? | Affichez une étiquette concise et échappée lorsqu'un choix est nécessaire ; gardez-la localement sauf besoin du support. | Un nom évoquant une marque ne prouve rien sur le système, l'appareil ou la personne. |
localService | L'API décrit-elle le service comme local ? | Utilisez cette propriété uniquement si l'application doit expliquer à l'utilisateur la différence entre service local et distant. | true ne garantit ni la confidentialité réseau ni la réussite de la lecture. |
default | Quelle voix l'implémentation désigne-t-elle comme voix par défaut ? | Utilisez-la comme critère de départage entre voix adaptées si la personne n'a pas choisi. | La voix par défaut n'est pas nécessairement celle que préfère l'application ni la meilleure pour le texte courant. |
voiceURI | L'implémentation fournit-elle un URI pour cette voix ? | Traitez-le comme une valeur opaque ; évitez de le conserver ou de l'utiliser comme clé entre sessions. | Rien ne garantit qu'il soit universellement stable, portable ou significatif hors de cette implémentation. |
Ce tableau aide à prendre une décision ; ce n'est pas un répertoire de signatures de plateformes. Sur une installation, un name peut être lisible par un humain alors qu'un autre identifiant est opaque ; l'application ne doit pas analyser le nom pour en déduire un éditeur. La valeur de localService décrit l'objet voix selon l'implémentation, pas le chemin complet emprunté par chaque requête vocale. De même, default est une préférence fournie par l'implémentation, pas un algorithme de négociation linguistique pour la page.
Partez du besoin réel de l'application. Si elle doit lire du texte espagnol, choisissez parmi les voix dont lang correspond aussi précisément que possible à la locale espagnole demandée dans la liste actuelle. En présence de plusieurs correspondances, utilisez un choix explicite de la personne ou un critère prévisible tel que default. Si la page propose uniquement un bouton de lecture sans menu de voix, elle n'a peut-être pas besoin d'afficher ou de conserver les noms. Pour un exemple connexe qui remet les propriétés de plateforme déclarées dans leur contexte, consultez les propriétés navigator et le contexte de plateforme ; aucune de ces surfaces ne doit servir de clé d'identité personnelle.
Ne supposez pas un ordre stable, par exemple « la voix zéro est la voix système par défaut » ou « la première entrée anglaise est la même sur tous les ordinateurs ». L'ordre du tableau n'est pas un contrat de sélection portable. L'actualisation peut également produire un nouveau tableau : conservez une préférence compréhensible par l'utilisateur, comme la locale demandée ou une option sélectionnée localement, puis résolvez-la à partir des objets les plus récents. Si l'ancien choix a disparu, informez la personne et proposez les autres possibilités au lieu de sélectionner silencieusement une voix sans rapport.
Arbre de décision d'un sélecteur de voix
Le parcours suivant permet à l'application de rester utile sans transformer un état temporaire de l'API en affirmation sur le navigateur ou l'appareil :
speechSynthesisest-il présent ? Dans le cas contraire, laissez le contenu écrit disponible et indiquez que la lecture à voix haute n'est pas proposée dans ce contexte. Ne masquez pas le texte et ne le remplacez pas.getVoices()renvoie-t-il des entrées maintenant ? Si oui, affichez les choix de la liste actuelle. Sinon, inscrivez un seul écouteurvoiceschanged, relisez la liste à son déclenchement et cessez d'attendre après un délai défini par l'application. Ne créez pas un écouteur supplémentaire à chaque rendu.- L'actualisation a-t-elle fourni une valeur
langadaptée ? Si oui, gardez le choix de la personne s'il correspond toujours. S'il a disparu, effacez la sélection périmée et expliquez les possibilités restantes. Si aucune voix ne correspond, utilisez le repli linguistique explicite de l'application ou demandez un choix ; ne déduisez pas la langue du nom d'une voix. - La personne a-t-elle lancé la lecture ? Si oui, créez une nouvelle utterance avec le choix actuel et appelez
speak(). Sinon, attendez. La fonctionnalité reste ainsi sous le contrôle de la personne et ne dépend pas d'une hypothèse de lecture automatique. - Qu'est-il arrivé à l'utterance ? À
end, affichez l'état inactif ou terminé. Àerror, indiquez brièvement qu'une nouvelle tentative est possible et conservez le texte. Après un arrêt explicite, annulez la file et effacez l'état actif de l'interface. - La liste a-t-elle changé pendant la lecture ? Actualisez le sélecteur, mais ne dupliquez pas l'utterance active. Lors d'une lecture ultérieure, recherchez à nouveau le choix préféré dans la dernière liste.
Après une attente limitée, un tableau vide a plusieurs explications possibles : la synthèse vocale n'est peut-être pas utilisable dans ce contexte, le service n'a fourni aucune entrée, l'application recherche peut-être la mauvaise locale, ou son initialisation ne s'est pas déroulée comme prévu. Ces situations appellent des actions différentes. Un message générique tel que « incompatibilité d'empreinte » n'aide pas et n'est pas justifié. Un message précis, comme « Aucune voix française n'est disponible pour le moment », propose une action sans révéler l'inventaire complet.
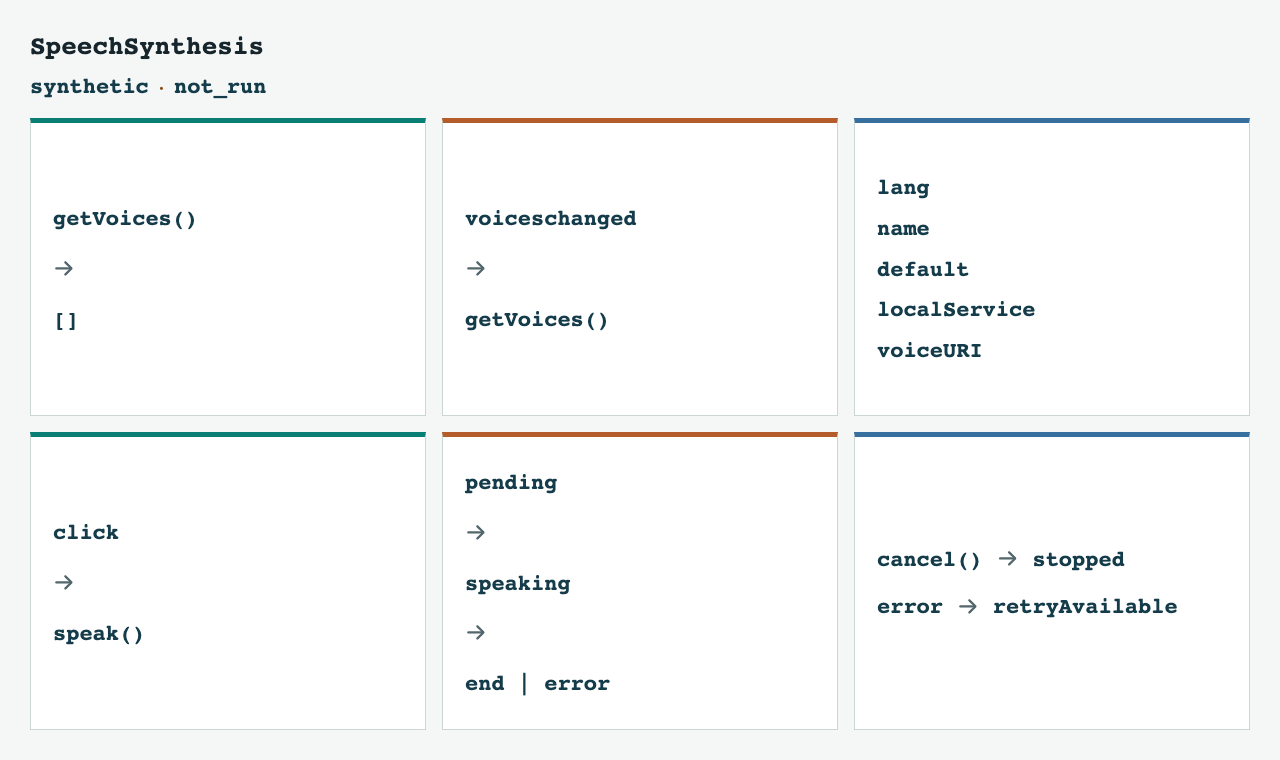
Le schéma des états d'un sélecteur de voix présenté ci-dessus condense ces branches en six états de l'application. Il s'agit d'une aide à la décision illustrative produite à partir d'une fixture HTML locale, pas d'une mesure effectuée dans un navigateur. L'interface garde toujours une voie textuelle, que la liste arrive immédiatement, soit actualisée plus tard ou reste vide.
Décider quand une attente est terminée
| Indice que la liste charge encore | Ce que cela prouve et ne prouve pas |
|---|---|
getVoices() a renvoyé un tableau vide au premier rendu | Pas définitif en soi ; la liste se remplit de façon asynchrone |
voiceschanged ne s'est pas encore déclenché | Pas définitif ; l'événement peut encore arriver |
Une lecture après voiceschanged n'est pas vide | La liste est prête à l'emploi |
| Le délai expire avec une liste vide | Aucune voix n'est apparue pendant votre attente ; ce n'est pas la preuve qu'il n'en existe aucune |
La différence entre « pas encore » et « aucune » décide si l'interface affiche un indicateur de chargement, un nouvel essai ou un message de locale, et les deux se ressemblent à l'identique dans un seul appel à getVoices(). Trois questions les séparent sans deviner.
Lisez une fois au chargement et conservez ce résultat. Un tableau vide au premier rendu est normal sur certaines plateformes, car la liste se remplit de façon asynchrone. Notez-le comme premier échantillon et non comme verdict, puis affichez le sélecteur en état de chargement.
Liez exactement un écouteur voiceschanged pendant la vie du composant et relisez à l'intérieur. Une lecture non vide signifie que la liste est prête. Une lecture identique à la première indique seulement que l'événement s'est déclenché avec une liste encore vide ; la plateforme ne le garantit pas, alors notez « toujours vide » et non « aucune voix disponible ».
Bornez l'attente par un délai applicatif et traitez-le comme un état, pas comme une panne. Quand il expire avec une liste vide, retirez l'écouteur, effacez le minuteur, arrêtez l'indicateur et affichez le message de locale avec le texte encore lisible et un bouton de nouvel essai. Une page qui attend indéfiniment, ou qui garde un écouteur obsolète, a fait d'un détail de plateforme un contrôle inutilisable.
const readOnce = () => speechSynthesis.getVoices();
const key = list => list.map(v => `${v.voiceURI}|${v.lang}|${v.name}`).join('\n');
let first = readOnce();
let settled = false;

const settle = new Promise(resolve => {
  const finish = outcome => {
    if (settled) return;
    settled = true;
    clearTimeout(timer);
    speechSynthesis.removeEventListener('voiceschanged', onChange);
    resolve(outcome);
  };
  const timer = setTimeout(() => finish('still-empty'), 2000);
  const onChange = () => {
    const next = readOnce();
    // A change event with the same list proves the event fired, not that the list is final.
    if (next.length) finish('ready');
    else if (key(next) !== key(first)) finish('still-empty');
  };
  speechSynthesis.addEventListener('voiceschanged', onChange);
  if (first.length) finish('ready');
  // If no event arrives, the 2 s timer reports 'still-empty': neither ready nor proven absent.
});
Les trois issues correspondent à trois écrans différents, et aucune n'est « la synthèse vocale n'est pas prise en charge ». Une première lecture non vide mène directement au sélecteur. Une lecture tardive non vide atteint le sélecteur après l'état de chargement. Un délai expiré avec une lecture vide affiche le message de locale et conserve le texte. Le même code produit les trois, donc la différence tient à ce que la plateforme a rapporté, pas à ce qu'est l'appareil.
Actualisation et états de la file
L'événement voiceschanged signale que la liste renvoyée par getVoices() a changé. Il ne demande pas de parler à nouveau et l'application ne doit pas supposer qu'il ne se produit qu'une fois. Une routine d'actualisation propre remplace la liste affichée à partir du dernier appel, retire l'écouteur ponctuel après utilisation et conserve séparément la préférence de locale de la personne et un objet SpeechSynthesisVoice particulier. Si l'application propose une nouvelle tentative manuelle, elle peut réutiliser cette routine au lieu d'ajouter un autre gestionnaire d'événement.
SpeechSynthesis.speak(utterance) ajoute l'utterance à la file du contrôleur. Des clics répétés ou des rappels d'actualisation peuvent donc entraîner des lectures en double si l'interface ne définit pas de règle. Un produit peut désactiver le bouton de lecture tant qu'une utterance est en file ou en cours, proposer une action « arrêter » distincte ou remplacer volontairement la requête actuelle. L'essentiel est de rendre cette transition explicite. Le seul changement des choix disponibles ne doit pas créer une nouvelle entrée dans la file.
Le code suivant est illustratif et n'a pas été exécuté. Il montre une actualisation limitée dans le temps, la correspondance de locale et un parcours de lecture déclenché explicitement par la personne. Il ne garantit pas que tous les navigateurs exposent les mêmes voix ou acceptent la lecture dans les mêmes circonstances.
Cet exemple montre uniquement la correspondance automatique de locale ; il n'enregistre ni ne restaure un choix explicite de voix.
const synth = window.speechSynthesis;
const requestedLocale = 'en-GB'; // Set from the application's own locale.
let currentVoices = [];
let activeUtterance = null;
let refreshTimer = null;

function refreshVoices() {
  currentVoices = synth.getVoices();
  const exact = currentVoices.filter(voice => voice.lang.toLowerCase() === requestedLocale.toLowerCase());
  const language = requestedLocale.split('-')[0];
  const broader = currentVoices.filter(voice => voice.lang.toLowerCase().split('-')[0] === language.toLowerCase());
  return exact.length ? exact : broader;
}

function waitForVoices(onReady, timeoutMs = 1500) {
  const immediate = refreshVoices();
  if (immediate.length) {
    onReady(immediate);
    return;
  }

  const onChange = () => {
    const matches = refreshVoices();
    if (matches.length) {
      clearTimeout(refreshTimer);
      synth.removeEventListener('voiceschanged', onChange);
      onReady(matches);
    }
  };

  synth.addEventListener('voiceschanged', onChange);
  refreshTimer = setTimeout(() => {
    synth.removeEventListener('voiceschanged', onChange);
    refreshTimer = null;
    onReady(refreshVoices());
  }, timeoutMs);
}

function playFromUserAction(text) {
  const available = refreshVoices();
  const voice = available.find(item => item.default) ?? available[0];
  if (!voice) {
    showReadableRetryState();
    return;
  }

  const utterance = new SpeechSynthesisUtterance(text);
  utterance.lang = voice.lang;
  utterance.voice = voice;

  activeUtterance = utterance;
  utterance.onend = () => {
    activeUtterance = null;
  };
  utterance.onerror = () => {
    activeUtterance = null;
    showReadableRetryState();
  };
  synth.speak(utterance);
}

function stopSpeech() {
  synth.cancel();
  activeUtterance = null;
}
Dans un composant de production, onReady devrait actualiser un sélecteur ou un état de disponibilité visible, et non sérialiser toutes les voix dans les outils d'analyse. L'exemple suppose également que l'application fournit showReadableRetryState(). Une interface réelle doit éviter que des gestionnaires d'événement actualisent un composant qui a été démonté, annuler tout délai encore actif pendant le nettoyage et définir ce qui se passe lors d'une seconde action de lecture pendant qu'une utterance est active. Ce sont des décisions ordinaires de cycle de vie ; elles ne se déduisent pas des métadonnées de voix.
Repli linguistique et action de la personne
La sélection d'une voix doit suivre la politique linguistique de l'application et non une supposition sur le système d'exploitation. Déterminez la locale demandée à partir du contenu ou d'un réglage explicite de l'application. Essayez d'abord une correspondance exacte, comme en-GB. Si les exigences du produit le permettent, utilisez une correspondance documentée au niveau de la langue, par exemple en-US. Si seule une langue sans rapport est disponible, ne la faites pas passer silencieusement pour un équivalent. Laissez le texte visible et permettez à la personne de choisir une autre option ou de poursuivre sans audio.
Une valeur lang décrit la voix et une utterance peut également porter une balise de langue. Aucune des deux ne traduit le texte. Une voix répertoriée pour une locale peut malgré tout mal prononcer un nom, une abréviation ou une phrase mêlant plusieurs langues. Le produit doit fournir un texte traduit lorsque c'est nécessaire et rendre les commandes de langue compréhensibles. L'article sur les codecs WebRTC montre lui aussi pourquoi la disponibilité annoncée d'une capacité ne doit pas être confondue avec un résultat complet pour l'utilisateur.
La lecture doit commencer après une action délibérée, par exemple un clic sur « Lire à voix haute ». C'est un choix de contrôle utilisateur et de compatibilité, pas l'affirmation que la spécification Web Speech définit une boîte de dialogue d'autorisation universelle. Les politiques du navigateur et le contexte d'intégration peuvent influer sur le démarrage du son. Expliquez comment réessayer si la requête ne démarre pas ; ne demandez pas à la personne d'accorder une permission inexistante pour cette API et ne prétendez pas qu'un clic garantit la lecture audible.
Lorsque la personne modifie la langue de l'application, mettez à jour la locale demandée et réévaluez les voix à partir de la liste actuelle. Si la liste est actualisée alors qu'un menu est ouvert, ne conservez la préférence que si elle correspond encore à une option disponible. L'application peut nommer clairement la solution de repli, par exemple « Anglais (États-Unis), utilisé car l'anglais (Royaume-Uni) est indisponible ». Une solution visible est plus facile à corriger qu'un changement automatique caché derrière un bouton générique.
Le choix de la personne et les réglages d'accessibilité doivent rester indépendants de l'analytique. Il peut être utile d'enregistrer localement une option sélectionnée pour la prochaine visite, mais cela ne justifie pas l'envoi de tout le tableau de voix à un serveur. Si un service transmet le texte à un fournisseur vocal distant, expliquez séparément ce flux de données et les commandes correspondantes ; localService ne suffit pas à auditer le routage réseau.
Annulation, erreurs et limites de confidentialité
La file du contrôleur a besoin d'un modèle d'état visible. Distinguez au minimum les états indisponible, chargement, prêt, en file ou en cours de lecture, terminé, arrêté et en échec. Un bouton d'arrêt doit appeler cancel() et ramener l'interface à un état inactif prévisible ; une annulation est un arrêt explicite, pas une nouvelle tentative. Dans le schéma, l'étiquette retryAvailable signifie que l'application peut proposer un autre essai après avoir expliqué l'erreur, mais la lecture doit attendre une nouvelle action de la personne. Comme l'annulation supprime aussi les utterances en attente et interrompt celle en cours, une page partagée doit considérer qu'un composant pourrait annuler la lecture lancée par un autre. Coordonnez la responsabilité au lieu de laisser chaque widget manipuler seul une file globale.
Associez des gestionnaires de fin et d'erreur à chaque utterance. La fin peut ramener la commande de lecture à l'état prêt. Une erreur doit produire un message compréhensible, conserver le texte source et proposer une nouvelle tentative ou une solution pertinente. Ne relancez pas automatiquement speak() après une erreur : des requêtes répétées risquent de remplir la file ou de laisser la personne dans l'incertitude quant à l'arrêt demandé. Lorsqu'une utterance est remplacée, ignorez les rappels tardifs de l'ancienne requête en la comparant à la requête actuellement active.
La Web Speech API expose des événements, mais l'application ne doit pas promettre une cause unique à chaque échec. Celui-ci peut être lié à une voix manquante, à la disponibilité du service, au texte, au contexte du navigateur ou à une autre particularité de la plateforme. Signalez ce que l'application sait, par exemple « La lecture n'a pas démarré » ou « Aucune voix correspondante n'est disponible », et réservez les détails techniques à un diagnostic de support facultatif. Ne déduisez ni l'identité de la personne, ni les logiciels installés, ni sa localisation d'une erreur ou du nom d'une voix.
Pour le support courant, un relevé compact peut inclure le produit et la version du navigateur, la locale de l'application, la présence ou l'absence d'une voix correspondante et la catégorie d'erreur visible. Évitez d'enregistrer la liste complète dans son ordre, chaque voiceURI, l'heure exacte de chaque actualisation ou le contenu prononcé, sauf besoin de support défini et accord de la personne. Ne conservez ces données que le temps nécessaire au cas déclaré. La limite de confidentialité consiste à minimiser les données, non à dissimuler un état normal de l'application.
Cet article ne décrit pas une méthode d'identification des personnes. Il présente ces métadonnées comme une surface potentiellement liée au contexte du navigateur et se concentre sur le comportement fiable de l'application. La liste d'un navigateur ne prouve pas à elle seule une identité unique, et une fixture illustrative locale ne permet pas d'établir le comportement de tous les systèmes d'exploitation, versions de navigateur, services linguistiques ou outils d'assistance.
Apport au guide de configuration
Le guide de protection de la synthèse vocale décrit les modes de voix de profil et de système réel de BotBrowser, leurs paramètres de configuration et les principes généraux de dépannage de l'alignement du profil. Par défaut, --bot-speech-voices=profile utilise les métadonnées de voix du profil ; --bot-speech-voices=real utilise les voix du système sans cette protection des métadonnées. Aucun des deux modes ne garantit une lecture audible. Il ne fournit pas d'arbre de décision destiné à l'application pour gérer une liste initialement vide, une actualisation voiceschanged, une sélection périmée ou une file d'utterances. Cet article apporte une règle de sélection champ par champ, un exemple applicatif non exécuté et des états d'interface explicites pour le repli de langue, la lecture initiée par la personne, l'annulation et les erreurs. Ces étapes complètent le guide de configuration ; elles ne prétendent ni reproduire le comportement du profil ni ajouter une garantie produit.
Pour diagnostiquer un problème de configuration, séparez deux questions : quelles métadonnées de voix l'API du navigateur renvoie-t-elle, et l'hôte peut-il produire un son audible pour la personne concernée ? Un profil ou son guide de configuration peut traiter la surface déclarée par le navigateur, tandis que la lecture dépend de l'application réelle et du contexte de l'hôte. La réussite de l'énumération ne constitue pas un test audio. Inversement, l'échec d'une lecture ne prouve pas que la liste de voix est incorrecte.
FAQ
Un premier appel vide signifie-t-il que la synthèse vocale n'est pas prise en charge ?
Non. Cela signifie que l'appel actuel n'a renvoyé aucune voix. La liste peut être complétée plus tard, l'environnement peut ne fournir aucune voix ou l'API peut être inutilisable dans ce contexte. Écoutez voiceschanged pendant un délai limité, proposez une nouvelle tentative et gardez le texte disponible. N'attendez pas indéfiniment et ne déduisez pas le type d'appareil d'un résultat vide.
voiceURI est-il un identifiant stable pour enregistrer une préférence ?
Traitez-le comme une métadonnée opaque de l'implémentation, pas comme une clé de compte portable. Privilégiez l'enregistrement de la préférence linguistique de la personne et, si nécessaire, d'un choix d'affichage local qui pourra être rapproché de la liste actuelle. Si la voix enregistrée n'est plus disponible, demandez un nouveau choix au lieu de sélectionner silencieusement une autre langue.
localService: true prouve-t-il qu'aucun service réseau n'intervient ?
Cette valeur décrit la voix comme locale selon l'implémentation. Elle n'audite pas tous les chemins de service et ne prouve pas que l'application entière conserve le texte sur l'appareil. Expliquez séparément le flux de données réel de l'application et ne transformez pas ce booléen en garantie générale de confidentialité.
Chaque événement voiceschanged doit-il relancer la lecture ?
Non. Cet événement invite à actualiser les choix disponibles ; il n'exprime pas l'intention de la personne de démarrer la lecture. Mettez le sélecteur à jour, conservez ou effacez la préférence selon la liste actuelle et exigez une action de lecture distincte.
Sources
- W3C Web Speech API : spécification de la synthèse, des objets voix, des utterances, des méthodes de file et des événements.
- MDN : SpeechSynthesis : référence du contrôleur et de ses méthodes dans les navigateurs.
- MDN : SpeechSynthesis.getVoices() : méthode de lecture de la liste de voix actuelle.
- MDN : SpeechSynthesisVoice : propriétés des objets voix.
- MDN : événement voiceschanged : événement signalant un changement de liste.
- MDN : SpeechSynthesis.speak() et cancel() : comportement de la file et annulation.
- MDN : événement error de SpeechSynthesisUtterance : événement d'erreur d'une utterance.
- Protection de la synthèse vocale BotBrowser : configuration produit et limites des modes de profil.
Conclusion pratique
Une liste de voix vide ou changeante est un état de l'application à gérer, pas une base pour identifier une personne ou supposer un ordre de plateforme fixe. Actualisez la liste avec voiceschanged, choisissez dans les métadonnées actuelles selon la politique linguistique de l'application, démarrez la lecture à la suite d'une action explicite de la personne et rendez visibles la fin, l'annulation et les erreurs. Conservez le texte lisible et ne recueillez que les champs de diagnostic nécessaires à un besoin déclaré. La prochaine étape raisonnable pour une équipe produit consiste à tester, dans ses propres contextes de navigateur pris en charge, les listes immédiates et différées ainsi qu'une utterance en échec, sans prétendre que ce code ou ce schéma illustratif a déjà été exécuté.
Cet article fait partie du guide : Qu'est-ce qu'une empreinte de navigateur ?
Articles Connexes
Voix de synthèse vocale et lecture accessible dans le navigateur
EmpreinteFingerprinting codecs WebRTC : fuite de capacites
EmpreinteInformations de l’adaptateur WebGPU et vie privée
EmpreinteFingerprinting par mesure de texte : suivi sous-pixel
EmpreinteEmpreinte de fréquence d'images : affichage et vidéo
EmpreinteQu'est-ce que l'empreinte des polices ? Cohérence du texte
Faites passer BotBrowser de la recherche à la production
Utilisez ces guides pour comprendre le modèle, puis passez à la validation multi-plateforme, aux contextes isolés et au déploiement navigateur prêt pour l'échelle.