Protection contre le sondage des ports locaux par le navigateur
Comment une page peut sonder les ports de localhost pour déduire vos services locaux, pourquoi les solutions courantes échouent et comment vérifier un comportement uniforme.
BotBrowser Team
Vous préférez la doc produit maintenue ?
Cet article a une page équivalente dans le centre de documentation. Utilisez les docs pour le flux canonique, les flags à jour et la référence durable.
Une page web peut demander à votre navigateur d'ouvrir une connexion vers une adresse de votre propre machine, et le navigateur essaiera généralement de le faire. Si un service écoute sur ce port, la tentative aboutit ou reçoit une réponse au niveau du protocole. Si rien n'écoute, la tentative est refusée. Une page qui répète la tentative sur un ensemble de ports bien connus obtient un schéma de ports ouverts et fermés, et ce schéma en dit long sur les logiciels que vous utilisez.
Les sections suivantes suivent cette déduction depuis une simple tentative de connexion jusqu'à un signal stable de l'environnement local, comparent les solutions courantes et la lacune que laisse chacune, puis passent à la protection des ports de BotBrowser, qui rend les réponses uniformes. Elles se terminent par une vérification que vous pouvez exécuter sur votre propre machine et par un exposé net de ce que la fonction ne couvre pas.
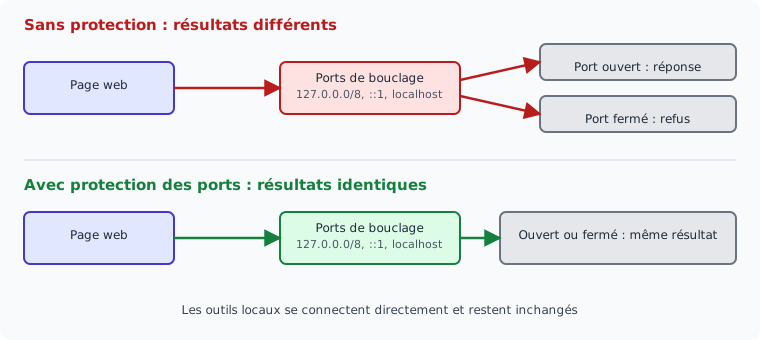
Résumé
La protection des ports de BotBrowser uniformise les sondes lancées par les pages vers les ports de bouclage documentés, tandis que les outils locaux continuent leurs connexions directes. Elle ne couvre ni tous les ports ni les adresses de réseau privé : vérifiez donc la forme d'adresse et l'ensemble exact avant de l'activer.
Sommaire
- Comment une page cartographie vos services locaux
- Pourquoi le schéma vous suit d'une session à l'autre
- Pourquoi les solutions habituelles sont insuffisantes
- Activer la protection des ports
- Vérifier des résultats uniformes avec un service de test local
- Ce que BotBrowser prend en charge et ce qui reste hors de sa portée
- Conclusion pratique
Comment une page cartographie vos services locaux
Chaque machine possède une interface de bouclage (loopback), qui existe pour que les programmes d'un même hôte puissent communiquer sans en sortir. La RFC 1122 réserve à cet usage tout le bloc 127.0.0.0/8, et la RFC 4291 définit ::1 comme l'adresse de bouclage IPv6. Le nom d'hôte localhost se résout normalement vers l'une d'elles ou vers les deux. Les services destinés uniquement à l'utilisateur local, comme les serveurs de développement, les moteurs de bases de données, les assistants de bureau à distance et les outils de conteneurs, y écoutent souvent, car l'interface de bouclage n'est pas joignable depuis d'autres machines.
Le navigateur, lui, s'exécute sur la même machine, et le code d'une page peut donc viser ces mêmes points de connexion. Rien n'a besoin d'être installé ni approuvé dans la page pour cela. La page émet une tentative de connexion ordinaire, par exemple via un WebSocket, le chargement d'une image ou un appel fetch, puis observe comment cette tentative se termine. Les différents résultats lui apprennent des choses différentes :
- Un service qui accepte la connexion et répond de façon reconnaissable laisse penser qu'un type précis de logiciel tourne sur ce port.
- Un service qui accepte la connexion mais répond par quelque chose que la page ne comprend pas montre tout de même que le port est ouvert.
- Une connexion refusée montre que rien n'écoute, et la manière dont le refus arrive peut différer de la manière dont se termine une connexion acceptée.
Rien de tout cela ne lit de données du service local. La page apprend seulement qu'un port se comporte d'une façon ou d'une autre, et avec assez de ports cela donne une description étonnamment détaillée d'une machine. Une page qui vérifie quelques dizaines de ports bien connus peut souvent dire si le visiteur utilise un environnement de développement web, une base de données, un outil d'accès à distance ou une plateforme de conteneurs.
Cela compte au-delà du suivi, car de nombreux services locaux sont écrits en supposant que seuls les programmes de la même machine peuvent les joindre. Ils omettent souvent l'authentification, écoutent sur un port bien connu et exposent une interface HTTP simple. Une page qui apprend l'existence d'un tel service a déjà gagné une information, et une page qui peut aussi lui envoyer des requêtes peut en gagner davantage. Les navigateurs ont durci au fil des ans les règles entre origines, mais savoir qu'un port est ouvert demande bien moins que lire une réponse. C'est pourquoi le schéma ouvert contre fermé lui-même mérite d'être protégé.
La proposition Local Network Access du WICG décrit ce type de requêtes, où une page servie depuis un site public s'adresse à des adresses locales et de bouclage, et propose que les navigateurs les soumettent à une autorisation. Il s'agit d'une spécification communautaire, dont la prise en charge varie selon les navigateurs et les versions ; ne supposez donc pas que votre navigateur actuel demande une autorisation ou bloque. Vérifiez ce que fait votre propre version avant de vous y fier.
Pourquoi le schéma vous suit d'une session à l'autre
Comparez 127.0.0.1:3000 et 127.0.0.1:5432 dans le même profil ; le résultat dépend des processus de la machine, pas des cookies.
Les cookies, le stockage local et l'adresse IP sont autant d'éléments que vous pouvez effacer ou changer. L'ensemble des services qui tournent sur votre ordinateur est différent, car il décrit votre façon de travailler et non l'endroit d'où vous vous connectez. Un développeur qui utilise chaque jour la même intégration d'éditeur, la même base de données et le même environnement de conteneurs présentera le même schéma le lundi et le vendredi.
Cette stabilité rend le signal utile pour le suivi. Considérez les façons habituelles de repartir de zéro :
- Effacer les cookies et les données de site supprime l'état qu'un site a stocké dans votre navigateur, mais ne change pas les ports ouverts.
- Changer d'adresse IP, par exemple via un proxy, modifie l'emplacement réseau que voit le site, mais le schéma de bouclage appartient à la machine et la suit.
- Ouvrir une fenêtre privée ou un second profil de navigateur réinitialise l'état du navigateur, mais la même machine répond de la même manière.
Le signal se combine aussi bien avec d'autres. Un schéma de ports ouverts et fermés est un attribut de plus qui peut être joint à la sortie du canvas, aux polices disponibles et au reste de la surface que collecte un script d'empreinte. Chaque attribut est partiel à lui seul, et ensemble ils peuvent isoler une machine ; c'est pourquoi même un signal faible vaut la peine d'être refermé. Pour comprendre pourquoi une fenêtre privée laisse ces signaux inchangés, consultez Navigation privée et fingerprinting : pourquoi elle ne suffit pas, qui compare pas à pas une session normale et une session privée.
Toutes les machines ne sont pas exposées de la même façon. Un portable utilisé seulement pour le courrier et les documents peut montrer presque aucun port ouvert, et son schéma ressemble alors à celui de nombreuses autres machines. Un poste de travail ou un serveur avec une douzaine de services est beaucoup plus distinctif. Ceux qui tirent le plus de bénéfice du traitement de ce signal sont les développeurs, les exploitants de serveurs sans interface graphique et toute personne qui utilise des outils d'accès à distance, car ces configurations écoutent sur plus de ports qu'une machine grand public typique.
Pourquoi les solutions habituelles sont insuffisantes
Même touch-action: none ne change pas le résultat d'une connexion vers 127.0.0.1:3000 ; cette propriété concerne les gestes tactiles.
Un retour immédiat ERR_BLOCKED_BY_CLIENT est également mesurable ; comparez-le au délai normal avant de choisir une règle.
Une page de test peut appeler fetch() avec AbortSignal.timeout(1000) vers http://127.0.0.1:3000/ ; le délai et la classe d'erreur sont la surface observable.
Plusieurs approches semblent raisonnables, et chacune laisse une lacune.
Bloquer purement et simplement les connexions de bouclage. Si le navigateur refuse toute tentative d'atteindre localhost, la page n'apprend plus quel service tourne. Mais le refus lui-même devient un comportement observable. Une tentative bloquée peut se distinguer d'un refus normal, et un échec instantané identique sur tous les ports est inhabituel par rapport à la variation d'un navigateur ordinaire. Le blocage casse aussi des choses sur lesquelles vous pouvez compter : les applications de bureau qui dialoguent avec une page web, les serveurs de développement avec rechargement à chaud et les parcours de connexion qui redirigent vers un écouteur local.
Extensions de navigateur. Les filtres de requêtes peuvent bloquer les connexions vers les adresses locales, mais ils agissent dans la couche des extensions du navigateur, et la couverture dépend du type de requête. Une règle qui gère les appels fetch peut ne pas couvrir toutes les autres façons dont une page peut ouvrir une connexion. L'extension elle-même peut aussi laisser des traces observables par la page, de sorte que la protection devient un attribut distinctif de plus.
Règles de pare-feu. Les pare-feu du système d'exploitation décident quels programmes peuvent accepter des connexions entrantes ou atteindre le réseau. Une connexion vers localhost initiée par une page est une connexion locale depuis le navigateur ; une règle conçue pour le trafic venant d'internet ne la traite donc pas. Une règle qui empêcherait le navigateur d'atteindre le bouclage casserait de nouveau les outils locaux que vous voulez garder et ramènerait le problème d'un refus distinctif.
Espaces de noms réseau et conteneurs. Exécuter le navigateur dans un conteneur doté de son propre espace de noms réseau l'empêche de voir les services de l'hôte, ce qui sépare bien les deux. Le coût est opérationnel : vous maintenez une couche de plus, vous atteignez difficilement les services de l'hôte que vous souhaitez utiliser, et le conteneur expose son propre ensemble de services en écoute qu'une page peut sonder. C'est un outil d'isolation raisonnable pour certains déploiements et une réponse lourde à ce problème précis.
Routage par VPN. Un VPN change la destination du trafic internet sortant. Le trafic de bouclage ne quitte jamais la machine ; les changements de routage ne modifient donc pas la manière dont le navigateur répond à une tentative de connexion vers 127.0.0.1. Vous ajoutez un saut réseau et un peu de surcharge, et vous laissez le comportement réel intact. Pour savoir comment l’itinéraire réseau et l’environnement d’exécution de la page doivent décrire une même configuration, consultez Cohérence réseau du navigateur pour protéger la vie privée, qui présente une méthode reproductible pour valider cette cohérence.
Ces options ont en commun qu'aucune ne rend les réponses uniformes. Soit elles suppriment la réponse, ce qui se remarque et perturbe, soit elles agissent à une couche qui ne voit pas la connexion. L'objectif qui correspond vraiment au problème est plus étroit : lorsqu'une page tente une connexion vers un port de bouclage couramment sondé, le résultat ne devrait pas dépendre de la présence d'un service à l'écoute. La résolution de noms est une surface distincte qu’aucune de ces options ne traite ; consultez Prévention des fuites DNS : chemins de résolution, proxys et tests, qui couvre les chemins de résolution et la manière de réaliser un test de fuite.
Activer la protection des ports
BotBrowser documente la protection des ports comme une fonction PRO. Elle est désactivée par défaut, et vous l'activez avec un indicateur de lancement ou un réglage du profil. La forme en ligne de commande est un indicateur unique ajouté à la commande de lancement habituelle :
chrome --bot-profile="path/to/profile.enc" --bot-port-protection
Le même interrupteur peut figurer dans le JSON du profil, ce qui convient aux profils où la protection doit toujours être active et où l'indicateur ne doit jamais être oublié :
{
  "configs": {
    "portProtection": true
  }
}
Lorsque le réglage se trouve dans le profil, il s'applique dès le chargement du profil et aucun indicateur supplémentaire n'est nécessaire. Si vous lancez le navigateur via un framework d'automatisation, ajoutez le même indicateur aux arguments de lancement, comme pour n'importe quel autre indicateur de BotBrowser. La documentation de la protection des ports montre le même indicateur dans un lancement Playwright et dans une configuration combinée avec un proxy.
Le comportement documenté est que les tentatives de connexion des pages web vers des ports couramment sondés se comportent de façon cohérente sur les adresses de bouclage. La référence des indicateurs de la CLI indique que l'ensemble couvert est de 30 ports couramment sondés répartis sur trois formes d'adresse : le bloc de bouclage IPv4 127.0.0.0/8, l'adresse de bouclage IPv6 ::1 et le nom d'hôte localhost. Le guide de la protection des ports décrit le même comportement sans donner de nombre.
Choisissez l'indicateur lorsque vous voulez la protection pour un seul lancement, par exemple pendant vos tests. Choisissez le réglage du profil lorsqu'un profil donné doit toujours la porter. Les équipes qui conservent leurs scripts de lancement sous gestion de versions préfèrent souvent le réglage du profil, car un profil protégé le reste quel que soit le script qui le démarre, et une relecture du fichier du profil montre l'intention. Gardez à l'esprit que la fonction est désactivée par défaut : un profil sans ce réglage et un lancement sans l'indicateur fonctionnent donc tous deux sans protection.
Les serveurs sans interface graphique et les machines de compilation partagées méritent une remarque à part. Un navigateur sur un serveur qui héberge des bases de données, des agents de supervision et des outils de conteneurs côtoie de nombreux écouteurs locaux, et une page qu'il visite peut y voir le même type de schéma qu'un poste de travail. Si ce navigateur appartient à une flotte censée se comporter de façon cohérente, l'ensemble distinctif d'écouteurs d'un serveur est une différence indésirable. Définir l'option dans le profil utilisé par ces tâches maintient le comportement sans dépendre de chaque script de lancement.
Deux détails comptent pour la planification. Premièrement, la protection concerne les tentatives faites par des pages web. La documentation indique que les outils locaux qui se connectent directement ne sont pas affectés ; votre terminal, votre client de base de données et votre éditeur continuent donc de fonctionner comme avant. Deuxièmement, l'ensemble couvert est une liste fixe de ports couramment sondés, et non tous les ports de la machine. Si vous avez besoin d'une couverture pour un port hors de cette liste, la documentation vous renvoie vers le support, et vous ne devez pas supposer qu'il est inclus.
Vérifier des résultats uniformes avec un service de test local
La vérification doit montrer deux choses : les résultats des tentatives initiées par des pages sont uniformes lorsque la protection est active, et vos propres outils fonctionnent toujours. Vous pouvez contrôler les deux sur une machine qui vous appartient avec un service jetable. Faites-le uniquement sur votre propre machine. Tester des hôtes que vous ne contrôlez pas n'est pas une étape de vérification et n'est pas traité ici.
Démarrez un service inoffensif lié à l'adresse de bouclage, sur un port dont vous pouvez disposer :
python3 -m http.server 8080 --bind 127.0.0.1
Passez ensuite les contrôles dans l'ordre :
- Faites une mesure de référence sans protection des ports. Utilisez une petite page de test que vous maîtrisez, chargée dans le navigateur, qui tente une connexion depuis le code de la page vers votre service jetable et vers un port inutilisé de la même adresse, et qui note comment chaque tentative se termine.
- Relancez avec
--bot-port-protectionouconfigs.portProtectionet répétez la même page. Avec la protection active, le résultat pour le port ouvert et pour le port inutilisé doit être indiscernable pour la page. - Répétez la tentative avec les formes que nomme la documentation : l'adresse de bouclage IPv4, l'adresse IPv6 ::1 et le nom d'hôte localhost. Le résultat doit être uniforme pour chaque forme, et pas seulement pour l'une d'elles.
- Depuis un terminal, connectez-vous directement au service jetable, par exemple avec
curl http://127.0.0.1:8080/. Il doit répondre normalement, car les connexions directes des outils ne sont pas affectées. - Si vous dépendez d'une page web qui dialogue avec une application locale compagnon, testez cette intégration avec la protection active. La documentation décrit un comportement cohérent pour les tentatives initiées par des pages vers des ports couramment sondés ; tout parcours de page vers application locale sur l'un de ces ports mérite donc son propre contrôle avant de généraliser le réglage.
- Notez les arguments de lancement, le profil utilisé et les résultats, et répétez le test après tout changement du profil, de la version du navigateur ou des scripts de lancement.
Un relevé utile est court : la forme de l'adresse, le port, s'il s'agissait du service jetable ou d'un port inutilisé, et ce que la page a observé. Limitez-le à vos ports de test. Un relevé qui ne liste que les résultats de ports que vous avez ouverts vous-même suffit à montrer l'uniformité et ne laisse aucun inventaire de vos vrais services dans un document partagé.
Si la mesure de référence semble déjà uniforme, la comparaison apporte peu, car votre page de test ne distinguait pas les deux ports même sans protection. Si l'exécution protégée montre encore une différence sur un port que vous pensez couvert, vérifiez que l'indicateur ou le réglage du profil est bien parvenu au navigateur, et confirmez le port dans la documentation. Un port hors de l'ensemble couvert se comporte comme avant. C'est une question de couverture à soumettre au support, pas nécessairement un dysfonctionnement.
Ce que BotBrowser prend en charge et ce qui reste hors de sa portée
BotBrowser PRO prend en charge la protection des ports via l'indicateur --bot-port-protection ou configs.portProtection dans un profil, et fait en sorte que les tentatives de connexion des pages web vers des ports de bouclage couramment sondés (30 ports sur 127.0.0.0/8, ::1 et localhost) se comportent de façon cohérente, afin qu'une page ne puisse pas cartographier les services locaux que vous exécutez. BotBrowser ne peut pas garantir la couverture des ports hors des 30 documentés ni des plages de réseau local comme 192.168.x.x, ne peut pas modifier les connexions établies directement par les outils locaux et ne remplace pas les protections de proxy, de DNS, de WebRTC ni les autres protections d'empreinte.
Le périmètre est volontairement étroit. Les adresses que nomme la documentation sont des adresses de bouclage. Les plages utilisées par d'autres appareils de votre réseau, comme 192.168.x.x, 10.x.x.x et 172.16.x.x, ne font pas partie de la couverture documentée ; ne les présentez donc pas comme protégées. La fonction n'est de plus qu'une couche parmi d'autres : votre adresse IP, les requêtes DNS et les candidats WebRTC sont des surfaces distinctes qui demandent leur propre traitement, tout comme le canvas, les polices et les signaux similaires.
Pour les couches réseau voisines, consultez la prévention des fuites DNS, la prévention des fuites WebRTC et la cohérence entre proxy, DNS et WebRTC. Revérifiez la documentation de la protection des ports et la référence des indicateurs de la CLI avant de modifier dans vos propres notes les plages couvertes, le nombre de ports, le niveau de licence ou l'état par défaut, car ce sont les détails les plus susceptibles d'évoluer d'une version à l'autre.
Sources
- Documentation BotBrowser : protection des ports
- Documentation BotBrowser : référence des indicateurs de la CLI
- WICG : Local Network Access
- RFC 1122 : Requirements for Internet Hosts, Communication Layers
- RFC 4291 : IP Version 6 Addressing Architecture
Conclusion pratique
Activez --bot-port-protection ou configs.portProtection lorsque le résultat visible par une page doit être indépendant des services locaux. Vérifiez l'ensemble documenté de 30 ports et répétez le contrôle pour 127.0.0.1, ::1 et localhost ; un résultat uniforme du navigateur ne protège ni les adresses privées ni les ports hors ensemble.
Cet article fait partie du guide : Vue d’ensemble de la configuration proxy : carte des décisions réseau
Articles Connexes
Vue d’ensemble de la configuration proxy : carte des décisions réseau
RéseauPrévention des fuites DNS : chemins de résolution, proxys et tests
RéseauUDP sur SOCKS5 : routes privées pour QUIC et WebRTC
PlateformePermissions Web Serial et cycle de vie des ports
RéseauCohérence du proxy IPv4 et IPv6 dans un navigateur
RéseauConfiguration proxy du navigateur : guide SOCKS5, HTTP et HTTPS
Faites passer BotBrowser de la recherche à la production
Utilisez ces guides pour comprendre le modèle, puis passez à la validation multi-plateforme, aux contextes isolés et au déploiement navigateur prêt pour l'échelle.