Itérateurs paresseux et à usage unique : take et drop
Une sonde sur les assistants d’itérateur : quand la première valeur est tirée, pourquoi le résultat ne se parcourt pas deux fois et comment take arrête ce que drop parcourt.
BotBrowser Team
Vous voulez la documentation structurée pour Empreinte ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
BotBrowser permet de rejouer un fixture de même origine autorisé sous un profil déclaré et de garder une trace bornée de ce qu’une page a réellement tiré d’un flux, mais il ne peut pas faire rendre des valeurs une seconde fois à un itérateur consommé, ne peut pas transformer take en vidage, ni empêcher drop de parcourir les valeurs qu’il saute. Cette revue exécute une sonde sur quatorze cas fixes et consigne quand chaque assistant tire sa première valeur, pourquoi le résultat d’un assistant ne se parcourt pas deux fois alors que le tableau d’origine si, jusqu’où take et drop avancent la source, ce que laisse un assistant consommé à moitié, et comment un lancement dans la source traverse la chaîne.
Résumé
- Un assistant est paresseux : après
source().map(...)la sonde imprimelazy-before -> pulled=0, et seul le premiernext()tire une valeur (lazy-after-one -> first=10 pulled=1). - Un assistant renvoie un itérateur, pas un tableau : la sonde imprime
type -> isArray=false isIterator=true. - Un assistant est à usage unique : l’étaler deux fois imprime
consume-twice -> first=2,4,6 second=alors que le tableau dont il vient imprimearray-reiterable -> a=1,2,3 b=1,2,3. take(2)arrête tôt la source, donc la sonde imprimetake -> values=1,2 pulled=1,2et ne tire jamais les valeurs trois à cinq.drop(3)ne vide pas la source d’avance, mais son premiernext()parcourt les trois valeurs sautées :drop-after-one -> value=4 pulled=1,2,3,4.flatMapexige un résultat itérable ; renvoyer un nombre lève unTypeError.findetsomecessent de tirer dès que la réponse est connue, tandis quereducevide toute la source.- Un lancement dans la source atteint le consommateur après les valeurs déjà émises, et la chaîne s’arrête là.
Sommaire
- Quand un assistant tire sa première valeur
- Pourquoi le résultat est à usage unique
- Jusqu’où take et drop avancent la source
- Ce que fait un lancement dans la source
- Consigner une lecture d’assistants d’itérateur
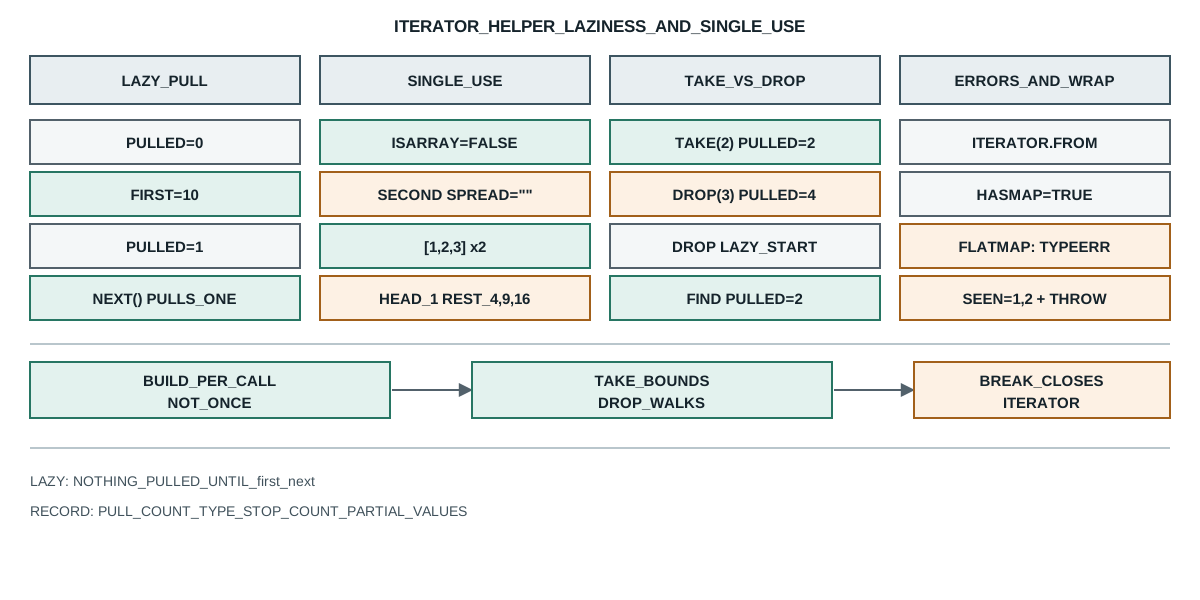
Quand un assistant tire sa première valeur
Un assistant d’itérateur est un emballage qui produit des valeurs à la demande, et tout l’intérêt est que rien ne s’exécute avant qu’un consommateur ne demande. La sonde construit un générateur qui note chaque valeur qu’il émet, l’enveloppe dans map et vérifie le compteur avant que quoi que ce soit ne demande une valeur :
node=v26.9.0
lazy-before -> pulled=0
lazy-after-one -> first=10 pulled=1
type -> isArray=false isIterator=true
consume-twice -> first=2,4,6 second=
array-reiterable -> a=1,2,3 b=1,2,3
helper-reiterable -> a=2,3,4 b=
take -> values=1,2 pulled=1,2
take-stopped -> pulledCount=2
drop -> values=4,5 pulled=1,2,3,4,5
drop-before-next -> pulled=0
drop-after-one -> value=4 pulled=1,2,3,4
partial -> head=1 rest=4,9,16
flatMap -> 1,10,2,20
flatMap-non-iterable -> TypeError
find -> value=2 pulled=1,2
some -> result=true pulled=1,2,3
reduce -> total=6 pulled=1,2,3
exhausted-source -> length=0
thrown -> seen=2 error=Error:source failed
from-before -> pulled=0 hasMap=true
from-take -> values=1,2,3 pulled=1,2,3
toArray -> 3,6,9 thenNext=true
break -> seen=1,2 nextDone=true
Les deux premières lignes sont la définition du dispositif. lazy-before -> pulled=0 signifie que l’appel à map n’a fait aucun travail : il a lié un rappel à une source et rendu la main. lazy-after-one -> first=10 pulled=1 montre que le premier next() a tiré exactement une valeur du générateur, exécuté le rappel dessus et renvoyé le résultat mappé. Une chaîne d’assistants reste paresseuse de la même façon, parce que chaque maillon ne tire du précédent que lorsque le consommateur tire de la chaîne.
Un second point d’entrée mérite une mention parce qu’il change ce qu’un assistant peut envelopper. Iterator.from prend n’importe quel itérable ou itérateur et renvoie un itérateur porteur des assistants, ce qui veut dire qu’un objet qui n’implémente que Symbol.iterator peut recevoir les mêmes assistants qu’un itérateur natif. Les cas de la sonde partent tous d’un générateur ou d’un tableau, et les deux portent déjà les assistants, donc la valeur d’Iterator.from apparaît avec un itérable propre comme un curseur sur un résultat de base de données. Une page qui enveloppe son propre curseur dans Iterator.from peut alors le borner avec take sans écrire de boucle manuelle, et la même paresse s’applique : rien n’est lu du curseur avant le premier tirage. La sonde imprime from-before -> pulled=0 hasMap=true, puis enveloppe un itérable propre de cinq valeurs dans take(3) et imprime from-take -> values=1,2,3 pulled=1,2,3, donc le curseur a avancé exactement trois fois.
Cela compte pour une page qui lit une source grande ou illimitée. Un map sur un générateur qui prendrait des minutes à finir ne coûte rien à construire, et un take(10) plus loin dans la chaîne fait que seules dix valeurs sont jamais produites. L’alternative, construire un tableau intermédiaire, force toute la source à tourner avant que la première valeur ne soit disponible, ce qui est la différence entre un flux qui commence à livrer en une fraction de seconde et un qui bloque jusqu’à la fin.
La paresse est par tirage, pas par lot d’éléments. Chaque next() fait tourner la source jusqu’à avoir une valeur de plus, donc le rappel de la valeur n ne s’exécute que lorsque le consommateur demande la valeur n. Une page qui intercale son propre travail entre les tirages, comme lire un flux réseau ou écrire un fichier, répartit donc le coût de la source sur les tours du consommateur au lieu de le payer en un appel bloquant. Cet intercalage est la même frontière de tour que décrit microtâches et minuteries, où un rappel mis en file comme microtâche s’exécute avant l’arrivée de la tâche suivante.
Le coût est qu’un assistant ne porte aucun contrôle sur le nombre de valeurs déjà produites par la source. Il n’y a ni aperçu, ni retour arrière, ni compte, donc un consommateur qui en a besoin doit les construire, typiquement en enveloppant le générateur lui-même d’un compteur. L’assistant n’ajoute que l’étape de mapping, et il est délibérément l’emballage le plus fin possible parce que tout ce qui serait plus lourd casserait la paresse qui le rend préférable à une méthode de tableau.
Pourquoi le résultat est à usage unique
L’autre moitié du dispositif est qu’un assistant renvoie un itérateur plutôt qu’une collection, et la sonde montre la conséquence exacte. Elle imprime type -> isArray=false isIterator=true, puis étale le même assistant deux fois et obtient consume-twice -> first=2,4,6 second=.
Le premier spread a parcouru l’itérateur jusqu’au bout, et le second l’a trouvé épuisé et n’a rien produit, sans erreur. C’est le comportement de tout itérateur du langage, et un assistant l’hérite parce qu’il est bâti sur le protocole d’itération et non sur une copie. Comparez le tableau source à la ligne suivante : array-reiterable -> a=1,2,3 b=1,2,3, parce qu’array.values() renvoie un itérateur neuf à chaque appel.
La ligne d’après est le bout tranchant de la même règle. helper-reiterable -> a=2,3,4 b= montre que l’assistant lui-même n’est pas réitérable : il garde l’unique itérateur avec lequel il a été construit, le premier spread l’a consommé et le second n’a rien vu. C’est l’erreur qui transforme une chaîne paresseuse en résultat vide silencieux. Une fonction qui renvoie un assistant et est appelée deux fois reçoit un itérateur mort au second appel, et la panne est une séquence vide plutôt qu’une exception.
Le correctif est de renvoyer une fonction qui construit un assistant à chaque appel, ou de renvoyer la source et de bâtir la chaîne au point d’appel. Un assistant destiné à être réutilisé doit être redérivé de sa source à chaque fois, parce que le langage ne donne aucun réinitialisation à un itérateur. C’est la même raison pour laquelle un objet générateur ne se parcourt pas deux fois, et une page qui mélange les deux styles obtient le second résultat vide chaque fois qu’elle suppose le contraire.
Un lot de valeurs tirées à moitié rempli a le même problème de forme qu’un tableau creux, où un index absent et un undefined stocké se lisent pareil mais s’itèrent autrement. La consommation partielle d’un assistant est la version douce de la même règle. La sonde tire une valeur, puis étale le reste, et imprime partial -> head=1 rest=4,9,16 pour un map qui élève son entrée au carré. L’unique next() a renvoyé 1 (le carré de 1), et le spread suivant a repris là où le tirage s’est arrêté, renvoyant 4, 9, 16 pour les entrées 2, 3, 4. Rien n’a été perdu ni répété, parce que l’itérateur se souvient de sa position ; un second spread aurait renvoyé vide. Un assistant terminal termine l’itérateur comme le fait un spread : la sonde imprime toArray -> 3,6,9 thenNext=true, donc après que toArray a recueilli toutes les valeurs le next() suivant a rapporté terminé.
Une source déjà épuisée avant la construction de l’assistant est le cas silencieux. La sonde vide un itérateur de tableau, puis construit un map sur le même objet et l’étale, en imprimant exhausted-source -> length=0. Il n’y a ni erreur ni avertissement : l’assistant a été construit sur un itérateur qui avait déjà rapporté terminé, donc tout tirage ultérieur renvoie terminé immédiatement. Une page qui met en cache un itérateur et construit un assistant dessus plus tard obtient un résultat vide dès que quelque chose d’autre a consommé l’itérateur entre-temps, et le correctif est le même que pour le double spread : construire l’assistant depuis une source capable de produire un itérateur neuf à chaque fois.
Une boucle qui s’arrête tôt se comporte à l’inverse de ce que suggère le modèle de position. La sonde exécute un for...of sur un assistant, rompt à la valeur 2, puis demande une valeur de plus : elle imprime break -> seen=1,2 nextDone=true. Donc un break ne gare pas l’itérateur pour une lecture ultérieure ; sortir de la boucle le ferme, et les valeurs après le break sont perdues. Un consommateur qui veut lire un en-tête, s’arrêter et reprendre depuis le corps ne peut pas utiliser un break dans un for...of sur un seul itérateur ; il doit tirer avec next() pour que l’itérateur ne se ferme pas, ou construire un itérateur neuf sur la source.
Cela compte surtout pour la raison d’être de tout ce dispositif : borner le coût. Un break est la seule sortie précoce qui jette le reste, donc un consommateur qui lit jusqu’à une condition puis s’en va paie seulement ce qu’il a lu mais ne gagne plus rien de cet itérateur. La forme par tirage garde l’option ouverte, et la forme avec take borne la lecture sans jamais avoir besoin d’un break, donc une chaîne qui compose take est la version qui s’arrête proprement et ne laisse aucun travail à demi fait.
Jusqu’où take et drop avancent la source
take et drop décident de ce qu’un consommateur voit d’une source, et la sonde montre qu’ils l’avancent de façons opposées. take s’arrête tôt, et drop parcourt les valeurs qu’il saute.
Le cas de take imprime take -> values=1,2 pulled=1,2 puis take-stopped -> pulledCount=2. La source générait cinq valeurs au total, et après en avoir pris deux, les tirages enregistrés sont exactement les deux premiers. take(2) n’a pas lu les trois restants pour les jeter ; il a demandé deux puis s’est arrêté, ce qui permet de borner une source infinie. Une page qui prend un nombre fixe d’éléments sur un flux illimité paie donc exactement ceux-là, et le reste du flux n’est pas touché.
Le cas de drop est l’image en miroir. Le spread impatient imprime drop -> values=4,5 pulled=1,2,3,4,5, parce qu’étaler jusqu’au bout a tout tiré, et les valeurs jetées ont dû être générées pour être sautées. La ligne la plus révélatrice est la paresseuse : drop-before-next -> pulled=0 montre qu’un drop(3) fraîchement créé n’a rien tiré à la construction, et drop-after-one -> value=4 pulled=1,2,3,4 montre que son premier next() a parcouru quatre valeurs pour renvoyer la quatrième. Donc drop est paresseux à la construction comme tout assistant, mais le travail qu’il diffère est celui du saut, et un consommateur qui demande une valeur après un drop(3) a déjà causé quatre tirages.
Cette asymétrie décide comment borner un flux. take est le plafond sûr parce qu’il ne lit jamais de trop. drop est un filtre sur la position, et un drop avec un grand compte sur une source lente fait le travail lent avant que la première valeur n’atteigne le consommateur, donc une page qui compose un grand drop avec un take paie quand même le drop. Un consommateur qui veut sauter un en-tête puis lire un corps paie donc l’en-tête dès qu’il demande la première valeur du corps, pas avant de commencer, mais pas gratuitement non plus.
L’interaction avec flatMap mérite une ligne de la même lecture. La sonde imprime flatMap -> 1,10,2,20 pour un flatMap qui renvoie deux valeurs par entrée, donc chaque tirage de la source est devenu deux tirages pour le consommateur, et l’aplatissement est d’un niveau plutôt que récursif. Un flatMap qui renverrait un tableau imbriqué livrerait au consommateur un tableau comme valeur, pas ses éléments, ce qui est la même règle d’un niveau que la méthode de tableau du même nom.
flatMap refuse aussi d’aplatir une valeur qui n’est pas itérable. La tentative de la sonde de renvoyer un nombre imprime flatMap-non-iterable -> TypeError, donc un rappel qui renvoie parfois un scalaire et parfois une liste échoue sur le scalaire au lieu de le sauter. Une page qui construit un flatMap depuis un rappel qui peut renvoyer undefined doit donc normaliser le résultat en tableau vide ou à un élément avant que l’assistant ne le voie, parce que l’assistant ne traitera pas un non-itérable comme « rien à aplatir ».
Ce que fait un lancement dans la source
Un itérateur qui échoue à mi-chemin doit faire quelque chose des valeurs qu’il a déjà produites, et la sonde fixe le comportement. Sa source émet 1 puis lève un Error('source failed'), et un map dessus est consommé par une boucle for...of :
thrown -> seen=2 error=Error:source failed
Le consommateur a reçu la première valeur mappée, 2, l’a enregistrée, puis le tirage suivant a fait tourner la source vers le lancement, qui s’est propagé hors de la boucle comme l’erreur d’origine. Les valeurs antérieures au lancement ne sont pas retirées, et les suivantes n’ont jamais existé. C’est le contrat sur lequel s’appuie un consommateur qui traite les éléments à mesure qu’ils arrivent : tout ce qu’il a déjà traité reste traité, et la panne apparaît au point où la source a échoué plutôt qu’au début.
L’erreur n’est pas emballée. La sonde imprime Error:source failed, qui est le même constructeur et le même message que la source a levés, donc une chaîne d’assistants transmet la valeur levée sans changement. Une page qui veut ajouter du contexte doit emballer l’erreur au point où elle traite les éléments, parce que l’assistant n’ajoutera pas de couche nommant l’étape de la chaîne qui a échoué.
L’itérateur est terminé après le lancement, donc un nouvel essai sur le même objet ne produit rien au lieu de relancer la source. C’est la même règle d’usage unique que le cas du spread, appliquée à une panne : la position est au-delà du lancement, et il n’y a aucun moyen d’y revenir. Une page qui doit réessayer doit construire un itérateur neuf depuis une source neuve, ce qui veut généralement dire une fonction qui construit le générateur plutôt qu’un objet générateur stocké.
Un reduce sur la même source est impatient, et cela change quand le lancement survient par rapport à l’appelant. La sonde imprime reduce -> total=6 pulled=1,2,3 pour une source de trois valeurs, sans résultat partiel disponible à mi-parcours, donc un reduce qui rencontre un lancement perd l’accumulateur qu’il avait bâti. Les assistants non réducteurs laissent un consommateur voir les valeurs une à une et agir sur chacune ; un reduce les replie en une seule valeur à la fin, et une panne signifie que cette valeur n’arrive jamais. Choisir entre les deux est donc un choix sur la quantité d’avancement partiel que le consommateur doit garder.
Consigner une lecture d’assistants d’itérateur
Une lecture d’assistants d’itérateur soutient une affirmation bornée : ce moteur, cette source, ces assistants ont produit ces tirages. Quatre champs la gardent vérifiable :
- Le compte de tirages avant le premier
next(), parce que la paresse est tout l’intérêt et un assistant construit qui a déjà tiré quelque chose n’est pas paresseux. - Si le consommateur tenait un tableau ou un itérateur, parce qu’une seconde itération sur un itérateur renvoie vide et sur un tableau renvoie les valeurs de nouveau.
- Le compte de tirages à chaque arrêt, parce que
takeetdropavancent la source de quantités différentes et que seul le compte montre laquelle. - Si une panne est arrivée après les valeurs déjà émises, parce qu’un consommateur qui garde ses résultats partiels dépend de la survie des valeurs antérieures au lancement.
Sources publiques
- MDN : Iterator
- MDN : Iterator.prototype.map()
- MDN : Iterator.prototype.take()
- MDN : Iterator.prototype.drop()
- MDN : Iterator.prototype.flatMap()
- ECMAScript : Iterator Helpers
- BotBrowser : référence de cohérence d’automatisation
Conclusion pratique
Bâtissez une chaîne d’assistants et ne payez que les valeurs que vous tirez : construisez la chaîne, bornez-la avec take quand la source est illimitée, et rappelez-vous que drop parcourt ce qu’il saute au premier tirage et non d’avance. Renvoyez une fonction qui construit la chaîne plutôt qu’un itérateur stocké quand un appelant peut itérer deux fois, parce qu’un assistant est à usage unique et qu’un second spread est silencieusement vide. Normalisez le résultat du rappel de flatMap en tableau pour qu’un scalaire ne puisse pas lever, et décidez si un consommateur doit garder les valeurs qu’il a déjà traitées, parce qu’un lancement termine l’itérateur et qu’un reduce perd son accumulateur. Pour l’ordre dans lequel livre un flux fondé sur les microtâches, lisez microtâches et minuteries ; pour le trou que laisse un lot à moitié rempli, lisez trous de tableaux creux.
Cet article fait partie du guide : Qu'est-ce qu'une empreinte de navigateur ?
Articles Connexes
FingerprintJS OSS : collecte et provenance du condensat
EmpreinteWeakMap et WeakSet : garder et lâcher des clés
EmpreinteTrous de tableau creux et ce que fait chaque méthode
EmpreinteIntl.NumberFormat : mode d’arrondi et affichage du signe
EmpreintePromise : ce qui échoue d’abord
EmpreinteRaison d’annulation, composition et écouteurs tardifs
Faites passer BotBrowser de la recherche à la production
Utilisez ces guides pour comprendre le modèle, puis passez à la validation multi-plateforme, aux contextes isolés et au déploiement navigateur prêt pour l'échelle.