Retour arrière de l'isolation inter-origines : liste de contrôle
Décidez quelles URL restent isolées, quel responsable porte chaque classe de ressource et comment un déploiement progressif revient aux en-têtes précédents.
BotBrowser Team
Vous voulez la documentation structurée pour Plateforme ?
Cet article fait partie de la bibliothèque éditoriale. Pour les étapes de configuration, la référence et les mises à jour continues, passez directement à la section docs.
Changer l'isolation inter-origines, c'est changer la politique de réponse d'un produit en production, et le difficile n'est pas de l'activer. Cette liste commence là où s'arrête le correctif du message not cross-origin isolated : une fois qu'une première page prouve son état isolé, il reste à décider quelles URL doivent le rester, qui répond de chaque ressource intégrée et ce que fait un déploiement progressif quand un parcours casse.
BotBrowser peut charger une version de navigateur déclarée sur une page en propre et noter si window.crossOriginIsolated vaut vrai pour cette réponse ; il ne peut pas envoyer COOP ni COEP pour un hôte, modifier la réponse CORS ou CORP d'un fournisseur, ni restaurer un parcours que la nouvelle politique sépare.
Résumé
- Listez les URL qui ont besoin de l'isolation et laissez les autres non isolées à dessein.
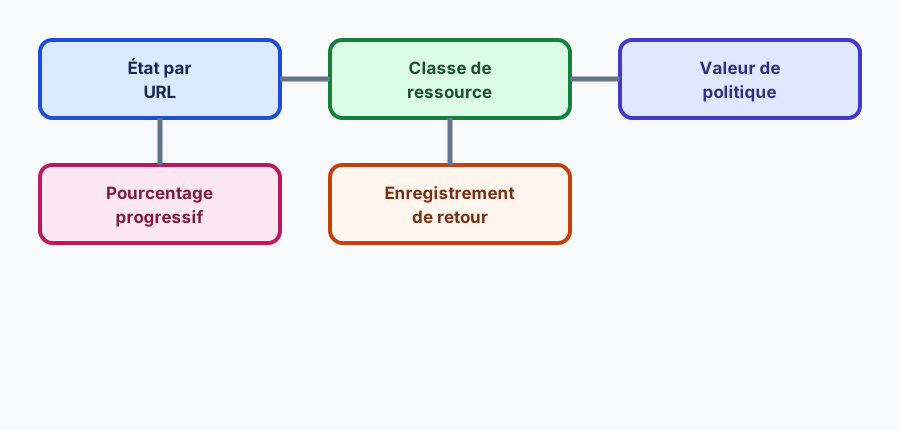
- Associez chaque classe de ressource intégrée à un responsable de politique avant de toucher un en-tête.
- Déployez par pourcentage ou par hôte, pas en ouvrant toutes les routes d'un coup.
- Convenez du déclencheur de retour arrière et du jeu d'en-têtes précédent avant la première requête de production.
Sommaire
- Délimiter les URL à isoler
- Associer les classes de ressource aux responsables
- Déployer progressivement
- Définir le retour arrière
- Livrer le repli et les preuves
- Conclusion pratique
Délimiter les URL à isoler
L'isolation appartient aux documents, pas au site. Un produit en a généralement besoin sur une seule surface, par exemple une page qui démarre un worker avec mémoire partagée, et n'en a pas besoin sur une page de présentation, un parcours de connexion ou un retour OAuth. Envoyer Cross-Origin-Opener-Policy: same-origin et Cross-Origin-Embedder-Policy: require-corp partout élargit le rayon d'impact sans rien apporter aux pages qui ne touchent jamais une fonction réservée à l'état isolé. Avant d'élargir le périmètre, relisez le guide des frontières CORS, qui décrit les ressources déjà considérées comme dépendances inter-origines.
Écrivez le périmètre comme une liste de motifs d'URL comme /app/editor/* et /auth/*, pas comme un domaine. Incluez les chemins de document à isoler, ceux qui doivent rester non isolés et les chemins de retour dont le comportement de fenêtre ne peut pas changer. Une chaîne de redirections qui se termine sur un document isolé reste isolée ; celle qui se termine sur un document non isolé ne l'est pas, et cette différence se perd quand le périmètre est écrit comme « l'application ».
Consignez le périmètre au même endroit que l'enregistrement de déploiement (docs/cross-origin-isolation-scope.md), avec la date et le responsable. Quand une route est ajoutée plus tard, le périmètre indique si elle hérite de l'isolation d'un motif parent ou si elle a besoin de sa propre politique. C'est la différence entre une politique voulue et une politique qui s'est étendue par accident.
Vérifiez le périmètre contre le plan du site et le manifeste de routes plutôt que de mémoire, et automatisez cette comparaison si l'ensemble des routes change souvent. Une route générée par un gabarit peut servir un document que votre règle d'en-têtes ne couvre pas, surtout si le gabarit a sa propre mise en page et un hôte canonique différent. Le premier endroit où l'isolation surprend une équipe est une page que personne n'avait listée.
Garder le périmètre vérifiable
La revue du périmètre est aussi le moment de confirmer que les pages non isolées n'ont pas vraiment besoin d'une fonction réservée à l'état isolé. Cherchez SharedArrayBuffer, crossOriginIsolated et Atomics dans l'application avant de déclarer une page hors périmètre. Une page qui teste le booléen et se replie peut rester non isolée ; une page qui construit un tampon partagé sans tester lèvera une erreur dès que la fonction sera exercée.
Si une page n'a besoin de l'isolation que sous un indicateur de fonctionnalité, notez l'indicateur avec le motif. Activer l'indicateur sur un hôte qui n'envoie pas la politique produit un échec à l'exécution qui ressemble à un défaut de code, et l'enregistrement de l'indicateur permet de voir que la politique n'a jamais été en place plutôt que de conclure à une régression.
Écrire le périmètre comme une liste vérifiable
Un périmètre qui vit dans une présentation ne se vérifie pas ; gardez l'état attendu comme une ligne de scopes.tsv ou un champ JSON que le build peut lire. Gardez-le comme une liste de motifs avec un état attendu par motif, pour qu'un changement ultérieur s'y compare au lieu de faire l'objet d'une discussion. Une entrée utile nomme le motif, l'état d'isolation attendu, la raison et le responsable qui l'a demandé.
L'état attendu n'est pas toujours « isolé ». Beaucoup de produits ont besoin qu'un document reste non isolé parce qu'un widget de messagerie, un iframe de paiement ou un rapport ancien dépend de ressources que personne ne peut changer dans la même fenêtre. Consigner cette intention évite qu'un nettoyage ultérieur « corrige » une page volontairement exclue et casse un parcours au passage.
Regroupez les motifs par leur chemin de réponse et pas seulement par préfixe d'URL. Deux chemins sous le même préfixe peuvent être servis par des origines différentes après une réécriture, et une règle CDN qui s'applique à l'un peut ne pas s'appliquer à l'autre. Quand la liste dépasse quelques entrées, ajoutez une vérification que chaque route versionnée correspond à un motif ou est explicitement exclue, pour qu'une nouvelle route n'hérite pas silencieusement du mauvais état.
Gardez la liste à côté de la configuration de déploiement et mettez-la à jour dans le même changement qui ajoute ou retire une route. Un périmètre corrigé après coup a déjà été faux en production, et l'échec qu'il cause ressemble à une incohérence aléatoire plutôt qu'à une entrée manquante.
Mesurer avant et après, sur le même build
La mesure qui rend un déploiement vérifiable est une comparaison, pas une lecture unique ; gardez scope-before.json et scope-after.json. Prenez une référence sur l'hôte de préproduction avant le changement, puis répétez les mêmes vérifications après, sur le même build de navigateur et les mêmes fixtures. Une lecture unique après le changement ne dit pas si une valeur inattendue vient de la politique ou était déjà là.
Notez trois champs par page : les valeurs d'en-têtes réellement servies, le booléen d'isolation à l'exécution et la première ressource en échec, s'il y en a une. Les en-têtes disent ce que le serveur a envoyé, le booléen ce que le navigateur a accepté, la ressource en échec quelle classe demander quand les deux premiers ne concordent pas.
Échantillonnez au moins une URL par motif plutôt qu'une seule URL globale. Une chaîne de redirections, un hôte localisé et une variante avec barre finale peuvent produire des réponses finales différentes, et le motif vaut ce que vaut son membre le moins testé.
Répétez la mesure après un changement de CDN, une mise à jour de service worker ou une migration d'hébergement même si le code de l'application n'a pas bougé. Ces trois événements changent la réponse servie sans toucher au dépôt, et c'est précisément pour cela qu'un enregistrement de politique antérieur peut induire en erreur.
Associer les classes de ressource aux responsables
L'isolation change ce qui peut se charger, donc chaque classe de ressource intégrée a besoin d'une décision et d'un responsable. Regroupez-les par mode de service et non par équipe demandeuse, parce que la réponse de politique dépend de la réponse du serveur et non de la requête.
Les cadres sont la classe la plus sensible. Un iframe d'une autre origine a besoin d'une réponse compatible COEP ou d'un en-tête CORP, et un cadre fournisseur qui n'en envoie pas échouera dès que le document hôte applique COEP. La connexion par fenêtre appartient à la même classe : COOP sépare la relation avec l'ouvrant, et un fournisseur qui attend window.opener s'en apercevra. Notez le fournisseur, l'origine du cadre et ce que sa documentation dit de la compatibilité avec l'isolation.
Scripts, feuilles de style, polices et images forment la classe suivante. Ils sont souvent servis par un CDN, et la réponse est un en-tête CORS ou Cross-Origin-Resource-Policy: cross-origin. Une règle CDN qui marche pour un sous-domaine peut ne pas s'appliquer à l'hôte canonique, donc le responsable à nommer est celui qui peut changer la réponse de l'hôte exact que vous appelez.
Les médias sont une classe à part et souvent les plus lents à changer. Les points d'accès vidéo et audio peuvent être signés, redirigés ou propres à une région, et chacun de ces cas change les en-têtes que vous voyez. Testez avec une URL signée proche d'une URL de production plutôt qu'avec un échantillon statique.
L'analytique et les gestionnaires de balises sont la classe la plus susceptible d'échouer en silence. Beaucoup chargent des scripts supplémentaires à l'exécution, donc l'URL que vous avez revue n'est pas celle qui s'exécute. Notez qu'ils peuvent échouer et décidez si cet échec est acceptable, parce qu'une balise qui cesse de remonter bloque rarement un parcours utilisateur mais change bien les données sur lesquelles vous vous appuyez.
Pour chaque classe, nommez la politique, le responsable et la vérification. La vérification est une requête par classe, notée avec l'URL finale et la valeur d'en-tête qui l'a rendue compatible. Une classe sans vérification est une classe que vous supposez au lieu de la connaître, et une supposition est ce qui transforme un déploiement progressif en surprise.
Déployer progressivement
Déployez par trafic, pas par ambition. Un déploiement progressif fait venir la première preuve de production d'une petite population tandis que la politique précédente reste à un changement de configuration. Choisissez la dimension de progression selon ce que votre infrastructure annule le plus vite : un pourcentage à la périphérie, une règle d'en-têtes sur un hôte ou une route canari servant le même code.
Alignez l'unité de progression sur le parcours utilisateur. Un pourcentage de trafic peut envoyer un même utilisateur vers la version isolée sur la première page et vers la version non isolée au retour, ce qui produit un échec qui semble aléatoire et ne l'est pas. Un pourcentage collant ou un regroupement par hôte garde un parcours sous une seule politique pendant sa durée.
Décidez l'ordre des surfaces. Commencez par celle qui a le moins de dépendances intégrées et le repli le plus clair, et terminez par celle qui porte la connexion ou le paiement. L'intérêt de l'ordre est d'apprendre les classes de ressource à un endroit bon marché avant l'endroit coûteux.
Surveillez les bons signaux pendant la fenêtre. Un crossOriginIsolated: false sur une page qui devrait être vraie est un résultat de configuration. Une ressource bloquée est un résultat de politique contre une classe. Un utilisateur qui ne peut pas se connecter est un résultat d'application, et il prime sur les deux autres car aucun état isolé ne vaut un parcours cassé.
Gardez la fenêtre assez courte pour être annulable et assez longue pour voir un parcours complet, et inscrite dans l'enregistrement avant qu'elle commence pour que personne ne l'allonge par accident. Une fenêtre qui se termine avant qu'un utilisateur ne se connecte et ne revienne par le retour n'a pas testé les chemins qui cassent le plus souvent.
Définir le retour arrière
Un retour arrière a besoin d'un déclencheur, d'une action et d'une vérification convenus avant le début. Le déclencheur est une phrase qu'un ingénieur support peut appliquer sans demander au responsable de la livraison : un parcours essentiel échoue au-delà d'une part déclarée des utilisateurs concernés, ou le responsable d'une classe ne parvient pas à rendre une ressource compatible pendant la fenêtre.
L'action est le jeu d'en-têtes précédent plus le chemin applicatif précédent, tous deux disponibles et testés. Un retour d'en-têtes qui restaure COOP et COEP en laissant la fonction isolée active produit une page qui annonce faux puis échoue à l'exécution ; le chemin applicatif doit changer avec la politique.
La vérification est la même que celle qui a prouvé l'isolation, exécutée à l'envers : l'hôte concerné revient aux en-têtes précédents, crossOriginIsolated est faux là où c'est attendu, le repli termine le parcours et les classes qui exigeaient la nouvelle politique ne sont plus requises. Notez le résultat avec la date et la personne qui a décidé.
Écrivez ce que le retour arrière ne couvre pas. Un document en cache, un service worker ou une règle de périphérie avec un TTL long peuvent continuer à servir la nouvelle politique après le changement d'origine. Notez l'étape de purge et les hôtes concernés, car un retour incomplet est une politique qui semble annulée et ne l'est pas.
Revoyez l'enregistrement de retour arrière quand le déploiement se termine, qu'il ait servi ou non. Un retour qui n'a pas été nécessaire dit quand même si l'action a fonctionné, et le changement d'en-têtes suivant peut réutiliser la procédure au lieu de la redécouvrir.
Livrer le repli et les preuves
Choisir le repli que le produit peut vraiment livrer
Chaque fonction réservée à l'état isolé a besoin d'un repli avec lequel l'utilisateur peut accomplir la tâche (fallback: passed), et le repli doit être le chemin le plus simple plutôt qu'un second système. Un worker avec mémoire partagée peut se replier sur une boucle dans le fil principal avec un indicateur de progression. Une fonction qui a besoin de l'isolation pour la performance peut se dégrader vers le chemin lent avec un avis visible. Une fonction qui a besoin de l'isolation pour l'exactitude ne peut pas se replier, et c'est une décision produit à remonter avant le déploiement plutôt que pendant.
Testez le repli avec les mêmes fixtures que le chemin isolé. Un repli qui n'a jamais tourné avec des données proches de la production est un chemin non testé, et la fenêtre de déploiement n'est pas le moment de découvrir qu'il lève une erreur sur une grosse entrée.
Décidez qui possède le repli. Si l'équipe applicative le livre et que l'équipe plateforme active l'en-tête, le repli appartient à l'équipe applicative et doit figurer dans la liste de livraison plutôt que d'être ajouté après coup. L'enregistrement de déploiement doit nommer le repli et où le vérifier, pour qu'un ingénieur support puisse y diriger un utilisateur sans attendre un diagnostic.
Garder des preuves assez courtes pour agir
Un enregistrement de déploiement que seul un spécialiste lit ne sera pas lu pendant un incident. Réduisez-le à la liste de périmètre, aux responsables par classe, à la dimension de progression, aux lectures avant et après, au déclencheur de retour arrière et au repli. Chaque élément tient en une ligne et renvoie au document long si nécessaire.
Datez l'enregistrement et nommez la personne qui a accepté la politique, avec le fuseau horaire local de la fenêtre prévue. Un enregistrement sans responsable devient un enregistrement que personne ne défend, et le changement suivant part d'une position plus faible que le premier.
Retirez l'enregistrement quand la politique est stable depuis assez longtemps et que le jeu d'en-têtes précédent n'existe plus dans aucune configuration déployable. D'ici là, l'enregistrement est la seule description de la façon dont l'état actuel a été atteint.
Conclusion pratique
L'isolation est une politique de réponse avec un périmètre, des responsables et un plan de déploiement. Décidez les URL, associez les classes de ressource, progressez par trafic et convenez du déclencheur de retour arrière avant la première requête de production. Utilisez cette liste avec le correctif d'isolation, le guide des frontières CORS et la vue des contextes sécurisés.
Sources publiques
Cet article fait partie du guide : Surfaces de la plateforme web : carte de revue
Articles Connexes
Résoudre not cross-origin isolated : COOP, COEP et SharedArrayBuffer
PlateformePermissions Policy pour les fonctions du navigateur intégrées
DéploiementDéploiement et livraison du navigateur : carte opérationnelle
PlateformeOrigin-Agent-Cluster : isolation mémoire JavaScript prévisible
PlateformeLimites CORS : en-tetes, preflight, identifiants et cache
PlateformeNotes de version du navigateur pour les équipes web
Faites passer BotBrowser de la recherche à la production
Utilisez ces guides pour comprendre le modèle, puis passez à la validation multi-plateforme, aux contextes isolés et au déploiement navigateur prêt pour l'échelle.