Semántica del proxy HTTP y solicitudes del navegador
Comprende cómo los navegadores usan proxies HTTP, túneles CONNECT, cabeceras, redirecciones y DNS para configurar rutas fiables.
Quieres la documentación estructurada de Red?
Este artículo forma parte de la biblioteca editorial. Para pasos de configuración, material de referencia y actualizaciones continuas, entra en la sección de docs.
Por qué importa la semántica del proxy en un navegador
Un proxy HTTP es mucho más que una dirección situada entre el navegador y un sitio web. Cambia la ruta, la forma de la solicitud y, a veces, el punto donde se resuelve un nombre. Estos detalles afectan a la autenticación, las cookies, las redirecciones, los certificados TLS, la caché, los registros y el origen aparente de la solicitud. Una configuración puede parecer correcta en el comando de inicio y, aun así, producir un intercambio por cable distinto del que espera la aplicación.
Cuando un navegador usa un proxy HTTP o HTTPS, la semántica de las solicitudes afecta a la autenticación, las cookies, las redirecciones, los certificados TLS, la caché, los registros y el origen aparente de cada solicitud. Esta guía sigue los estándares y el comportamiento observable, no a un proveedor concreto. Para una referencia práctica de configuración, consulta Configuración de proxy del navegador: guía de SOCKS5, HTTP y HTTPS. Si tu despliegue también usa WebRTC, ¿Qué es una fuga de IP de WebRTC? describe una ruta de tráfico separada que la configuración del proxy HTTP no controla automáticamente.
Las ideas clave son:
- Una solicitud enviada a un proxy puede usar una URI absoluta, mientras que una solicitud enviada por un túnel usa la forma de origen.
CONNECTcrea un túnel de bytes hacia un host y un puerto. Tras una respuesta correcta, el proxy normalmente reenvía bytes TLS cifrados sin interpretar los mensajes HTTP que contienen.- La autenticación del proxy y la autenticación del origen son desafíos distintos, con cabeceras diferentes.
- El navegador puede resolver un nombre de host localmente o pedir al proxy que lo resuelva, según el protocolo y la implementación.
- Las redirecciones, los service workers, las cachés y los protocolos no HTTP pueden generar solicitudes fáciles de pasar por alto en una prueba sencilla.
Los estándares son precisos sobre la sintaxis de los mensajes, pero dejan deliberadamente espacio para la política de despliegue. Un proxy puede restringir destinos, reescribir determinadas cabeceras o registrar metadatos. Trátalo como un servicio de red con su propio contrato, no como un cable transparente.
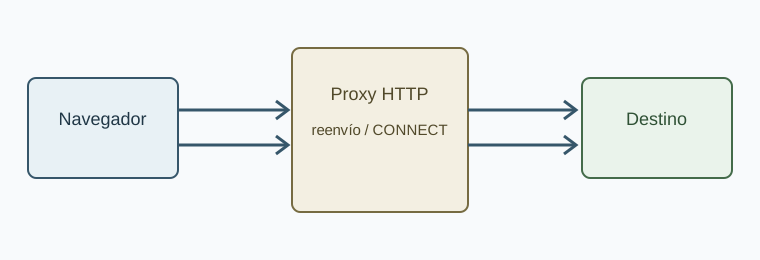
Formas de solicitud y primer salto
HTTP/1.1 define cuatro formas de destino de solicitud en RFC 9110, sección 7.1: origin-form, absolute-form, authority-form y asterisk-form. Un navegador que usa un proxy de reenvío suele enviar absolute-form para una solicitud HTTP normal. Por ejemplo, en lugar de enviar GET /products HTTP/1.1, puede enviar:
GET http://shop.example/products HTTP/1.1
Host: shop.example
Accept: text/html
El proxy usa la URI completa para seleccionar el siguiente salto. La cabecera Host sigue siendo importante porque identifica la autoridad que espera el servidor de origen y es obligatoria en las solicitudes HTTP/1.1. En una solicitud correcta, la autoridad de la URI y el campo Host coinciden. El proxy puede rechazar una discrepancia en vez de adivinar qué destino pretendía el cliente.
Cuando el navegador se conecta directamente a un origen HTTP, normalmente usa origin-form. La primera línea solo contiene la ruta y la consulta:
GET /products?sort=price HTTP/1.1
Host: shop.example
Esta distinción es útil al leer una captura de paquetes o un registro de acceso del proxy. Ver una URI absoluta en la línea de solicitud demuestra que el primer salto es un proxy de reenvío, no que el origen haya recibido esa misma forma. Por lo general, el proxy convierte la solicitud a la forma que espera el siguiente salto.
Authority-form se usa con CONNECT y consta de host y puerto, como shop.example:443. Asterisk-form, OPTIONS *, se dirige al propio servidor y no a un recurso concreto. Los navegadores rara vez generan esta última durante una carga normal, aunque una prueba diagnóstica o de compatibilidad sí puede hacerlo.
Las URL HTTP y HTTPS son casos distintos
Para una URL http://, el navegador puede enviar la solicitud HTTP a un proxy HTTP en texto legible. El proxy puede inspeccionar el método, la ruta, las cabeceras y el estado de respuesta. La conexión del proxy al origen también puede ser HTTP, aunque el proxy puede usar TLS hacia el origen cuando la URL solicitada es HTTPS.
Para una URL https://, el navegador suele pedir al proxy HTTP que abra un túnel:
CONNECT shop.example:443 HTTP/1.1
Host: shop.example:443
El proxy devuelve un estado como 200 Connection Established. Entonces el navegador inicia un handshake TLS por la conexión establecida. La solicitud HTTP, las cabeceras de respuesta y el cuerpo están dentro de TLS y no son visibles para un proxy de reenvío convencional. El proxy sí ve la autoridad de destino, los tiempos de conexión, el número de bytes y los metadatos que requiera su política.
El modelo de túnel explica por qué una página HTTPS puede fallar antes de cargarse. El proxy puede rechazar CONNECT, exigir autenticación, rechazar el puerto o no poder resolver el destino. En esos casos no existe una respuesta HTTP del origen que inspeccionar. Las herramientas de desarrollo pueden mostrar un error de red en vez de un código de estado normal, porque el fallo ocurrió al establecer la ruta.
Consideraciones sobre HTTP/2 y HTTP/3
RFC 9112 describe los mensajes HTTP/1.1, incluidas las reglas de análisis que protegen los límites entre mensajes. Los navegadores modernos pueden usar HTTP/2 o HTTP/3 hacia un origen después de establecer un túnel, según el soporte del navegador y del proxy. Los conceptos de solicitud son similares, pero cambia la representación en el cable: HTTP/2 usa tramas binarias y pseudo-cabeceras como :method y :authority, mientras HTTP/3 funciona sobre QUIC.
No deduzcas el protocolo usado entre cada par de participantes solo por la URL. Puede haber un protocolo del navegador al proxy y otro del proxy al origen. Un proxy que acepta CONNECT de HTTP/1.1 puede transportar una sesión TLS de HTTP/2 como bytes opacos. Por el contrario, un proxy que entiende HTTP/2 puede representar las solicitudes mediante CONNECT extendido. Al diagnosticar un problema, registra cada salto por separado.
Túneles CONNECT, TLS y resolución de nombres
CONNECT es un método definido para crear un túnel hacia una autoridad de destino. El destino no es una URL arbitraria con una ruta, sino normalmente un host y un puerto, casi siempre el puerto 443 para HTTPS. Cuando el proxy envía una respuesta correcta, deja de procesar mensajes HTTP y reenvía datos en ambas direcciones hasta cerrar la conexión.
Qué puede ver el proxy
En un túnel HTTPS normal, el proxy puede ver la propia solicitud al proxy, incluido el host y el puerto de destino, y observar los metadatos de conexión. No puede leer la ruta HTTP cifrada, las cookies, los valores de autorización ni el cuerpo de respuesta. Aun así puede aplicar una política basada en el destino, limitar puertos, restringir la duración o cerrar el túnel.
La validación del certificado TLS ocurre en el navegador en un túnel de extremo a extremo. El navegador comprueba el nombre, el periodo de validez y la cadena de confianza del host de origen. No interviene un certificado del proxy salvo que el despliegue realice una interceptación TLS de forma intencionada. La interceptación cambia el modelo de confianza y requiere una autoridad certificadora confiable en el perfil del navegador. Debe documentarse y probarse como una arquitectura independiente.
El valor SNI del navegador y otros detalles del handshake TLS pueden revelar el host previsto a un observador de red, según la versión TLS y las funciones de privacidad activas. Un proxy que solo reenvía bytes no elimina esas señales del protocolo. La privacidad de DNS, la privacidad de TLS y el uso de un proxy HTTP están relacionados, pero son controles distintos.
Dónde se realiza el DNS
La resolución de nombres es una fuente frecuente de confusión. Con un proxy HTTP, el navegador puede enviar el nombre de host en la URI absoluta o en la autoridad de CONNECT y dejar que lo resuelva el proxy. Algunas implementaciones resuelven primero de forma local, especialmente al aplicar políticas locales o elegir una familia de direcciones. El comportamiento exacto depende del navegador, del tipo de proxy y de la configuración.
La resolución local significa que el resolvedor local puede conocer el destino aunque la conexión TCP posterior use el proxy. La resolución en el proxy mantiene esa consulta allí, pero no garantiza que todas las solicitudes auxiliares sigan la misma ruta. Las comprobaciones de revocación de certificados, portales cautivos, precarga de DNS, conexiones especulativas y extensiones pueden tener un comportamiento de red independiente.
Cuando importa dónde se realiza el DNS, prueba algo más que la navegación desde la barra de direcciones. Observa un perfil en frío, un proceso nuevo del navegador, redirecciones a otro nombre de host, un iframe, un worker y una búsqueda fallida. La visión general de HTTP en MDN ayuda a separar la semántica HTTP de la planificación de red específica del navegador.
Cabeceras, autenticación y política de reenvío
Las cabeceras HTTP tienen destinatarios distintos en un despliegue con proxy. Algunas describen la solicitud al origen, otras la conexión al proxy y otras las añaden los intermediarios. RFC 9110, sección 5 define las reglas generales de los campos y advierte que los intermediarios deben tratar con cuidado los campos salto a salto.
La autenticación del proxy no es la del origen
Un proxy que requiere credenciales responde con 407 Proxy Authentication Required e incluye Proxy-Authenticate. El cliente responde con Proxy-Authorization. Un origen que requiere credenciales responde con 401 Unauthorized, usa WWW-Authenticate y espera Authorization.
Estos desafíos pueden producirse en momentos distintos. Para una URL HTTP, el desafío del proxy puede llegar antes de que este reenvíe la solicitud. Para una URL HTTPS, suele ocurrir como respuesta a CONNECT, antes de iniciar TLS. El navegador puede reintentar la conexión con credenciales, pero una biblioteca de automatización puede mostrar el desafío como un fallo de navegación si las credenciales del proxy no se configuraron mediante su API compatible.
No coloques credenciales del origen en un campo de credenciales del proxy ni credenciales del proxy en una cabecera Authorization destinada al sitio web. Tienen ámbitos distintos y suelen registrarse en sistemas diferentes. Usa un almacén de credenciales o el mecanismo documentado de configuración del proxy del navegador en vez de construir cabeceras en el JavaScript de la página.
Campos de identidad reenviados
Los intermediarios suelen usar cabeceras como Via, Forwarded y X-Forwarded-For, pero su presencia es una decisión de política. Un proxy puede añadirlas, conservarlas o eliminarlas. Forwarded puede describir la dirección del cliente, el protocolo y el host cuando una solicitud atraviesa intermediarios. Como estos campos pueden contener información de red sensible, las aplicaciones solo deben confiar en ellos cuando procedan de saltos de proxy conocidos.
El navegador no garantiza que el proxy añada una cabecera de reenvío concreta. Si una aplicación depende de la dirección original del cliente, define explícitamente el contrato entre proxy y aplicación. Si no necesita esa dirección, evita aceptar valores de reenvío arbitrarios desde Internet.
Campos salto a salto frente a extremo a extremo
Algunos campos describen una sola conexión y no deben reenviarse sin cambios a través de un proxy. El campo Connection puede designar campos salto a salto en HTTP/1.1. El proxy elimina o consume esos campos antes de reenviar la solicitud. Los campos de extremo a extremo, como Cache-Control, están destinados a viajar hasta el origen y regresar, sujetos al comportamiento normal de los intermediarios.
Esto importa al depurar. Una cabecera visible en las herramientas de desarrollo puede no ser idéntica a la que recibe el origen. Del mismo modo, el proxy puede añadir un campo que la página nunca generó. Captura el intercambio entre navegador y proxy e inspecciona un registro en el origen cuando la diferencia sea importante.
Funciones del navegador que crean solicitudes adicionales
Una carga de página es una secuencia, no una sola solicitud. El documento principal puede activar hojas de estilo, scripts, imágenes, fuentes, marcos, precargas, workers, manifiestos y llamadas a API. Cada URL puede seleccionar un destino y un estado de caché diferentes. Una política de proxy que funciona para el documento puede fallar en el host de una fuente o en un dominio de API.
Las redirecciones son un ejemplo habitual. Una respuesta 301, 302, 303, 307 o 308 puede hacer que el navegador emita una nueva solicitud a otra autoridad. El tratamiento del método y del cuerpo varía según el código de estado y las reglas del navegador. La nueva solicitud sigue usando el proxy configurado, pero puede requerir otra búsqueda DNS, una nueva decisión de autenticación del proxy y un nuevo túnel TLS.
Las cookies también atraviesan los límites entre solicitudes. Una respuesta Set-Cookie de un host puede influir en solicitudes posteriores según las reglas de dominio, ruta, secure y same-site. El proxy puede ver valores de cookies en HTTP sin cifrar, pero no en HTTPS dentro de un túnel. Un registro del proxy que solo anota la primera solicitud no puede explicar todos los cambios de estado posteriores.
Los service workers añaden otra capa. Una vez instalados, pueden satisfacer un fetch desde su caché o generar una solicitud mediante programación. La ausencia de una entrada de red no demuestra que se omitiera el enrutamiento por proxy; puede significar que no hacía falta ninguna solicitud de red. A la inversa, un service worker puede contactar con un host de API que no resulta evidente en el código fuente del documento.
El tráfico no HTTP necesita su propia revisión. Los handshakes de WebSocket comienzan como solicitudes HTTP, pero la conexión se convierte después en un flujo bidireccional de larga duración. Los canales de medios y datos de WebRTC usan ICE y pueden contactar servidores STUN o TURN fuera del HTTP normal de la página. La documentación de la API WebRTC en MDN explica por qué estos flujos deben probarse por separado. Una guía de proxy que solo cubre GET y CONNECT no es un inventario de red completo.
Método práctico de verificación
Una validación fiable compara lo que pretendía el navegador, lo que recibió el proxy y lo que observó el origen. La siguiente secuencia mantiene separadas esas observaciones.
1. Establecer una línea base
Empieza con una conexión directa en un perfil limpio del navegador. Carga una URL HTTP y otra HTTPS, registra la URL final tras las redirecciones y anota el protocolo negociado cuando el navegador lo exponga. Guarda el estado de respuesta, algunas cabeceras de solicitud y la información temporal. No reutilices una caché caliente al comparar cambios del proxy.
2. Probar el handshake del proxy
Usa un registro de acceso del proxy o un endpoint de prueba controlado. Para una URL HTTP, confirma si el proxy recibe absolute-form. Para una URL HTTPS, confirma una solicitud CONNECT con la autoridad esperada y una respuesta de túnel correcta. Un 407 indica que la autenticación del proxy está incompleta. Un rechazo de conexión o un tiempo de espera señala un problema de ruta o de política antes de llegar al origen.
3. Verificar la vista del origen
Haz que el destino registre la dirección de origen, Host, los campos de reenvío, la versión del protocolo y la ruta solicitada. Compara este registro con el del proxy. Cuando la ruta funciona como se espera, el origen debe ver la dirección de salida del proxy. No debe esperarse que vea la dirección local del navegador salvo que un intermediario la reenvíe deliberadamente.
4. Ejercitar el grafo de solicitudes
Prueba una página con una redirección, una imagen de otro origen, una fuente, un iframe, un worker y una llamada fetch. Incluye un nombre de host fallido y un host con registros IPv4 e IPv6. Así podrás comprobar si la resolución de nombres, la selección de familia de direcciones y la autenticación del proxy se comportan de forma coherente más allá del primer documento.
5. Repetir con estado cálido
Repite la misma navegación después de crear cookies, un service worker y entradas de caché. Compara las solicitudes de red con la ejecución en frío. Una solicitud ausente puede indicar un acierto de caché, no un cambio de ruta. Limpia el estado entre experimentos controlados y registra qué estado se utilizó.
Síntomas comunes y su significado
Si las páginas HTTP cargan pero las HTTPS fallan, inspecciona la autorización de CONNECT, la política del puerto de destino y los errores de certificado TLS. Si carga el documento pero falla una llamada a API, revisa el nombre de host de la API, la respuesta CORS y si la gestionó un service worker. Si solo fallan algunos dominios, compara sus registros DNS y las reglas de lista permitida del proxy. Si el origen informa de una dirección de cliente inesperada, inspecciona el tratamiento de Forwarded y X-Forwarded-For en cada intermediario.
Evita considerar una única página externa de «cuál es mi IP» como una prueba completa. Normalmente mide una sola ruta HTTP y puede estar en caché, redirigida o servida por una CDN. Las comprobaciones basadas en estándares, junto con registros de ambos lados, explican mucho mejor el comportamiento del navegador.
Opciones de configuración para solicitudes coherentes
Usa un proxy HTTP cuando necesites una interfaz convencional de proxy de reenvío y el proveedor admita destinos HTTP y HTTPS. Usa una configuración SOCKS cuando el proveedor o la aplicación necesite un relé TCP más general, y confirma cómo se selecciona la resolución del nombre de host. La guía de configuración del proxy documenta las formas de URL específicas de cada protocolo y el tratamiento de credenciales en BotBrowser.
Mantén una única fuente de verdad para la configuración del proxy. Mezclar un proxy de línea de comandos, un objeto de proxy del framework de automatización y la interceptación de solicitudes a nivel de página puede producir rutas en conflicto. Configura las credenciales mediante la interfaz compatible del navegador o del framework y verifica después el comportamiento resultante de 407 y CONNECT con registros.
Haz coincidir la salida geográfica del proxy con las expectativas de la aplicación cuando la ubicación afecte al contenido, pero no supongas que una dirección IP determina todas las señales del navegador. La configuración regional, la zona horaria, el idioma, el DNS, WebRTC y la familia de direcciones pueden ser independientes. Para el comportamiento específico de WebRTC, usa una prueba dedicada basada en la guía de fugas de IP de WebRTC.
Por último, documenta los límites del servicio de proxy. Registra qué protocolos acepta, qué puertos permite, dónde se resuelve el DNS, cómo rotan las credenciales, qué cabeceras añade y cuánto tiempo conserva los registros. Ese contrato operativo convierte un «problema de proxy» impreciso en una ruta de solicitud que se puede probar.
La semántica del proxy HTTP es predecible cuando se identifica cada salto. Lee la forma de la solicitud, distingue 407 de 401, entiende cuándo CONNECT crea un túnel y prueba el grafo completo de solicitudes del navegador. Estos hábitos facilitan la resolución de problemas tanto en la automatización como en la navegación diaria, sin depender de suposiciones sobre lo que hace el proxy entre bastidores.
Fuentes
Artículos Relacionados
Lleva BotBrowser de la investigación a producción
Usa estas guías para entender el modelo y después avanzar hacia validación multiplataforma, contextos aislados y despliegue de navegador preparado para escalar.