Navegador de privacidad vs anti-detección: diferencias
Compara los núcleos de navegador con privacidad primero y los navegadores anti-detección. Descubre cómo la arquitectura, los datos y la transparencia afectan la protección.
Quieres la documentación estructurada de Documentación?
Este artículo forma parte de la biblioteca editorial. Para pasos de configuración, material de referencia y actualizaciones continuas, entra en la sección de docs.
Dos arquitecturas bajo una misma etiqueta
Si has buscado "navegador anti-detección", probablemente quieres mantener separadas varias identidades en línea, cada una con sus propias características de dispositivo, cookies y ajustes de red. El término ya abarca cualquier herramienta que ofrezca perfiles de navegador independientes, y los equipos las usan para gestión de varias cuentas, verificación de anuncios, monitorización de precios, control de calidad e investigación de privacidad.
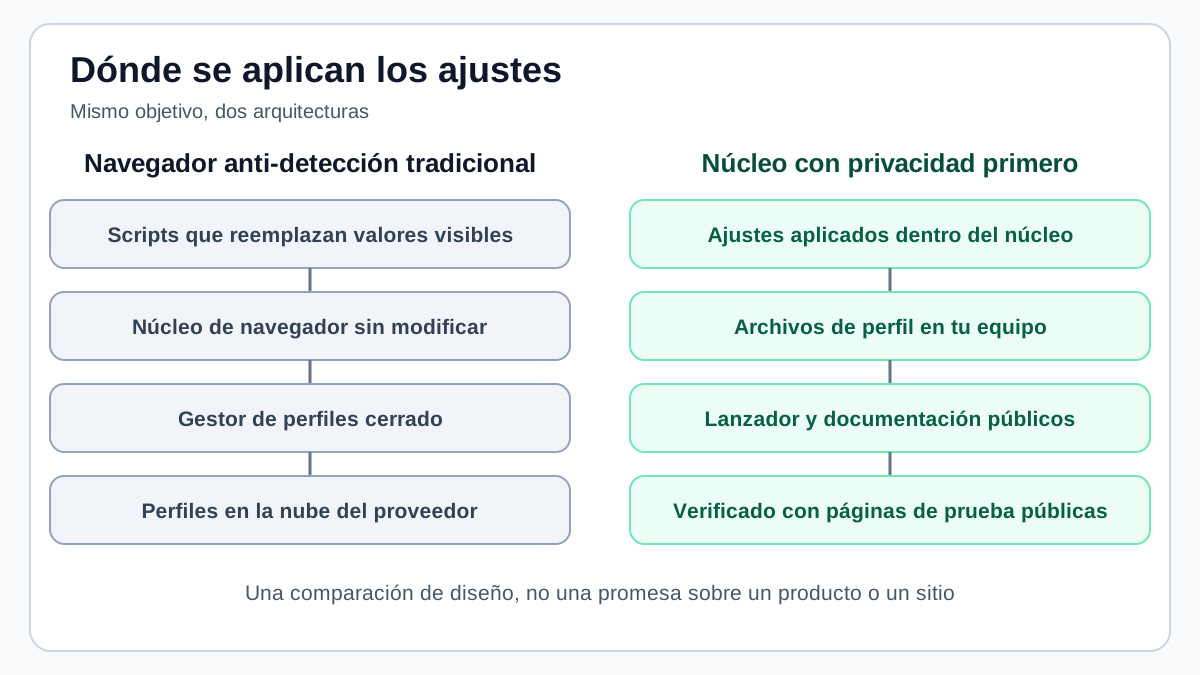
La necesidad es la misma en todos estos usos: cada sesión debe ser coherente por sí sola y no estar conectada con las demás. Las herramientas que la cubren siguen dos arquitecturas distintas. Los navegadores anti-detección tradicionales envuelven un navegador estándar y aplican sus ajustes por encima. Un núcleo de navegador con privacidad primero aplica los ajustes dentro del propio navegador. Esa diferencia afecta a la coherencia del resultado, a dónde viven tus datos, a lo que puedes verificar y a cómo crece el coste.
Las secciones siguientes describen cada arquitectura, las comparan con los mismos criterios y terminan con una declaración clara de lo que BotBrowser cubre para identidades separadas y de cuáles son sus límites. La comparación trata de decisiones de diseño. No afirma que ningún producto concreto falle y no promete cómo tratará un sitio web a un navegador determinado.
Cómo funcionan los navegadores anti-detección tradicionales
La mayoría de los navegadores anti-detección tradicionales comparten una arquitectura. Envuelven un navegador estándar, normalmente Chromium, y cambian lo que ven las páginas mediante alguna combinación de las capas que se describen a continuación.
Sobrescritura de APIs de JavaScript
La capa más común sustituye las APIs del navegador a nivel de JavaScript. Cuando una página lee una propiedad como navigator.hardwareConcurrency o screen.width, el envoltorio responde con el valor guardado en el perfil en lugar del valor que informaría la máquina real.
Las opciones de implementación habituales incluyen:
Object.definePropertypara reemplazar un getter nativo por una función de JavaScript que devuelve el valor del perfil- Métodos de prototipo envueltos, por ejemplo alrededor de
HTMLCanvasElement.prototype.toDataURL - Scripts inyectados antes de que se ejecuten los de la propia página, de modo que los reemplazos ya estén en su sitio
Inyección al estilo de extensión
Algunas herramientas funcionan como extensiones del navegador o usan scripts de contenido similares. Se ejecutan en el contexto de la página y cambian propiedades relacionadas con la huella justo antes o justo después de que cargue. El enfoque es sencillo de distribuir, pero hereda las limitaciones de tiempo y visibilidad de cualquier script que se ejecuta dentro de la página.
Almacenamiento de perfiles en la nube
Las herramientas tradicionales suelen guardar los datos del perfil en los servidores del proveedor, incluidas las cookies, los ajustes de huella y el estado de la sesión. Esto facilita la colaboración, porque los miembros del equipo pueden compartir perfiles y abrirlos desde máquinas distintas.
Envoltorio de código cerrado
El navegador subyacente suele ser una compilación de Chromium sin modificar. La capa propietaria que gestiona los perfiles, las sobrescrituras y la interfaz suele ser de código cerrado, así que los usuarios no pueden inspeccionar cómo se aplica un ajuste concreto.
Dónde llega a sus límites el enfoque tradicional
Estos límites se derivan de la arquitectura. Son propiedades del diseño, no afirmaciones sobre la calidad de un producto en particular.
Las sobrescrituras dejan rastros estructurales
Cuando una propiedad se reemplaza con Object.defineProperty, su descriptor cambia. Un getter nativo muestra [native code] en la salida de toString(), mientras que un reemplazo en JavaScript muestra su propio código fuente. Cualquier script que se ejecute en la página puede leer esa diferencia.
Lo mismo ocurre con los métodos de prototipo envueltos. Los descriptores de propiedades, las cadenas de prototipos, la salida de toString() y la forma de la pila de llamadas son lugares donde un reemplazo puede diferir del original nativo. Una sobrescritura puede coincidir con el valor que devolvería un dispositivo objetivo, pero es más difícil igualar la manera en que ese valor se entrega.
Que un sitio concreto compruebe algo de esto es otra cuestión, y nada de lo anterior garantiza un resultado en ningún sentido. El punto es arquitectónico: una capa situada por encima del núcleo del navegador solo puede imitar el comportamiento nativo, mientras que una capa dentro del núcleo no lo necesita.
La salida de renderizado sigue ligada a la máquina real
La salida de canvas, WebGL y audio depende de la cadena de renderizado de la máquina que la produce. Si un envoltorio informa una plataforma Windows mientras la salida de canvas aún refleja el renderizado de macOS, las dos señales no coinciden.
Una sobrescritura puede interceptar la función que lee la salida, como toDataURL, pero no cambia lo que la cadena de renderizado produjo en realidad. Los píxeles subyacentes, el comportamiento de los shaders y el procesamiento de audio siguen ligados al hardware y al sistema operativo reales.
El almacenamiento en la nube concentra los datos
Guardar perfiles y cookies de sesión en los servidores de un proveedor plantea varias preguntas:
- Ubicación de los datos: las cookies de autenticación y el estado de sesión residen en infraestructura de terceros
- Continuidad: si el proveedor cambia sus condiciones o detiene el servicio, el acceso a tus perfiles puede verse afectado
- Concentración: las sesiones almacenadas de muchos clientes forman un único objetivo valioso
- Cumplimiento: las organizaciones sujetas a normas de protección de datos pueden tener que contabilizar al proveedor como encargado del tratamiento de sesiones de navegador
El código cerrado limita la auditoría
Cuando la capa que aplica los ajustes es cerrada, los usuarios no pueden comprobar:
- Qué datos recopila la herramienta y envía al proveedor
- Cómo se implementa cada ajuste
- Si los ajustes cubren todas las señales que describe el proveedor
- Si el software contiene recopilación de datos que nunca se divulgó
Para las organizaciones preocupadas por la seguridad, no poder auditar la herramienta que maneja sesiones sensibles es una preocupación real. No significa que la herramienta se comporte mal. Significa que te fías de la palabra del proveedor.
El precio por perfil crece con el uso
Muchas herramientas tradicionales cobran por el número de perfiles y de puestos de equipo. Un plan puede incluir un número fijo de perfiles y unos pocos puestos, con extras facturados aparte. El coste crece entonces al mismo ritmo que el uso, algo que importa sobre todo en operaciones grandes.
Qué cambia un núcleo de navegador con privacidad primero
Un núcleo de navegador con privacidad primero aplica los ajustes dentro del propio navegador en lugar de envolver un navegador sin modificar. BotBrowser es un ejemplo. Modifica el código fuente de Chromium para que las señales se produzcan dentro del navegador según un perfil cargado, en lugar de parchearse después con scripts.
Ajustes aplicados dentro del núcleo del navegador
Cuando una página lee una propiedad, el valor procede de la implementación nativa del navegador, configurada por el perfil cargado. No hay ningún reemplazo de JavaScript en medio, así que los descriptores de propiedades, las cadenas de prototipos y la salida de toString() siguen el patrón nativo.
El renderizado funciona igual. Las señales de canvas, WebGL y audio las produce el navegador según el perfil cargado, en lugar de interceptarse a posteriori. Los workers dedicados, compartidos y de servicio creados en un contexto heredan los ajustes de ese contexto, de modo que una página y sus workers describen el mismo dispositivo.
Los perfiles se quedan en tu máquina
BotBrowser se ejecuta en tu propia infraestructura y no necesita un servicio en la nube de BotBrowser durante su funcionamiento. Los archivos de perfil son archivos locales que te pertenecen, y las cookies, el estado de sesión y los ajustes permanecen en sistemas que controlas. La documentación de instalación indica que el navegador puede usar la red para validar y actualizar perfiles, autenticar el proxy y detectar la zona horaria o la configuración regional, así que revisa tus reglas de cortafuegos en lugar de suponer que el navegador está desconectado.
- Ubicación de los datos: todos los datos del navegador permanecen en la infraestructura que elijas
- Continuidad: los perfiles son archivos locales normales, así que no dependen de una cuenta de proveedor
- Menor exposición: no existe un almacén central de sesiones de clientes
- Revisión de cumplimiento más simple: no hay un servicio en la nube de BotBrowser que procese tus sesiones y que tengas que contabilizar
Esto describe dónde guarda BotBrowser sus datos. Tus propios proxies, tus cuentas y los sitios que visitas son flujos de datos distintos que sigues teniendo que gestionar.
Identidades separadas en una instancia del navegador
Muchas configuraciones lanzan una instancia de navegador distinta para cada identidad, lo que cuesta memoria y tiempo de arranque. La función de huella por contexto de BotBrowser, documentada como ENT Tier3, asigna en su lugar un perfil, un proxy, una zona horaria y una configuración regional a cada BrowserContext dentro de una misma instancia. Cada contexto conserva su propio almacenamiento, cookies y estado de sesión, y las páginas de un contexto no pueden leer ni influir en los ajustes de otro.
La asignación debe hacerse antes de crear la primera página de un contexto, y la documentación de aislamiento multicuenta describe la secuencia exacta. Cuando se define un proxy para un contexto, la documentación indica que BotBrowser detecta la dirección de salida y establece la zona horaria, la configuración regional y el idioma de ese contexto, de modo que los tres valores coinciden con la ruta.
Lanzador y documentación públicos
El lanzador, las herramientas de perfiles y la documentación de BotBrowser están publicados en GitHub. Como el navegador se ejecuta en local, puedes inspeccionar su comportamiento con páginas públicas de pruebas de huella y observar su actividad de red con tus propias herramientas de monitorización.
- Salida comprobable: prueba lo que ven las páginas con herramientas públicas en lugar de depender del resumen de un proveedor
- Lanzador inspeccionable: el código fuente del lanzador está disponible en GitHub
- Comportamiento de red observable: captura el tráfico tú mismo para confirmar a qué se conecta el navegador
- Revisión comunitaria: las incidencias y preguntas pasan por el repositorio público
Precio por volumen de perfiles y capacidad
Los planes de BotBrowser se fijan por volumen de perfiles y nivel de capacidad. No cobran por navegador, por puesto ni por lanzamiento, y el uso en ejecución es ilimitado en todos los planes. Existe un plan corto de validación para evaluar, y los volúmenes de perfiles mayores y las funciones de despliegue están en niveles superiores. Consulta la página de precios vigente antes de presupuestar, porque los niveles y límites cambian.
Elegir entre las dos opciones
La tabla resume cómo se diferencian las dos arquitecturas en los puntos que suelen decidir una compra o la elección de una herramienta interna.
| Dimensión | Navegador anti-detección tradicional | Núcleo con privacidad primero (BotBrowser) |
|---|---|---|
| Dónde se aplican los ajustes | Sobrescrituras de JavaScript sobre un navegador estándar | Código fuente de Chromium modificado |
| Descriptores de propiedades | Funciones de JavaScript reemplazan getters nativos | Getters nativos leen los valores del perfil |
| Canvas, WebGL y audio | Intercepción de APIs, el renderizado real no cambia | Producidos por el navegador según el perfil |
| Zona horaria y configuración regional | Depende del proveedor, a menudo se fijan a mano por perfil | Documentadas como derivadas de la dirección de salida del proxy de cada contexto, salvo que las establezcas tú |
| Workers | Pueden requerir un tratamiento aparte | Heredan los ajustes de su contexto |
| Almacenamiento de perfiles | Normalmente la nube del proveedor | Archivos locales que te pertenecen |
| Visibilidad del código | Normalmente un envoltorio cerrado | Lanzador y documentación públicos en GitHub |
| Verificación | Sobre todo declaraciones del proveedor | Páginas de prueba públicas y tu propia monitorización de red |
| Precio | A menudo por perfil y por puesto | Por volumen de perfiles y nivel de capacidad, con uso ilimitado |
| Perfiles multiplataforma | Varía según el proveedor | Documentado: perfiles de Windows, macOS y Android funcionan en equipos Windows, macOS y Linux, y los equipos Linux requieren ENT Tier1 |
| Colaboración en equipo e interfaz gráfica | Normalmente un punto fuerte, con perfiles compartidos en la nube y creación gráfica de perfiles | Los perfiles son archivos locales, así que compartirlos es un proceso tuyo |
| Aislamiento por contexto | Varía según el proveedor | Perfil, proxy, zona horaria y configuración regional independientes por BrowserContext, documentado como ENT Tier3 |
Las herramientas tradicionales pueden bastar cuando
- La gestión básica de varias cuentas es el objetivo y las plataformas implicadas hacen poco análisis de huellas
- La colaboración en equipo, como compartir perfiles y el acceso por roles, es esencial y el almacenamiento en la nube es aceptable
- La sencillez importa más que la profundidad, y un creador de perfiles con interfaz gráfica encaja en tu flujo de trabajo
- El volumen bajo o el uso a corto plazo mantiene manejables los costes por perfil
Un núcleo con privacidad primero encaja mejor cuando
- La coherencia profunda importa, incluidos los descriptores de propiedades, los contextos de workers y la salida de renderizado
- La ubicación de los datos importa y las sesiones, cookies y ajustes deben permanecer en tu propia infraestructura
- La verificación importa y quieres comprobar las afirmaciones con herramientas públicas
- El volumen es alto y el precio por perfil dominaría el coste
- La coherencia multiplataforma es necesaria, por ejemplo sesiones con perfil de Windows en servidores Linux (consulta perfiles de navegador multiplataforma)
- La automatización con Playwright o Puppeteer es un uso principal
- La reproducibilidad importa para pruebas, investigación o integración continua
Investigadores de privacidad y equipos de seguridad
Si tu trabajo consiste en estudiar cómo funciona la recopilación de huellas, probar las defensas de una plataforma que estás autorizado a probar o analizar el comportamiento de rastreo, un núcleo que se ejecuta en local con lanzador y documentación públicos te da control y una forma de comprobar tus propios resultados. El contexto de qué es la huella digital del navegador explica qué señales intervienen.
Una evaluación corta antes de decidir
Un piloto corto enseña más que una tabla de funciones. Anota los flujos de trabajo que te importan antes de empezar, para que el resultado no dependa de la herramienta que mejor parezca el primer día.
- Flujos de trabajo: elige dos o tres tareas reales, como una prueba de calidad contra un sitio de preproducción, una sesión de investigación de privacidad o una revisión autorizada de cuentas, y ejecuta las mismas tareas en cada herramienta
- Aislamiento: abre dos identidades a la vez y confirma que las cookies y el almacenamiento local no se traspasan, ya que Playwright documenta los contextos de navegador como entornos aislados con su propio almacenamiento
- Coherencia: compara lo que informan las páginas de prueba con el dispositivo que el perfil pretende describir, y comprueba que el idioma, la zona horaria y la ubicación del proxy concuerdan entre sí
- Ubicación de los datos: anota dónde se escriben los perfiles, las cookies y los registros, y a qué servidores se conecta la herramienta mientras funciona
- Operaciones: apunta cómo se copian los perfiles, cómo recibe uno un compañero y cómo se comporta la herramienta tras una actualización del navegador
- Coste a tu escala: calcula el plan para el número de perfiles y de personas que esperas tener dentro de un año, no para la prueba
Conserva las notas de cada ejecución. Tras una actualización del navegador o de la herramienta, repetir la misma ejecución corta muestra qué cambió, y las notas permiten a un colega seguir cómo se tomó la decisión.
Qué verificar por tu cuenta
Elijas el tipo de herramienta que elijas, verifica en lugar de fiarte de una lista de funciones:
- Ejecuta páginas públicas de pruebas de huella y compara los resultados con el dispositivo que describe el perfil, como se explica en cómo verificar la huella de un navegador
- Monitoriza el tráfico de red durante una sesión para confirmar con qué servidores se conecta el navegador
- Lee el repositorio público y la documentación para ver qué está documentado y qué no
- Repite las pruebas tras cada actualización del navegador, porque los resultados cambian a medida que cambian los navegadores
Preguntas frecuentes
¿Se puede distinguir un navegador anti-detección de uno estándar? Las sobrescrituras de APIs pueden dejar rastros estructurales, como descriptores de propiedades no nativos, cadenas de prototipos modificadas y discrepancias entre los valores visibles para los scripts y la salida de renderizado. Que un sitio concreto los busque queda fuera del control de cualquiera, así que trátalo como una propiedad del diseño y no como una predicción.
¿Es seguro el almacenamiento de perfiles en la nube? Depende de las prácticas de seguridad del proveedor, que normalmente no puedes auditar. El almacenamiento local elimina la copia de terceros, pero también te hace responsable de proteger la máquina, hacer copias de seguridad de los perfiles y compartirlos de forma segura con tus compañeros.
¿Puedo usar un núcleo con privacidad primero para trabajo con varias cuentas? Sí, para pruebas autorizadas, control de calidad, investigación y gestión autorizada de cuentas. La guía de aislamiento de navegador para varias cuentas muestra cómo los contextos separados mantienen las identidades aparte.
¿Sustituye el almacenamiento local a la higiene de cuentas? No. Los perfiles separados no arreglan contraseñas reutilizadas, correos de recuperación compartidos ni un proxy que usan muchas otras personas.
Qué cubre BotBrowser para identidades separadas
BotBrowser permite asignar un perfil de huella independiente, una configuración de proxy, una zona horaria y una configuración regional a cada BrowserContext dentro de una misma instancia del navegador, y los perfiles se quedan como archivos locales. Para un equipo que hace pruebas o investigación autorizadas, eso significa que las identidades separadas pueden funcionar en paralelo sin que una nube de proveedor guarde los datos de sesión. BotBrowser no puede garantizar que una plataforma acepte, confíe o deje de revisar una cuenta, no sustituye la calidad de tus propios proxies, la higiene de tus credenciales ni tus obligaciones de cumplimiento, y el aislamiento por contexto no está disponible fuera de la licencia ENT Tier3 documentada.
Úsalo para trabajo que estés autorizado a realizar, como control de calidad, investigación de privacidad y operaciones autorizadas con varias cuentas. No es una forma de saltarse las condiciones de una plataforma ni sus políticas de cuentas.
Fuentes públicas
Artículos Relacionados
Lleva BotBrowser de la investigación a producción
Usa estas guías para entender el modelo y después avanzar hacia validación multiplataforma, contextos aislados y despliegue de navegador preparado para escalar.