语音合成语音列表:安全排障指南
处理空语音列表、语言匹配、语音队列和错误,并为用户保留可读文本与明确的重试路径;不要将语音元数据当作个人身份信号。
BotBrowser Team
BotBrowser 的 profile mode 只控制对外暴露的语音元数据,不保证主机能够实际播放语音。
如果浏览器中的语音选择器为空,不要立刻认定 API 不受支持,也不要无限轮询。先读取 getVoices(),再监听 voiceschanged,在限定时间内刷新列表。如果仍然没有合适的语音,就保留可阅读的文字,并提供重试或依据应用语言设置的回退选项。只有在用户明确操作后才开始朗读;每次朗读前,都要从当前列表中重新解析所选语音,并将队列完成、取消和错误视为普通的应用状态。可用语音的元数据可能发生变化,因此它既不是稳定的设备身份,也不是跨操作系统通用的语音目录。
TL;DR
getVoices()在某个时刻可能返回空数组。将其视为加载或可用性状态,并在voiceschanged后刷新;不要假设事件次数或触发时间固定。name、lang、localService、default和voiceURI各自回答不同问题。应依据用户的任务和语言选择语音,而不是依赖假定的操作系统顺序。speak()会把 utterance 加入语音队列。列表刷新不意味着应再次加入同一个 utterance;刷新可选语音后,让用户决定是否开始或重播。- 应由可见的用户操作触发播放,但不要承诺所有浏览器都会显示相同的权限提示或采用相同的激活策略。保留原文和可重试的错误状态。
- 语音列表可能暴露环境上下文,但不能据此识别个人。只收集必要的诊断信息,默认不要传输完整列表。
目录
API 暴露了什么
Web Speech API 将语音发现与语音输出分开。window.speechSynthesis 是控制器:它暴露当前语音列表、一个队列,以及 speak()、cancel()、pause() 和 resume() 等方法。一个 SpeechSynthesisUtterance 保存单次请求的文本和可选设置。应用可以先读取语音元数据,再要求控制器朗读;枚举语音本身不会播放音频。 通过 getVoices() 读取列表时,API 本身没有单独向用户请求权限的步骤;启动音频播放时适用的策略是另一回事。
语音列表依赖具体环境,并非通用目录。浏览器可能接入操作系统语音服务、浏览器管理的服务,或同时使用两者。已安装的语言资源和浏览器自身的选择都会影响暴露的内容。即使在同一台主机上,不同浏览器产品或版本也不必返回相同集合。安装语言包或服务后,设备上的列表也可能改变。因此,不要发布声称每台 Windows、macOS、Linux 或移动设备都有固定数量、品牌、顺序或名称集合的表格。
第一次调用并不是可靠的就绪检查。MDN 说明,getVoices() 返回当前语音合成服务可用的语音,并记录了列表变化时的 voiceschanged 事件。在某些应用环境中,初始列表为空,之后会触发变化事件;另一些环境在首次读取时就有条目。API 没有规定一个通用延迟,保证超过该时间列表就完整。页面应同时处理立即取得列表和稍后刷新两种路径,而不要把某种特定时序说成兼容性保证。
这个表面与隐私有关,因为语音名称、语言覆盖、是否本地服务以及列表变化行为可能为其他浏览器信号补充上下文。若要了解组合浏览器属性这一更广泛的概念,可参阅浏览器指纹简介。某个集合可能具有区分度,并不能证明网站实际使用了它、它能够识别某个人,或某个属性对应特定操作系统。面向用户的语音选择器只需要足够支持选择的信息;常规分析通常不需要完整列表。
逐字段选择规则
语音对象的字段各有用途。实用的选择器不会把这些字段当作可以互换的标识符。
| 字段 | 应用要回答的问题 | 选择规则 | 不应据此推断 |
|---|---|---|---|
lang | 语音对应哪种语言或区域设置? | 将语言标签与应用请求的区域设置比较;优先精确匹配,再按明确规则回退到语言级匹配。 | 标签匹配不保证文本已翻译,也不保证发音符合预期。 |
name | 哪个标签能帮助用户区分选项? | 需要用户选择时显示简短且经过转义的名称;除非支持工作确有需要,否则将其留在本地。 | 类似品牌的名称不能证明操作系统、设备或个人身份。 |
localService | API 是否将该服务描述为本地服务? | 仅当应用有面向用户的理由说明本地与远程服务行为时使用。 | true 不保证网络隐私,也不保证播放成功。 |
default | 实现将哪个语音标记为默认语音? | 用户尚未选择时,在其他条件相当的语音之间用它作次级排序依据。 | 默认语音不一定是应用偏好的语言,也不一定最适合当前文本。 |
voiceURI | 实现是否为语音提供 URI? | 将其视为不透明值;不要持久化,也不要将其用作跨会话键。 | 它不保证全局稳定、可移植,或在该实现以外有意义。 |
这张表用于帮助决策,不是平台签名目录。在某台设备上,name 可能是可读名称;另一个标识则可能完全不透明。应用不应解析名称来推断供应商。localService 按实现描述语音对象,不代表每次语音请求完整经过的服务路径。default 同样只是实现提供的偏好,不是页面的语言协商算法。
从应用真正的需求出发。如果需要朗读西班牙语文本,就从当前列表中选择 lang 与所需西班牙语区域设置尽可能匹配的语音。如果有多个匹配项,可采用用户明确选择,或使用 default 等可预测的次级规则。如果页面只提供朗读按钮而没有语音菜单,可能根本不需要显示或持久化名称。若需了解如何把声明的平台属性放回正确上下文,可参阅 navigator 属性与平台上下文;两类表面都不应当作个人身份键。
不要假设数组顺序稳定,例如“第零个语音就是系统默认项”或“第一条英语语音在所有计算机上都一样”。数组顺序不是可移植的选择约定。刷新也可能得到新数组,因此应用应保存用户可理解的偏好,例如请求的语言或本地选择项,再根据最新对象解析偏好。如果原选择已不存在,应告知用户并提供剩余匹配项,而不是静默选用无关语音。
语音选择器的故障决策树
下面的决策路径可以让应用保持可用,同时避免把临时 API 状态转换为关于浏览器或设备的断言:
- 是否存在
speechSynthesis? 如果不存在,保留可见的文字内容,并说明当前环境无法朗读。不要隐藏或替换文本。 - 现在调用
getVoices()是否有条目? 如果有,就用当前列表呈现选项。如果没有,注册一个voiceschanged监听器,在事件触发时重新读取,并在应用定义的超时后停止等待。不要在每次渲染时都新增监听器。 - 刷新后是否有合适的
lang? 如果有,且用户原来的选择仍然匹配,就保留它。如果已消失,清除过期选择并说明其他选项。如果没有匹配语音,就使用应用明确定义的语言回退或请用户选择;不要根据语音名称猜测语言。 - 用户是否启动了播放? 如果是,使用当前选择创建新的 utterance 并调用
speak()。否则就等待。这样用户仍然控制功能,应用也不需要依赖自动播放假设。 - utterance 发生了什么? 收到
end时,显示空闲或完成状态。发生error时,显示简短且可重试的提示并保留文本。用户明确停止时,取消队列并清除界面中的活动状态。 - 播放过程中列表发生变化了吗? 更新选择器,但不要重复加入正在播放的 utterance。下次重播前,再用最新列表解析偏好。
在限定时间内仍然得到空数组,可能有几种原因:当前上下文可能无法使用语音合成,服务可能没有提供条目,应用可能查找了错误的语言,也可能是初始化尚未按预期完成。这些原因需要不同的用户操作。笼统显示“指纹不匹配”既无帮助,也没有依据。诸如“当前没有可用的法语语音”这样的具体提示更可操作,也不会暴露完整语音列表。
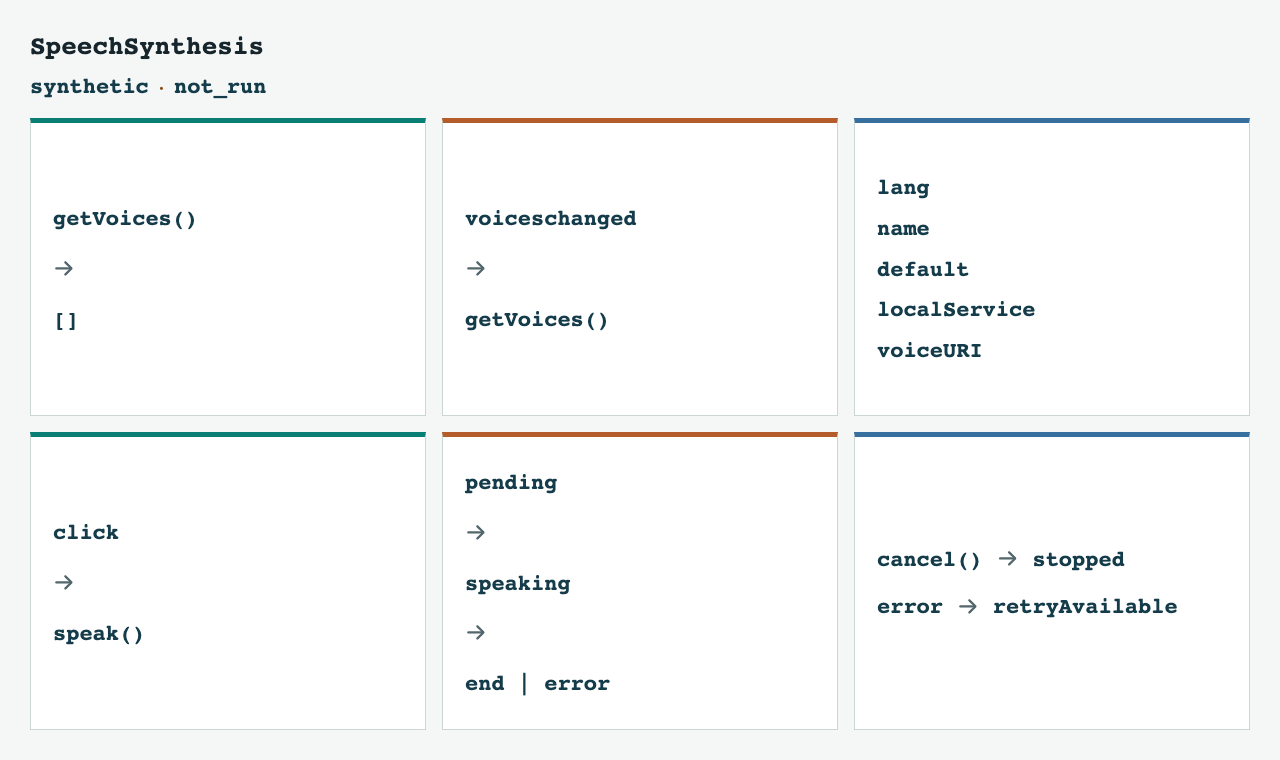
上方的语音选择器故障路径图将这些分支概括为应用的六种状态。它是基于本地 HTML fixture 制作的示意决策图,不是浏览器实测结果。无论列表立即到达、稍后变化还是持续为空,界面都始终保留文字阅读路径。
判断等待何时结束
| 列表仍在加载的证据 | 它能证明什么、不能证明什么 |
|---|---|
首次渲染时 getVoices() 返回空数组 | 本身不能定性;列表是异步填充的 |
voiceschanged 尚未触发 | 不能定性;事件仍可能到来 |
voiceschanged 之后的读取非空 | 列表已可用于选择 |
| 超时到期时列表仍为空 | 等待期间没有出现语音,并不证明一个都没有 |
「还没有」和「完全没有」决定界面显示加载中、重试还是语言提示,而在单次 getVoices() 调用里,两者看起来完全一样。三个问题可以在不猜的前提下把它们分开。
加载时读取一次并保存结果。部分平台上首次渲染返回空数组是正常的,因为列表是异步填充的。把它记为第一次采样而不是结论,并让选择器处于加载状态。
组件生命周期内只绑定一个 voiceschanged 监听器,并在其中重新读取。读取非空,说明列表已可用。与第一次读取完全相同,只能说明事件触发时列表仍为空;平台并没有承诺什么,所以记为「仍为空」,而不是「一个都没有」。
用应用自己的超时为等待设定上限,并把超时当作一种状态而不是故障。超时到期且列表为空时,移除监听器、清掉计时器、停止加载状态,显示语言提示并保持文字可读,同时给出重试。永远等待、或留着过期监听器的页面,把一个平台细节变成了不可用的控件。
const readOnce = () => speechSynthesis.getVoices();
const key = list => list.map(v => `${v.voiceURI}|${v.lang}|${v.name}`).join('\n');
let first = readOnce();
let settled = false;

const settle = new Promise(resolve => {
  const finish = outcome => {
    if (settled) return;
    settled = true;
    clearTimeout(timer);
    speechSynthesis.removeEventListener('voiceschanged', onChange);
    resolve(outcome);
  };
  const timer = setTimeout(() => finish('still-empty'), 2000);
  const onChange = () => {
    const next = readOnce();
    // A change event with the same list proves the event fired, not that the list is final.
    if (next.length) finish('ready');
    else if (key(next) !== key(first)) finish('still-empty');
  };
  speechSynthesis.addEventListener('voiceschanged', onChange);
  if (first.length) finish('ready');
  // If no event arrives, the 2 s timer reports 'still-empty': neither ready nor proven absent.
});
三种结果对应三个不同界面,没有一个是「不支持语音合成」。首次读取非空直接进入选择器。较晚的非空读取经过加载状态后进入选择器。超时到期且读取为空时显示语言提示并保留文字。同一段代码产生这三种结果,所以差别在于平台报告了什么,而不在于设备是什么。
刷新与语音队列状态
voiceschanged 事件表示 getVoices() 返回的列表已经变化。它不是重新朗读的指令,应用也不应假设该事件只触发一次。清晰的刷新流程应根据最新调用替换显示列表、使用后移除一次性监听器,并将用户的语言偏好与某个具体的 SpeechSynthesisVoice 对象分开保存。如果应用支持手动重试,可以调用同一刷新流程,而不是再增加一个事件处理器。
SpeechSynthesis.speak(utterance) 会将 utterance 加入控制器队列。如果界面没有定义处理策略,重复点击或重复触发刷新回调就可能造成重复朗读。产品可以在 utterance 排队或播放时禁用播放按钮,提供单独的“停止”操作,或有意替换当前请求。关键是明确呈现状态转换。仅仅可选语音发生变化,不应产生新的队列项。
以下代码是示意代码,尚未运行。它展示了一次有时限的刷新、区域设置匹配,以及由用户明确操作触发的播放流程。它不保证所有浏览器都会暴露相同语音或在相同情况下接受播放。
此示例仅演示自动语言匹配,不实现用户明确选择语音的保存或恢复。
const synth = window.speechSynthesis;
const requestedLocale = 'en-GB'; // Set from the application's own locale.
let currentVoices = [];
let activeUtterance = null;
let refreshTimer = null;

function refreshVoices() {
  currentVoices = synth.getVoices();
  const exact = currentVoices.filter(voice => voice.lang.toLowerCase() === requestedLocale.toLowerCase());
  const language = requestedLocale.split('-')[0];
  const broader = currentVoices.filter(voice => voice.lang.toLowerCase().split('-')[0] === language.toLowerCase());
  return exact.length ? exact : broader;
}

function waitForVoices(onReady, timeoutMs = 1500) {
  const immediate = refreshVoices();
  if (immediate.length) {
    onReady(immediate);
    return;
  }

  const onChange = () => {
    const matches = refreshVoices();
    if (matches.length) {
      clearTimeout(refreshTimer);
      synth.removeEventListener('voiceschanged', onChange);
      onReady(matches);
    }
  };

  synth.addEventListener('voiceschanged', onChange);
  refreshTimer = setTimeout(() => {
    synth.removeEventListener('voiceschanged', onChange);
    refreshTimer = null;
    onReady(refreshVoices());
  }, timeoutMs);
}

function playFromUserAction(text) {
  const available = refreshVoices();
  const voice = available.find(item => item.default) ?? available[0];
  if (!voice) {
    showReadableRetryState();
    return;
  }

  const utterance = new SpeechSynthesisUtterance(text);
  utterance.lang = voice.lang;
  utterance.voice = voice;

  activeUtterance = utterance;
  utterance.onend = () => {
    activeUtterance = null;
  };
  utterance.onerror = () => {
    activeUtterance = null;
    showReadableRetryState();
  };
  synth.speak(utterance);
}

function stopSpeech() {
  synth.cancel();
  activeUtterance = null;
}
在生产组件中,onReady 应更新语音选择器或用户可见的可用状态,而不是将所有语音序列化到分析系统。示例还假设应用提供了 showReadableRetryState()。真实界面应避免事件处理器在组件卸载后更新它,清理时取消尚未结束的计时器,并定义语音播放期间用户再次发起播放时的行为。这些是常规生命周期决策,无法从语音元数据推导出来。
语言回退与用户操作
语音选择应遵循应用的语言策略,而不是对操作系统作出猜测。根据内容或应用的显式设置取得请求的区域设置。先尝试精确匹配,例如 en-GB。如果产品需求允许,可以使用有明确说明的语言级匹配,例如 en-US。如果只有完全无关的语言可用,不要静默地把它当成等价选项。保留可见文本,让用户选择其他选项或继续使用非语音方式。
lang 值描述语音;utterance 也可以带有语言标签。但二者都不会翻译文本。标记为某种区域设置的语音,仍可能无法正确读出人名、缩写或混合语言句子。必要时,产品应提供已翻译文本,并让语言控件易于理解。WebRTC 编解码器文章也说明,声明支持某项能力不等于用户最终获得了完整体验。
语音输出应在用户有意操作后开始,例如按下“朗读”按钮。这是用户控制和兼容性方面的选择,并不是声称 Web Speech 规范定义了统一的权限对话框。浏览器策略和嵌入上下文可能影响音频能否按预期开始。如果请求没有启动,界面应说明如何重试;不要要求用户授予不存在的 API 权限,也不要宣称点击就一定能听到声音。
用户更改应用语言时,应更新请求的区域设置,并根据当前语音列表重新评估选项。如果菜单打开期间语音列表刷新,只有在原偏好仍能映射到可用选项时才保留它。应用可明确标记回退,例如“由于英式英语不可用,当前使用美式英语”。透明的回退比隐藏在普通播放按钮后的自动切换更容易纠正。
用户选择和辅助功能设置应与分析系统分开。为了下次访问在本地保存选项可能有用,但这不足以成为将整个语音数组发送到服务器的理由。如果服务会把文本发送到远程语音提供方,应分别解释该数据流及其控制方式;localService 单独不能完整审计网络路由。
取消、错误与隐私边界
控制器队列需要明确且可见的状态模型。至少区分不可用、加载中、就绪、已排队或正在播放、已完成、已停止和失败。停止按钮应调用 cancel(),并将界面恢复到可预测的空闲状态;取消是明确的停止,不是重试。图中的 retryAvailable 标签表示应用可以在解释错误后提供另一次尝试,而播放必须等待用户的新操作。取消会移除待处理 utterance,也会中断当前输出,因此共用页面还应考虑某个组件取消了另一个组件发起的语音。应协调队列所有权,不要让每个小组件各自操纵同一个全局队列。
为每个 utterance 绑定完成和错误处理器。完成时可将播放控件恢复到就绪状态。发生错误时,应显示容易理解的信息、保留文本,并提供有意义的重试或替代方式。不要在错误后自动循环调用 speak():重复请求可能堆积在队列中,也会让用户不确定停止操作是否生效。替换 utterance 时,应比较回调所属对象与当前活动请求,忽略旧请求迟到的回调。
Web Speech API 会暴露事件,但应用不应为每次失败承诺唯一原因。失败可能与语音缺失、服务可用性、文本、浏览器上下文或其他平台特性有关。只报告应用确知的情况,例如“语音未能启动”或“没有可匹配的语音”;技术细节留给用户主动选择的支持诊断。不要根据错误或语音名称推断用户身份、已安装软件或所在地。
普通支持诊断可以包含浏览器产品和版本、应用语言、是否存在匹配语音,以及用户可见的错误类别。除非既定支持目的确实需要且用户已同意,否则不要记录完整有序列表、每个 voiceURI、每次列表刷新的精确时间,也不要记录朗读的内容。此类数据只应为声明的个案保留必要时间。隐私边界是数据最小化,而不是掩盖应用的正常状态。
本文不介绍识别个人的方法。它将这些元数据视为可能反映浏览器环境上下文的一处表面,并聚焦于可靠的应用行为。浏览器列表本身不能证明唯一身份,本地的示意 fixture 也不能证明每种操作系统、浏览器版本、语言服务或辅助技术的行为。
本文对配置指南的补充
Speech Synthesis Protection 指南介绍 BotBrowser 的配置文件语音模式和真实系统语音模式、相关配置标志,以及配置文件对齐方面的常见排障内容。默认情况下,--bot-speech-voices=profile 使用配置文件中的语音元数据;--bot-speech-voices=real 使用系统语音,不提供该元数据保护。两种模式都不保证实际发声。它没有提供面向应用的故障决策树来处理初始列表为空、voiceschanged 刷新、过期选择或 utterance 队列。应用层仍需定义逐字段选择规则,并处理语言回退、用户主动播放、取消和错误等界面状态;示例代码未执行,也不声称复现配置文件行为或构成新的产品保证。
排查配置问题时,应分开考虑两个问题:浏览器 API 返回了哪些语音元数据,以及主机能否为目标用户产生可听见的输出。配置文件或配置指南可以说明浏览器声明的表面,而实际播放还取决于应用和主机上下文。枚举成功不等于完成了音频测试。反过来,播放失败也不能证明语音列表有误。
常见问题
第一次调用返回空列表,是否表示不支持语音合成?
不是。这只表示本次调用没有返回语音。列表可能稍后才填充;环境可能不提供语音;API 也可能无法在当前上下文中使用。应在有限时间内监听 voiceschanged,提供重试并保留文本。不要无限等待,也不要根据空结果判断设备类型。
voiceURI 是保存偏好的稳定标识符吗?
应将它视为实现提供的不透明元数据,而不是可移植的账户键。优先保存用户的语言偏好;如有需要,可保存本地显示选择,并在之后与当前列表匹配。如果已保存的语音不再可用,应询问用户是否重新选择,不要静默切换到另一种语言。
localService: true 能证明没有网络服务参与吗?
它只表示实现将该语音对象描述为本地语音。它没有审计所有服务路径,也不能证明整个应用都把文本保留在设备上。应另行说明应用的实际数据流,不要把这个布尔值夸大成全面的隐私保证。
每次收到 voiceschanged 都要重新朗读吗?
不需要。该事件意味着应刷新可选语音,不代表用户有意开始播放。更新选择器,根据当前列表保留或清除偏好,并要求用户另行操作以播放。
来源
- W3C Web Speech API:语音合成、语音对象、utterance、队列方法和事件的规范。
- MDN:SpeechSynthesis:面向浏览器的控制器与方法参考。
- MDN:SpeechSynthesis.getVoices():当前语音列表方法。
- MDN:SpeechSynthesisVoice:语音对象属性。
- MDN:voiceschanged 事件:语音列表变更事件。
- MDN:SpeechSynthesis.speak() 与 cancel():队列行为与取消。
- MDN:SpeechSynthesisUtterance error 事件:utterance 错误事件。
- BotBrowser Speech Synthesis Protection:产品配置和配置文件模式边界。
实践结论
语音列表为空或发生变化,是需要管理的应用状态;它不是识别个人或假定固定平台顺序的依据。通过 voiceschanged 刷新列表,按应用的语言策略从当前元数据中选择语音,由用户明确操作开始播放,并让完成、取消和错误状态清晰可见。保留可阅读文本,只收集满足明确需求所需的诊断字段。产品团队下一步可以在自身支持的浏览器环境中,分别测试立即可用和延迟出现的语音列表,以及一次 utterance 失败;不要声称本文的示意代码或图表已经运行过。
本文属于指南: 什么是浏览器指纹?原理、风险、信号与隐私边界