招聘网站抓取:浏览器边界
围绕 JobPosting 标记、分页、会话状态规划公开招聘列表采集,并在候选人已认证数据前明确停止。
BotBrowser Team
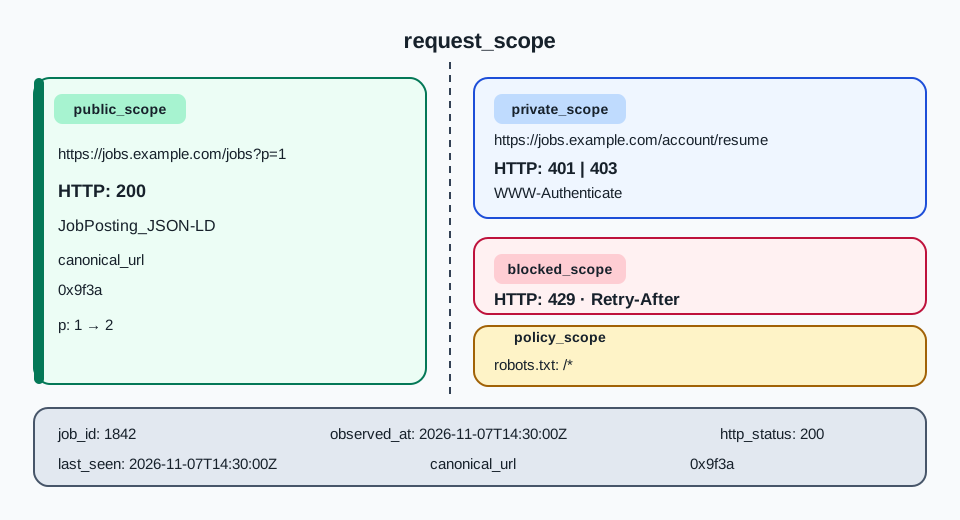
招聘网站抓取主要是一个分页与记录完整性问题,浏览器层只承担其中一部分。真正重要的边界是访问类别:公开列表页可以在运营方授权下请求,而候选人档案、申请历史、招聘方收件箱或与账号绑定的已保存搜索都属于本工作负载之外的私有数据。BotBrowser 提供可从运营方配置启动并返回可见页面结果的可配置浏览器运行时,但不能授予许可、判断某站点条款是否允许采集,也不能移除认证、同意或速率限制闸门。此方案只覆盖公开招聘列表。
TL;DR
- 把每个招聘网站视为三类记录来源:列表卡片、详情页和
JobPostingJSON-LD。用明确的优先级顺序将它们合并为一条记录。 - 将页面就绪定义为可见的结果容器加稳定的卡片数量,而不是固定休眠或全局网络空闲事件。
- 在首次观察时就带上
job_id、canonical_url、datePosted、validThrough、hiringOrganization和jobLocation,不要事后再重建。 - 在第一次请求前把每个 URL 归类为公开列表或已认证数据;当响应跨入第二类时停止运行。
- 将 429、
robots.txt规则、同意插页和 401 归因到不同层。它们都不是浏览器需要更换配置文件的证据。
目录
将列表工作负载映射到浏览器职责
招聘网站的一次运行从查询 URL 开始,例如 https://jobs.example.com/jobs?q=analyst&p=1 ,沿着站点提供的分页链接前进,并为每条职位打开一个详情页。每页 40 张卡片、共 12 个列表页时,预期上限是 480 个详情页,但这个数字从不由浏览器决定。运营方固定查询、允许的页范围和停止规则;浏览器创建上下文、导航、等待约定信号,并读取它收到的页面。
职责分离可以防止一种常见的错误结论。调度器负责重试、队列顺序和并发。存储层负责规范化与去重。浏览器负责导航、渲染、就绪判断,以及提取页面所暴露的内容。当详情页返回的卡片缺少标题时,缺失字段属于提取或标记问题,除非状态码或插页证明另有原因。
招聘网站页面重复度很高:一个模板服务数千条职位,筛选条件放在查询字符串里,详情布局在不同职位之间很少变化。因此单页成本主要来自导航、就绪等待和解析工作,而不是每页重新学习布局。这种形态有利于固定的选择器契约和固定的字段契约,也会惩罚为每条职位临时编写选择器的做法。
从列表页到详情页的同类数量换算也出现在SERP 抓取负载规划中,该文在选择采集目标前把浏览器阶段与响应等待分开。
先读结构化职位数据,再读可见卡片
许多站点以 JSON-LD 发布 Schema.org JobPosting 标记。该节点通常位于 <script type="application/ld+json"> 块中,有时嵌套在 @graph 数组里,有时分散在同一页面的多个块中。读取每个块,把解析失败保留为计数字段,并选择 @type 为 JobPosting 或包含该值的数组的节点。
| 字段 | 典型形态 | 存储为 | 需记录的失败 |
|---|---|---|---|
@type | "JobPosting" 或数组 | node_type | 页面有卡片但没有职位节点 |
datePosted | 形如 2026-11-03 的 ISO 8601 日期 | date_posted | 只有 "3 days ago" 之类的相对文本 |
validThrough | ISO 8601 日期或日期时间 | valid_through | 长期招聘职位缺少该字段 |
hiringOrganization.name | Organization.name 字符串 | employer_name | 雇主显示为 "Confidential" |
jobLocation.address.addressLocality | 嵌套的 PostalAddress | location_city | 远程职位没有地址 |
identifier | 字符串或 PropertyValue | source_job_id | 标识符在不同渲染之间变化 |
同一字段可能出现在三个位置且取值不同:列表卡片、详情 DOM 和 JSON-LD 节点。记录每个字段由哪个来源提供,而不是让后一轮处理静默覆盖前一轮。一种可行的优先级是结构化数据优先、内嵌页面状态次之、可见 DOM 最后,并把选中的来源存为 field_source。
const raw = await page.locator('script[type="application/ld+json"]').allTextContents();
const errors = [];
const nodes = raw.flatMap(text => {
  try {
    const doc = JSON.parse(text);
    return Array.isArray(doc['@graph']) ? doc['@graph'] : [doc];
  } catch (error) {
    errors.push(String(error));
    return [];
  }
});
const postings = nodes.filter(node => [].concat(node['@type'] ?? []).includes('JobPosting'));
这段代码返回职位节点,并让解析错误保持可见。它不假定站点一定发布结构化数据;只渲染卡片的站点仍然需要 DOM 契约,而在首次绘制后才注入标记的站点仍然需要下文的就绪规则。
根据页面定义分页,而不是猜测 URL
站点表达分页的方式至少有五种,差异会改变运行判断结束的方式。记录产生每个页面的 URL、页索引,以及页面自身声明的下一页链接。
| 模式 | 示例 | 检测方式 | 主要风险 |
|---|---|---|---|
| 页码 | ?page=2 | 查询参数 | 站点限制或忽略深层页面 |
| 短页码 | ?p=2 | 查询参数 | 同一参数名在另一站点含义不同 |
| 偏移量 | ?start=25 | 带页大小的查询参数 | 偏移量按错误页大小推导 |
| 游标 | ?after=eyJpZCI6MTg0Mn0 | 来自上一页的不透明令牌 | 复用过期游标 |
| 链接关系 | <link rel="next" href="..."> | DOM 属性 | 某些模板缺失 |
当页面不再声明下一页链接、结果容器存在但为空、首尾卡片键重复了更早页面,或已访问 URL 集合已包含下一个目标时停止。把 "1 of 12" 控件给出的页数当作提示而非保证:筛选变化、个性化以及过期职位都可能改变两次请求之间的总数。
有两个守卫从第一次运行起就应放入循环。维护规范化页面 URL 的集合并拒绝重复。为每页用首尾卡片键构建签名;相邻页面签名相同,通常说明站点把页码截断到了同一页,而不是返回了新结果。
设置与提取相匹配的就绪条件
导航事件只能证明文档到达,不能证明列表可用。DOMContentLoaded 可能在卡片渲染前触发,全局网络空闲等待又可能被广告、分析脚本或长轮询请求拖住。使用与提取器所读元素绑定的条件。
| 就绪信号 | 能证明什么 | 会遗漏什么 |
|---|---|---|
domcontentloaded 事件 | HTML 已解析 | 客户端渲染的卡片 |
| 列表容器可见 | 模板已挂载 | 卡片仍在陆续到达 |
| 两次检查间卡片数稳定 | 列表已稳定 | 延迟注入的 JSON-LD |
JobPosting 节点存在 | 详情结构化数据已解析 | 没有标记的站点 |
| 下一页控件可交互 | 分页可操作 | 服务端页码截断 |
实用规则是一个合取条件:结果容器可见,卡片数量等于页面报告的数量,且每张卡片都有非空的详情链接。对详情页,在提取开始前还要有已解析的 JobPosting 节点或明确的“无结构化数据”标记。把就绪事件的时间戳与请求开始时间分开记录,以便后续复核计算等待时长。
会话状态属于同一份契约。有些站点把筛选放在 URL 中,对新上下文返回同一列表。另一些站点把排序、位置半径或页游标放在 cookie 或本地存储中,于是新上下文从第一页重新开始,而 URL 仍写着第八页。先确定适用哪种行为,然后在一次运行中复用同一上下文,或从 URL 重建筛选状态。每次运行使用专用上下文还能防止存储在不相关的采集任务之间泄漏;多账号浏览器隔离说明了多个获授权工作负载共用一台主机时,按上下文划分存储与身份设置的方式。
如果运行在分页中途丢失路线,不要重启整个爬取。网络中断后的会话恢复指南说明了如何区分连接中断与页面过期,以及如何在不重复已完成页面的情况下继续。
划定公开与已认证数据的边界
URL 的访问类别属于站点和运营方授权,而不属于浏览器构建。公开搜索结果、公开详情页以及无需会话即可访问的公司招聘页属于一类。候选人档案、申请状态页、招聘方消息线程、与账号绑定的已保存搜索,以及接收简历的申请表单属于另一类。本工作负载只请求第一类。
这条公开数据边界与网页数据采集的浏览器指纹保护所维持的边界一致:浏览器信号可以为经授权的工作流变得可重复,但不能把已认证页面变成公开数据。
| URL 或响应类别 | 示例路径 | 预期响应 | 是否在范围内 | 处理方式 |
|---|---|---|---|---|
| 公开搜索 | /jobs?q=analyst&p=2 | 200 且带结果卡片 | 是 | 在约定页范围内请求 |
| 公开详情 | /jobs/1842 | 200 且带职位标记 | 是 | 提取并记录 |
| 公开公司页 | /careers/acme | 200 且无需会话 | 是,若获允许 | 视为另一列表来源 |
| 登录表单 | /login | 200 且带登录表单 | 否 | 排除该路径 |
| 候选人档案 | /account/profile | 401 或 403,或仅带会话时 200 | 否 | 停止并排除 |
| 申请历史 | /account/applications | 会话范围内的 200 | 否 | 停止并排除 |
| 招聘方收件箱 | /employer/messages | 会话范围内的 200 | 否 | 停止并排除 |
| 简历上传 | /apply/1842/upload | 接收个人文件的表单 | 否 | 停止并排除 |
在第一次导航前应用该表。URL 允许列表比阻止列表更容易审计,因为站点新增的账号路由无法静默进入运行。每个条目都应带有运营方审批依据、检查日期和分配的页面类别。
认证边界的识别规则
最清晰的信号是带 WWW-Authenticate 头的 HTTP 401,但真实站点也会重定向到 /login、对受保护路由返回 403,或返回一个内容只有登录提示的 200 页面。仅候选人可见的导航项、账号头像,或打开简历表单的“申请”控件,即使状态码是 200,也是边界标记。
出现上述任一情况时,停止该 URL,把类别记为 authenticated,并将其排除在公开列表完整性的分母之外。绝不提供凭据、重放从他人会话复制的 cookie、完成挑战,或继续通过要求候选人数据的页面。正确的输出是带原因的排除,而不是部分填充的记录。
同意、robots 与速率限制是彼此独立的闸门
同意插页是一道政策闸门。横幅可能在做出选择前遮住列表,而可用选项会因地区和会话是否存在而不同。把 consent_state 记录为 present、required 或 absent,捕获 URL,并把决定交给运营方。脚本化点击接受不属于公开列表提取方案的一部分,因为该选择属于访问者,而不属于采集方。
Robots 排除协议规定了站点如何发布爬取规则,包括按 user-agent 令牌选择分组。获取 robots.txt,记录响应状态与适用于所声明客户端的规则,并排除被禁止的路径。选择其他 user-agent 令牌以落入更宽松的分组是政策规避,而不是浏览器要求。
带 Retry-After 的 429 响应属于速率限制,其语义与其他状态码一起定义在 RFC 9110 中。遵守时间窗口、缩小请求范围,或向站点所有者申请 API。在窗口内轮换路线或配置文件以继续请求,改变的是谁收到请求,而不是请求是否被允许。503 是服务状况;将其视为可用性失败,仅在运营方约定的策略下重试。
失败归因矩阵
下表防止把受阻响应误读为浏览器缺陷。每一行指明产生该观察的层,以及下一步获准采取的动作。
| 观察 | 负责的层 | 不能证明什么 | 下一步动作 |
|---|---|---|---|
200 但容器中无卡片 | 渲染、选择器契约或空结果 | 站点阻止了浏览器 | 检查就绪、选择器与查询状态;记录 empty_result |
200 且出现同意对话框 | 同意政策 | 页面不可用 | 记录 consent_gate 并停止,等待运营方决定 |
401 加 WWW-Authenticate | 认证 | 另一个配置文件会被授权 | 排除该 URL |
候选人路由上的 403 | 授权 | 该路由是公开的但配置错误 | 排除该 URL |
重定向到 /login | 认证 | 网络或区域设置问题 | 排除该 URL |
429 加 Retry-After | 速率限制 | 浏览器身份有误 | 遵守窗口或缩小范围 |
路径列在 robots.txt 中 | 站点爬取政策 | HTML 已损坏 | 排除该路径 |
| 结果被挑战页面替代 | 访问控制 | 某个渲染选项可以移除它 | 停止;不要自动化该挑战 |
| 导航超时 | 网络、主机或页面体积 | 站点拒绝了请求 | 记录阶段并复查路由 |
200 但结果少于一页 | 分页结束或筛选收窄 | 运行已完成该查询 | 比较首页签名与查询 |
浏览器配置文件、代理路线或不同的区域设置会改变服务器观察到的东西。这些都不会产生许可、满足 robots 规则、代表访问者接受同意选择,或把 403 变成授权。采集是否获准取决于站点所有者、适用条款和法律,浏览器层只能处于该决定之内或之外。
网络路由是另一个配置面。浏览器代理配置指南说明了路线选择、凭据处理和 DNS 行为;它也明确路线不能验证目标站点的政策。使用运营方获授权使用的路线,并在比较提取行为时保持路线固定。
衡量完整性并归因失败
对本工作负载有用的测量问题是:在一组获允许的公开列表 URL 上,发现了多少职位、多少必填字段被填充,以及失败分别来自哪一层。这个问题有可辩护的分母。以登录页或限流响应为基准测出的“成功率”则没有。
在第一次运行前冻结输入。fixture 应列出查询 URL、预期页范围、就绪契约和选择器契约,并在旁边保留审批依据。如果站点更改模板,fixture 应作为新版本变更,而不是就地编辑,这样新旧结果仍可比较。
记录结构
每条观察到的职位存一条记录,每个页面存一条记录。页面记录携带状态、计时和数量。职位记录携带身份和字段来源,如下例所示,其取值为示意值。
{
  "job_id": "1842",
  "canonical_url": "https://jobs.example.com/jobs/1842",
  "page_url": "https://jobs.example.com/jobs?q=analyst&p=2",
  "http_status": 200,
  "observed_at": "2026-11-07T14:30:00Z",
  "date_posted": "2026-11-03",
  "valid_through": "2026-12-01",
  "employer_name": "Example Analytics",
  "location_city": "Toronto",
  "field_source": "jsonld",
  "etag": "W/\"abc123\"",
  "content_hash": "9f2c1d7a4b8e0c31"
}
站点自身的标识符稳定时,把 job_id 保留为该标识符。canonical_url 保留为页面声明的地址,而不是引导到它的分页 URL。保留 page_url,以便把重复项追溯到产生它的列表页。存储 etag 与 content_hash 以检测未变化的详情页,并避免重写相同记录。
用已声明的键合并重复项
同一条职位常常同时出现在站点搜索页、公司页、区域镜像和聚合器上。职位标识符存在时是最强的键,但重新发布的职位可能获得新标识符,同时保留相同的雇主、标题、城市和描述。
| 候选键 | 稳定性 | 冲突风险 | 适用条件 |
|---|---|---|---|
source_job_id 加站点主机 | 职位存续期间高 | 删除后同一 id 被复用 | 站点发布稳定 id |
canonical_url | 高 | 同一职位有两个 URL | 存在规范链接 |
雇主、标题、城市、date_posted | 中 | 同一天开启同一职位两次 | 缺少 id 和规范 URL |
| 雇主、标题、城市、描述哈希 | 中 | 不同团队使用相同模板文本 | 描述有实质内容 |
| 仅标题与城市 | 低 | 许多真实职位共享标题 | 从不使用,仅作复核提示 |
按可用的最强键合并,然后把较弱的匹配保留为 variant_urls,而不是删除它们。合并后的记录应保留贡献过的每个 URL、首末观察时间,以及为每个字段提供值的来源。
重复项决策矩阵
| 情形 | 是否合并 | 原因 |
|---|---|---|
相同 canonical_url,不同 page_url | 是 | 同一职位经两个列表页到达 |
雇主、标题、城市和 date_posted 相同;job_id 不同 | 是,保留变体 | 很可能是同一职位被分发两次 |
| 雇主和标题相同,城市不同 | 否 | 地点是职位的一部分 |
雇主、标题和城市相同,date_posted 相隔超过 30 天 | 否,除非描述哈希相同 | 较晚开启的可能是真正的新职位 |
valid_through 已过但页面仍返回 200 | 保留,标记 expired | 页面未按计划移除 |
| 聚合器副本与公司招聘页 | 两者均获授权时合并到公司记录 | 源页面是更好的规范目标 |
| 重定向链终止于新的规范 URL | 合并并存储该链 | 旧 URL 不再标识该职位 |
运行计划与计时标记
下面的计划使用站点契约对象,使选择器和就绪规则集中命名。名称是示意性的;应替换为针对获允许站点约定的契约。
const contract = {
  list: "[data-testid='job-card']",
  detailLink: "a[data-testid='job-link']",
  next: "a[rel='next']",
};

const started = performance.now();
const response = await page.goto(listUrl, { waitUntil: 'domcontentloaded' });
await page.locator(contract.list).first().waitFor({ state: 'visible' });
const cards = page.locator(contract.list);
const count = await cards.count();
await page.waitForTimeout(250);
const stabled = await cards.count();
if (count !== stabled) throw new Error('card count changed before extraction');
const links = await cards.locator(contract.detailLink).evaluateAll(nodes => nodes.map(node => node.href));
把 request_start、response_received、ready_signal 和 extract_done 记录为独立时间戳。就绪等待计算为 ready_signal - request_start,提取时间计算为 extract_done - ready_signal。如果运行只报告页面的一个总时长,缓慢的选择器与缓慢的服务器就无法区分。性能优化文档介绍现有部署的运行时调优;上述标记描述了该调优应对照什么进行比较。
对同一 fixture 重复三次,并报告每个阶段的最小值、中位数和最大值,而不是最佳一次。把失败页面保留在分母中。在就绪前超时的页面应计为带阶段失败的尝试页面,而不是缺失的职位。
完整性与字段覆盖率
完整性比较已发现的职位与获允许查询报告的职位。如果第一页在 40 条每页时显示 480 条结果,而运行合并后提取到 462 条唯一职位,则报告 462 / 480,并附上重复计数和排除计数。不要通过合并不相关职位来悄悄抬高分子,也不要通过丢弃失败页面来降低分母。
字段覆盖率是按字段分别计算的比率。报告 date_posted 在 462 条记录中有 440 条存在,valid_through 有 301 条,jobLocation 有 455 条。站点可能分页完整但字段覆盖率差,也可能相反。这两个数字回答不同问题,单一“成功”数字会掩盖是哪一项失败。
归因决策矩阵
| 记录中的模式 | 需核对的理解 | 下一次测量 |
|---|---|---|
| 有卡片,但每个详情页都缺少 JSON-LD | 站点可能不发布标记 | 在更改提取前先确认第二个模板版本 |
状态保持 200 而就绪等待变长 | 客户端渲染或脚本体积变化 | 在同一 fixture 版本上比较就绪时间戳 |
查询未变而 200 页面数量减少 | 分页上限或筛选状态 | 复查第一页与下一页链接链 |
429 只在更高并发时出现 | 请求速率超过站点限制 | 降低并发或申请 API |
403 只出现在账号路径 | 到达认证边界 | 排除该路径并复核允许列表 |
| 模板变更后重复率上升 | 新的 URL 或 id 模式 | 跨版本比较合并键 |
| 字段覆盖率下降但卡片数量不变 | 标记或选择器漂移 | 按字段比较 field_source |
运行前清单
- 每个种子 URL 都是公开列表或公开详情页,并带有审批依据。
- 账号、申请、简历、消息和已保存搜索路由已通过允许列表排除。
- 已获取
robots.txt并记录适用规则。 - 就绪条件写为可见元素加稳定计数。
- 分页停止规则包含已访问 URL 和重复页签名。
- 合并键与较弱的回退键在提取前已声明。
- 页面级状态、计时和数量与职位记录一同存储。
- 失败和排除页面以原因代码保留在分母中。
- 运行在
401、403、同意闸门、挑战页面或429时停止。 - 运行记录写明浏览器构建、所用路线和 fixture 版本。
FAQ
JobPosting JSON-LD 足以识别每一条职位吗?
不够。覆盖率因站点和模板而异,有些页面从内部状态对象渲染卡片,完全没有结构化数据块。把 JSON-LD 作为首选来源,保留 DOM 契约作为回退,并存储 field_source,使覆盖率下降可见。有卡片但没有职位节点的页面是标记层面的观察,不是访问失败。
分页应在第一个空页停止吗?
先停止,再验证。空容器可能意味着查询已耗尽、筛选收窄了集合,或页码被截断。在把运行记录为完成前,比较页面签名、声明的总数和下一页链接。单个空页是请求的停止条件,不是查询没有返回任何内容的证据。
浏览器配置文件决定采集是否获准吗?
不决定。许可来自站点所有者、适用条款和法律。配置文件改变可观察的浏览器信号,代理改变路线,但两者都不能满足 robots 规则、同意选择或速率限制。访问类别表与失败矩阵是决策面;浏览器配置处于该决定的下游。
实践结论
先把每个 URL 归类为公开列表或已认证数据,并在任何请求之前移除第二类。然后把就绪信号、分页停止规则和合并键定义为一组书面契约。分别衡量完整性和字段覆盖率,并把每个失败归因到产生它的状态、政策或渲染层。
下一步很小:为一个获允许的公开招聘网站查询写出允许列表和审批依据,然后确认第一页返回 200,并带有 JobPosting 节点或约定的 DOM 契约。运行中的其他一切都取决于该边界是否成立。
来源
本文属于指南: 浏览器部署与发布:运维决策地图