浏览器内核与 JavaScript 覆盖:指纹一致性对比
按各自控制的层面比较浏览器扩展、注入脚本和浏览器自身的改动,并学会自己验证指纹是否一致。
BotBrowser Team
BotBrowser 可以在受控浏览器上下文中应用所选配置,但不能决定第三方站点如何评估会话,也不能代替对所选设置的验证。
TL;DR
- 扩展和注入脚本主要修改 JavaScript 可见的值。
- 在浏览器内应用的配置可以协调请求、渲染和执行上下文中的值。
- 下结论前,分别检查页面、Worker、渲染输出和首个请求中的同一信号。
目录
防护工具控制的是哪一层
指纹防护工具之间的差别,与其说在于承诺了什么,不如说在于它们运行在哪里。浏览器有多个层面:发出第一个请求的网络代码,生成像素和音频样本的渲染与音频管线,页面读取的 JavaScript API 表面,以及各自拥有这套表面副本的独立执行上下文(框架、专用 Worker、共享 Worker 和 Service Worker)。工具只能让它所控制的层面及其以下的内容保持一致。BotBrowser 可以在受控上下文中于页面脚本运行前应用所选配置,但不能改变站点、网络标准或其他浏览器的行为。
目前常见的架构有三种:
- 浏览器扩展:在页面中运行内容脚本,并在页面开始加载之后覆盖 JavaScript 属性
- 注入脚本:通常以 Puppeteer、Playwright 等自动化框架的插件形式提供,在每个新文档中先于页面脚本运行
- 修改浏览器自身编译后的代码:加载的配置文件在任何页面脚本出现之前就设定好各项数值
这三种并不是同一个想法的三个版本。每一种的作用范围不同,而作用范围决定了三个实际结果:主框架、iframe 和 Worker 之间的数值是否一致;渲染输出和请求头是否与 JavaScript 数值一致;以及每个新的浏览器版本或新的指纹技术会给你带来多少维护工作。
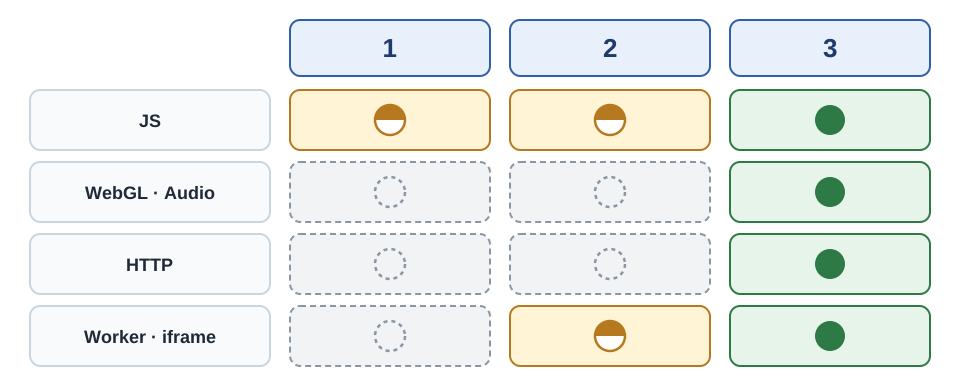
第 1 到第 3 列对应上面的编号列表。实心绿色圆表示数值来自配置文件,半填充的琥珀色圆表示由脚本修改数值,虚线圆环表示在没有其他手段改变它时会保留设备的真实值。最后一行中注入脚本的半圆表示框架被覆盖,而 Worker 视情况而定。虚线圆环并不表示这种方式没有用,下面的章节会解释每一行为什么重要。
一个具体的例子更容易说明问题。假设页面在主框架中读取平台值,然后打开一个 iframe 和一个专用 Worker 并在其中读取同一个值,同时服务器也记录首个请求中的平台提示。这样,同一个事实就有了四次读取。只控制 JavaScript 层的工具可以让其中一部分保持一致,但只有当每条路径恰好都收到覆盖时,四处才会全部一致。如果工具只设定一次数值,来自同一个配置文件,并且发生在这些路径出现之前,就不必再逐条路径分别打补丁。
为什么部分防护本身会变成一种信号
不完整的防护可能让访问者比完全没有防护时更容易被区分出来。 同一逻辑也说明为什么托管管道是另一种工具而不是更好的工具:解锁服务与自有浏览器的对比 把部分保护的问题留在你这一侧。当一部分数值被修改而另一部分没有时,结果就会出现矛盾。一个浏览器在平台字符串中声明了一种操作系统,但字体和文本渲染却与另一种操作系统吻合,这比未经修改的浏览器更少见,因为很少有真实设备会呈现这种组合。测试可以同时检查 Object.getOwnPropertyDescriptor(Navigator.prototype, "platform") 和渲染字体结果,把两类信号分开记录。
工具自身留下的痕迹也是如此。被脚本定义的 getter 替换过的属性,在读取其源码文本时,函数体与浏览器内置 getter 不同。被包装过的原型方法也可能表现出同样的差异。
W3C 关于在 Web 规范中缓解指纹识别的指南说明了为什么指纹难以清除或重置,这正是一致性比修改数值的数量更重要的原因。对隐私工程师或自动化工程师来说,实际问题不是工具有没有改某个值,而是之后所有能读取该值的位置是否一致,包括工具可能根本看不到的位置。
扩展和注入脚本能触及什么
两种基于脚本的方式都通过 JavaScript 层工作,因此它们的优势和局限来自同一个来源。下面的各点说明这一层能改变什么、不能改变什么。
浏览器扩展。 扩展使用 WebExtensions API,它允许内容脚本在文档开始时于页面中运行。典型的指纹扩展会替换 hardwareConcurrency 和屏幕尺寸等属性的定义,并包装读取 Canvas 和音频数据的方法,使其结果发生变化。
属性描述符。 用脚本定义的 getter 替换内置属性,会改变它的属性描述符。输出该 getter 的源码文本时,看到的是普通的 JavaScript,而不是 [native code],页面中运行的任何脚本都可以做这项检查。
原型链。 被包装的原型方法同样是普通函数。通过同类的源码文本比较,就能把它们与浏览器的内置代码区分开,所以包装对原函数的隐藏程度,只取决于包装器模仿得有多像。
新建上下文。 扩展未必会在每个执行上下文中运行它的覆盖。页面创建的 iframe、专用 Worker、共享 Worker 和 Service Worker 各自有独立的全局对象,MDN 将它们记录为彼此分离的作用域。如果覆盖到达了主框架却没有到达某个 Worker,同一个属性在同一个会话中就会返回两个不同的值,页面能看到这个不一致。
渲染输出。 扩展可以包装读取 Canvas 像素或音频样本的方法,但像素和样本是由浏览器的图形与音频管线产生的。任何通过包装器未覆盖的路径读取真实输出的代码,看到的都是设备的真实值,而只给 API 结果添加噪声的包装器,不会改变底层输出。
网络层。 扩展脚本在第一个请求发出之后才运行。像平台提示这样的 Client Hints 请求头,在内容脚本能够动作之前就已附加到请求上,而 TLS 参数更是任何页面脚本都无法改变的。
注入脚本。 自动化框架的插件改进了扩展的做法。框架会注册一个脚本,在每个新文档中先于页面脚本运行,这就缩小了时间差,并覆盖页面创建的框架。这些插件还会覆盖更多数值,并修改 toString(),让被替换的函数看起来像内置代码。
仍然存在的问题。 剩下的局限是结构性的。Worker 是否被覆盖,取决于框架会不会向 Worker 作用域注入。渲染层和网络层保持原样。每个数值都是独立的补丁,因此要让它们彼此一致,例如所声称的 GPU 与真实的光栅化输出相符,就要依赖作者的人工细心。被修改过的 toString() 也只是又一个可以被检查的覆盖。
Service Worker 还会带来额外的麻烦。它们会在页面加载之间持续存在,并且可能比注册它们的页面存活得更久,因此为某次导航安装的覆盖,在稍后 Service Worker 启动时可能并不存在。基于脚本的方式必须在这些作用域出现时逐一找到并打补丁,而遗漏的作用域会表现为同一属性有两个值。
更好的脚本可以缩小这些局限,但无法消除,因为脚本运行在相关层面之上。这是架构本身的属性,不是靠更仔细的编码就能补上的缺口。同时,维护量会随着你打补丁的数值数量而增长:每个新的浏览器版本或指纹技术都可能需要新补丁,而每个补丁都是又一个必须看起来像内置的函数。
配置文件在浏览器内应用后有什么不同
当数值是在浏览器自身的代码中设定,而不是在已经构建好的页面上打补丁时,就没有可以被发现的覆盖。BotBrowser 加载从真实浏览器会话中捕获的配置文件,并在页面脚本运行之前应用它。它的 navigator 文档描述了结果:navigator 的值在 JavaScript、HTTP 头和 Worker 上下文之间保持一致。
原生 getter。 读取属性走的是浏览器正常的代码路径,因此数值前面没有脚本定义的 getter。下一节中的描述符检查预期会显示内置代码。
渲染输出。 对于 Canvas 2D、WebGL 和音频,BotBrowser 在渲染管线中应用确定性噪声,而不是通过 JavaScript 注入。阅读 Canvas 文章可以了解这种噪声如何在同一种子下保持稳定。
请求头。 文档将 Client Hints 值和对应的请求头描述为由同一个配置文件生成,因此它们与 JavaScript 值以及 Worker 保持一致。
Worker 继承。 在某个上下文中创建的专用 Worker、共享 Worker 和 Service Worker 会继承该上下文的指纹(参见按上下文指纹文档),所以不存在可能晚执行或遗漏某个上下文的注入步骤。
下表总结了三种方式在与一致性相关的维度上有何不同。它比较的是架构,而不是具体产品。
| 维度 | 浏览器扩展 | 注入脚本 | 在浏览器内应用配置文件 |
|---|---|---|---|
| JavaScript 属性值 | 脚本覆盖 | 脚本覆盖,执行时机更早 | 通过正常 getter 返回配置文件的值 |
| 属性描述符检查 | 可见脚本 getter | 可见脚本 getter,toString() 已被修改 | 预期为内置 getter |
| Canvas、WebGL 和音频输出 | 仅包装读取方法 | 仅包装读取方法 | 渲染路径中由配置文件驱动的噪声 |
| 字体可用性 | 无法控制 | 无法控制 | 字体列表来自配置文件 |
| 请求头 | 在内容脚本运行前已发出 | 页面脚本不会改变 | 与配置文件一致的值 |
| Client Hints | 无法触及 | 无法触及 | 与配置文件保持一致 |
| iframe 和 Worker | 可能被遗漏 | 框架被覆盖,Worker 视情况而定 | 相同的配置文件值 |
| 信号之间的一致性 | 相互独立的补丁 | 相互独立的补丁 | 由一个配置文件定义所有值 |
配置文件包含从真实浏览器会话中捕获的设备信号:navigator 值、屏幕尺寸、GPU 信息、字体,以及渲染和音频特征。加载它会一并配置这些信号,它们因此彼此保持一致。启动命令很短:
chromium-browser \
  --bot-profile="path/to/profile.enc" \
  --bot-noise-seed=42
确定性噪声种子。 对于回归测试和受控实验,噪声种子让输出可以重复。文档说明,同一个配置文件加上同一个种子,会在不同会话中产生相同的 Canvas、WebGL 和音频输出,更换种子则会得到不同但同样稳定的结果。文档将 --bot-noise-seed 标注为 ENT Tier2 功能,因此在依赖上面的启动命令之前,请先确认你的套餐包含它。
按上下文设置指纹。 按上下文设置指纹在文档中被标注为 ENT Tier3 功能,它允许每个浏览器上下文在同一个浏览器实例内带有自己的配置文件和噪声种子。BotBrowser 自己的基准测试显示,在大规模下,它比多个独立浏览器实例占用更少内存、产生更少操作系统进程。这些是 BotBrowser 在自己硬件上的测量结果,所以规划容量之前请测量你自己的负载。
跨平台输出。 Canvas 文档说明,在 Linux 主机上运行 Windows 配置文件,会产生与在 Windows 硬件上相同的 Canvas 输出。跨平台配置文件文章介绍了主机与配置文件的操作系统不同时应检查什么。
性能。 在 BotBrowser 自己进行的无头模式 Speedometer 3.0 测试中,BotBrowser 得分 42.7,标准 Chrome 得分 42.8。基准文档认为这在多次运行之间的正常波动范围内。没有需要逐页注入的脚本,所以没有逐页注入的开销,但在你的硬件上结果可能不同。
自己检查一致性
验证适用于任何一种方式,它只检查浏览器暴露的数值之间是否彼此一致。通过说明内部一致,并不说明任何第三方网站会如何判定一个会话。
检查 1,属性描述符与 Worker。 在你要测试的浏览器中打开某个页面的开发者控制台并运行下面的代码。第一行读取一个属性的 getter 并输出它的源码文本,其余几行启动一个 Worker 并把它的值与主框架的值作比较。
const d = Object.getOwnPropertyDescriptor(Navigator.prototype, 'hardwareConcurrency');
console.log(Function.prototype.toString.call(d.get));
const w = new Worker(URL.createObjectURL(new Blob(['postMessage(navigator.hardwareConcurrency)'])));
w.onmessage = e => console.log('worker:', e.data, 'main:', navigator.hardwareConcurrency);
内置 getter 输出的函数体包含 [native code],由脚本定义的 getter 则输出 JavaScript 源码。Worker 的值与主框架的值应当一致。如果不同,说明覆盖到达了其中一个上下文,却没有到达另一个。
检查 2,其他上下文。 对同源 iframe 重复这一比较,如果你的流程用到 Service Worker,也对它重复。数值一致是一致性的证据,不一致则指向工具没有触及的某个层面或上下文。
检查 3,请求头与脚本。 把脚本报告的平台和品牌值,与服务器收到的 User-Agent 和 Client Hints 请求头作比较。一个由你控制、能回显收到请求的页面就足够了。两个来源应当描述的是同一台设备。
检查 4,渲染稳定性。 重新加载页面,并用相同的配置文件和种子重启浏览器,然后比较 Canvas 输出。更换种子,确认输出以稳定的方式发生变化。在没有种子参与的情况下每次读取都变化的输出,比重复出现的输出更少见,因为真实设备对同一幅绘制会返回相同的结果。
公开的检查页面可以提供第二个视角,验证文章介绍了如何解读它们。请把它们的警告当作内部不一致的线索,而不是任何网站所使用的分数。
当某项检查失败时,失败会指向某一层。检查 1 中出现脚本定义的 getter,说明该值是在浏览器自身代码之上被覆盖的。Worker 与主框架不一致,说明覆盖没有到达该作用域。请求头与脚本值不一致,说明请求是在脚本运行之前构造的。渲染结果每次读取都变化,说明噪声是按调用而不是按种子施加的。这些发现会告诉你该修复什么,或者该重新考虑哪种架构,这比一个简单的通过或不通过更有用。请求头与网络层如何影响一致性,可参阅面向隐私保护的网络层浏览器一致性。 配套的对比指南在同一份记录里并排跑这四项检查,分别针对浏览器内核构建与 API 层构建:浏览器内核保护与 API 层保护的可复现对比。
请把配置记录在每个结果旁边:BotBrowser 版本、配置文件、种子、主机操作系统,以及运行是无头模式还是有界面模式。没有这些记录,两次运行之间的差异就无法追溯到原因。
选择方式及其局限
按你无法接受的故障来选择。扩展可以用于针对简单跟踪器的基础防护,前提是你接受新建上下文和渲染输出可能保留真实值。注入脚本适合你能控制自动化框架、只需要修改少数几个值的测试。当要求是跨上下文和跨层面保持一致时,在浏览器内应用配置文件更为合适。隐私优先内核与反检测浏览器的区别,见隐私优先浏览器内核 vs 反检测浏览器:有什么区别?。
无论选择哪种方式,都应事先确定哪些信号对你的场景重要,并对它们做测试。对单个浏览器做隐私评估,可能只需要描述符和 Worker 的一致。运行大量会话的测试套件,还需要把每次运行的种子和配置文件记录下来,以便日后复现差异。对比不同主机操作系统的团队,还需要跨平台检查。如何用轻量脚本驱动浏览器,参见使用 Chrome DevTools Protocol 进行轻量级浏览器自动化。
使用 BotBrowser 时我还需要注入脚本吗? 配置文件已经覆盖了这些脚本所修补的数值。在其上叠加脚本覆盖,可能重新引入脚本定义的 getter 和不一致,所以请先只使用配置文件,只添加有文档记录的检查证明你仍然需要的部分。
那些把 Canvas 输出随机化的扩展呢? 每次读取都变化的随机噪声本身就很少见,因为真实设备对同一幅绘制会返回相同的输出。带种子的噪声在同一种子下保持稳定,这正是它可用于可重复测试的原因。
设置比添加插件更难吗? 通常更简短。你只需让自动化框架指向 BotBrowser 的可执行文件并选择一个配置文件。Playwright 指南逐步展示了连接方法。
BotBrowser 能够在浏览器内应用已加载的配置文件,在 JavaScript、HTTP 请求头和 Worker 上下文之间保持 navigator 值一致,让你可以自行检查跨上下文的一致性,而不必依赖注入式覆盖。BotBrowser 不能保证任何第三方网站或检测器如何判定一个会话,也不替代代理质量、行为真实性以及你自己对最终配置的验证。
实际结论
根据已授权工作负载需要保持一致的表面来选择控制点。分别记录主框架、Worker、渲染输出和首个请求中的同一信号;单次 JavaScript 读取无法证明这些层面一致。