解读 BrowserLeaks WebRTC 测试报告
把 BrowserLeaks 的 WebRTC 支持、ICE、SDP 与媒体设备字段映射到浏览器操作,不把单行结果当作泄漏判决。
BotBrowser Team
BrowserLeaks 的 WebRTC 测试会显示几类彼此独立的观察结果:接口支持、收集到的 ICE 候选、会话描述,以及媒体设备状态。BotBrowser 文档说明了 WebRTC 和媒体设备控制,但这份报告不是 BotBrowser 兼容性测试,任何一行都不能证明身份、匿名性或普遍的泄漏结论。正确的读法是把每一行对应到产生它的浏览器操作,并把不同路径的证据分开。
摘要
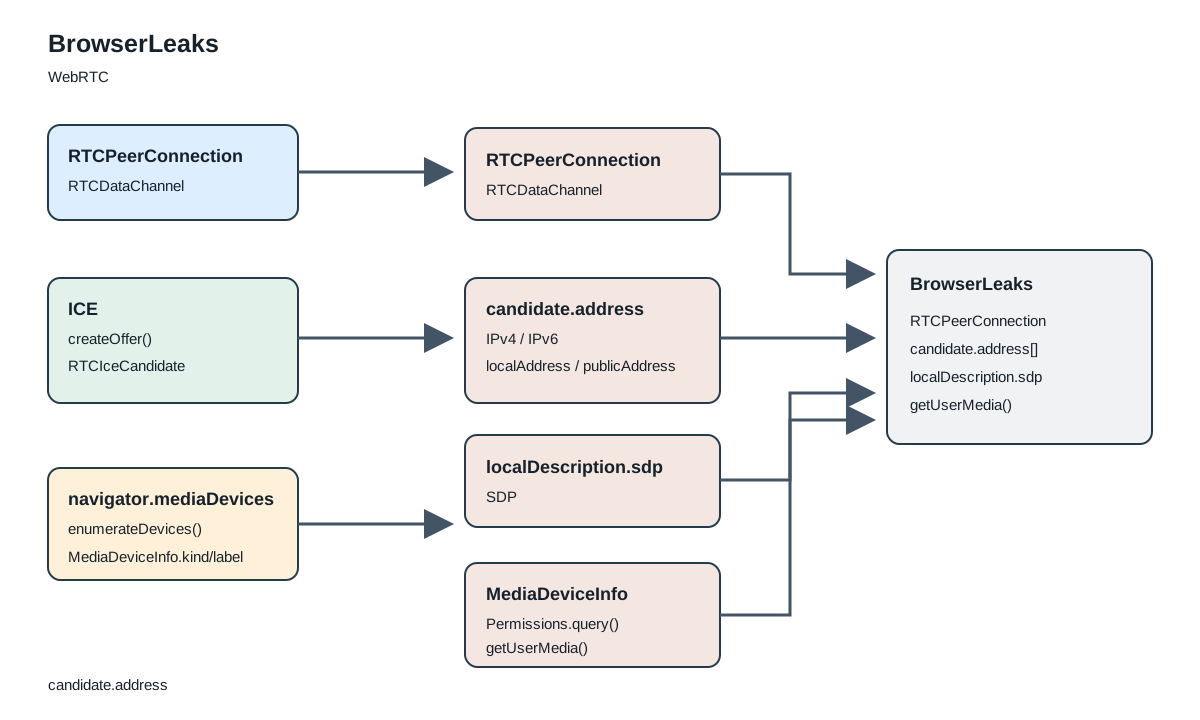
BrowserLeaks 公共页面展示接口支持检查、ICE 收集结果、SDP 日志和媒体设备信息。页面版本 URL 中的客户端脚本会创建 RTCPeerConnection、请求 offer、监听候选事件,并分别查询媒体设备和权限。候选地址、支持标记、权限状态或设备条目,只能说明特定上下文中的对应操作;它们既不是完整的网络路径说明,也不是人的身份标识。
目录
报告包含多条路径,而不是一个分数
BrowserLeaks WebRTC 页面由多个独立区块组成,并非一个统一的数字评分。可见标题包括 WebRTC 支持、本地与公网 IP 地址、会话描述和媒体设备。页面还提供单独的音频和视频捕获权限按钮。这个布局有实际意义:每个区块由不同的浏览器操作填充,一个区块有值并不意味着其他操作也成功。
页面加载的公开客户端脚本 URL 当前带有版本标记 86970852。该脚本是描述页面行为的依据,但它不是 WebRTC 标准,也不是经过审计的源代码仓库。后续版本可能改变字段、超时条件或解析规则。因此,可见 HTML 和脚本回答的是一个有限的问题:当前获取到的页面版本请求浏览器执行什么操作,并将结果写到哪里。它们不能证明所有浏览器、网络、扩展或未来 BrowserLeaks 版本的行为。
这与 BotBrowser 的 WebRTC 防泄漏文档不同,后者解释 ICE 和 SDP 控制;也与媒体设备文档不同,后者介绍由配置文件支持的设备枚举。这里关注 BrowserLeaks 报告自身。CreepJS WebRTC 字段分析追踪的是另一个采集器的转换过程,不能把其中的字段名和分支套到 BrowserLeaks 上。
明确范围可以避免常见误读。例如,报告可能同时显示 RTCPeerConnection: True 和空的地址区域,也可能显示设备列表,但捕获请求仍在等待或已被拒绝。这些状态并不矛盾。支持标记只表示找到了接口;候选收集和权限操作属于后续步骤,有各自的结果。
接口支持与候选收集回答不同的问题
公共页面显示两个支持项:RTCPeerConnection 和 RTCDataChannel。在页面版本对应的脚本中,构造器辅助函数会在页面上下文和沙箱 iframe 中尝试标准及带前缀的构造器名称。随后,脚本检查创建的对象是否暴露 createDataChannel。这些只是接口存在性检查,不会建立网络路由,不表示 ICE 收集已完成,也不证明远端节点收到过数据。
候选收集走另一条路径。脚本创建配置了 Google 公共 STUN 地址 stun:stun.l.google.com:19302 的 peer connection;如果方法可用,就创建数据通道,然后请求 offer。offer 请求接收音频和视频;如果该形式失败,脚本会尝试更简单的 offer。浏览器在本地接受 offer 后,脚本将其设置为本地描述并处理候选事件。这些调用解释了为什么页面可以在没有应用发起通话的情况下产生候选数据,但它们不等于测试每个应用、TURN 设置或点对点会话。
脚本从 icecandidate 事件以及 localDescription.sdp 中形似候选的行收集数据。解析后的地址字符串会去重;随后脚本等待收集完成或进入超时分支,把 SDP 文本写入可见日志,再关闭 peer connection。事件流和 SDP 表示是同一次协商的相关视图,不是两轮独立网络扫描。同一值同时出现在两处时,不应算作两个独立接口或两次泄漏。
浏览器 API 定义 RTCPeerConnection 和 ICE 交换的含义;页面决定调用哪些方法、显示哪些值。W3C WebRTC 规范与 MDN 的 RTCPeerConnection 参考描述接口约定。测试自身的选择,例如 STUN 地址、offer 回退方式、收集超时和界面文字,则来自 BrowserLeaks 客户端脚本。标准说明了候选事件,并不能验证报告采用的分类规则或结论。
候选标签是对收集数据的投影
页面分别显示本地和公网地址区域。客户端脚本从 icecandidate 事件和 localDescription.sdp 收集值,再用地址解析器提取形似地址的字符串,与本地网段列表比较并去重。ICE 候选池化分析说明了候选出现时机为何重要。这是报告自身构造的投影:它把候选信息压缩成用于显示的地址分组,不是完整 ICE 候选对象、数据包捕获,也不是操作系统可访问的所有地址清单。
当结果为空时,这一区别尤其重要。脚本可能没有收到符合解析规则的候选;浏览器可能应用了隐私处理;当前路线可能没有产生预期格式的地址;报告也可能走到超时或错误分支。空区域只表示该版本在本次上下文中没有在该字段呈现可解析值。它不能证明主机没有本地地址、网络上不存在路由,或所有远端观察者看到的内容相同。
本地分组的值也不会自动标识某个物理网卡。脚本的网段检查只能回答解析后的文本是否匹配它自己的本地规则。它不能说明地址来自哪个适配器、谁控制适配器,或另一个 peer 是否可以使用该地址。公网分组表示报告将不匹配这些本地规则的解析值放入该组;它不是公网可达性的完整地图,也不能证明代理被绕过。
这个解析过程还会丢失信息。脚本搜索 IPv4 或 IPv6 形态的子字符串,而不是保留包含所有相关字段的类型化候选记录。采集器没有为每个地址同时显示可还原 foundation、传输、组件、相关地址或候选对选择的来源对象。唯一地址字符串列表回答不了这些遗漏问题。应用要诊断 ICE 时,应用自己的选中候选对和连接统计属于另一类证据,范围和权限都不同。
BrowserLeaks 页面作为公共观察界面有其价值,因为它展示当前测试实际收集的内容,但它不是通用检测判决。在隐私审查中,应区分数据来源(事件或 SDP)、解析器(地址提取)、分组规则(本地网段匹配)和最终显示字段。把这些步骤合并成“浏览器泄漏了”会丢失页面实际观察到的细节。
SDP 日志不是数据包捕获
Session Description 区块中的 SDP 日志取自 localDescription.sdp。SDP 是协商期间使用的文本描述,可能包括媒体段、编解码器属性、ICE 参数和候选行;具体字段取决于浏览器创建了什么,以及报告读取前收集到了什么。它不是网络上已发送数据包的记录,也不能证明远端节点收到、接受或使用了每一行。
需要时,脚本会规范化 SDP 开头的版本行,然后把本地描述写入文本区域。该文本属于浏览器本地协商状态,与报告派生出的地址列表不同:同一候选文本可能既出现在 SDP 日志中,也被解析进本地或公网分组。如果把原始日志和分组列表当成独立确认,就会把一个来源计算两次。
日志也没有呈现真实应用通话的全部属性。BrowserLeaks 页面创建自己的 peer connection、offer 和 ICE 配置。视频会议应用可能使用不同的 SDP offer、不同 ICE 服务器、中继策略、通话生命周期,或不同的来源与权限上下文。没有来自该应用路径的证据,就不能把 BrowserLeaks 的结果泛化到这些条件。
阅读日志时可以提出三个有边界的问题:本地描述里有哪些文本?脚本把哪些行解析成地址形态字符串?网段检查又把哪些解析值放进可见分组?单靠这个文本区域,无法回答远端 peer 是否真的收到数据包。要回答那个问题,需要报告此字段没有呈现的传输层或应用层证据。
媒体设备、权限与捕获彼此独立
Media Devices 区块走的是与 ICE 候选收集不同的分支。客户端脚本检查 navigator.mediaDevices.enumerateDevices() 是否存在,在可用时调用它。对每个返回的 MediaDeviceInfo,脚本格式化 kind、label、deviceId 和 groupId。它还单独记录音频输入和视频输入条目是否有非空标签。浏览器返回的条目数量和标签会随上下文、权限、策略与实现不同而变化;这不是硬件清单。
如果 navigator.permissions.query() 和对应权限名称受支持,页面还会分别查询麦克风和摄像头权限状态,并把它们与设备条目分开显示。权限查询的支持程度可能因浏览器而异;查询被拒绝或不受支持不等于权限被拒绝。prompt 状态不是捕获授权。标签为空也不能证明设备不存在,它可能反映披露规则或当前权限状态。
音频和视频捕获是两种明确、独立的操作。页面按钮分别以纯音频或纯视频参数调用 getUserMedia()。脚本根据对应 promise 成功或失败更新结果区域。枚举设备不会自动打开麦克风或摄像头,权限状态也不能证明能够获取可用流。反过来,一种媒体类型捕获成功也不表示另一种类型已授权或可用。
这与浏览器 API 模型一致。 MDN 的 enumerateDevices 参考说明返回列表受权限和策略过滤;getUserMedia 参考则描述可能触发请求、被拒绝或返回媒体流的操作。报告同时展示这两类界面,因为它们回答相关但不同的问题。设备条目不是捕获结果。
BotBrowser 媒体设备指南介绍了配置文件设备枚举与真实系统设备之间的差别。这个控制不会创建物理摄像头,不会授予操作系统权限,也不保证 BrowserLeaks 显示某个具体标签。WebRTC 配置文档讲的是网络行为,不是媒体捕获。把两类控制分开,可以避免把配置文件设置当作用户权限或可用输入流。
字段与操作对照表
下表归纳报告可见字段和填充字段的操作。它用于阅读当前页面版本,不是复现网络扫描的操作说明,也不表示每行都是检测器特征。
| 可见字段 | 页面操作 | 字段能支持的判断 | 字段不能证明的内容 |
|---|---|---|---|
RTCPeerConnection | 在页面和隔离 iframe 中查找构造器 | 当前上下文是否找到可用构造器 | 收集是否完成、连接是否到达其他主机 |
RTCDataChannel | 检查创建对象的 createDataChannel | 对象是否暴露该方法 | 是否与远端 peer 建立了数据通道 |
Local IP Address / Public IP Address | 解析候选和 SDP、去重、按本地网段分组 | 报告将哪些解析字符串放入各显示分组 | 完整接口列表、完整路线、物理身份或普遍泄漏判决 |
SDP Log | offer 路径后读取 localDescription.sdp | 本页面本地描述中的文本 | 数据包捕获、远端回复或成功媒体交换 |
媒体设备 API Support | 检查 enumerateDevices() | 枚举前该方法是否存在 | 设备是否存在或可被打开 |
| 设备条目 | 格式化 enumerateDevices() 结果 | 返回的 kind、label、deviceId、groupId | 主机上的全部硬件或永久设备身份 |
| 音频/视频权限 | 对对应名称调用 permissions.query() | 查询返回的权限状态 | 已授予媒体流、浏览器间统一支持或可用设备 |
| 音频/视频捕获 | 用户触发的 getUserMedia() 请求 | 当前上下文中请求成功还是失败 | 另一类媒体、未来权限或远端通话质量 |
总结时应让每一行继续保持独立。例如,RTCPeerConnection: True、没有显示地址以及 enumerateDevices(): True 可以同时成立,因为它们分别描述接口存在、解析路径没有显示值和另一项媒体 API。若把它们合成一个“通过”或“失败”,就会抹掉每个观察由什么操作产生。
报告不能证明什么
WebRTC 报告不能识别某个人。候选地址可能被共享、重新分配、转换、转发、隐藏,或不向页面提供。媒体设备标识符和标签是浏览器上下文中的值,不能证明物理设备属于谁。浏览器页面报告不能验证账户身份,不能确定 WebView 宿主应用,也不能说明服务器在请求后保留了什么。
报告不能证明匿名性。地址字段只是一个可观察面;页面没有测量所有网络路线或所有浏览器信号。地址字段为空不等于网络路径干净,显示公网地址本身也不证明代理被绕过。提出网络隐私结论前,必须限定观察者和测试上下文。
报告也不能证明浏览器“通过”了 bot 检测。BrowserLeaks 是公开诊断页面,不是自动化流量决策的通用标准。某个字段可能用于调试或透明度说明,但特定 anti-bot 服务未必会使用它。单凭此报告无法推断厂商决策、挑战结果或接受率。
最后,报告结果受时间和上下文影响。浏览器版本、来源权限、网络路线、STUN 可用性、策略、扩展和脚本变更都可能影响显示结果。脚本 URL 中的版本标记指向检查时获取的资源,不保证未来每次访问都获得相同代码。因此引用公共页面时,最好记录获取日期和查看的区块,而不是将其当作永久不变的规范。
常见问题
BrowserLeaks WebRTC 测试总能显示公网地址吗?
不能。只有当浏览器操作返回了解析器认识的候选或 SDP 文本,并到达渲染分支时,页面才会显示解析后的地址。空结果可能有多种原因,也不能证明不存在其他地址或路线。
RTCPeerConnection: True 是否证明 WebRTC 通话可用?
不能。这只是支持检查。候选收集、ICE 连通、远端协商和媒体传输都属于后续步骤。支持行不表示页面与另一个端点完成了通话。
媒体设备列表是否表示麦克风已开启?
不是。enumerateDevices() 返回浏览器过滤过的列表。页面的捕获按钮会分别发起 getUserMedia() 请求,成功或失败彼此独立。设备条目不证明捕获已经开始。
BrowserLeaks 页面是开源检测器吗?
页面和客户端脚本可以公开获取,因此可以检查其展示的行为。但这不足以证明其具有开源许可证或已授权的代码仓库。这里将它称为包含公开脚本的公共页面,不称为已确认许可的开源项目。
结果能说明浏览器是否可被检测吗?
不能。报告展示的是部分 WebRTC 和媒体设备观察值。其他页面或服务可以使用不同 API、策略或服务端信号;这份报告没有显示它们的决策。
来源
- BrowserLeaks WebRTC Leak Test 及其页面版本客户端脚本。
- W3C WebRTC 1.0 和 MDN RTCPeerConnection。
- MDN MediaDevices.enumerateDevices() 与 MediaDevices.getUserMedia()。
- BotBrowser WebRTC 防泄漏 和媒体设备隐私。
实践结论
应把 BrowserLeaks WebRTC 页面看作一组独立结果:将支持标记对应到构造器检查,将地址分组对应到候选和 SDP 解析,将会话日志对应到本地描述,将设备条目对应到枚举,将权限标签对应到权限查询,将捕获结果对应到明确的 getUserMedia() 请求。该报告可以展示其页面上下文中的这些操作,但不会把它们变成人的身份、匿名保证、普遍泄漏判决或 bot 检测决策预测。
本文属于指南: 什么是 WebRTC 泄露?IP 泄露防护与浏览器隐私