Web Unblocker и API скрапинга: задачи и границы
Хостинговый сервис разблокировки возвращает данные, а не сессию. Эта форма запроса определяет подходящие задачи и случаи, когда нужен собственный браузер. Включён расчёт стоимости.
BotBrowser Team
Нужна структурированная документация по теме Документация?
Эта статья относится к редакционной библиотеке. Для пошаговой настройки, справки и постоянных обновлений переходите сразу в соответствующий раздел docs.
Хостинговый сервис разблокировки отвечает на один HTTP-запрос данными и забывает его, и эта форма запроса определяет почти всё в его применимости. BotBrowser предоставляет объявленный профиль, который поддерживает согласованность читаемых страницей поверхностей между запусками, и не может заменить пул прокси, управляемый парк машин или сервис повторных попыток. Документация поставщиков ясно показывает, что продаёт категория: конвейер запросов, который берёт на себя маршрутизацию, повторы, рендеринг и генерацию собственного отпечатка, а также идентификатор сессии, сохраняющий один прокси на ограниченный интервал, а не браузер, остающийся неизменным.
Кратко
- Сервис разблокировки это конвейер запросов: вы отправляете URL, получаете результат, и после этого нет процесса браузера, который можно изучить.
- Документированные составные части это маршрутизация, повторы, рендеринг JavaScript и генерация отпечатков на стороне поставщика.
- Непрерывность ограничена и узко определена: один поставщик документирует идентификатор сессии, который удерживает один прокси не более десяти минут.
- Это непрерывность исходящего трафика, а не непрерывность идентичности браузера, и эти два свойства отвечают разным требованиям.
- Управляемые сервисы подходят для разовых извлечений, малых объёмов и задач без входа в систему.
- Они плохо подходят, когда нужен один узнаваемый браузер на протяжении дней или когда содержимое запроса не может покинуть ваш периметр.
- Сравнение стоимости это вопрос загрузки, и приведённая ниже схема считает обе стороны без цитирования цен.
Содержание
- Что на самом деле продаёт категория
- Ограничения, вытекающие из формы запроса
- Когда хостинговый сервис подходит
- Когда он не подходит
- Стоимость без прикрас
- Практический вывод
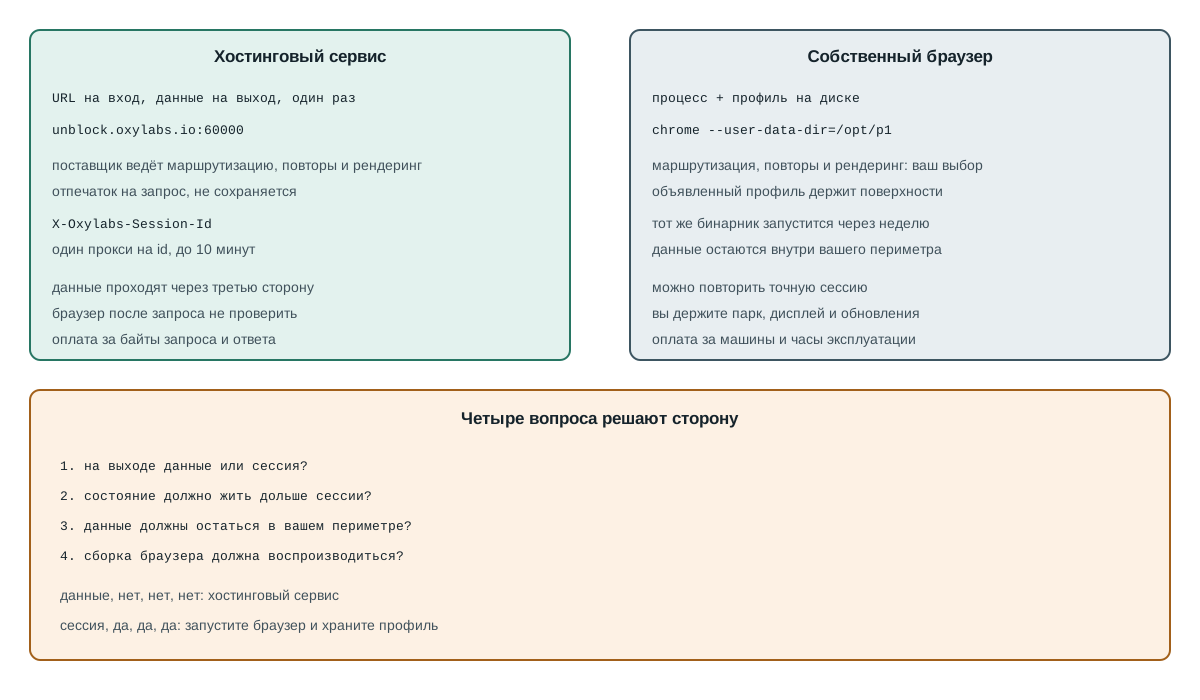
Что на самом деле продаёт категория
Документация необычно прямо описывает состав, поэтому раздел получается коротким. Oxylabs описывает Web Unblocker как прокси-решение на основе ИИ, которое управляет типом прокси, генерацией отпечатка браузера, автоматическими повторами, поддержанием сессии и рендерингом JavaScript. Browserless выражает ту же идею через REST-эндпоинты, где один HTTP-запрос выполняет одну задачу браузера и возвращает результат, а не сессию.
you send      -> https://unblock.oxylabs.io:60000  (proxy endpoint) or /content, /scrape (REST)
you receive   -> HTML, JSON or an image, once
you do not get-> a browser process, a profile directory or a build you chose
Две детали из этого списка важнее основного заявления. Первая это генерация отпечатка: её создаёт поставщик, а значит она не в ваших руках и не остаётся неизменной на протяжении дней. Вторая это повторы: поставщик решает, когда повторять, что удобно, пока не потребуется узнать, пришёл ли ответ с третьей попытки или с первой, а документированное правило оплаты оставляет в счёте только ту попытку, которую видно.
Это не критика. Конвейер запросов является правильной формой для широкого класса задач, и именно поэтому категория существует. Суть в том, что форма остаётся формой: она определяет, что можно утверждать после запроса.
Форма также определяет, что можно сравнивать. Команда, выбирающая между хостинговым конвейером и собственным браузером, на самом деле выбирает между двумя моделями защиты, и что меняет ядро браузера по сравнению с внедряемыми переопределениями скриптов объясняет, почему частичная защита может быть более отличимой, чем её отсутствие. Хостинговый конвейер согласован по построению, потому что все значения создаёт одна система; собственный браузер согласован только тогда, когда профиль объявляет их все.
assertable after a request    -> status code, body, latency, credit cost
not assertable               -> which browser build ran, which profile, which fingerprint
Ограничения, вытекающие из формы запроса
Три ограничения вытекают из отправки URL и получения результата, и каждое документировано, а не выведено предположением.
Первое это ограниченная непрерывность. Oxylabs документирует заголовок X-Oxylabs-Session-Id, который закрепляет один прокси за идентификатором сессии не более чем на десять минут, после чего назначается другой прокси. Это реальная функция, полезная для многошаговых сценариев. Это также окно привязки прокси, а не долговечная идентичность браузера: через десять минут исходящий трафик меняется, и в ответе нет ничего, что сказало бы, как выглядел браузер до или после.
session id -> one proxy for up to 10 minutes -> new proxy afterwards
             (egress continuity, not browser continuity)
Второе ограничение в том, что отпечаток генерируется внутри поставщика. Это прямо указано в списке возможностей и следует из архитектуры: сервис, выполняющий тысячи запросов в минуту, не может читать ваш профиль с диска. Он может генерировать согласованный отпечаток для каждого запроса, что и обещает документация. Последствие для читателя узкое: если требование звучит как "тот же браузер в понедельник и в пятницу", спрашивать нужно не на этом уровне.
Третье это путь данных. Запрос через хостинговый конвейер передаёт URL, заданные вами заголовки, передаваемые cookies и тело ответа через третью сторону. Для публичных страниц это часто приемлемо, а для всего, где есть вход в систему, идентификатор клиента или договорное условие о местонахождении данных, обычно нет. Это факт соответствия требованиям, а не дефект продукта, и он входит в решение раньше цены.
У третьего ограничения есть практическая проверка, достаточно короткая, чтобы выполнить её до подписания. Перечислите поля, которые несёт запрос: URL, каждый заголовок, каждое cookie, тело и ответ. Затем для каждого поля спросите, может ли оно законно покинуть среду, в которой выполняется задача. Если хотя бы одно поле не может, хостинговый конвейер исключается для этой цели независимо от производительности, и заменой будет не лучший поставщик, а браузер внутри периметра.
allowed to leave -> public URL, no cookies, no account identifiers
not allowed      -> session cookies, bearer tokens, customer records, regulated data
leaves your perimeter -> target URL, request headers, cookies, response body
stays with provider   -> retry history, generated fingerprint, routing decision
Ещё два свойства важны для воспроизводимости. Хостинговый конвейер обновляется по собственному графику, поэтому два одинаковых запроса с разницей в месяц могут обслуживаться разными внутренними компонентами; а кредитная модель измеряет трафик, поэтому размер полученного тела так же важен, как число запросов. Документированное правило повторов это успокаивающая половина: внутренний повтор, завершившийся успехом, оплачивается один раз. Ни то, ни другое не скрыто: оба видны в документации и панели управления, а не в ответе.
Есть четвёртое ограничение, которое легко пропустить, пока оно не начнёт мешать: эндпоинт говорит по HTTP, поэтому единственный рычаг управления браузером это набор заголовков, описанный поставщиком. Oxylabs предлагает пользовательские инструкции браузера и заголовок рендеринга JavaScript для Web Unblocker, и оба действительно полезны. Ни один из них не позволяет утверждать, какая сборка выполнялась, какие шрифты были установлены или какой путь GPU использовался, потому что браузер находится за эндпоинтом, а не перед вами. Тест, написанный против хостингового эндпоинта, может утверждать данные; он не может утверждать браузер, и любое обратное утверждение относится к внутренней генерации поставщика, а не к вашему воспроизведению.
assertable through the endpoint -> status, body, latency, credits spent
assertable only on a browser    -> build, profile, fonts, GPU, extensions, timing
По этой же причине хостинговый сервис плохо подходит для набора регрессионных проверок. Набор, сравнивающий вчерашний снимок с сегодняшним, требует, чтобы оба изображения пришли из одной сборки браузера с одинаковыми шрифтами и одинаковым соотношением пикселей устройства, а хостинговый эндпоинт намеренно варьирует все три параметра в своём парке, чтобы проходить проверки отпечатков. Та же вариативность, которая помогает ему работать против цели, делает его непригодным как фиксированный эталон.
Практический ответ это разделение, а не победитель. Используйте хостинговый эндпоинт, когда вопрос звучит как "возвращает ли этот URL данные", и браузер, который вы запускаете, когда вопрос звучит как "отрисовывается ли страница по-прежнему так же". Оба вопроса законны и требуют разных инструментов.
Когда хостинговый сервис подходит
Пригодность проще описать списком условий, которые должны выполняться все, потому что задача, удовлетворяющая четырём из пяти, обычно относится в другое место.
- Нужен результат в виде данных, а не сессии, поэтому ниже по потоку ничего не должно управлять страницей.
- Задача разовая или с небольшим стабильным объёмом, когда содержание парка машин стоило бы дороже экономии.
- Состояние входа не должно сохраняться между запросами, поэтому окна привязки в десять минут достаточно.
- Содержимое запроса публично или нечувствительно, поэтому третья сторона в пути данных допустима.
- Воспроизводить нужно не сам браузер, а только результат извлечения.
Когда эти условия выполнены, хостинговый конвейер дешевле во всех значимых смыслах: один HTTP-запрос заменяет процесс, и 200 с телом это весь контракт. Нет машины, которую нужно содержать, браузера, который нужно обновлять, и пула, который нужно проверять. Для этого категория и существует, и команде, которой нужно именно это, не стоит строить своё.
Второе законное применение это первая проверка новой цели. Несколько запросов через хостинговый сервис показывают, возвращает ли страница данные вообще, до того как кто-то напишет браузерную обвязку, и ответ стоит нескольких кредитов. Диагностика блокировки скрапинга по уровням это метод, который превращает первую проверку в решение, а не в привычку.
Третье применение это нагрузка с меняющимися целями. Задача мониторинга, которая раз в день просматривает двести несвязанных публичных страниц, мало выигрывает от постоянного браузера, потому что каждая страница это отдельный источник, а важная идентичность здесь это согласованность в пределах запроса, а не непрерывность. Хостинговая маршрутизация решает этот случай напрямую: поставщик выбирает подходящий цели исходящий маршрут, и задаче не нужно знать, каким он был. Та же задача на собственном браузере потребовала бы пула, рассчитанного на число одновременных целей, и правила о том, какой исходящий маршрут видит каждый источник, то есть больше механики, чем оправдывает задача.
one origin, many runs      -> continuity matters; a browser you own
many origins, one run each -> coherence per request; a hosted pipeline
Когда он не подходит
Зеркальные условия столь же конкретны, и каждое называет требование, которое форма запроса не может выполнить.
- Тот же браузер должен оставаться узнаваемым на следующей неделе, поэтому идентичность обязана пережить запрос.
- Данные не могут покинуть вашу инфраструктуру по причине места хранения, договора или обязательства перед клиентом.
- Нужно закрепить сборку браузера, потому что различие в вёрстке или кодеке меняет результат.
- Нужно повторить одну точную сессию, чтобы сравнить два запуска, а для этого сессию нужно удерживать, а не запрашивать заново.
- Нужно состояние по идентичности, сохраняющееся днями, а это каталог профиля, а не заголовок сессии.
В этих случаях браузер должен работать там, где вы контролируете, и работа, которую поглощал хостинговый сервис, становится явной: установить закреплённую сборку, хранить каталог профиля, поддерживать в рабочем состоянии дисплей или контейнер и записывать, что выполнялось. Закрепление версии Chrome for Testing это материальная половина этой работы, а Browserless против собственных браузеров это смежное решение о том, где живёт процесс, когда идентичность остаётся вашей.
Последнее из этих условий обычно удивляет команды, поэтому его стоит объяснить. Повторить точную сессию значит удержать браузер между двумя наблюдениями, а не отправить тот же запрос дважды. Хостинговый эндпоинт этого не может, потому что второй запрос по построению является новой сессией; собственный браузер может, потому что каталог профиля и процесс всё ещё на месте. Когда отчёт утверждает, что "во вторник работало", единственный способ проверить это утверждение вернуться в тот же браузер, и это возможность, а не удобство.
replay definition -> same process, same profile, same build, second observation
not a replay      -> same URL sent again through a stateless endpoint
hosted unblocker  -> you own: the query, the parsing, the decision to retry
self-hosted       -> you own: the binary, the profile, the pool, the display, the record
Стоимость без прикрас
Ни одна из сторон не является числом без вашей нагрузки, но обе вычислимы, и записать формулу полезнее, чем читать чужую цену.
hosted monthly    ~= consumed_traffic x unit_price    (request bytes + response bytes)
self-hosted cost  ~= machines x hours + ops_hours x loaded_rate + egress
crossover         -> where hosted_traffic x unit_price equals the fixed side
Две поправки делают эту арифметику честной, и обе взяты со страницы тарификации поставщика, а не из догадки о том, как работает пул прокси. Первая: счётчик измеряет трафик, а не запросы. Oxylabs тарифицирует байты запроса и байты ответа успешно извлечённых данных, поэтому большое тело JSON стоит дороже маленького, и различие в сжатии меняет счёт, не меняя число запросов. Вторая: правило повторов, и оно противоположно интуиции большинства. Когда запрос требует трёх внутренних попыток и последняя успешна, документация указывает, что оплачивается только трафик, потреблённый последней успешной попыткой; а когда сторона самого поставщика отвечает ошибкой 5xx, эта попытка не тарифицируется. Документированное исключение действует наоборот: ошибка, вызванная клиентом, всё равно тарифицируется, поэтому некорректный запрос или неверные учётные данные могут стоить трафика, не возвращая данных.
Разобранный пример делает форму конкретной без цитирования тарифов. Предположим, задача отправляет пятьдесят тысяч запросов в месяц, и один из десяти требует одной дополнительной внутренней попытки до успеха, то есть всего пятьдесят пять тысяч попыток. По документированному правилу оплачиваемыми единицами остаются пятьдесят тысяч успешных запросов, потому что дополнительная попытка внутри успешного запроса отдельно не тарифицируется. Меняется другое слагаемое, трафик: если каждый успех потребляет двести килобайт запроса и ответа вместе, за месяц набирается десять гигабайт оплачиваемого трафика, и цель с удвоенным размером страницы сдвигает счёт вдвое сильнее, чем цель с удвоенной долей повторов. На собственной стороне та же задача помещается в несколько одновременных браузеров на двух машинах по восемь часов в день, а арифметика это машинные часы плюс часы, которые кто-то тратит на обновления.
requests issued          50000
internal attempts        55000  (1 in 10 needs one extra)
billed successful units  50000  (only the last, successful attempt)
billed traffic           ~10 GB at 200 kB per success
low, spiky volume   -> per-request billing follows the spikes; hosted usually cheaper
high, steady volume -> fixed machines amortise; self-hosted usually cheaper
either way          -> the identity requirement is not in this arithmetic at all
Бесплатный уровень заслуживает простой фразы, а не пренебрежения, потому что значительная часть поисковых запросов вокруг этой категории ищет именно его. Поставщики публикуют бесплатную квоту, а Oxylabs документирует приветственный кредит. Бесплатная квота это законный способ оценить конвейер; она не является способом выполнять нагрузку, которой нужна параллельность, потому что опубликованные бесплатные уровни ограничивают число одновременных сессий и их длительность. Прочитать ограничение до того, как строить на бесплатном уровне, это разница между пилотом и простоем.
Открытая альтернатива это второй объект тех же поисков, и она заслуживает такого же простого разбора. Собственный сервис разблокировки существует, и по сути это работа с пулом браузеров, описанная выше, плюс слой маршрутизации и цикл отчётности детекторам, то есть большой объём кода на сопровождении. Это оправдано при стабильном объёме и реальных требованиях к идентичности; это не оправдано как способ избежать подписки для задачи, запускаемой дважды в неделю, потому что эксплуатационная стоимость пула определяется часами наблюдения за ним, а не машинами. Пул, за которым никто не смотрит, это пул, который молча отказывает в субботу, и подписка, которую он заменил, оплачивала именно это внимание.
free tier        -> good for a pilot, capped on concurrency and session length
open-source      -> good at steady volume, costs engineering hours to operate
paid per request -> good for spiky or low volume, follows the spikes
Практический вывод
Задайте четыре вопроса по порядку. Результат должен быть данными или сессией? Должно ли какое-либо состояние жить дольше окна поставщика? Должно ли содержимое запроса оставаться внутри вашего периметра? Должен ли сам браузер быть воспроизводимым? Задача с ответами "данные, нет, нет, нет" относится к хостинговому сервису разблокировки, и заголовка сессии на 10 minutes ей достаточно. Задача с ответами "сессия, да, да, да" относится к браузеру, который вы запускаете, и никакая настройка хостингового запроса его не заменит.
Режим отказа, которого стоит избегать, это смешанный случай, когда команда начинает с хостингового конвейера, добавляет вход в систему, затем добавляет требование постоянства и продолжает расширять запрос, пока не получится браузерная обвязка из повторов. В этот момент честный шаг это запустить браузер, сохранить профиль и использовать хостинговый сервис только для целей, которые всё ещё соответствуют форме запроса.
Оба изменения стоят меньше альтернативы, то есть конвейера, поведение которого никто не может воспроизвести. Записывайте, какую сторону использует каждая цель и почему; скрапинг безголовым браузером: что меняется это список различий после того, как браузер оказывается на вашей стороне границы.
Источники
Похожие статьи
Browserless или собственный браузер: что даёт сервис
СравнениеЧто меняет антидетект-браузер?
Начало работыБраузер для веб-скрейпинга: шесть критериев
СравнениеЯдро браузера и скрипты JavaScript: согласованность отпечатка
РазвертываниеЗащита отпечатков браузера при сборе веб-данных
РазвертываниеСбор данных Shopify: Storefront API, Ajax или браузер?
Выполните ту же проверку в BotBrowser
Загрузите профиль, сохраните внутри браузера те сигналы, о которых только что прочитали, и подтвердите результат на своей машине до раскатки.